ARTICLE · 1308260
RAG 文档处理:把加载、切分和数据清洗做好
本篇不仅介绍工具的使用,更侧重于生产级文档处理方法论,对比 LangChain 和 LlamaIndex 的最佳实践,并涵盖最新的 PDF 解析技术(如 MinerU, LlamaParse)。
学习路径
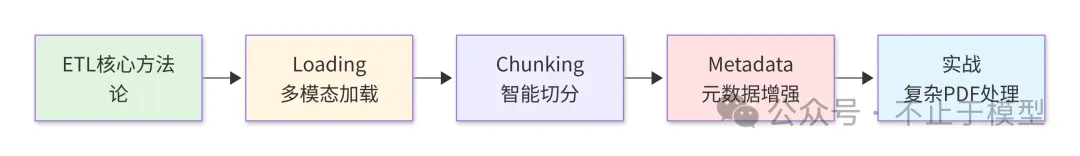
Part 1: ETL 核心方法论
在构建 LLM 应用时,我们遵循标准的 ETL (Extract, Transform, Load) 流程,但在向量数据库语境下,通常描述为:
- Load (加载)
: 将各种非结构化数据(PDF, HTML, MarkDown)统一为标准 Document对象。 - Split (切分)
: 将长文档切分为适合 Embedding 模型窗口(如 512/1024 tokens)的 Chunks。 - Embed (向量化)
: 将文本块转化为向量。 - Store (存储)
: 存入向量数据库。
关键数据结构对比:
| 原始文档 | Document | Document | page_content (text) 和 metadata |
| 切分单元 | Document | Node | |
| 加载器 | BaseLoader | BaseReader |
Part 2: 数据加载 (Loading)
2.1 LangChain 加载方案
LangChain 的加载器生态非常丰富,适合处理异构数据源。
2.1.1 网页加载 (WebBaseLoader)
最常用的网页加载器,基于 BeautifulSoup。
from langchain_community.document_loaders import WebBaseLoader# 1. 加载单个网页loader = WebBaseLoader("https://python.langchain.com/docs/get_started/introduction")docs = loader.load()print(f"Loaded {len(docs)} docs")print(f"Content preview: {docs[0].page_content[:200]}")print(f"Metadata: {docs[0].metadata}")# 2. 并行加载多个网页loader_multi = WebBaseLoader([ "https://www.google.com", "https://www.baidu.com"])loader_multi.requests_per_second = 2 # 限流docs_multi = loader_multi.aload() # 异步加载2.1.2 目录加载 (DirectoryLoader)
适合加载本地知识库文件夹。
from langchain_community.document_loaders import DirectoryLoaderfrom langchain_community.document_loaders import TextLoader# 加载指定目录下所有的 .md 文件loader = DirectoryLoader( './knowledge_base', glob="**/*.md", loader_cls=TextLoader, show_progress=True)docs = loader.load()2.2 LlamaIndex 加载方案
LlamaIndex 的 SimpleDirectoryReader 是目前最强大的全能加载器,一行代码即可处理 PDF, Word, Excel, 图片等多种格式。
2.2.1 SimpleDirectoryReader (全能王)
from llama_index.core import SimpleDirectoryReader# 1. 基础用法:加载目录reader = SimpleDirectoryReader( input_dir="./data", recursive=True, # 递归子目录 required_exts=[".pdf", ".docx"], # 指定后缀 filename_as_id=True # 使用文件名做ID)documents = reader.load_data()print(f"Loaded {len(documents)} docs")# 2. 自定义特定的加载器 (例如对 .pdf 使用特殊的解析逻辑)from llama_index.readers.file import PDFReaderfile_extractor = {".pdf": PDFReader()}reader_custom = SimpleDirectoryReader( "./data", file_extractor=file_extractor)2.2.2 LlamaHub (加载器生态)
LlamaIndex 拥有世界上最大的数据加载器社区 LlamaHub。
# 例如:加载 Notion 数据from llama_index.readers.notion import NotionPageReader# 需要先在 Notion 申请 Integration Tokenreader = NotionPageReader(integration_token="secret_xxx")documents = reader.load_data(page_ids=["page_id_1", "page_id_2"])Part 3: 智能切分 (Chunking)
切分策略直接影响检索的准确性。切分太碎会丢失上下文,切分太大则包含噪声。
LangChain vs LlamaIndex 切分器对比
RecursiveCharacterTextSplitter | SentenceSplitter | |
|---|---|---|
| 默认行为 | ["\n\n", "\n", " ", ""] | |
| 优势 | ||
| 元数据 |
3.1 LangChain: 递归字符切分
from langchain_text_splitters import RecursiveCharacterTextSplittertext_splitter = RecursiveCharacterTextSplitter( chunk_size=1000, # 块大小 chunk_overlap=200, # 重叠部分,防止上下文丢失 separators=["\n\n", "\n", " ", ""] # 优先级从左到右)splits = text_splitter.split_documents(docs)3.2 LlamaIndex: 句子窗口切分
LlamaIndex 的切分器通常称为 NodeParser。
from llama_index.core.node_parser import SentenceSplitter# 默认分块器splitter = SentenceSplitter( chunk_size=1024, chunk_overlap=20)nodes = splitter.get_nodes_from_documents(documents)# 查看生成的 Nodeprint(f"生成了 {len(nodes)} 个节点")print(nodes[0].get_content()) # 内容print(nodes[0].relationships) # 关系(上一块、下一块的ID)3.3 高级策略:分层切分 (Hierarchical Chunking)
对于长文档,父子索引 (Parent-Child Indexing) 是一种非常有效的策略:
- 父块
: 大块(如 2048 tokens),用于给 LLM 生成答案,保留完整上下文。 - 子块
: 小块(如 256 tokens),用于向量检索,提高精准度。
LlamaIndex 实现:
from llama_index.core.node_parser import HierarchicalNodeParsernode_parser = HierarchicalNodeParser.from_defaults( chunk_sizes=[2048, 512, 128] # 三层切分)nodes = node_parser.get_nodes_from_documents(documents)# 检索时,如果命中 128 的块,可以自动回溯到 2048 的父块内容Part 4: 元数据提取 (Metadata Extraction)
单纯靠文本内容检索往往不够,我们需要结构化元数据(如标题、作者、摘要、关键词)来进行过滤(Pre-filtering)。
4.1 使用 LLM 提取元数据
这是目前最灵活的方法。我们可以定义一个 Pydantic 模型,利用 LLM 的 Function Calling 能力提取元数据。
from langchain_core.pydantic_v1 import BaseModel, Fieldfrom langchain_openai import ChatOpenAI# 1. 定义元数据结构class DocumentMetadata(BaseModel): title: str = Field(..., description="The title of the document") summary: str = Field(..., description="A one-sentence summary") tags: list[str] = Field(..., description="Keywords for categorization") sentiment: str = Field(..., description="Sentiment: positive, negative, or neutral")# 2. 配置 LLMllm = ChatOpenAI(model="gpt-4", temperature=0)structured_llm = llm.with_structured_output(DocumentMetadata)# 3. 提取函数def extract_metadata(text_chunk): return structured_llm.invoke(text_chunk)# 测试sample_text = """LlamaIndex v0.10 发布了!这次更新带来了重大的架构变革,将库拆分为 llama-index-core 和各种插件包。用户现在可以按需安装依赖,大大减小了包体积。社区对此反应热烈。"""metadata = extract_metadata(sample_text)print(metadata.json(indent=2))# 输出:# {# "title": "LlamaIndex v0.10 Release",# "summary": "LlamaIndex v0.10 introduces architectural changes splitting the core library from plugins for optimized dependency management.",# "tags": ["LlamaIndex", "Release", "Python", "Architecture"],# "sentiment": "positive"# }4.2 LlamaIndex 自动化 Pipeline
LlamaIndex 提供了 IngestionPipeline 来串联提取过程。
from llama_index.core.ingestion import IngestionPipelinefrom llama_index.core.extractors import TitleExtractor, SummaryExtractorpipeline = IngestionPipeline( transformations=[ SentenceSplitter(chunk_size=1024, chunk_overlap=200), TitleExtractor(nodes=5), #利用前5个节点生成标题 SummaryExtractor(summaries=["prev", "self", "next"]), # 生成摘要 ])nodes = pipeline.run(documents=documents)# nodes[0].metadata 现在会自动包含 'document_title', 'section_summary' 等字段Part 5: 复杂文档实战 (PDF & Tables)
真实世界的文档(尤其是 PDF)充满了挑战:多栏布局、表格、公式、图片。简单的 PyPDF 往往无法胜任。
5.1 解决方案对比矩阵
| LlamaParse | ||||
| MinerU | ||||
| PyMuPDF | ||||
| Unstructured |
5.2 LlamaParse 实战 (推荐)
LlamaParse 是专为 RAG 设计的解析器,它直接将 PDF 转换为 Markdown,完美保留标题层级和表格结构。
# pip install llama-parseimport osfrom llama_parse import LlamaParsefrom llama_index.core import SimpleDirectoryReader# 配置 API Key (https://cloud.llamaindex.ai/)os.environ["LLAMA_CLOUD_API_KEY"] = "llx-..."# 1. 配置解析器parser = LlamaParse( result_type="markdown", # 输出 Markdown verbose=True, language="zh", # 支持中文 gpt4o_mode=True # 开启高级多模态识别 (消耗更多 credit))# 2. 结合 SimpleDirectoryReader 使用file_extractor = {".pdf": parser}reader = SimpleDirectoryReader( "./complex_docs", file_extractor=file_extractor)documents = reader.load_data()# 3. 检查结果print(documents[0].text[:500])# 你会发现表格被转换为了 Markdown Table 格式:# | 季度 | 营收 | 利润 |# |-----|------|-----|# | Q1 | 100 | 20 |5.3 MinerU 实战 (学术/公式场景)
如果你处理的是包含大量数学公式的论文,MinerU (Magic-PDF) 是目前开源界的 SOTA。
注:MinerU 需要独立部署,以下为 Python 调用示例。
# 假设已在本地安装 magic-pdf# pip install magic-pdf[full]import os# MinerU 通常通过命令行使用,但也可以封装为 Python 函数def process_pdf_with_mineru(pdf_path): output_dir = os.path.dirname(pdf_path) # 调用 CLI (实际生产环境建议使用 API 服务模式) os.system(f"magic-pdf -p {pdf_path} -o {output_dir}") # MinerU 会生成 .md 文件 md_path = pdf_path.replace(".pdf", ".md") if os.path.exists(md_path): with open(md_path, "r") as f: return f.read() return None# 读取后的 Markdown 内容可以直接喂给 LangChain/LlamaIndexmarkdown_content = process_process_pdf_with_mineru("./paper.pdf")5.4 图片与图表处理 (Multimodal RAG)
对于 PDF 中的图片,通常有两种策略:
- OCR 转文本
: 使用 GPT-4o-vision 描述图片内容,存为文本。 - 多模态索引
: 将图片直接作为 Embedding 存入(如 CLIP Embedding),支持文搜图。
策略 1 代码示例 (使用 GPT-4o 生成图片描述):
# 这是一个概念性示例def process_image(image_bytes): from langchain_openai import ChatOpenAI from langchain_core.messages import HumanMessage chat = ChatOpenAI(model="gpt-4o") msg = HumanMessage(content=[ {"type": "text", "text": "请详细描述这张图片中的图表数据或关键信息。"}, {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{base64_image}"}} ]) response = chat.invoke([msg]) return response.content总结
文档处理是 RAG 系统中最 "脏" 但最 "重要" 的环节。
- Loading
: 首选 LlamaIndex SimpleDirectoryReader,简单强大。 - Parsing
: 复杂 PDF 首选 LlamaParse (商业) 或 MinerU (开源)。 - Chunking
: 文本用 SentenceSplitter,代码用 RecursiveCharacterTextSplitter。 - Metadata
: 务必提取 标题 和 摘要,这对检索排序至关重要。
做好 ETL,你的 RAG 系统就已经成功了一半。