ARTICLE · 1315779
2026年11月必练十大软件工程师面试问题!(下)
上篇回顾:
在上篇中,我们详细讲解了:
✓问题1:Two Sum —— 哈希表与双指针的经典应用。
✓问题2:Valid Parentheses —— 栈数据结构入门。
✓问题3:Max Depth of Binary Tree —— 树的递归与BFS。
✓问题4:Merge Two Sorted Lists —— 链表操作与K路归并。
✓问题5:Climbing Stairs —— 动态规划入门。
今天,我们来讲剩下的5道题,以及完整的备考策略。
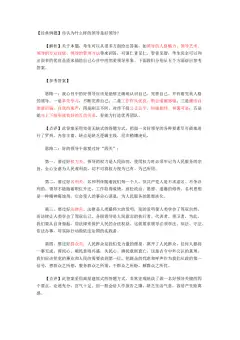
问题6:LRU Cache
题目描述:
LRU规则:
1. 当缓存达到容量限制时,应该在插入新项之前,使最久未使用的数据项失效;
2. get 和 put 操作必须都是 O(1) 时间复杂度。
解法:哈希表 + 双向链表
class ListNode:
"""双向链表节点"""
def __init__(self, key=0, val=0):
self.key = key
self.val = val
self.prev = None
self.next = None
class LRUCache:
def __init__(self, capacity: int):
"""
初始化LRU缓存
时间复杂度:O(1)
空间复杂度:O(capacity)
"""
self.capacity = capacity
self.cache = {} # key -> ListNode
# 使用哑节点简化边界处理
self.head = ListNode() # 虚拟头节点
self.tail = ListNode() # 虚拟尾节点
self.head.next = self.tail
self.tail.prev = self.head
def _add_node(self, node: ListNode):
"""在头部添加节点(最新使用的)"""
node.prev = self.head
node.next = self.head.next
self.head.next.prev = node
self.head.next = node
def _remove_node(self, node: ListNode):
"""移除指定节点"""
prev_node = node.prev
next_node = node.next
prev_node.next = next_node
next_node.prev = prev_node
def _move_to_head(self, node: ListNode):
"""将节点移动到头部(标记为最近使用)"""
self._remove_node(node)
self._add_node(node)
def _pop_tail(self) -> ListNode:
"""移除尾部节点(最久未使用)并返回"""
node = self.tail.prev
self._remove_node(node)
return node
def get(self, key: int) -> int:
"""
获取数据
如果key存在,返回值并将节点移动到头部
如果不存在,返回-1
"""
if key not in self.cache:
return -1
node = self.cache[key]
self._move_to_head(node)
return node.val
def put(self, key: int,
value: int) -> None:
"""
写入数据
如果key已存在,更新值并移动到头部
如果不存在,创建新节点:
- 如果超过容量,先淘汰最久未使用的
"""
if key in self.cache:
node = self.cache[key]
node.val = value
self._move_to_head(node)
else:
new_node = ListNode(key, value)
self.cache[key] = new_node
self._add_node(new_node)
if len(self.cache) > self.capacity:
# 淘汰最久未使用的
tail = self._pop_tail()
del self.cache[tail.key]
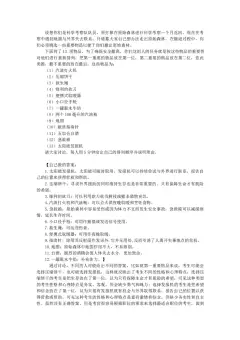
关键设计思路:
2026年进阶问题:
追问1:如何支持并发访问?
• 使用读写锁(Read-Write Lock);
• 读操作可以并行;
• 写操作需要独占锁;
• 可以考虑分段锁提高并发度。
追问2:如果数据量很大,单机存不下怎么办?
• 分布式缓存(如Redis Cluster);
• 一致性哈希(Consistent Hashing);
• 数据分片与副本机制。
问题7:岛屿数量(Number of Islands)
题目描述:
示例:
输入:
11110
11010
11000
00000
输出: 1 (一个大岛屿)
输入:
11000
11000
00100
00011
输出: 3 (三个岛屿)
解法1:深度优先搜索(DFS)
def num_islands_dfs(
grid: List[List[str]]) -> int:
"""
DFS解法
时间复杂度:O(m*n),m是行数,n是列数
空间复杂度:O(m*n),最坏情况递归栈深度
"""
if not grid or not grid[0]:
return 0
rows, cols = len(grid), len(grid[0])
count = 0
def dfs(r: int, c: int):
"""标记当前岛屿的所有陆地"""
# 边界检查
if (r < 0 or r >= rows
or c < 0 or c >= cols):
return
if grid[r][c] != '1':
return
# 标记为已访问
grid[r][c] = 'visited' # 或改为 '0'
# 四个方向DFS
dfs(r + 1, c)
dfs(r - 1, c)
dfs(r, c + 1)
dfs(r, c - 1)
for r in range(rows):
for c in range(cols):
if grid[r][c] == '1':
count += 1
dfs(r, c)
return count
解法2:广度优先搜索(BFS)
from collections import deque
def num_islands_bfs(
grid: List[List[str]]) -> int:
"""
BFS解法
时间复杂度:O(m*n)
空间复杂度:O(min(m,n)),取决于队列大小
"""
if not grid or not grid[0]:
return 0
rows, cols = len(grid), len(grid[0])
count = 0
for r in range(rows):
for c in range(cols):
if grid[r][c] == '1':
count += 1
grid[r][c] = 'visited'
# BFS
queue = deque([(r, c)])
while queue:
row, col = queue.popleft()
for dr, dc in [(1, 0),
(-1, 0),
(0, 1),
(0, -1)]:
nr = row + dr
nc = col + dc
if (0 <= nr < rows
and 0 <= nc < cols
and grid[nr][nc]
== '1'):
queue.append(
(nr, nc))
grid[nr][nc] = \
'visited'
return count
解法3:并查集(Union-Find)
class UnionFind:
"""并查集数据结构"""
def __init__(self, size: int):
self.parent = list(range(size))
self.rank = [0] * size
self.count = 0 # 岛屿数量
def find(self, x: int) -> int:
"""查找根节点(带路径压缩)"""
if self.parent[x] != x:
self.parent[x] = \
self.find(self.parent[x])
return self.parent[x]
def union(self, x: int, y: int) -> None:
"""合并两个集合"""
root_x = self.find(x)
root_y = self.find(y)
if root_x != root_y:
# 按秩合并
if self.rank[root_x] < \
self.rank[root_y]:
root_x, root_y = \
root_y, root_x
self.parent[root_y] = root_x
if self.rank[root_x] == \
self.rank[root_y]:
self.rank[root_x] += 1
self.count -= 1
def num_islands_union_find(
grid: List[List[str]]) -> int:
"""
并查集解法
适合需要频繁查询连通性的场景
"""
if not grid or not grid[0]:
return 0
rows, cols = len(grid), len(grid[0])
uf = UnionFind(rows * cols)
# 初始化:统计所有陆地块
for r in range(rows):
for c in range(cols):
if grid[r][c] == '1':
uf.count += 1
# 遍历所有陆地,合并相邻的
for r in range(rows):
for c in range(cols):
if grid[r][c] == '1':
idx = r * cols + c
# 只需向右和向下合并(避免重复)
if (r + 1 < rows
and grid[r + 1][c]
== '1'):
uf.union(
idx, (r + 1) * cols + c)
if (c + 1 < cols
and grid[r][c + 1]
== '1'):
uf.union(
idx, r * cols + c + 1)
return uf.count
2026年进阶问题:
变体1:最大岛屿面积?
在DFS/BFS时记录每个岛屿的大小。
变体2:如果可以改变一格水为陆地,如何得到最大岛屿?
这是一个更复杂的优化问题,需要预处理每个岛屿的大小。
关键考点:
问题8:最小覆盖子串(Minimum Window Substring)
题目描述:
示例:
输入: s = "ADOBECODEBANC", t = "ABC"
输出: "BANC"
解释: 最小覆盖子串 "BANC" 包含了 "A"、"B" 和 "C"
解法:滑动窗口
from collections import Counter, defaultdict
def min_window(s: str, t: str) -> str:
"""
滑动窗口解法
时间复杂度:O(|s| + |t|)
空间复杂度:O(|s| + |t|)
"""
if not s or not t or len(t) > len(s):
return ""
# 统计t中各字符的需求
target_counts = Counter(t)
required = len(target_counts)
# 需要匹配的不同字符数
# 滑动窗口统计
window_counts = defaultdict(int)
formed = 0 # 当前已满足条件的字符数
# 结果
# (长度, 左索引, 右索引)
result = (float('inf'), 0, -1)
left = 0
for right, char in enumerate(s):
# 将当前字符加入窗口
window_counts[char] += 1
# 如果当前字符的数量刚好满足需求
if (char in target_counts
and window_counts[char] ==
target_counts[char]):
formed += 1
# 尝试收缩窗口
while (left <= right
and formed == required):
character = s[left]
# 更新最小结果
result = (right - left + 1,
left, right)
# 移除左边的字符
window_counts[character] -= 1
if (character in target_counts
and window_counts[character]
< target_counts[character]):
formed -= 1
left += 1
if result[0] == float('inf'):
return ""
return s[result[1]:result[2] + 1]
滑动窗口模板:
def sliding_window_template(s, condition_fn):
"""
通用滑动窗口模板
"""
left = 0
result = []
for right in range(len(s)):
# 将s[right]加入窗口
# 当窗口满足条件时
while condition_fn(window):
# 更新结果
# 收缩窗口:移除s[left]
left += 1
return result
2026年进阶问题:
关键考点:
问题9:设计分布式缓存系统
面试场景:
这不是一道简单的编程题,而是一道系统设计题,考察的是你的架构思维和工程能力。
回答框架:从简单到复杂
第一步 明确需求(Clarify Requirements)
主动提问:
Q1 预计的数据量是多少?(GB/TB/PB级?)
Q2 QPS是多少?(读多写少?还是读写均衡?)
Q3 对一致性有什么要求?(强一致?最终一致?)
Q4 可用性要求?(99.9%?99.99%?)
Q5 是否需要持久化?
Q6 数据结构有哪些?(String、Hash、List、Set...)
第二步 核心设计(Core Design)
1. 整体架构
Client ──▶ Load Balancer
│
┌──────┼──────┐
▼ ▼ ▼
Cache N1 Cache N2 Cache N3
┌──────┐ ┌──────┐ ┌──────┐
│Memory│ │Memory│ │Memory│
│Disk │ │Disk │ │Disk │
└──────┘ └──────┘ └──────┘
2. 数据分布:一致性哈希(Consistent Hashing)
import hashlib
class ConsistentHashRing:
"""一致性哈希环"""
def __init__(self, nodes: List[str],
virtual_nodes: int = 150):
"""
nodes: 物理节点列表
virtual_nodes: 每个物理节点的虚拟节点数
"""
self.ring = {}
self.sorted_keys = []
self.virtual_nodes = virtual_nodes
for node in nodes:
self.add_node(node)
def _hash(self, key: str) -> int:
"""哈希函数"""
return int(
hashlib.md5(
key.encode()).hexdigest(),
16)
def add_node(self, node: str) -> None:
"""添加节点"""
for i in range(self.virtual_nodes):
virtual_key = f"{node}#{i}"
hash_val = self._hash(virtual_key)
self.ring[hash_val] = node
self.sorted_keys.append(hash_val)
self.sorted_keys.sort()
def remove_node(self, node: str) -> None:
"""移除节点"""
for i in range(self.virtual_nodes):
virtual_key = f"{node}#{i}"
hash_val = self._hash(virtual_key)
del self.ring[hash_val]
self.sorted_keys.remove(hash_val)
def get_node(self, key: str) -> str:
"""获取key对应的节点"""
if not self.ring:
raise Exception(
"No nodes available")
hash_val = self._hash(key)
# 二分查找顺时针第一个节点
import bisect
idx = bisect.bisect_left(
self.sorted_keys, hash_val)
if idx == len(self.sorted_keys):
idx = 0 # 环绕到第一个节点
return self.ring[
self.sorted_keys[idx]]
3. 数据过期策略
4. 高可用设计
• 主从复制(Master-Slave)
· 主节点负责写
· 从节点负责读(读写分离)
· 异步复制保证性能
• 哨兵机制(Sentinel)
· 监控节点健康状态
· 自动故障转移
· 通知客户端新主节点
• 集群模式(Cluster)
· 数据分片
· 无中心架构
· 支持水平扩展
第三步 深入讨论(Deep Dive)
面试官可能会追问:
1. 缓存穿透怎么办?
· 布隆过滤器(Bloom Filter)
· 缓存空值
· 请求限流
2. 缓存击穿怎么办?
· 互斥锁(Mutex Lock)
· 热点数据不过期
· 逻辑过期
3. 缓存雪崩怎么办?
· 随机过期时间
· 多级缓存
· 熔断降级
4. 如何保证一致性?
· Cache Aside Pattern
· Write Through / Write Behind
· 最终一致性 vs 强一致性
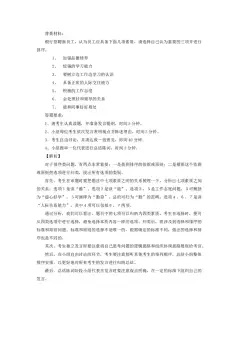
系统设计答题要点:
问题10:"请介绍一下你自己"
为什么这道题最重要?
很多人觉得这道题很简单,随便说说就行。大错特错!
• 第一印象;
• 后续问题的方向;
• 面试官对你的定位。
错误的回答方式:
错误1:背诵简历
问题:面试官已经看过简历了,不想听你复述。
错误2:流水账式
问题:没有重点,没有亮点,像在念日历。
错误3:过于谦虚或过于自大
· 太谦虚 → 显得没自信
· 太自大 → 让人反感
正确的回答框架:过去 → 现在 → 未来。
结构模板(2-3分钟)
【开场】一句话介绍自己(15秒)
"我是XXX,一名专注于XX领域的 软件工程师,有X年经验。"
【过去】1-2个亮点经历(60-90秒)
"在过去的工作中,我最自豪的项目是...我负责了...,面临了...挑战,通过...方法,最终实现了...成果(量化)。"
【现在】为什么来这里(30-45秒)
"我现在希望寻找一个新的机会,因为贵公司在XX领域的布局非常吸引我,特别是你们最近发布的XX产品/技术,这正是我想深耕的方向。"
【未来】你能带来什么价值(15-30秒)
"我相信我的XX经验和XX能力,能够帮助团队在XX方面取得更好的成绩。"
具体示例:
初级工程师版本:
资深工程师版本:
准备清单:
□准备2个版本:1分钟精简版 + 3分钟完整版;
□针对每个目标公司定制:提到他们的产品/技术/文化;
□准备具体的例子和数据:不要说空话;
□练习直到自然:不要背稿子,要像聊天一样;
□录音回放:检查语速、语气、用词。
完整备考策略:30天计划
第1周:打基础(Day 1-7)
第2周:攻克高频题(Day 8-14)
第3周:进阶提升(Day 15-21)
第4周:模拟冲刺(Day 22-30)
30件小事:面试冲刺期的好习惯
坚持这些小习惯,30天后你会感谢自己。
学习类(1-10)
□ 1. 每天至少刷1道题;
□ 2. 每周总结10道题的模式;
□ 3. 每次写代码前先讲思路;
□ 4. 每个算法都要手写一遍;
□ 5. 做完题后写复盘笔记;
□ 6. 学习一个数据结构的底层原理;
□ 7. 看一篇技术博客;
□ 8. 复习昨天的错题;
□ 9. 给自己计时做题(45分钟);
□ 10. 理解"为什么",不只是"怎么做"。
习惯类(11-20)
□ 11. 每天8点前起床;
□ 12. 每天运动30分钟;
□ 13. 保持7小时以上睡眠;
□ 14. 午休20分钟;
□ 15. 少刷短视频;
□ 16. 每天喝够1.5L水;
□ 17. 戒掉熬夜刷手机;
□ 18. 学习时把手机放另一个房间;
□ 19. 每周给自己放半天假;
□ 20. 保持书桌整洁。
面试类(21-30)
□ 21. 每次面试后写复盘;
□ 22. 面试前研究公司产品;
□ 23. 准备3个反问面试官的问题;
□ 24. 每次Mock后问反馈;
□ 25. 准备"自我介绍"的2个版本;
□ 26. 熟悉简历上每个项目细节;
□ 27. 练习白板写代码(不能看IDE提示);
□ 28. 准备系统设计1-2个完整案例;
□ 29. 准备STAR法则行为面试例子×5;
□ 30. 保持自信,相信自己的准备。
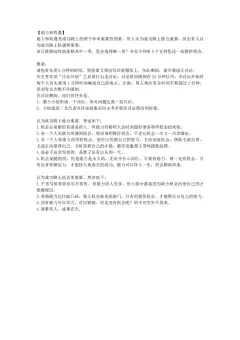
十大问题完整回顾:
如果这篇文章触动了你,点个「在看」吧!
也欢迎分享给正在迷茫的朋友~
我们希望每一篇分享都能真正帮到正在求职的你。如需转载,请提前联系并注明出处,未经允许请勿随意搬运哦~
祝大家面试不停, offer多多!
● ● ●
-END-