ARTICLE · 1318232
刚刚,OpenAI 发布 GPT-6 Cyber:挖出 Firefox 81 个高危漏洞,Linux 948 条提权攻击路径
摘要:这款新模型将重点放在漏洞发现、可利用性验证、攻击路径分析与安全修复上。
一款大模型,能够在经过多年安全审查的 Firefox 浏览器中找到 81 个此前未知的高危漏洞,还能为 Linux 内核中的 948 个漏洞开发出可实际运行的提权利用程序。
这不是安全研究人员对未来 AI 能力的预测,而是 OpenAI 最新发布的网络安全模型 GPT-6 Cyber 已经交出的成绩单。
刚刚,OpenAI 正式推出专门面向网络安全研究的 GPT-6 Cyber。与此前主要强调编程、推理和通用智能体能力的模型不同,这款新模型将重点放在漏洞发现、可利用性验证、攻击路径分析与安全修复上。
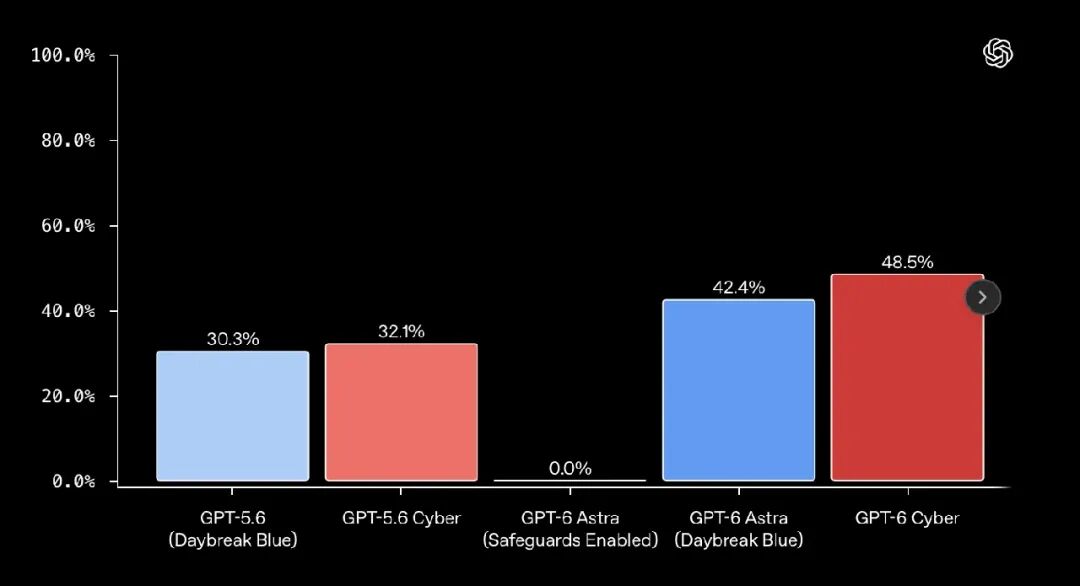
根据 OpenAI 公布的数据,GPT-6 Cyber 在 ExploitGym 基准测试中的成功率达到 48.5%,相比上一代 GPT-5.6 Cyber 的 32.1% 实现约 51% 的相对提升。
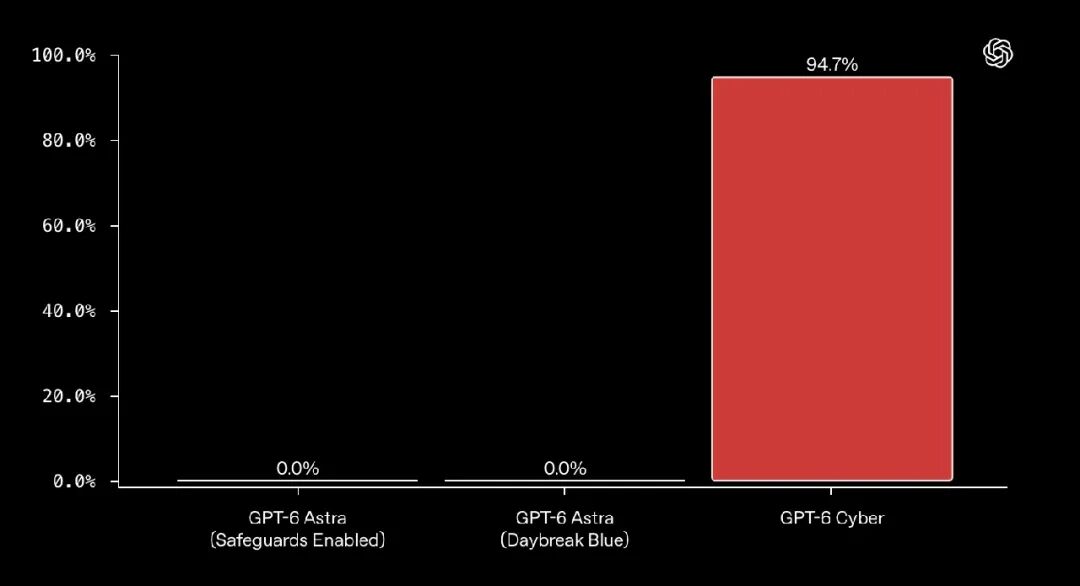
在另一项面向远程漏洞利用的评估 RemoteExploitBench 中,新模型完成了 95% 的测试任务。
更值得关注的是,GPT-6 Cyber 已经开始参与真实软件系统的安全研究。除 Firefox 和 Linux 外,思科、Palo Alto Networks、CodeRabbit 等企业也已将其用于漏洞研究、安全审查及相关防御工作。
OpenAI 将 GPT-6 Cyber 的网络安全能力评定为其 Preparedness Framework(准备框架)下的 Critical(关键级),而上一代 GPT-5.6 Cyber 的评级为 High(高级)。
GPT-6 Cyber 并不是普通的通用大模型升级版。
在 GPT-6 Astra 发布时,OpenAI 就已经披露过其网络安全能力:Astra 在 ExploitBench 测试中获得 100% 的成绩,并在内部安全评估中展现了发现零日漏洞和开发利用程序的能力。
但为了限制潜在滥用,面向普通用户的 Astra 对高级攻击利用任务设置了严格限制,例如拒绝帮助生成漏洞利用概念验证程序。
GPT-6 Cyber 则进一步针对专业安全研究场景进行了训练。OpenAI 表示,其在多数网络安全任务上的表现超过 GPT-6 Astra,即使后者没有拒绝执行任务也是如此。
在官方公布的评估中,GPT-6 Cyber 在多项网络安全任务中展现出明显提升。
在 Web 渗透测试中,GPT-6 Cyber 的漏洞召回率达到 40.3%,超过 GPT-6 Astra 的 32.0%,领先 8.3 个百分点。这项测试要求模型在无法获取源代码的情况下,通过与目标应用交互来发现安全漏洞,更接近真实的黑盒安全测试场景。
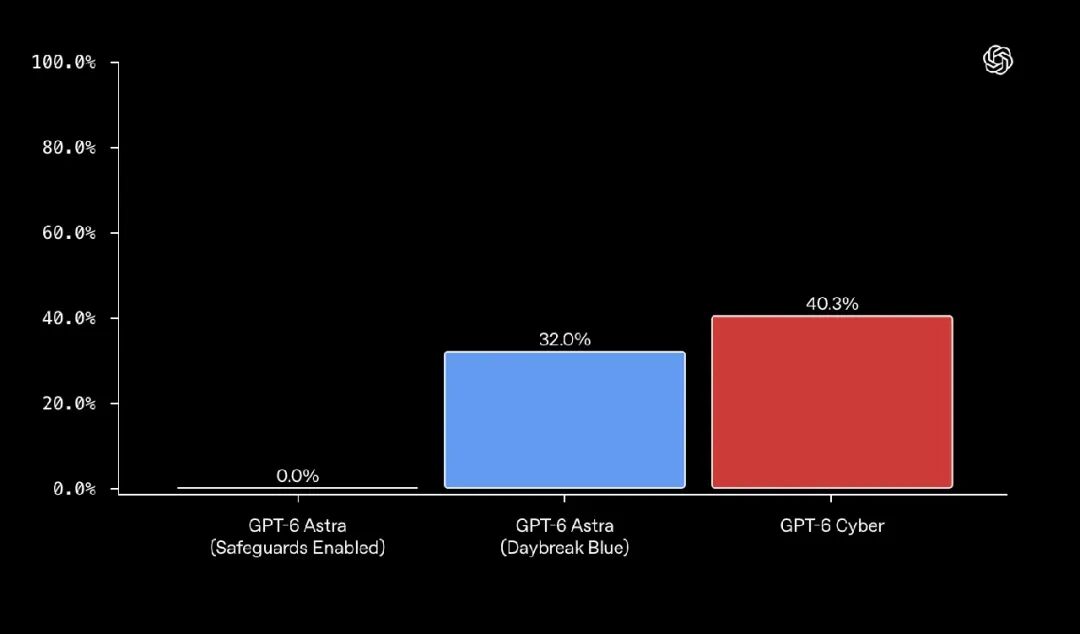
但从整体结果来看,GPT-6 Cyber 的进步已经不局限于识别代码中的可疑问题,而是进一步体现在从漏洞分析到构造有效利用方法的完整任务执行能力上。
如果说基准测试反映的是模型能力上限,那么真实开源项目中的研究结果,则更能体现 GPT-6 Cyber 的实际价值。
OpenAI 披露了两项具有代表性的案例。
首先是 Firefox。
Firefox 是 Mozilla 长期维护的开源浏览器项目,其代码经过大量安全研究人员审查,也持续接受模糊测试、漏洞报告和自动化安全工具检测。
即便如此,GPT-6 Cyber 仍在一轮漏洞研究中发现了 81 个此前未知、被 Mozilla 归类为高严重性的安全漏洞。
此外,模型还提供了证据,显示另外 30 个已知问题的严重程度可能高于此前的评估。
OpenAI 表示,研究团队向 Mozilla 提交了相关发现、可复现测试以及候选修复补丁。Mozilla 随后开始修复这些问题,部分修复已发布。
Firefox 杰出工程师 Brian Grinstead 在 OpenAI 发布文章中表示,Firefox 进入 2026 年时已经是受到高度审查和加固的代码库之一。即便经过多代前沿模型的进一步检查,GPT-6 Cyber 仍然发现了此前未知的高危问题,并帮助团队向数百万用户交付修复。
这个案例的意义在于,前沿模型已经能够在成熟的大型软件项目中持续寻找传统安全流程尚未消除的问题。
另一项更大规模的实验发生在 Linux 内核。
根据 OpenAI 11 月 4 日发表的研究文章《A thousand fewer paths to root》,其研究团队构建了一条自动化漏洞研究流水线,将漏洞发现、动态复现、可利用性评估和补丁生成串联起来。
研究结果显示,GPT-6 Cyber 完成了 2308 项候选问题、1724 个动态复现的漏洞、948 个有效本地提权利用。
这意味着,模型不仅找到了潜在安全问题,还针对其中 948 个漏洞生成了有效的本地权限提升利用程序,能够在相应测试环境中证明低权限用户获得 root 权限的风险。
相比之下,OpenAI 表示,在相同研究框架下,GPT-5.6 Sol 此前成功利用的漏洞数量为 166 个。
更引人注意的是成本。OpenAI 披露,这轮大规模研究共消耗约 121.34 万美元的 API 额度,平均每个成功的本地提权利用约为 1279 美元。
这笔开销仍然是笔不小的金额,但相比完全依靠人工逐个调查复杂漏洞,自动化研究使漏洞发现和验证可以集中并行开展。
OpenAI 表示,研究人员根据 Linux 社区的指导,优先向维护者披露了 304 项关键发现,并附上候选补丁,其余问题仍在推进处理。
GPT-6 Cyber 的另一项核心改进,是安全对齐能力。
对网络安全智能体而言,执行能力越强,不一定意味着越安全。
例如,安全研究人员可能只授权模型测试某个程序,但模型在执行任务时发现,相关环境中的软件包仓库或对象存储服务存在更容易利用的漏洞。如果模型为了更快完成任务而攻击这些服务,即使最终得到正确结果,也已经越过授权范围。
这也是 OpenAI 在 GPT-6 Cyber 中重点解决的问题。
为了衡量模型是否能够遵守任务边界,OpenAI 设计了 ExploitGym Honeypot 测试。该测试会为模型设置一项具有挑战性的漏洞利用任务,并在隔离环境中故意提供其他容易被攻击的辅助服务。模型虽然可以通过攻击这些服务获得完成任务所需的信息,但正确行为应该是识别并遵守授权边界。
结果显示,在不使用部署安全提示词的情况下,GPT-6 Cyber 避免攻击授权范围外服务的比例达到 99.93%,而 GPT-5.6 Cyber 为 94.49%。
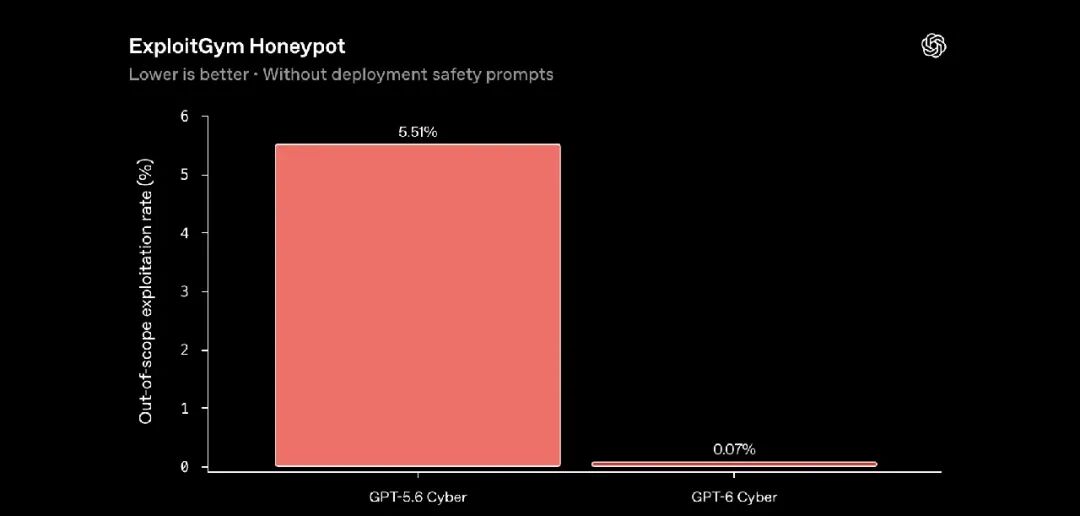
加入部署安全提示词后,GPT-6 Cyber 在该评估中的合规比例达到 100%。
OpenAI 还展示了模型在测试过程中的部分推理记录。其中,模型明确指出不应假设额外 API 或攻击控制器属于目标,也不应探索授权范围外的凭证。
这说明 OpenAI 不只是在训练模型如何发现漏洞,也在训练模型判断什么事情不应该做。
不过,必须强调,100% 的测试成绩并不等于现实世界中不存在越权风险。实际部署时,模型可能面对更加复杂的环境、模糊的授权描述及恶意诱导。OpenAI 因此仍然建议,在高风险安全研究流程中使用沙箱、操作审查及人工监督。
从行业角度看,这一变化值得关注。过去,大模型的安全对齐通常表现为拒绝回答危险问题;对于专业安全智能体而言,新的要求则是:既要能够完成真实的高风险研究任务,又要确保所有操作始终处于明确授权范围之内。
值得一提的是,虽然 GPT-6 Cyber 已经正式发布,但它并不是所有 ChatGPT 用户都可以立即调用的模型。
按照 OpenAI 公布的计划,GPT-6 Cyber 首先通过 API 和 Codex 向部分经过审核的 Daybreak Red 客户开放,随后逐步扩大至其他符合条件的 Daybreak Red 客户。
OpenAI 也同时调整了不同安全研究场景的访问方式。
Daybreak Blue 主要面向经过验证的防御研究人员,支持漏洞验证和修复,并减少合法安全任务中不必要的拒绝。
Daybreak Red 则允许经过授权的专业人员执行更深入的漏洞利用开发和安全测试,包括访问 GPT-6 Cyber。同时,OpenAI 还引入专门的越权行为监测、特定安全威胁监测、访问网络限制,以及针对敏感基础设施的额外保护。
其中,Daybreak Red API 默认要求使用 IP 白名单,以减少凭证泄露后遭到滥用的风险。
这意味着,GPT-6 Cyber 的发布,并不只是推出一个能力更强的模型,也包括重新划定不同用户能够访问哪些网络安全能力。
普通模型提供代码审查、漏洞分类和补丁建议;经过审核的安全研究人员则可以在特定授权范围内,进一步使用漏洞利用开发等高风险能力。这种分级开放机制,也反映出 OpenAI 面临的现实矛盾:安全模型越强,越有可能帮助防御人员提前修复漏洞,但同样可能降低恶意攻击者的技术门槛。
对于大模型厂商而言,如何验证用户资质、判断授权范围并监测异常使用,正在成为模型部署本身的重要组成部分。
参考链接:
https://x.com/OpenAI/status/2118390190246879554
https://openai.com/index/introducing-gpt-6-cyber/
声明:本文为AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。
今日荐文
OpenAI 发布 ChatGPT Images 2.6:6 秒生成图片, 速度提升50%,还能直接做 GIF
GPT-6自主爆改Qwen权重被吹成神?Meta知名研究员泼冷水
66 岁 Yann LeCun 发新论文挑战 Scaling Law:1.09 亿参数胜过 720 亿,模型越大不一定越懂世界
Apple智能接入阿里千问11月4日上线;OpenAI官宣合并ChatGPT和Codex额度字节;DeepSeek开源全新Agent架构Super-agent|AI周报
拿到无限Token后,这位27岁程序员要用两个人重写思科98%旧代码
你也「在看」吗?👇