ARTICLE · 1321098
DeepSeek 要建插件市场,意欲何为?
11 月 5 日晚上,DeepSeek Harness 团队在自己的对外渠道发了一段话,没有发布会,也没有倒计时海报。
三个数:日活 154 万,日消耗 Token 约 92 万亿,将建设官方插件市场。
前两个数被转发截图截烂了。第三个才真正值得琢磨——一个开源免费的壳,为什么要自己搭市场?
一种读法是它缺新收入。另一种读法是插件的活没人替它干,92 万亿的用量就到头了。两种都成立,区别在于你信不信一个开源的东西能把市场做起来。
🟡92 万亿,你其实一次都没看见
一个汉字大概占 1.5 个 Token,92 万亿折成字接近 60 万亿汉字。
一本 90 万字的《三体》全集六十多万 Token。92 万亿除以 154 万,平均每个用户一天 597 万 Token,等于一天读完十本。
人干不动这个量。是真有人在拿它跑批量任务:整仓代码扫描、几百个文件的分析、成批文档生成。这些活以前要排机器、写调度脚本,现在丢给 Agent 跑一夜。
这里有个大部分人没往深处想的事:你身边没人整天抱着 AI 聊天,但这个用量是真的。
因为它挪到后台去了。合同比对、工单分类、财报生成、代码审查,这些活干完了没人发朋友圈。你在前台看到的那个聊天框,只是冰山露出水面的一点。
所以"AI 到底有没有用起来",看 App 榜单看不出来,看 Token 消耗才看得出。
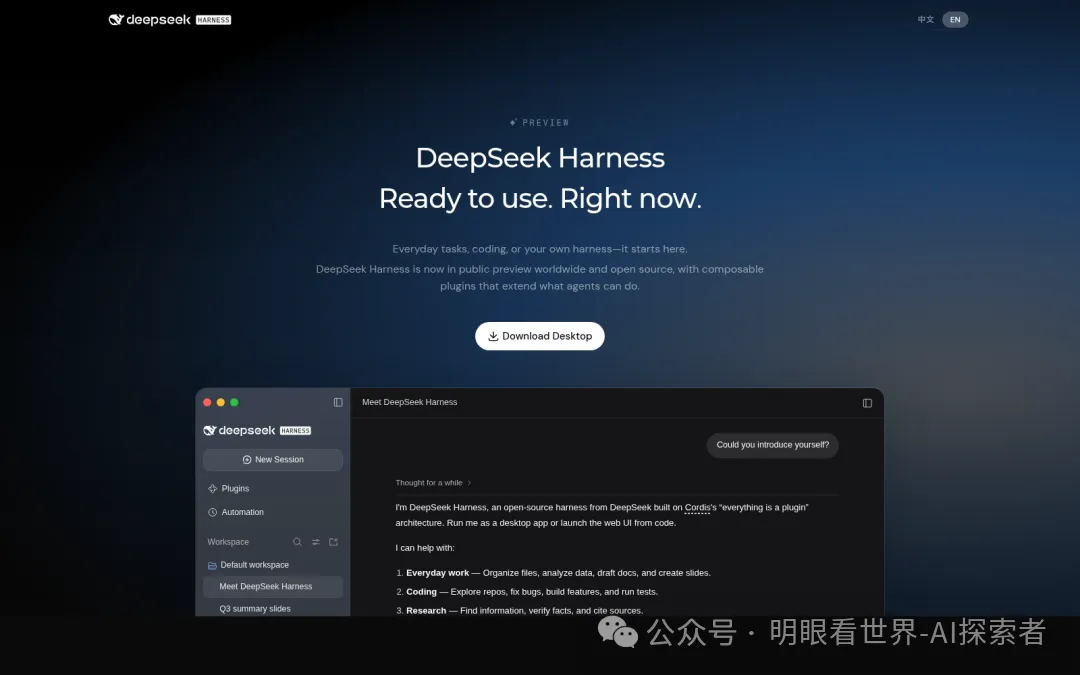
官方演示页右下角蹲着一个小图标,写着 Preview,一直没摘。两个半月做到这个用量,还挂着预览的牌子。
🟡154 万不是用户,是供给方
官方写明了统计范围是"以使用官方 API 的用户"。IT 之家 11 月 5 日的报道把这个口径原样保留了。
也就是说,这 154 万不是 154 万个在手机上问问题的人,是 154 万个把 Key 塞进脚本、塞进工具、塞进自己产品里的人。
普通用户会跑,因为产品换了。开发者不会跑,只要价格和稳定性没变——他们的代码里写死了这个接口。
这是它敢做市场的第一个底气:手上这批人不是来尝鲜的,是已经把活挂在上面的。
🟡为什么是现在
时间线很短:8 月 13 日 Harness v0.1 上线,9 月 29 日桌面端发布,11 月 4 日就是这组数。
两个半月,一个壳能跑通到这个用量,说明底层已经稳了。但"稳了"不是理由,"稳了还不够"才是理由。
这里有三股压力同时到顶。
第一,壳本身没有边界。它能干的四类活——办公、写代码、查资料、批处理——每一类背后都是插件。DeepSeek 不写插件,插件就得等别人写。
第二,别人已经在写了,只是没写给它。MCP 这套协议出来一年多,外面的工具生态已经成型,谁都能接。这意味着 Harness 现在的位置很尴尬:不是唯一选择,只是一个新来的客户端。
第三,用量涨得再快,没有新场景就会撞天花板。92 万亿是这 154 万人把现有的活搬上来跑出来的。他们的活跑完呢?
三条压力指向同一件事:再往下走,靠的不是模型更强,是有多少活能在它上面被干。
所以不是"要不要建市场",是"不建就停在原地"。
🟡图什么:一个别人没往下想的地方
先把最常见的答案排除掉。
很多人第一反应是抽成——插件卖钱,它分一道。这个答案经不起推:插件大多卖不了几个钱,抽成规模有限,撑不起一家公司。
真正的答案藏在协议里。
Harness 跑的插件,本质是 MCP Server。MCP 是 Anthropic 定的一套协议,开发者社区管它叫"AI 世界的 USB-C"——工具按这个协议包装一次,任何支持它的客户端都能直接调。
这句话反过来读就是问题所在:插件搬得走。
今天装在 Harness 里的工具,明天换成别的客户端,一样能跑。这不是漏洞,这是这套协议设计的目标。
所以那个最常被问的问题——"插件离了 DeepSeek 还能不能活"——答案是:本来就能活。
那它图什么?
图的是默认值。
插件虽然搬得走,但默认指向哪家模型,是装的那一刻定下的。绝大多数人不会去翻配置文件——装好能用,就一直用着。
这跟浏览器默认搜索引擎是同一套逻辑。搜索引擎谁都能换,但九成的人从来没换过。微软当年为了把 Edge 的默认搜索设成必应,愿意付那么大的代价,图的就是这个。
所以它建的是入口,不是围墙。围墙靠"你走了带不走东西",入口靠"你来了就不用走"。
入口的生意难做得多——要天天被比较,被更便宜的、更懂某个行业的、界面更好看的对手比。但入口一旦站住,比围墙结实。
至于 Token 会不会因为插件而多烧,那是副产品,不是目的。目的只有一个:让装插件的那个人,默认不用选。
🟡同样做 AI 工作台,腾讯走的是另一条路
把腾讯的 WorkBuddy 摆在旁边看,差别就出来了。
WorkBuddy 是腾讯做的 AI 工作台,官网首页那句话说得很直白:描述你要什么,它就开始干,全程你能看着进度,最后交成品。深度调研、写文档、做表,都是它自己跑完。
打开它的客户端,左边一列是:新任务、助手、Experts/Skills/Connectors、自动化、资料库。
有技能,有连接器,有专家角色。没有市场。
它的模型是内置的——腾讯云自己的教程写得很清楚,国际版内置 Claude、GPT-5 这些国际大模型,国内用户不用翻墙就能用。
这两件事放在一起,路线就很清楚了:
腾讯把能力和模型都装进产品里,卖的是"活干完了"这个结果。用户不需要知道底下跑的是谁的模型,也不需要自己拼插件。它收订阅费,用户换不换模型跟它没关系。
DeepSeek 反过来——壳开源、可以自己跑、插件谁都能写。它不卖结果,卖的是壳被用起来之后消耗掉的 Token。
所以腾讯没有"抢默认值"的焦虑,DeepSeek 有。这不是风格差异,是收入结构决定的:卖成品的人不怕你搬走,卖用量的人怕。
换句话说,"抢默认值"不是这个行业的共识做法,是 DeepSeek 在它自己那条路上必须做的事。
这一层想明白,前面那句"插件搬得走"就不可怕了——它从来没打算靠插件拦人。
🟡官方一个字没说的部分
到这一步,能查到的只有"将建设官方插件市场"这几个字。
分成比例没有,审核标准没有,收费方式没有,上线时间也没有。
这几点决定市场是热闹还是空转:抽成的话,作者愿不愿意来;完全不抽,市场靠什么活;只上官方插件,那它就是个功能商店,不是市场。
还有个更实际的:插件自己调模型也要花钱。这笔钱算谁的——作者自掏、用户按次付、还是 DeepSeek 补贴,直接决定第一批插件长什么样。
🟡说回那 92 万亿
两个半月,154 万 API 用户,一天 92 万亿 Token,国内没有第二个。
需要说清楚的是:这三个数都是 DeepSeek 自己披露的,没有第三方核对过。口径也只有一个"官方 API 用户",具体怎么统计、含不含免费额度,外面看不到。
但这个规模的真正意义,不在它有多大,在它证明了一件事:中国的 AI 用量已经不在聊天框里了,在生产流程里。
往后看这一年,判断一家 AI 公司的位置,看 App 榜单意义越来越小,看它每天被调用多少次、被谁调用、调用完解决了什么活,才是真的。
DeepSeek 现在做的选择是:把标准让给别人,把价格压到底,把入口做到最大。
能不能成,不看它建不建市场,看一年后那些基于 MCP 的工具,是默认先适配 DeepSeek,还是顺手也适配一下。
我的判断是:市场会开,抽成会很少或者干脆不收。它图的从来不是那一块,是每个插件的默认配置里,写着它的名字。
这个判断有被推翻的时候:如果一年后用户普遍勤快地改配置、或者有对手能做到强制迁移,那"抢默认值"这条路就走不通。到那时候它得回来重新回答一次"图什么"。