ARTICLE · 1355805
DeepSeek 把 App 的能力全开放成了 API,客户端不用再自己接搜索和抓取了
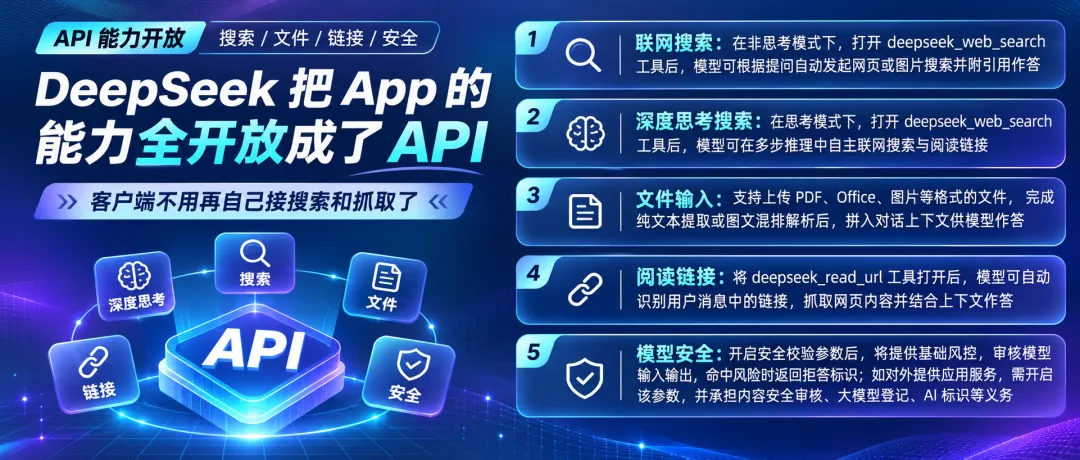
11 月 13 日晚,DeepSeek 放出了一套"全家桶应用 API"。过去要靠客户端自己接的联网搜索、网页抓取、文档解析、语音转写和语音合成,现在都有官方接口,工具调用和上下文拼接由服务端完成。
做 AI 应用的团队过去一年都在补同一套课。接一个搜索 API,写一个抓取脚本,处理超时重试,再想办法把网页正文塞回上下文。现在这段可以交给服务端。
01 开放的东西分三层
内置工具,在原来的对话请求里加参数就有。联网搜索是 deepseek_web_search,阅读链接是 deepseek_read_url,模型安全是 safety_check。还有两个公告里没细说的,title 让模型顺手生成一段对话标题,latest_reminder 把当前日期、用户位置和语言告诉模型,答案能贴着用户的情况说。Demo 的设置面板里就能改语言和位置。
五个独立接口,Search、Fetch、OCR、ASR、TTS,都能单独调,也能自己拼成工作流。Search 走 DeepSeek 自家搜索引擎,返回带相关度分、站点名和发布时间的结果。Fetch 抓单个网页,转成 Markdown 交回来。OCR 只出文字和坐标,文件不进对话。ASR 把音频转成文字,TTS 把文字读出来。
单独调 Search 还能用一套搜索语法,site: 限定站点,- 排除词,"..." 精确短语,lang: 限定语言,after: 和 before: 卡发布日期。做检索增强的团队能省掉不少过滤逻辑。
一个开源 Demo,静态页面,浏览器直连 api.deepseek.com,不需要自己的后端。
常用端点放一张表,存下来省得翻文档。
- 用途
对话,Anthropic 格式 · 端点: POST https://api.deepseek.com/anthropic/v1/messages - 用途
对话,Responses · 端点: POST https://api.deepseek.com/responses - 用途
对话,Chat Completions · 端点: POST https://api.deepseek.com/chat/completions - 用途
搜索 · 端点: POST https://api.deepseek.com/v1/tools/search - 用途
网页抓取 · 端点: POST https://api.deepseek.com/v1/tools/fetch - 用途
OCR · 端点: POST https://api.deepseek.com/v1/tools/ocr - 用途
语音识别 · 端点: POST https://api.deepseek.com/v1/tools/asr - 用途
语音合成 · 端点: POST https://api.deepseek.com/v1/tools/tts - 用途
文件上传与解析 · 端点: POST https://api.deepseek.com/files
模型是 deepseek-flash,实际版本 DeepSeek-V4.1-Flash-1017。老名字 deepseek-v4-flash 仍然收,那个模型已经退役,请求会转到新版本上按 Flash 的价计。Messages、Responses、Chat Completions 三个协议都支持。
上下文怎么回来的,值得单独说一句。搜索和抓取都跑在服务端,客户端一个工具都不用执行。用户消息里的链接被读回来后,正文并不直接出现在响应里,而是放在 signature 字段里加密,下一轮把这个字段原样传回去,服务端才把页面还原进上下文。客户端要做的只有两件事,把返回的块渲染出来,把上一轮回复原样传回去。
02 四个容易踩的坑
这些细节公告里没有,文档里写着。
思考模式下开了联网搜索,用户消息里的链接就不单独读了。 规则是,开启思考模式并声明 deepseek_web_search 之后,这一轮走深度思考搜索,链接不再单独处理。要读链接,要么关掉思考模式,要么只声明 deepseek_read_url。官方给的例子是让模型比一比埃菲尔铁塔和东京塔谁高,它会自己搜、自己开页面、自己到页面里找数字,全程二十次左右的工具调用。
开了这些工具,采样参数会被服务端忽略。 Messages 接口忽略 temperature、top_p、top_k、stop_sequences 和 thinking.budget_tokens,Chat Completions 忽略 temperature、top_p、frequency_penalty、presence_penalty、stop、seed、n。temperature 调不动了,做文案风格控制的团队会少一根旋钮。
tool_choice 不能指名这两个工具。 指名就返回 400。是否联网由模型自己判断,把 tool_choice 设成 none 会把搜索和读链接一起关掉。
读链接只看最后一条用户消息。 同一条消息里重复出现的链接只算一次,最多取前 10 个不同的链接,具体读哪几个还是模型说了算。
03 钱怎么算
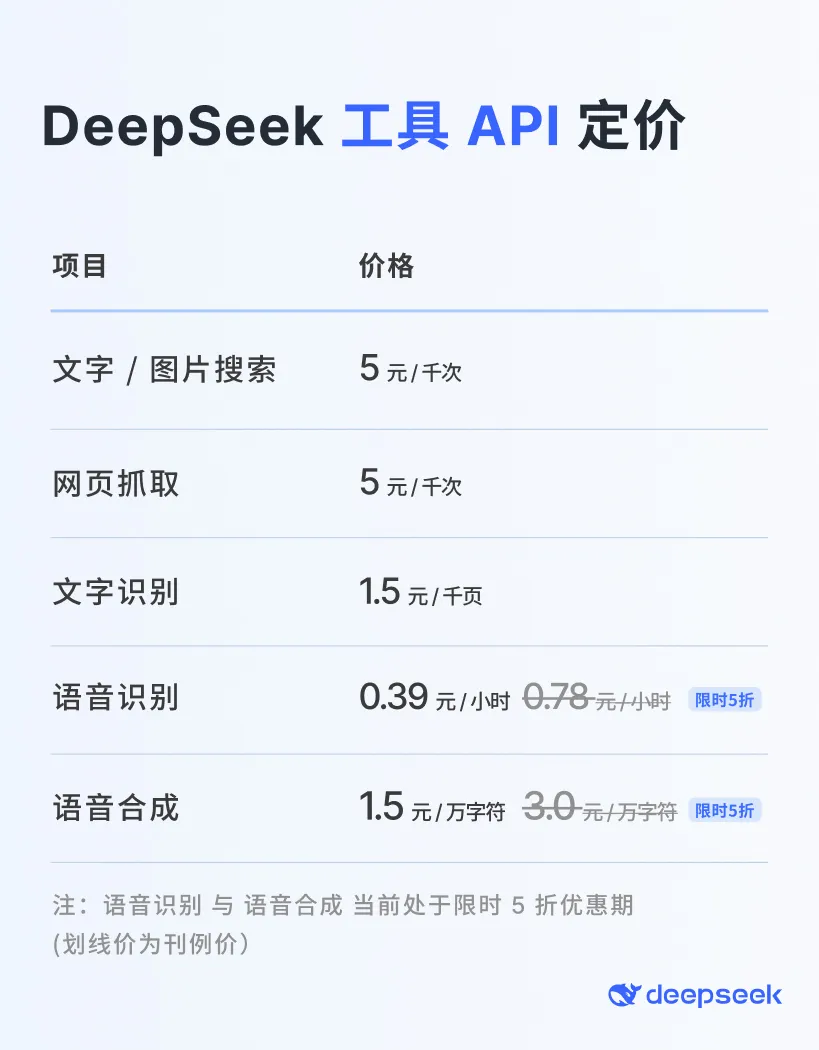
工具按次收费,跟 token 分开结算。
- 工具
文字与图片搜索 · 计费单位: 千次 · 人民币: 5 元 · 美元: $0.75 - 工具
网页抓取 · 计费单位: 千次 · 人民币: 5 元 · 美元: $0.75 - 工具
文字识别 OCR · 计费单位: 千页 · 人民币: 1.5 元 · 美元: $0.225 - 工具
语音识别 ASR · 计费单位: 小时 · 人民币: 0.39 元 · 美元: $0.058 - 工具
语音合成 TTS · 计费单位: 万字符 · 人民币: 1.5 元 · 美元: $0.225
语音两项是限时五折,原价分别是 0.78 元和 3 元。
几个容易算错的地方。搜索和抓取按成功的请求次数收费,返回几条结果不影响单价,count 只控制条数。失败的请求、搜不出结果的搜索、超时的请求都不计费。OCR 按成功识别的页数算,失败和超时不计。ASR 按音频时长算到秒,不足一秒按一秒。TTS 一个中文字算两个字符,字母数字空格各算一个。
拿这些单价算几笔账。一次网页抓取 5 厘钱,深度思考搜索最多约二十次工具调用,就算每次都计费,一次问题最坏 1 毛钱。听 10 分钟语音 6 分 5 厘,一段 1000 汉字的播报 3 毛钱。OCR 一份 50 页的报告 7 分 5 厘。
Token 那一头是零头。官方文档里那个开了联网搜索、安全校验和对话标题的请求,输入 9078 tokens,输出 1686 tokens。deepseek-flash 闲时输入 0.15 每百万 tokens,输出 0.6 每百万,高峰翻倍。折算下来这次提问的 token 费两美分上下,按七块出头的汇率合一分多人民币。DeepSeek 把高峰定在 UTC 凌晨一点到四点、早上六点到十点,换成北京时间是工作日的上午九点到十二点、下午两点到六点,周末和节假日全天按闲时算。
所以做预算的时候要倒过来看。一次带联网的提问,搜索和抓取的按次费用是 token 费的好几倍。
04 谁会先拆代码
已经在自建"搜索加抓取加拼上下文"这套管线的团队,拆掉的就是这段。一个具体场景是问答类产品,模型问一句要查三个来源,团队自己写循环去调搜索、调抓取、处理失败重试、把正文按格式拼回 prompt,然后逐个会话缓存。现在这段由服务端做,团队只留渲染逻辑。
做文档问答和票据识别的团队拿到的是 OCR 和文件解析。PDF、Word、PPT 和常见图片格式都能传,上传时选 text_recognition 只抽文字,选 rich_layout_recognition 连图表一起切出来按原位给模型。解析在上传时按页计费,成功才收钱,客户端中途断开,解析照样跑完,跑成功照样计费。
做语音应用的团队拿到的是 ASR 和 TTS。识别支持 21 种语言,合成支持 10 种,两个音色 stella 和 tide。TTS 还能用 WebSocket 一边生成一边合成,模型还在吐字就能开始播。
做检索增强的团队可以把 Search 和 Fetch 当成一个现成的外部知识源。Fetch 返回的是 Markdown,切分、embedding、拼 prompt 都按原来那套流程走,接一个新接口而已。另一条路是干脆不自己拼,让模型在 deepseek_web_search 里自己找、自己开页面、自己从页面里摘句子。
做企业内部助手的团队能少写不少界面逻辑。对话标题自动生成,历史列表不用自己命名,把用户的日期和位置一起喂给模型,答案能对上他所在时区和当地情况。
只做纯文本对话的团队,这次基本没影响。
这个我感触比较深,我们公司就有做实际的项目
1、模型爬取网络信息的,模型需要调用很多遍,有的网站返回的内容还是js内容,通过python fetch无法解析,需要安装第三方依赖包使用,而且网站的数据除非提前知晓一些,全网查询的话,搜索引擎会产生拦截,现在好多网站做了GEO优化,实际的内容质量不好,包括其他的边界处理,异常中断
2、文档问答的,票据识别的也做过,需要调用三方的TextIn或者百度OCR的识别文档,然后单独抽取对应的字段,形成一个结构化的数据,需要多步骤处理
05 还没解决的几件事
合规责任没有转移。safety_check 设成 high 只是基础风控,内容安全审核、大模型登记、AI 标识这些义务还在服务提供方自己身上,官方在文档里重复写了好几遍。
流式场景下处理拒答很麻烦。审核是在模型输出完之后才做的,已经流出去的字撤不回来。客户端得自己把显示出来的回答删掉,换成自己的拒答文案。审核用的 token 按输出 token 计费,输入被判风险直接返回 400 的话,输入 token 也照收。
文档解析出来的全文在多轮对话里一直占着上下文,一次请求最多 20 个文档、文本合计 8 MiB,超了直接 400,不做静默截断。文件本身的上限是 100 MiB 和 1000 页。传上去的文件和解析结果都下载不回来,要留底得自己另外存一份。
还有一批能力边界。Search 接口暂时不支持图片搜索,图片搜索只走 deepseek_web_search 里那条路。ASR 不支持流式,最长 120 秒、8 MiB。TTS 不支持变速,也不支持合成中断后接着来。抓取受目标站点的可用性和访问策略限制,403 和 404 都会出现。
最后提醒一句,Demo 把 API key 放在浏览器的 localStorage 里,对话记录放在 IndexedDB。它适合演示,不适合直接搬到生产环境。
06 想看效果最快的一步
Demo入口https://cdn.deepseek.com/chat-demo ,源码 https://github.com/deepseek-ai/chat-demo ,MIT 许可。仓库构建出来是 dist目录,解压双击index.html就能跑,前提是浏览器允许 file:// 页面上使用本地存储,并且 API 侧放行跨域请求。
Demo已经做好的东西不少。多会话和自动标题、改写提问、重新生成、消息分支切换、流式回复、思考过程展示、搜索和引用、拖拽和粘贴上传附件、语音输入和朗读、Markdown 和代码高亮、KaTeX 公式和 Mermaid 图、中英文界面、明暗主题、手机端布局、聊天记录导入导出。导入 DeepSeek 导出的历史对话,可以直接接着聊。公告里那句"1:1 复刻出完整的 DeepSeek App",落到这份 Demo 上大致就是这个样子。
想验证的话,拿自己平时真会问的问题跑一遍,尤其带上链接和 PDF 那种,看服务端拼出来的上下文是不是你要的那样。
如果有什么问题,欢迎评论留言讨论,看到会回复。如果这篇文章对你有帮助,欢迎关注我的微信公众号【一行梦境】,我会在那里分享更多深度内容和实用技巧。