ARTICLE · 1363978
ESP32原理|从一行 C 源码到 Flash 镜像:编译、打包、搬运与 XIP
前两篇把指令集本身讲完了:合同怎么定,两套方言怎么分工。还剩一个问题悬着——编辑器里的一行 C,怎么变成能烧进 Flash 的镜像。
这段路对主程序和协处理器程序同时成立。两条编译支流各自产出文件,最后被打包进同一个镜像,一次烧录、一起上电。
本篇沿流水线走一遍:两条支流怎么汇合,ELF 为什么有两副面孔,镜像怎么拼,Flash 上的地址怎么排;最后用一个 GPIO 边沿计数例程,把地址推导、加载、启动串成一次真实运行。
说明:本篇参数与配图整理自乐鑫官方公开资料,是 ESP32-S3 指令系统专题的第三篇。
01
两条支流,一个镜像
一次正常构建里,实际跑着两条并行的编译支流。
主程序支流走的是熟路:C/C++ 源文件交给 Xtensa 交叉编译器,产出 ELF。协处理器支流另起一条:ULP 源文件交给 RISC-V 工具链,先得到 ULP 侧的 ELF,再用 objcopy 抽成纯二进制。
两条支流在"链接主程序"这一步汇合。协处理器二进制被当作一段数据嵌进主程序镜像,随主程序一起烧录——它不是被"安装"进去的,而是被"打包"进去的。
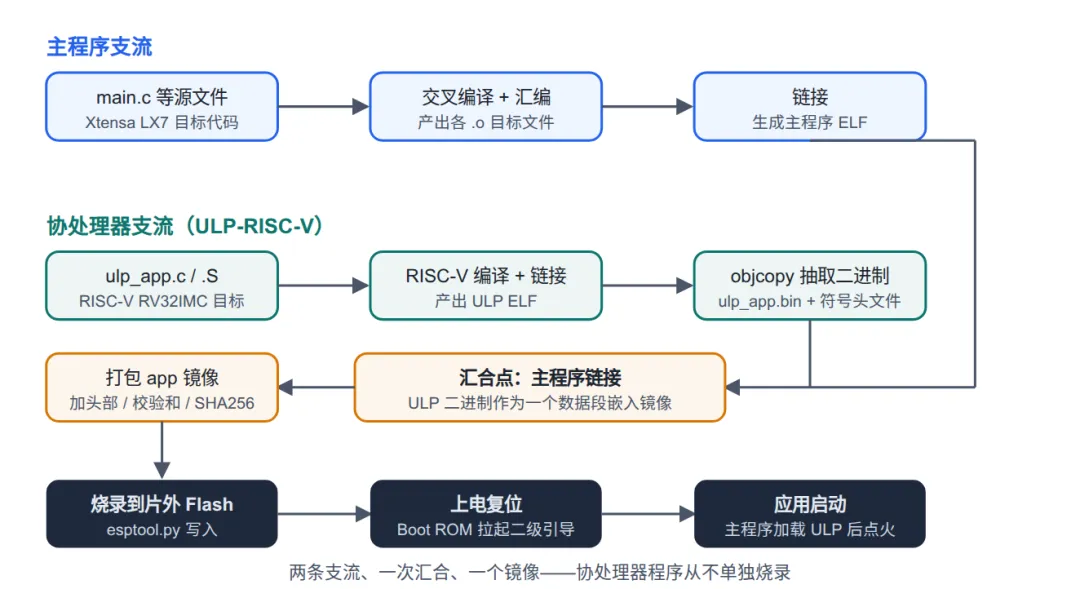
▲ 两条编译支流:ULP 侧的产物没有特殊格式,只是一个普通数据段,让它在运行时跑起来的是加载与启动调用
这里有个容易误解的点:ULP 程序在编译期并不"进入"协处理器的执行位置。它只是躺在主镜像里,等主 CPU 调用加载函数,才被复制到 RTC 慢速内存。编译解决"放到哪",运行才解决"从哪开始跑"。
02
ELF 的两副面孔
支流的产物是 ELF(可执行与可链接格式)。理解它只需要一个比喻:一物两卖,同一个文件卖给两个买家。
第一副面孔叫链接视图,卖给链接器(把各编译产物拼成一份完整程序、排定最终地址的工具)和调试器(单步跟踪运行、查变量查寄存器的工具)。文件按 section(节)组织:.text 放代码、.rodata 放常量、.data 放已初始化数据、.bss 放未初始化数据。每个节是独立货架,由节头表索引。
第二副面孔叫加载视图,卖给加载器。文件按 segment(段)组织:若干相邻的节被合并成一段,由程序头表给出"这段该装到哪个地址"。加载器只看程序头,从不关心里面有哪些节。
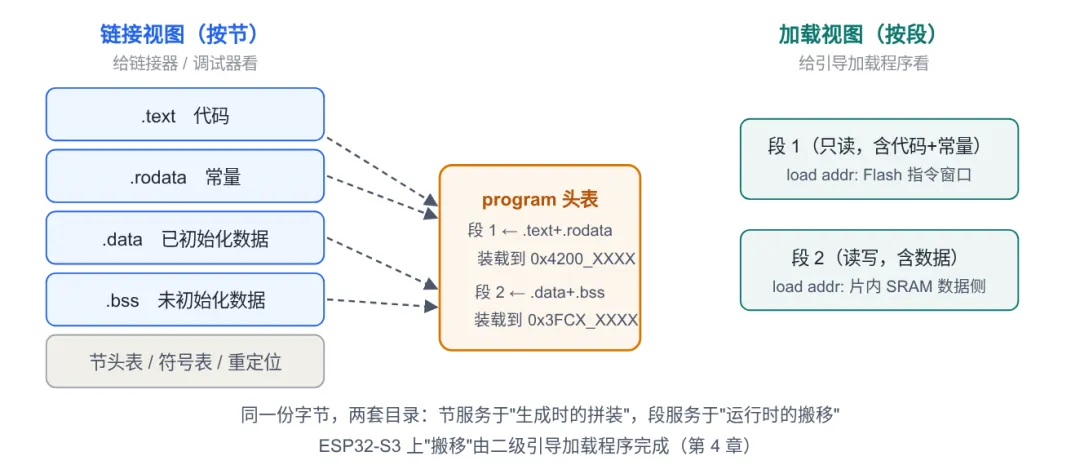
▲ 一个文件、两套索引:链接视图按节切,加载视图按段合,程序头表记录两者的映射与装载地址
读反汇编看的是节,烧进芯片走的是段。分不清这两个词,就会在"为什么 .text 被拆成了两段"这类问题上卡住。
03
镜像怎么拼,每段去哪
主程序 ELF 就绪后,构建系统还要做最后一层封装:应用镜像。它不是 ELF 的简单拷贝,而是一个面向"逐段搬运 + 校验"的扁平结构。
结构可以一句话说完:一个镜像头,后面跟着若干"段头 + 数据"的重复单元,尾部是校验和,按 16 字节对齐补零,再往后是可选的 SHA-256 附录。
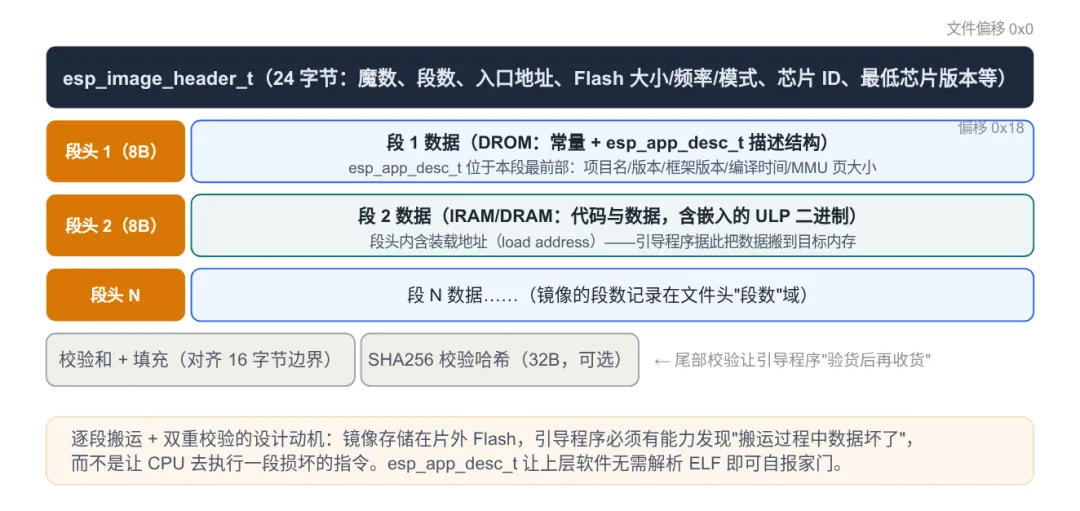
▲ 扁平结构:头、若干"段头+数据"、校验和、可选哈希,引导程序按这个顺序逐段搬
每个段最终落到地址空间的哪个窗口,由段的身份决定。这张表同时是第 2 章地址地图的使用说明。
五类段里,只有 IRAM 和 DRAM 真被搬进了片内 SRAM。IROM 和 DROM 留在 Flash,靠窗口映射访问——这一点第 2 章埋过伏笔,本篇后面再收。
04
Flash 布局与四步搬运
镜像要落到 Flash 的具体位置上。出厂默认布局很简单:起始处 0x0 放一级引导程序,0x8000 放分区表,0x10000 起是 factory 应用分区。应用分区必须按 64 KB 对齐,这条约束决定了后面所有偏移的算法。
分区表回答"Flash 上还有哪些区域、各是什么用途"。上电之后,搬运分四步走:ROM 里的固件先启动,从 Flash 加载二级引导程序;二级引导查分区表,选中要启动的应用分区;接着按镜像里的段头逐段搬运;最后跳到镜像头记录的入口字段,程序开始执行。
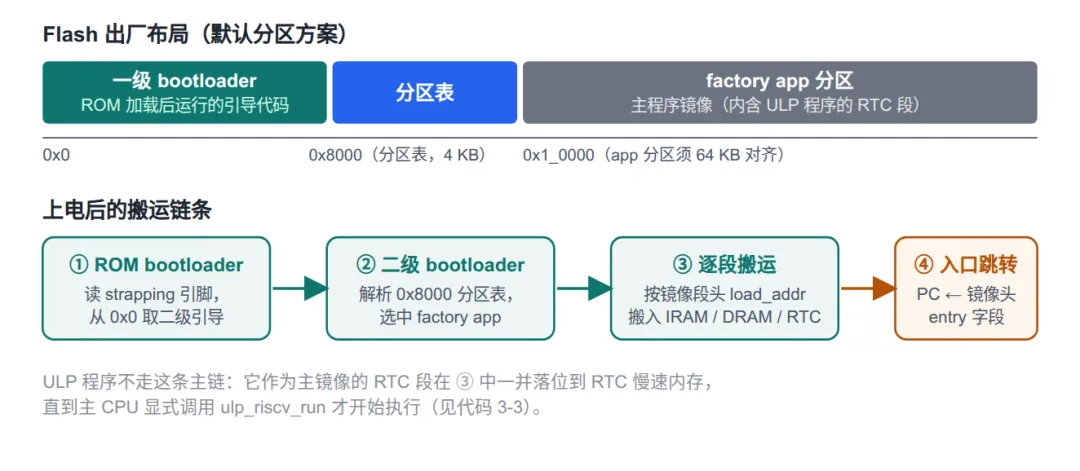
▲ 上半部是默认分区布局,下半部是四步搬运链:ROM 引导、查表选分区、逐段搬运、跳入口
ULP 程序的 RTC 段就在第三步随主镜像一起落下,落点是 0x5000_0000 起的 8 KB 慢速内存。这也解释了为什么它不需要单独的烧录步骤——主程序上船,行李跟着上船。
05
ULP 程序怎么挤进主镜像
ULP 明明单独编译成一个 ELF,凭什么挤进主程序?靠一条构建命令 ulp_embed_binary:它把 bin 当作二进制大对象嵌进主程序,同时生成一个头文件,把这段数据的起止地址和共享变量包装成可直接 include 的符号。
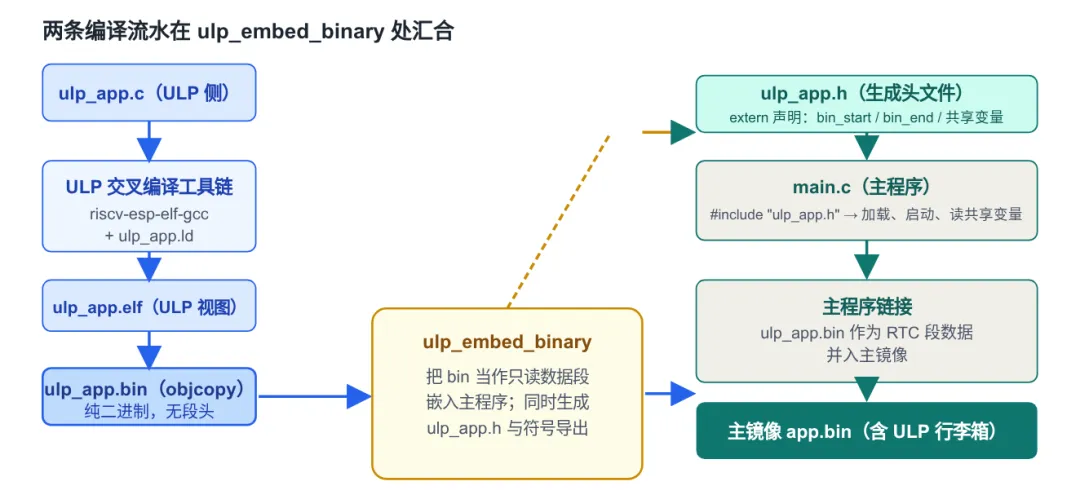
▲ 左边是缩微版的 ULP 编译流水,中间由嵌入命令汇合,右边主程序 include 生成头文件后即可加载启动
生成物的命名有一条简单规则:符号名 = 组件名 + 生成物名。以组件名 ulp_counter 为例,构建系统交出的"接口清单"只有这几样。
接口清楚了,主 CPU 侧只剩三步:在构建脚本里声明 ULP 子工程,在配置项里从 RTC 慢速内存划出保留区,然后调用加载函数把 bin 复制过去、调用启动函数让协处理器脱离复位(让电路回到已知初始状态的“重启”)。
加载函数做的其实是镜像格式的逆运算:以 bin 起始符号为源、以慢速内存基址为目标,逐字节复制 end 减 start 那么长。因为 ULP 链接脚本把装载地址定为 0,这段代码落位后正好从 0x5000_0000 开始铺开。
两颗处理器物理隔离,主 CPU 与 ULP 之间唯一的通信载体,是 RTC 内存里的共享变量。ULP 侧定义并初始化,主 CPU 侧经生成头文件 extern 访问同一个单元。
时序上一道坎:共享变量随 bin 一起装载。如果在调用加载函数之前就去读写它,碰到的是一片未初始化的 RTC 内存。经验法则很简单——所有共享变量的访问,都安排在加载与启动之后。
06
拿工具验货
纸面格式对不对,有个最省事的验证办法:官方烧录工具自带解剖命令,不运行程序,只读文件头,把镜像的每个字段逐项打印出来。
一份典型输出是:镜像大小 26352 字节,共 3 个段,段长分别以十六进制列出,校验和标注 valid,末尾还附一个被验证过的哈希。和前面的图纸逐项对号,全部能对上。
看输出时值得留意三件事。第一,段数与段长随源码和数据量变化,不是固定值。第二,校验和与哈希是否标 valid——手工改过 bin 文件,这里会立刻失效。第三,借字段表指出镜像头里"入口地址"落在哪个位置,这是读懂启动流程的钥匙。
07
XIP:代码为什么能住在 Flash 里
搬运链条里有个细节值得追问:IRAM 和 DRAM 都被逐段搬进片内 SRAM,可 IROM 段的目标地址是 0x4200_0000——那是片外 Flash 的映射窗口,并没有搬运发生。
指令凭什么从一颗走 SPI 总线、慢得多的 Flash 里直接执行?答案是 XIP(就地执行):指令不搬家,靠 Cache 在中间打掩护。命中时直接供指,走快路径;未命中时经 MMU 把窗口页翻译成 Flash 物理地址,由 SPI 控制器读回,填进 Cache 后继续执行。
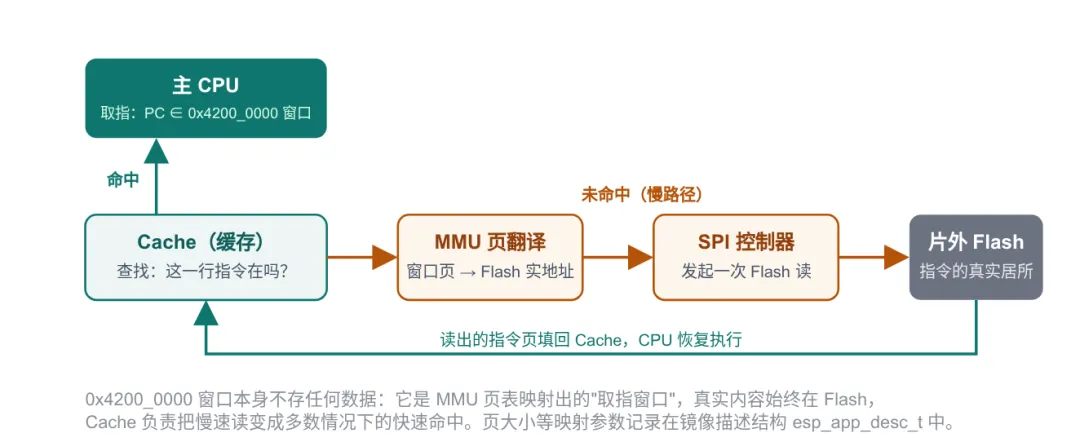
▲ 一条取指的两条路径:Cache 命中直接供指,未命中经 MMU 翻译再由 SPI 读 Flash 回填
这也顺带解释了 IRAM 段存在的意义:对时延敏感、经不起 Cache 未命中波动的代码,比如中断服务程序,可以单独链接到 0x4037_8000 的 SRAM 窗口。收益是确定性,代价是吃掉宝贵的片内内存。
08
例程:从一个引脚到一次计数
最后把整条链落到一个例程上:主 CPU 忙别的或睡眠时,ULP 持续监测 GPIO0 的电平,每出现一次上升沿就把计数加一,主 CPU 随时读取这个计数。
ULP 侧不用任何 API 封装,直接拿一个地址常量读寄存器。地址不是查来的,是沿地址空间推出来的,四步。
第一步定块基址:RTC IO 块在协处理器窗口里的基地址是 0xA400,窗口基座是 0x6000_0000,合成 0x6000_A400。第二步查寄存器偏移:输入电平寄存器偏移 0x0024。第三步相加,得到 0x6000_A424。第四步定位位序:RTC GPIO 序号等于 GPIO 号加 10,GPIO0 落在 bit10,掩码是 1 左移 10 位。
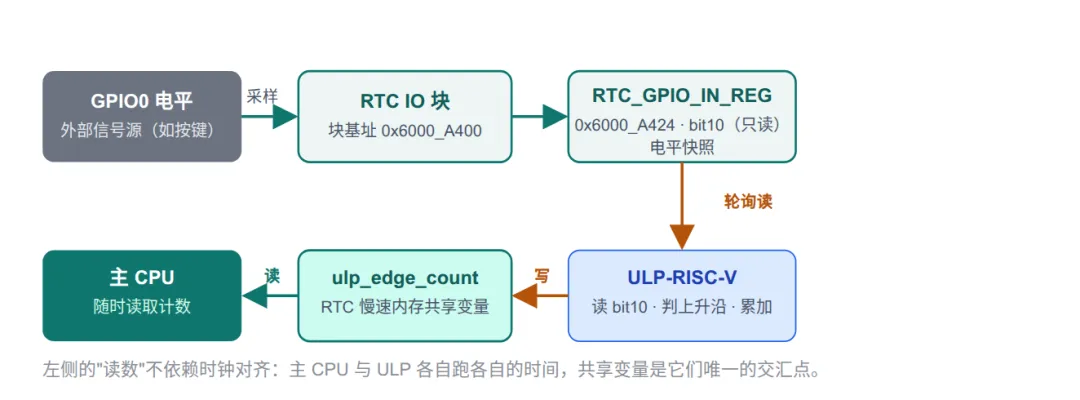
▲ 信号从引脚进、经 RTC IO 块变成寄存器里的一个位,被 ULP 读走判边沿,再由主 CPU 取走计数
这个推导结果应当与官方组件里的宏一字不差。故意写裸地址,是为了让"地址推导"成为可验证的能力——推出来的数,宏展开后必须对得上。
有了地址,ULP 侧就只剩一个"读、比、累加"的循环,每一行都对应上一篇讲过的指令形态。
主 CPU 侧仍是那三步:加载、启动、读共享变量。跑通之后,值得核对三件事:配置里划出的 RTC 保留区是否不小于 bin 的实际大小;主 CPU 读到的计数是否与手动翻转引脚次数一致;解剖命令的输出里能否找到 RTC 段的踪迹。
快翻慢翻各试一次,还会体会到一个细节:轮询方式对极短脉冲可能漏检。这不是程序写错了,而是"用最小的核、最省的功耗换确定性"的必然代价。
从一行源码到一次执行,中间没有魔法,只有三次换装:翻译、打包、搬运。
下一篇:程序已经能跑了,但芯片得先"活过来"。第 4 章从最小系统讲起——时钟树、复位与启动,一根晶振如何变成全片的心跳。
近期5篇相关文章推荐
ESP32原理|两颗 ULP、两套方言:Xtensa 主核之外的那颗 RISC-V 小核
代码住在 Flash 里,为什么能全速跑:ESP32-S3 的 Cache、XIP 与一致性
同一块 SRAM,两个门牌号:ESP32-S3 片内存储器与供电域
一块芯片,三个世界:ESP32-S3 的双核结构与地址空间分段
拆开 ESP32-S3:三个子系统、低功耗协处理器与三层映射法