ARTICLE · 1369640
设计文档一写就厚?用这个skill出MVP设计稿
做敏捷开发的,多半经历过这个循环:需求排进这一期,设计文档拖到开发前才动笔。写薄了,评审时被追问「异常怎么处理、接口谁先调谁」;写厚了,十几页背景和边界条件,评审没人看完,开发还是按自己的理解写。
问题不在文笔,在范围。加一个功能,顺手把两年后的扩展性也设计了;列接口,连没人用的错误码也补上。文档越写越厚,改动越来越慢,最后大家干脆不写,口头对齐。
于是只剩两种结果:要么没有文档,联调时才发现字段名对不上;要么文档成了摆设,谁都不按它写。你缺的不是又一个模板,是一条能把范围收住的写法。
今天要介绍的 agile-design-doc,走的是另一条线:先读你的项目,再按这一期真正要做的范围出文档,最后自己做一遍精炼度和 MVP 检查。它不追求完整,它追求能落地。
详情地址:https://ai.trusttools.cn/skills/ComeOnOliver/skillshub/agile-design-doc?repo_path=skills%2Faiskillstore%2Fmarketplace%2Fariesyb%2Fagile-design-doc%2FSKILL.md
● 安全认证:TrustTools 11 项安全检测通过
● Token 消耗:单次执行约 2.1k Tokens
● 中文适配:技能本体已全面汉化
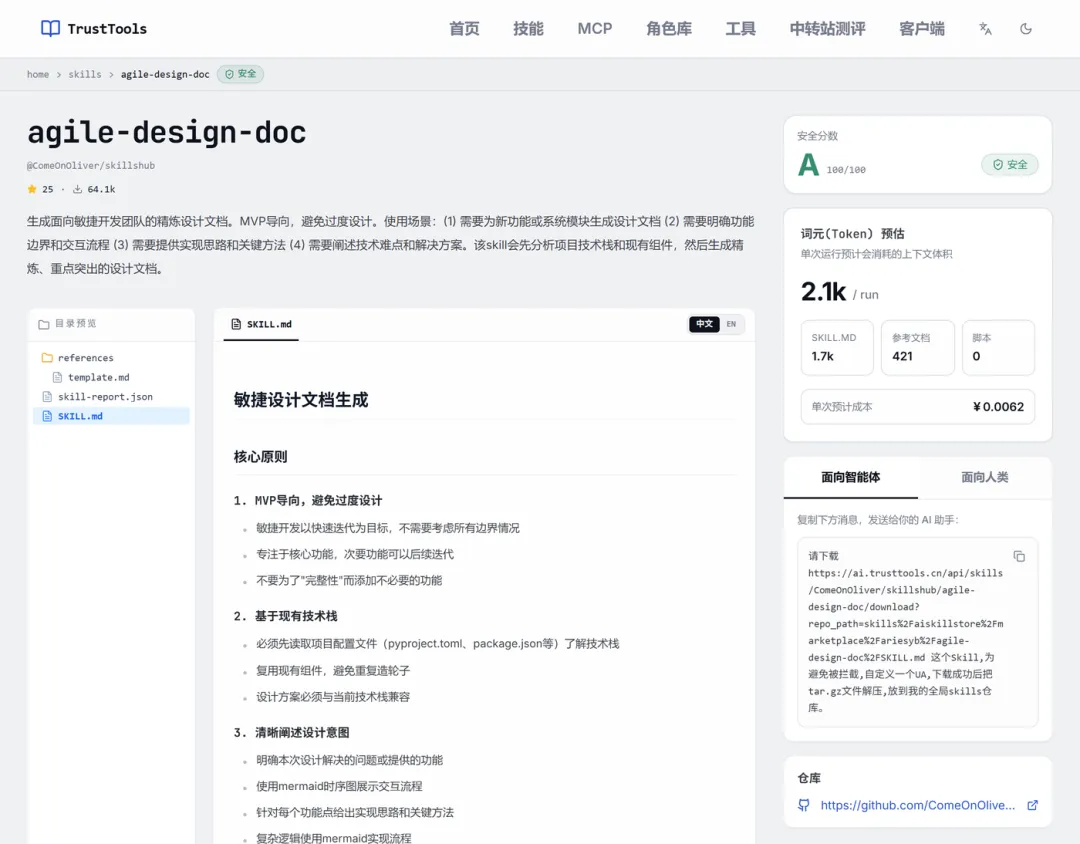
▲ TrustTools Skill 页面首屏截图
01
它做什么
这个 skill 的输入,是一句项目背景加一个要做的功能或模块:什么系统、这次加什么、边界在哪。它不会上来就套模板,SKILL.md 的第一步是「前置分析」——先把这个项目的底摸清楚。
具体摸三件事:项目背景、技术栈、现有组件。技术栈不是靠猜,SKILL.md 写得很明确:Python 项目读 pyproject.toml、requirements.txt、setup.py;Node.js 读 package.json、yarn.lock、pnpm-lock.yaml;Java 读 pom.xml、build.gradle;Go 读 go.mod、go.sum。现有组件则从 src/、lib/、components/ 这些目录、README 和 docs 里找,能复用就不重造。
分析完,才进入文档生成。一份文档固定包含这几块:
● 设计目标:1–2 段,说清这次解决什么问题、提供什么功能
● 功能列表:每个功能一句话,不展开
● 交互流程:Mermaid 时序图,标出组件顺序和外部依赖
● 实现方案:每个功能点给实现思路、关键方法代码、技术难点
● 数据模型:只列新增或修改的
● 接口定义:只列新增或修改的 API
注意「只列新增或修改的」和「每个功能一句话」这两条。它不是不会写长,是刻意不写长——次要功能留到后续迭代,不确定的标成可选。
最后一步是质量检查,四组清单:精炼度、重点突出、技术准确性、MVP 导向。其中 MVP 那组问得很直接:有没有不必要的功能、能不能再简化、哪些可以后续迭代。
它最硬的一条规则是:「必须先读取项目配置文件(pyproject.toml、package.json等)了解技术栈」。紧跟着还有一条:「不要为了"完整性"而添加不必要的功能」。所以它出的是先对齐你项目里已有的东西、再按这一期范围收口的文档,不是从零套一个通用模板。
三条边界,先说清楚。
第一,它是提示词型 skill。包里是 SKILL.md、references 和 skill-report.json,scripts 为 0——它不会替你跑构建、跑测试,也不会生成可直接运行的代码。实现方案里的示例代码是用来示意关键方法的(SKILL.md 的例子里就是注释加 pass),要你自己补完、自己验。
第二,它出的是「这一期」的文档,不是完整架构设计。MVP 导向写在核心原则第一条,SKILL.md 的原话是「敏捷开发以快速迭代为目标,不需要考虑所有边界情况」。拿它对齐本期方案可以,拿它当三年规划不行。
第三,信息不够时它会做假设。SKILL.md 的 Q1 给了优先级:先读项目文件,再分析项目结构,再问人,最后「基于常见模式做合理假设(并在文档中说明)」。所以文档里那些假设段落要逐条看,尤其是技术选型和性能相关的。这一点要自己跑一遍确认。
02
核心流程
Step 1:让它先读项目,别急着描述需求
打开项目根目录再发指令,或者把关键配置文件贴给它。技术栈、现有服务、工具类给得越具体,它越不会设计出一个和你项目无关的方案。SKILL.md 明确要求先读配置、再找可复用组件。
Step 2:把这一期的边界说死
一句话:这次做什么、不做什么、哪些留到下一期。功能列表是按你说的范围列的,你不划边界,它就会按「完整」去补。
Step 3:按六段结构出文档
设计目标、功能列表、时序图、实现方案、数据模型、接口定义。前两块很短,重点在后四块:交互顺序、关键方法、改了哪些表、动了哪些接口。
Step 4:用它的清单自查
文档出来后,照着 SKILL.md 的四组检查过一遍。最值得看的是精炼度:有没有冗长背景、有没有重复、删掉某节还看不看得懂。删得动,说明这一版是收敛的。
Step 5:代码和假设自己复核
示例代码是示意,技术难点那节的方案也要拿项目实际情况对一遍。它负责把结构搭好、把问题摆出来,最后的可实现性还是你签字。
03
使用场景
场景一:新功能开发前——一线后端/全栈工程师
需求刚排进来,趁记忆还新,把设计文档先落下来。给它项目技术栈和这一期的功能边界,让它按六段结构出第一版。
用 agile-design-doc 给「优惠券核销」写设计文档。项目是 Spring Boot 3 + MySQL + Redis,已有 CouponService 和统一的 Redis 缓存封装。这一期只做领取、核销、过期回收,不做叠加规则。先读项目配置,再按功能列表、时序图、实现思路、数据模型、接口定义输出。场景二:老模块改造——技术负责人/架构师
老接口扛不住了,要加缓存、改分页。改造比新建更容易漏:现有调用方、缓存失效、回滚路径。让它把改动点和风险一次列清。
用 agile-design-doc 给订单查询接口做改造设计。现在单表查询已经慢,要加 Redis 缓存和游标分页。现有 OrderRepository、CacheService 可复用。列出改动点、时序图、缓存失效策略和回滚方案,MVP 之外的内容标成后续迭代。场景三:需求和开发对齐——懂业务的产品经理/技术 PM
产品懂业务,但开发要的是边界、流程和接口。把业务规则交给它,让它翻成开发能评审的文档,不确定的地方明确标出来。
用 agile-design-doc 把「审批流配置」需求写成开发能看的设计文档。业务规则是三级审批、可跳过、可转交。先列功能边界和交互流程,再给接口定义和数据模型;不确定的地方标出来,不要自行扩展。04
AiPy联动
01
下载 Skill 包:访问 TrustTools 官网,搜索或浏览找到您需要的 Skill,进入其详情页。复制面向智能体的安装口令,并粘贴到 AiPy 对话框中,即可完成 Skill 安装。
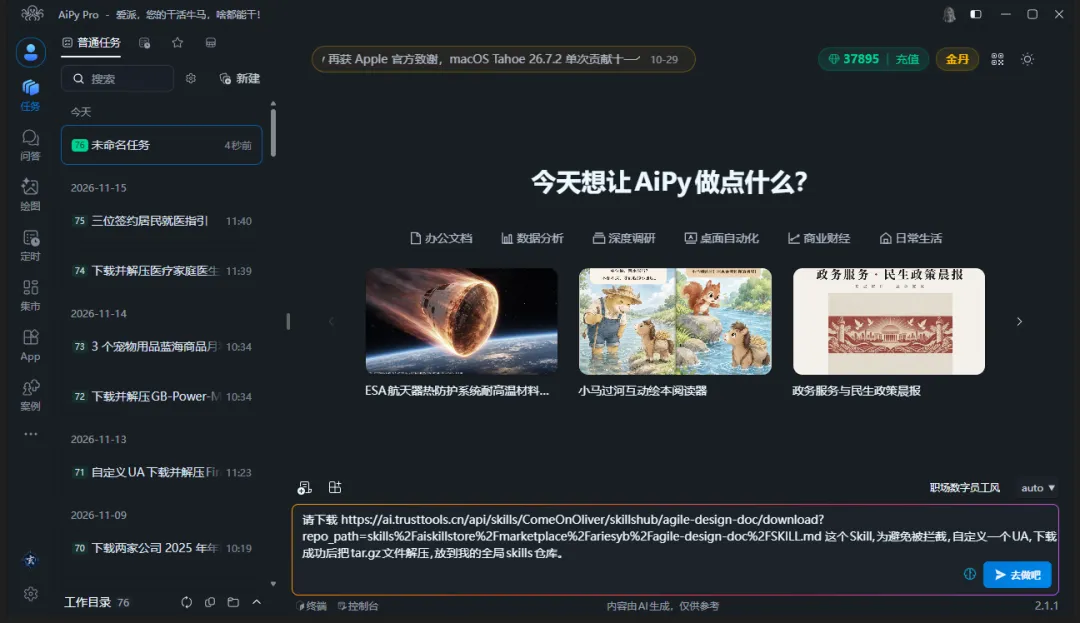
▲ 将安装口令粘贴到 AiPy 对话框中
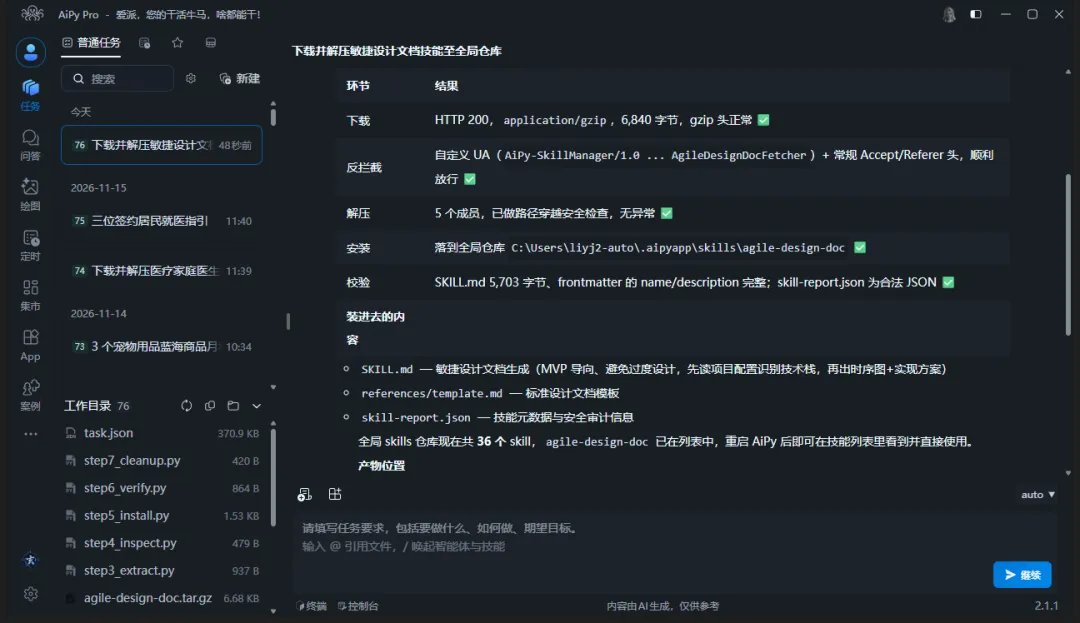
▲ AiPy 自动下载并安装 Skill
02
使用:回到对话主界面,即可像使用内置功能一样直接向 AI 发出相关指令来使用该 Skill。例如:用 agile-design-doc 给电商订单模块出设计文档:Spring Boot 3 + MySQL + Redis,已有 OrderService、库存服务和支付组件可复用。功能写下单、库存预扣、超时取消 3 项,新增 2 张表、3 个接口。列出功能清单、时序图、实现思路和数据模型,用表格把结果贴在回答里。
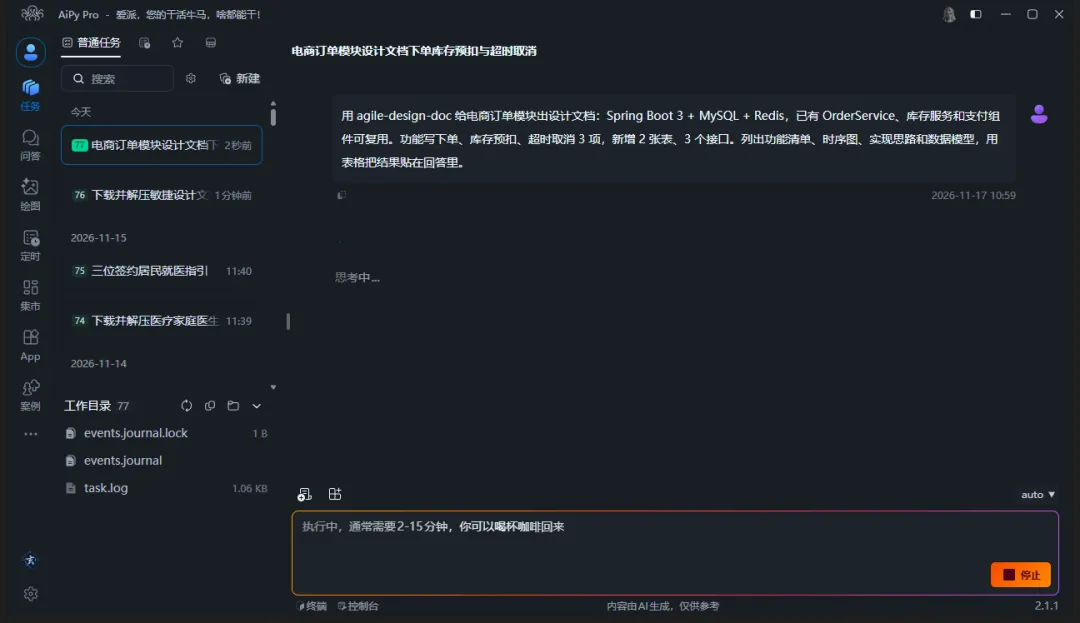
▲ 安装完成后使用 Skill
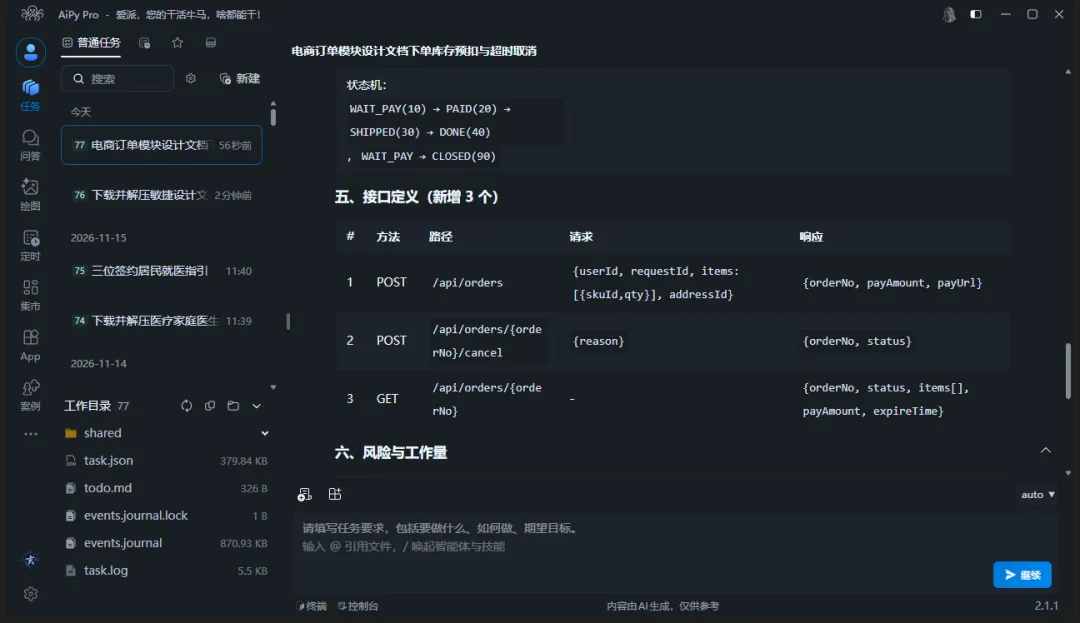
▲ 输出结果查看
获取经过安全审计、 Token 消耗量化的 Skills
访问地址: https://ai.trusttools.cn
为什么推荐通过 TrustTools 安装?
● 更安全: 已通过 11 项安全检测。
● 更懂你: 技能本体以中文为主,无需汉化。
● 更可控:实时提供 Token 消耗预估,拒绝Token黑洞。
一键部署: 复制页面中的安装命令,直接在 aipy 中运行安装命令即可完成安装。
安全使用 AI Skills,就上 TrustTools!
想找点更离谱的 AI 玩法?进群! 🏃♂️
我们这儿天天在全网"挖"这种脑洞大开的 Skills。
👇 扫码进群,和我们这群爱折腾的人扎堆:
(如群聊二维码失效,可添加助手进群)
点击链接
关注我们