ARTICLE · 1380412
一句话检索图文视频文档|GeeVec:把多模态内容装进同一个向量空间
🎯适合人群:AI开发者、RAG工程师、企业知识库建设、素材库运维人员
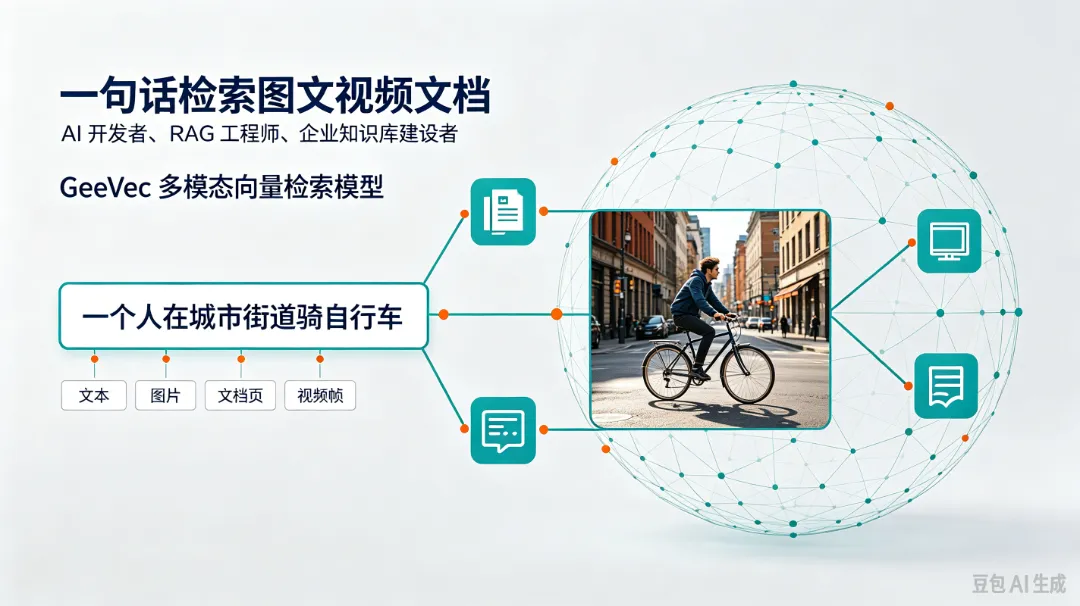
素材越存越多,想要的内容却越来越难找。
记得一张图片的画面,但记不住文件名;
知道报告里有一张关键营收图表,却翻不到在哪一页;
想找视频里某段场景,但是素材完全没有打标签。
传统关键词搜索只能匹配文字,大量藏在画面、图表、视频帧里的信息,直接被埋没。
能不能只用一句自然语言,同时搜索文字、图片、文档、视频?
今天介绍的GeeVec‑Embeddings‑mm‑1.0,就是主打这件事的多模态向量检索模型。
🔍什么是 GeeVec?不是聊天大模型,是检索大模型
很多人会混淆:它不负责写答案,专门负责找内容。
• 基座:基于Qwen3.5‑9B构建,参数量94.1亿
• 模态:文本、图片、视觉文档(图表/PPT扫描页)、视频(采样帧)
• 输出:全部统一输出4096维向量,不同类型内容进入同一个向量空间
简单理解它的工作逻辑:
用户输入一句描述 ➜ 转为向量数字图片/文档页/视频帧 ➜ 同样转为同规格向量计算向量相似度,把最相关的内容排序返回
不再比对关键词字面,而是比对语义与画面含义,实现「文搜图、文搜文档、文搜视频」跨模态检索。
✨举个直观例子:查询:“一个人在城市街道骑自行车”不需要图片文件名带“自行车”三个字,模型看懂画面语义,就能召回对应的照片。
📦四大能力,覆盖企业高频检索场景
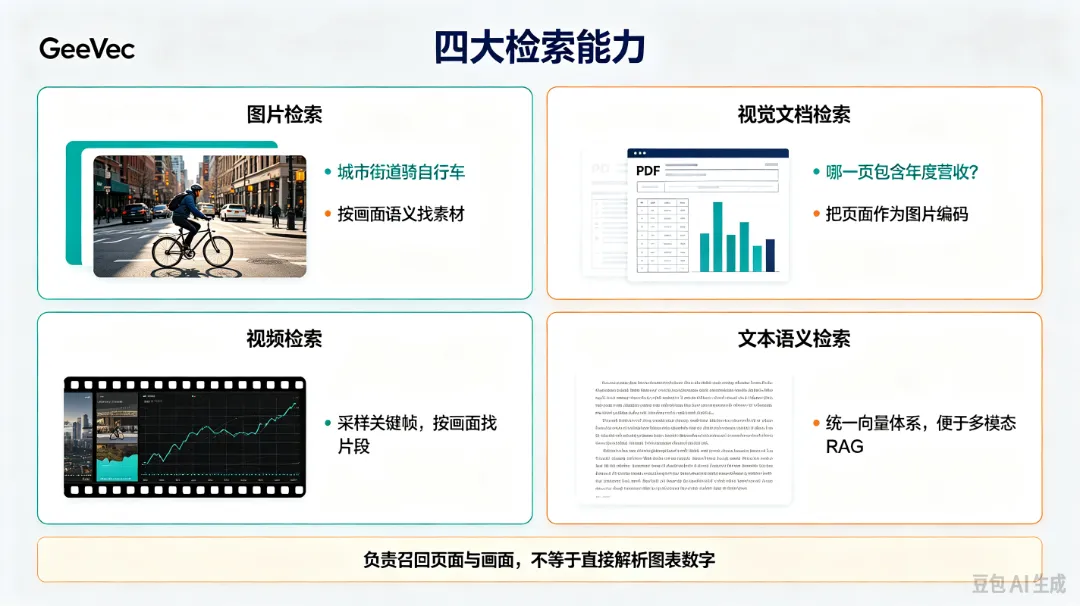
🖼️图片检索:描述画面,就能找素材
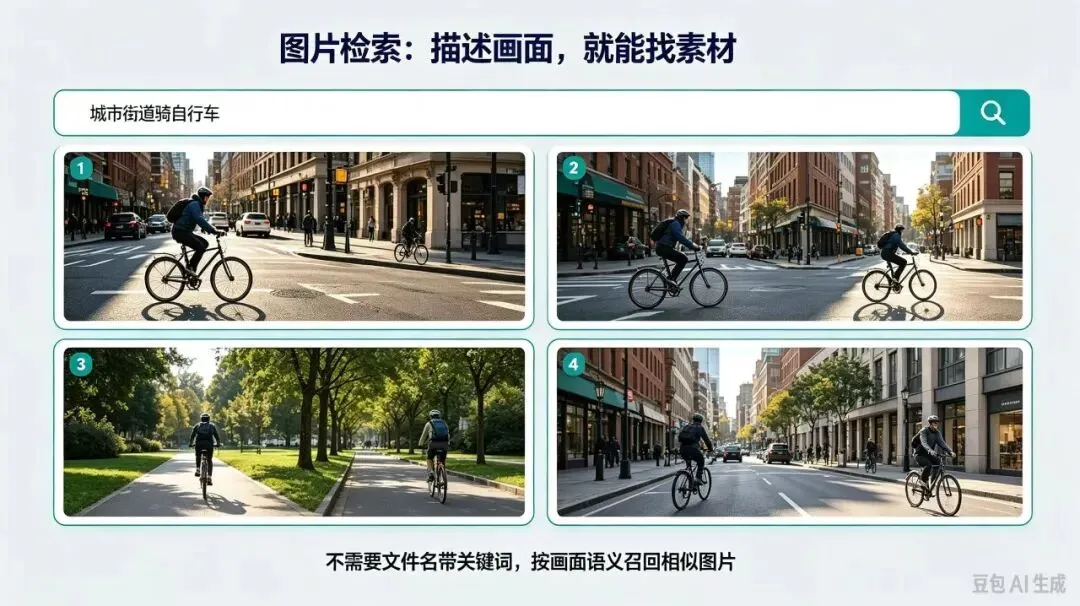
素材库、图库、设计资产库最大痛点:人工标签成本高,大量图片无标注。
GeeVec可以直接用自然语言描述画面来检索图片,摆脱对文件名、标签的依赖。
企业图库、新媒体素材库、产品图片库都可以试用:让沉睡的图片资产,能被文字唤醒。
⚠️注意:公开文档只给出技术示例,尚未披露线上业务落地案例。
📑视觉文档检索:直接检索图表、表格页面
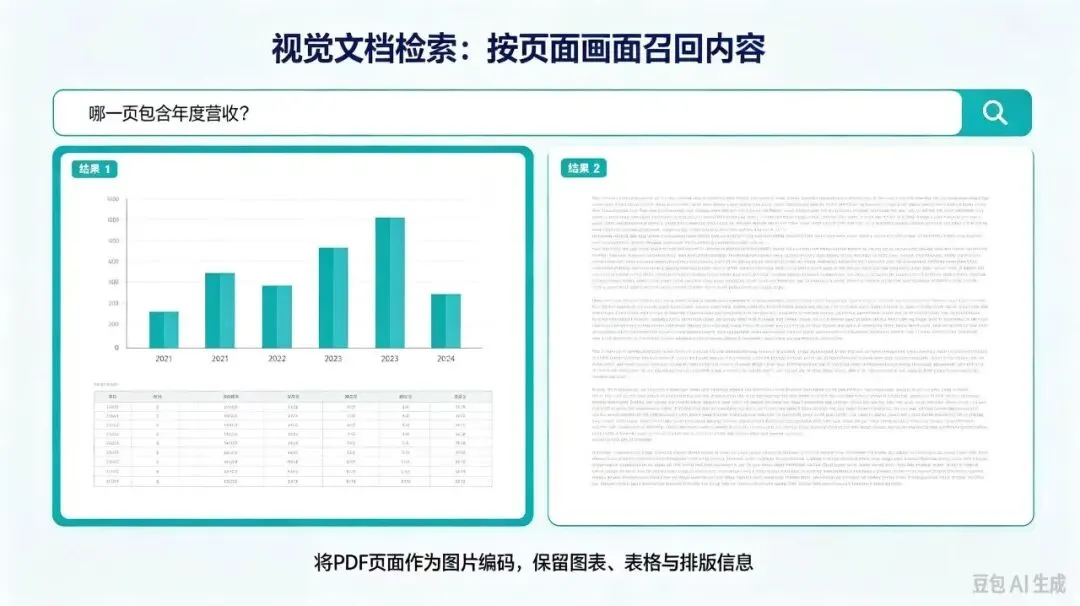
这是 GeeVec 最大亮点之一:把PDF页面当成一张图片去检索。
普通RAG流程,是把PDF提取文字再检索,会丢失图表、表格、排版布局信息。
而 GeeVec 将整页文档作为视觉图片编码,图表、表格信息都被保留在向量里面。
查询:“哪一页包含公司年度营收?”模型直接召回包含营收图表的那一页PDF页面。
👉适用场景:企业年报库、研究报告、PPT资料库、扫描档案。
重要边界:不会直接解析读出图表数字,只负责召回页面;解析读数仍要交给后续VL大模型处理;PDF文件必须预先转成页面图片输入,不能直接丢PDF文件进去。
🎞️视频检索:基于采样帧,按画面找片段
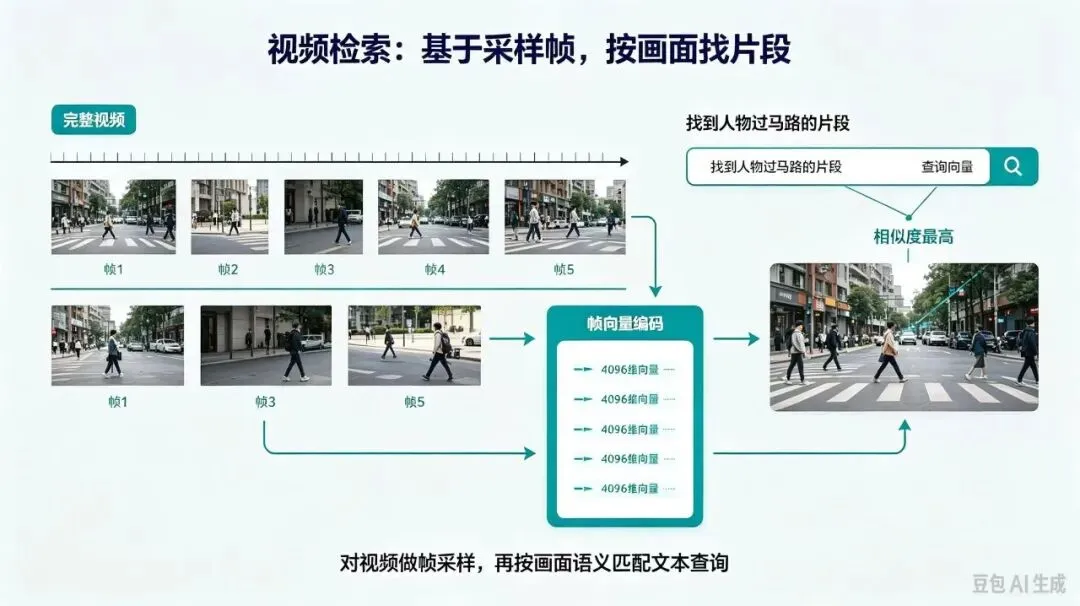
GeeVec支持视频输入,但底层逻辑是对视频做帧采样(例如每秒取1帧),把采样出来的图片帧做向量编码。
✅适合:找视频里的典型画面、场景片段。
❌局限:无法捕捉转瞬即逝动作、音频信息;采样策略会直接影响检索效果,不是丢完整视频就万事大吉。
📄文本语义检索:统一向量体系
除视觉内容外,也支持普通文本段落编码。
最大价值:一套向量接口,同时管理文字、图片、文档页,不用维护多套检索系统,非常适合多模态RAG系统做召回层。
📊评测表现:图片&文档检索优势突出,视频仍有提升空间
数据来源于模型README作者公开评测,未经过我方复现,仅作为选型参考,不代表业务落地保证。
在 MMEB‑v2 44个多模态检索数据集测试结果:
测评项目 | 得分 | 说明 |
总平均分 | 78.78 | 44个数据集等权平均 |
图片检索 | 81.82 | 模型榜单最高分同对比 |
视觉文档检索 | 83.63 | 同对比模型榜单最高分 |
视频&片段检索 | 59.66 | 相比竞品存在差距 |
✅选型建议:
如果你的核心诉求是图片检索、带图表的文档页面检索,GeeVec值得优先测试;如果以视频检索为核心业务目标,需要审慎评估效果。提示:不同任务采用Hit@1、NDCG@5等不同指标,分数不能简单理解成“准确率100分制”。
⚙️底层小科普:它是如何生成向量?
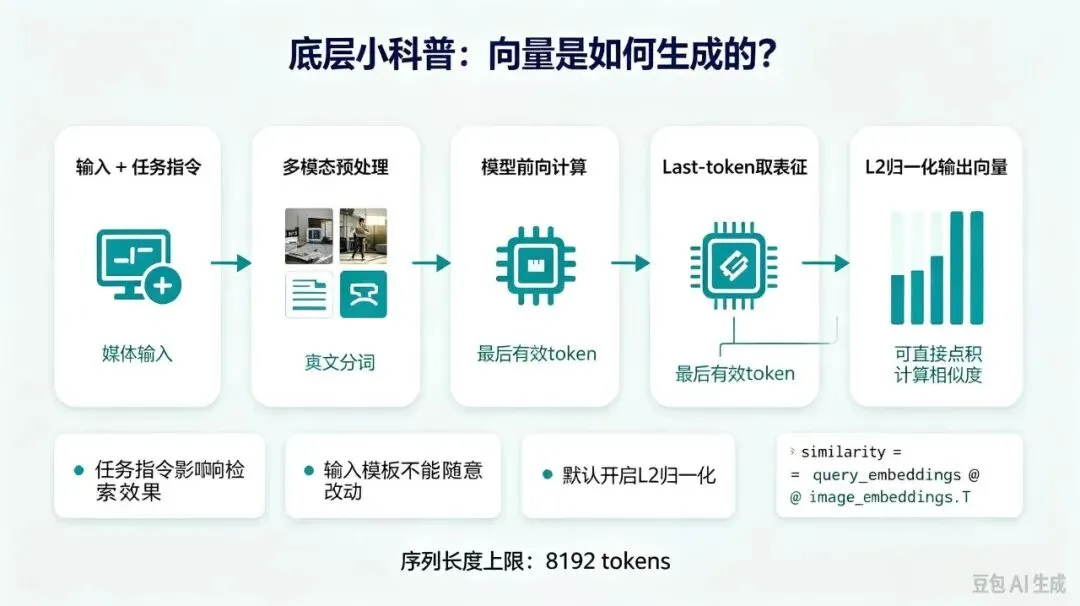
从开源modeling.py可以看到完整推理流程:
组装输入信息 → 多模态预处理 → 模型前向计算 → last‑token池化提取表征 → L2归一化输出向量
3个关键技术细节:
1. 支持任务指令 instruction
调用时可以带上提示,告诉模型现在任务是「找匹配图片」还是「找回答问题的文档页」,对检索效果影响明显。
2. Last‑token pooling 取向量
不是把所有token做平均,取输入最后有效token的隐藏状态作为Embedding,输入模板不能随意改动。
3. 默认开启L2归一化
归一化之后,向量直接点积就等价余弦相似度,简化检索代码;如果关闭归一化,就不能直接用点积算相似度。
# 归一化后,直接点积得到相似度矩阵
similarity = query_embeddings @ image_embeddings.T
序列长度上限:默认 8192 tokens,超长内容需要手动切分。
🧩在业务系统中,GeeVec该放在什么位置?
//图片占位:RAG链路示意图:用户提问 → GeeVec多模态向量召回(文本/图片/文档页)→重排模块→多模态大模型解析图文 →输出带来源引用的答案//
❗划重点:GeeVec只是检索召回层,不等于完整问答系统,不是向量数据库。
推荐完整链路:
用户提问 ➡️ GeeVec向量检索召回候选(文本、图片、文档页面、视频帧)➡️重排过滤 ➡️多模态大模型解析图表/画面内容➡️生成带来源页码、图片证据的回答
两大典型落地方向:
1. 企业多模态知识库
年报、PPT、扫描文档转页面图片入库;提问优先召回相关图表页面,再交给VL模型解读,解决传统RAG丢失图表信息的痛点。
2. 素材资产检索平台
图片库、视频素材库,自然语言描述直接检索素材,降低标签维护成本。
多模态RAG的核心痛点不再是“怎么生成回答”,而是“能不能把藏在图片图表里的证据先找回来”,这正是GeeVec的定位。
⚠️接入落地必须注意的边界
很多模型Demo效果很好,上线踩坑往往来自忽略工程边界:
1. 📄PDF不能直接喂模型,必须预先转成页面图片,业务系统自己要维护页码、原始文件映射关系。
2. 📏上限8192 tokens,长文档、长视频不能一次性全部输入,需要做页面切分、帧采样策略调优。
3. 💾4096维向量存储成本高,海量素材入库,要评估向量库存储、查询延迟。
4. 🖥️公开资料缺少完整显存占用、吞吐量、量化性能数据,硬件适配一定要自己实测,不要只看参数量预估。
✅最佳实践:不要直接全量迁移业务库。拿一批真实业务数据、真实业务问题做小批量A/B测试,验证图片召回、图表召回、视频召回效果,同时统计硬件成本,再决定是否大规模上线。
榜单只是选型线索,业务实测才是最终标准。
✨结语:搜索从找文字,升级为找信息本身
过去搜索的目标:找到包含关键词的文字。
多模态检索的目标:找到承载信息的页面、图表、画面、片段。
GeeVec‑Embeddings‑mm‑1.0给开发者提供了一套开源可落地的方案:一套接口统一编码文本、图片、文档页面、视频采样帧,在图片、视觉文档检索拿到亮眼评测结果。
当然,视频能力、部署成本、长内容处理依然需要结合业务场景打磨。
当企业的资料早已不止纯文本,多模态向量检索,会成为知识库、素材系统的必备底层能力。
📎资料来源:GeeVec 模型主页、提供的 README.md 与 modeling.py。评测数字为模型作者公布结果,本文未独立复现;应用场景为基于公开能力的使用方向说明。