ARTICLE · 1030941
Word、PPT、Excel、PDF 全能转 Markdown?Firecrawl 开源了一个 Rust 文档解析器:anydoc
企业里的数据很少整整齐齐地躺在数据库里,更多时候散落在 Word、PPT、Excel、PDF、CSV、EPUB 等各种文件中。真正进入 LLM 之前,这些文件通常还要经过解析、结构提取和格式统一,再继续做 Chunk、Embedding、检索或者问答。
最近 Firecrawl 开源了一个专门解决这件事的项目——anydoc。
它的目标非常直接:不管输入的是 Word、PPT、Excel 还是 PDF,尽量统一转换成干净、结构化的 GitHub-Flavored Markdown。 更特别的是,anydoc 核心使用 Rust 编写,同时提供 Node.js、Python 和 WebAssembly 支持,可以放进后端文档处理流水线,也可以直接运行在浏览器里。
一、各种办公文档,最后统一变成 Markdown
anydoc 目前覆盖的文件格式已经比较完整,从 Office 老格式到现在常用的 OOXML,再到 OpenDocument、RTF、EPUB、CSV 和 PDF 都包含在内。
.doc、 | |
.ppt、 | |
.xls、 | |
.odt、 | |
.rtf | |
.epub | |
.csv | |
.pdf |
它做的也不只是“把文字抽出来”。标题层级、粗体、斜体、删除线、代码块、内部链接、嵌套列表、任务列表、表格、引用、脚注、尾注,以及 PowerPoint 的 Speaker Notes 等结构都会尽量保留下来;Word、PowerPoint、OpenDocument、EPUB 和 RTF 中的公式还能转换成 LaTeX。
所以它更接近这样一条处理链路:
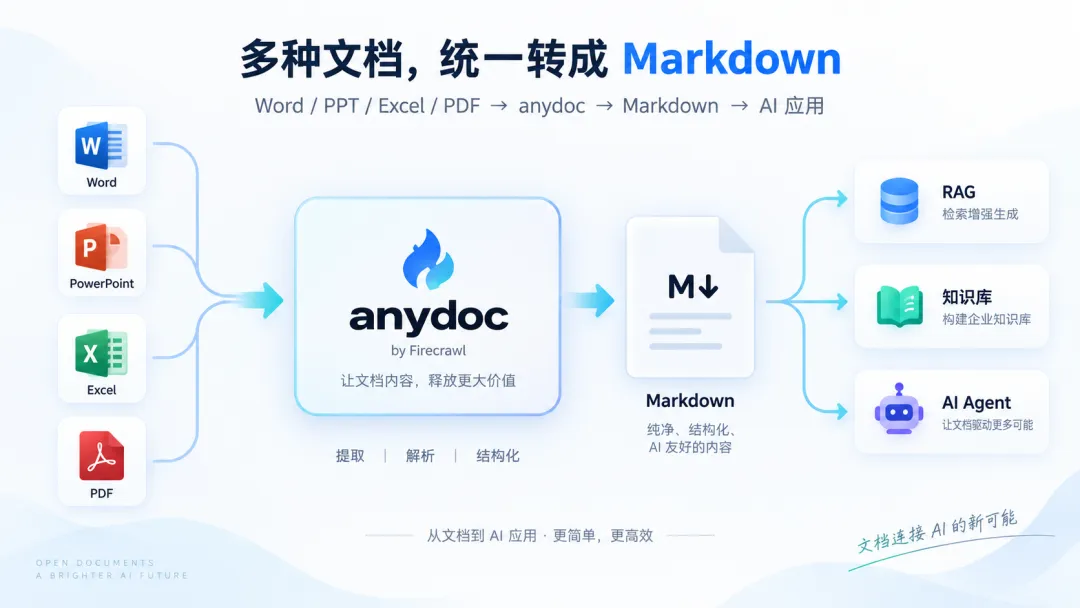
Word / PPT / Excel / PDF → anydoc → 结构化 Markdown → Chunk / Embedding → RAG、知识库或 Agent
对于 AI 应用来说,这一步其实非常重要。大模型真正需要的并不是 .docx、.pptx 这些文件格式本身,而是里面的标题、段落、表格、列表、公式以及内容之间的结构关系。
二、为什么现在越来越多 AI 工具喜欢先转 Markdown?
假设有一份 80 页的企业制度文件,如果只是简单提取纯文本,原本的章节标题、表格结构和列表层级很容易一起丢掉。后面无论是做知识库检索,还是让 Agent 阅读,模型看到的都可能只是一大段连续文字,很难再准确恢复原始文档关系。
Markdown 刚好处在一个比较合适的位置:它比纯文本保留了更多结构,同时又比 Word 内部 XML、PDF 页面描述或者复杂 HTML 简单得多。标题、列表、表格、代码、引用和链接都有相对明确的表达方式,很适合作为不同文档格式和后续 AI 系统之间的中间层。
所以现在很多 AI 文档处理流程,本质上都在做同一件事情:
先把复杂文件统一转换成模型更容易理解的结构化文本,再交给后面的 AI 系统处理。
anydoc 做的,就是这层“文档翻译器”。
三、它有一个很明显的特点:核心是 Rust,而且速度做得很激进
anydoc 的核心使用纯 Rust 编写,普通文档转换不依赖机器学习模型,也不需要调用外部服务。官方 README 给出的 Benchmark 中,它在 100 份真实文档、14 种格式上的中位转换时间为 4.4ms;同一组测试中,LibreOffice 为 1129.5ms、MarkItDown 为 134.8ms、Pandoc 为 102.1ms。
这里需要说明,这些数据来自 anydoc 项目自己的 Benchmark。不同工具支持的文件格式、转换方式和功能范围并不完全一致,测试中的质量评分也使用了 LLM Judge,因此更适合用来理解项目追求的方向,而不是简单得出“anydoc 比其他工具快多少倍”的绝对结论。
更值得关注的是它的设计思路:本地处理、统一解析、统一输出。 对于需要批量接收 Word、Excel、PPT、PDF 的 RAG、企业知识库和文档 ETL 系统,这种路线会比较省事。
四、文件扩展名写错了,它也会尝试自己判断
很多文档处理程序首先依赖文件后缀,比如看到 .docx 就按照 Word 处理。anydoc 还多做了一层:直接读取文件内容判断真实格式。
它会通过 PDF Header、RTF 数据结构、OLE Stream、ZIP Package MIME Type 等内部特征识别文件类型,因此即使文件扩展名被错误修改,只要内部结构仍然能够识别,就还有机会正常转换。CSV 因为本身没有这种固定文件签名,所以仍然需要根据扩展名或者显式指定格式。
这个能力看起来不起眼,但放进真实企业数据里其实很实用。历史系统导出的附件、人工修改过的文件名以及各类旧版 Office 文档,往往没有想象中规范,单纯依赖文件后缀很容易踩坑。
五、CLI、Node.js、Python、Rust、浏览器都能直接接
anydoc 并不是一个只能在命令行里跑的小工具,它已经提供了多种接入形式,基本覆盖了常见的 AI 和 Web 开发环境。
最简单可以直接通过 CLI 使用:
npx @firecrawl/anydoc report.docx如果希望把结果直接保存成 Markdown 文件:
npx @firecrawl/anydoc slides.pptx -o slides.mdNode.js 中也可以直接调用:
import { toMarkdown } from '@firecrawl/anydoc';const markdown = await toMarkdown('report.docx');Python 的调用方式同样比较直接:
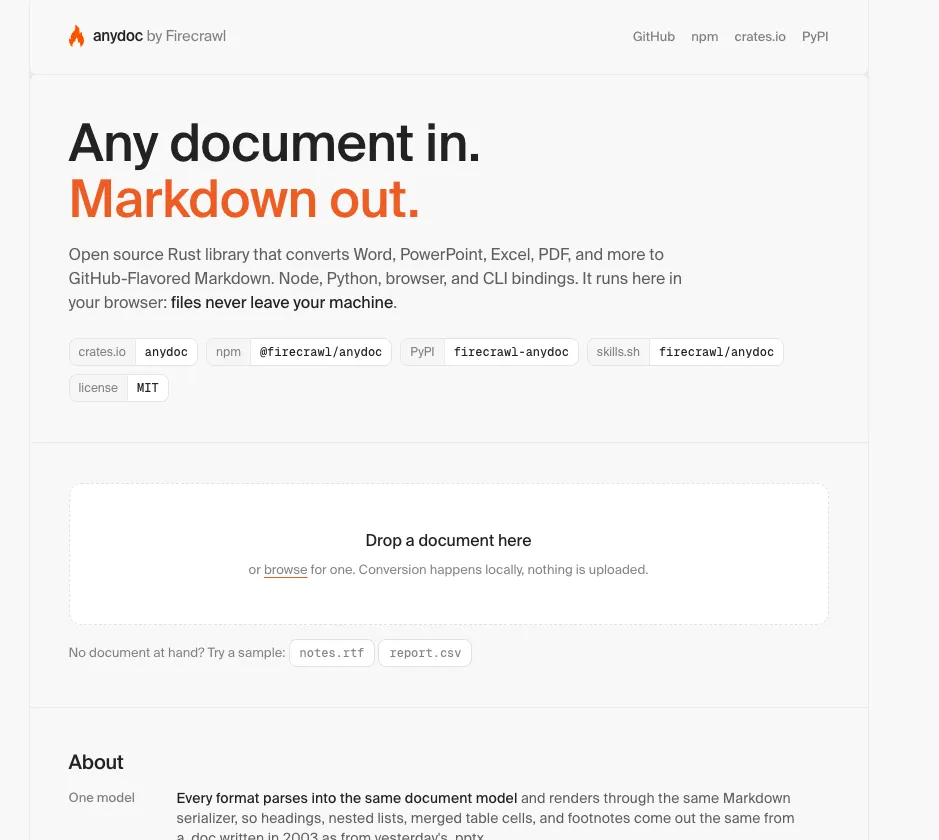
import anydocmarkdown = anydoc.to_markdown("report.docx")浏览器端则提供 @firecrawl/anydoc-wasm。官方还提供了在线 Demo,普通文档转换直接通过 WebAssembly 在浏览器本地完成,因此转换文件不需要离开用户设备。
六、它甚至已经直接给 Agent 准备好了 Skill
这可能是 anydoc 最符合现在 Agent 趋势的一点。
项目本身直接提供了 Agent Skill,安装方式只有一条命令:
npx skills add firecrawl/anydoc官方说明,该 Skill 可以配合 Claude Code、Codex、Cursor、OpenCode 以及其他兼容 Agent 使用。Agent 遇到 Office 文档以后,可以自己调用 anydoc CLI,把文件转换成 Markdown,再继续阅读和处理。
例如用户丢进来一份 合同.docx、产品方案.pptx、销售数据.xlsx 或 行业报告.pdf,过去可能需要用户自己先找到转换工具,再把内容交给 AI;现在则可以变成一条自动流程:Agent 发现文件,调用 anydoc 完成解析,再继续做总结、分析、RAG 入库或者生成后续结果。
以前我们一直在给 AI 增加网页搜索、数据库查询、浏览器操作等工具能力,现在开始出现越来越多类似 anydoc 的项目,把传统文件格式本身也变成 Agent 可以调用的 Skill。Agent 的能力因此不再只来自模型,而是逐渐来自模型周围不断扩展的工具生态。
七、扫描 PDF 是一个例外
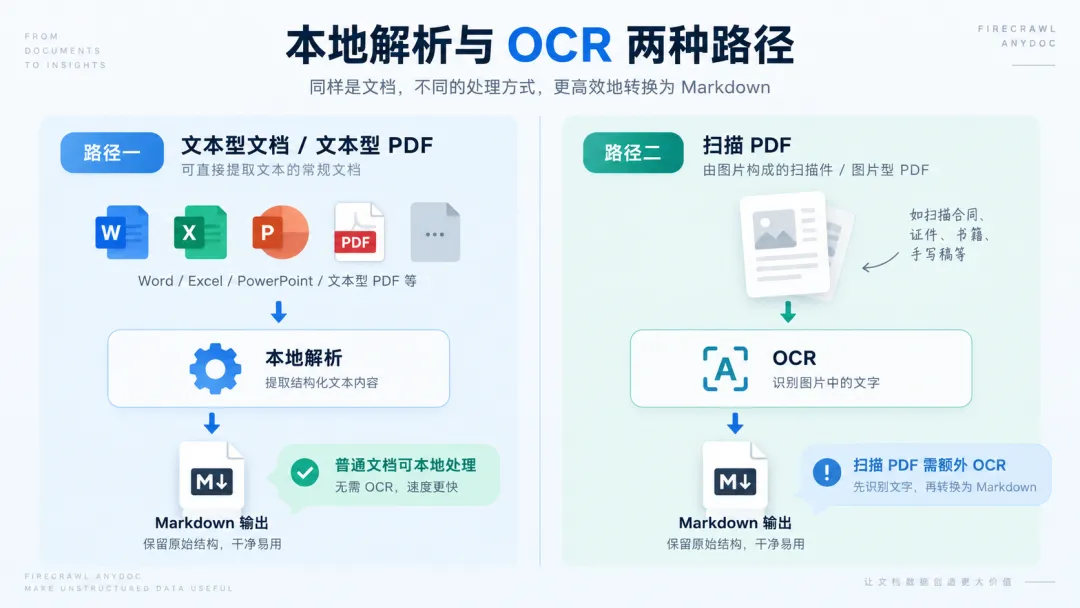
anydoc 对普通文本型 PDF 可以直接在本地解析,但如果 PDF 本质上是一张张扫描图片,本身没有文本层,就需要额外使用 OCR。anydoc 本地版本目前不负责 OCR,如果检测到扫描页会返回 NeedsOcr;这时可以显式开启 hosted OCR,将文档交给 Firecrawl Parse 处理,再返回同样格式的 Markdown。
CLI 中可以这样使用:anydoc scan.pdf --ocr hosted
Node.js 和 Python 同样提供 hosted OCR 参数。官方说明,只有确实需要 OCR 且用户主动启用 hosted OCR 的文档才会离开本机;Rust crate 本身没有 OCR 选项,也不会主动发起网络请求。
所以可以简单理解为:普通 Office 文件和文本型 PDF 可以本地解析,扫描 PDF 则需要额外 OCR 服务。
八、它比较适合哪些场景?
anydoc 最适合的并不是偶尔把一份 Word 转成 Markdown,而是那些需要持续接收大量不同格式文档的系统。企业知识库、RAG、Agent、文档 ETL 和数据抽取等场景,都需要在“原始文件”和“AI 可以继续处理的数据”之间增加这样一层解析能力。
从这个角度看,anydoc 并不负责知识库本身,也不负责问答和 Agent 推理,它更像 AI 文档链路里的一个底层组件:把不同来源、不同年代、不同格式的办公文件,转换成后续 AI 系统更容易继续处理的统一结构。
九、它内部是怎么把这么多格式统一起来的?
anydoc 的实现思路也比较清晰。除了 PDF 走单独的 pdf-inspector 路径之外,其他格式首先经过格式识别,然后交给对应 Parser,再统一转换成一个共享的 Document Model,最后由同一套 GFM Serializer 输出 Markdown。
可以简单理解成:
Document Bytes ↓格式检测 ↓不同格式 Parser ↓统一 Document Model ↓Markdown Serializer ↓GitHub-Flavored Markdown这种架构最大的好处是:不同格式最后都会进入同一套中间模型和序列化逻辑。比如表格转义规则修复一次,不只是 .docx 受益,RTF、ODT 等其他格式也可以一起复用。
这也是为什么它能够把“支持很多格式”和“输出格式统一”同时作为核心卖点。
写在最后
anydoc 看起来只是一个“文档转 Markdown”的工具,但放到现在的 AI Agent 环境里,它解决的其实是一个很基础的问题:怎么让 AI 更方便地读取我们已经使用了几十年的那些办公文件。
网页已经有各种 Crawling 工具,数据库可以直接 Query,API 可以通过工具调用,而企业里数量巨大的 Word、Excel、PPT、PDF,同样需要一套稳定的解析方式。anydoc 想做的,就是这个“翻译层”。
更有意思的是,现在越来越多开源项目开始不满足于“提供一个库”,而是直接提供 Agent Skill。文档解析、浏览器操作、视频剪辑、数据处理等能力都可以继续封装成 Agent 的工具。等这些能力逐渐拼起来以后,一个真正能干活的 Agent 系统,依赖的就不只是更强的模型,还有它周围越来越完整的开源工具、Skill 和基础设施。
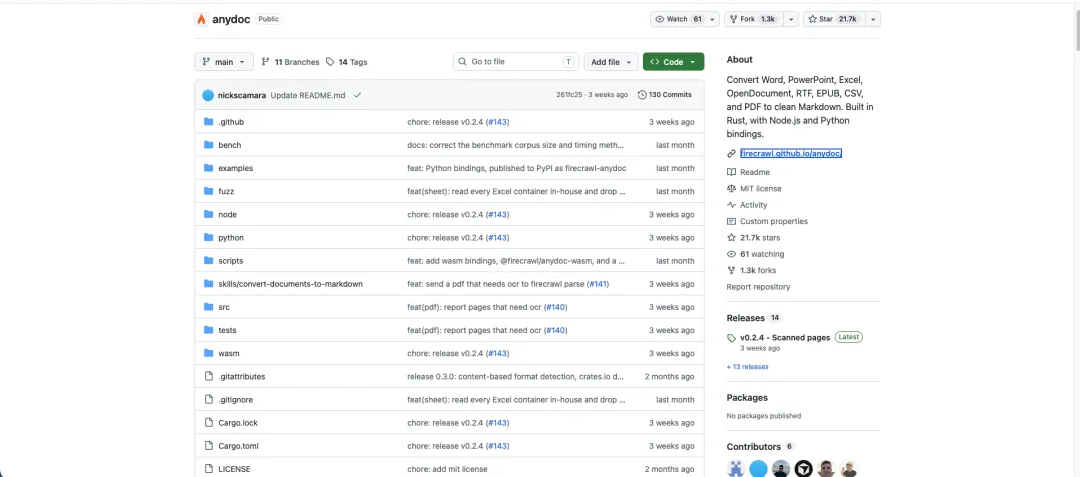
目前 anydoc GitHub 仓库已经有约 21.7K Star、1.3K Fork,采用 MIT License 开源。
项目地址
https://github.com/firecrawl/anydoc
开源原力社
持续分享值得关注的开源软件、开发工具和技术项目。
如果你也在关注 AI Agent、RAG、知识库、文档解析和开源工具,欢迎关注 开源原力社。