ARTICLE · 1036378
高效AI计算 · 韩松 MIT 6.5940 公开课全程追踪
韩松MIT 6.5940第一课:大模型时代的"效率军备竞赛",从600MB训练内存压到141KB说起
本文基于 MIT HAN Lab 官方课程视频(EfficientML.ai Lecture 1,63分钟)逐段整理,幻灯片实拍提取,关键事实联网核验。
2026年秋季,MIT韩松(Song Han)教授第四次开设6.5940《TinyML与高效AI计算》课程——选课人数从2022年的30人涨到今年的300人,四年10倍。这本身就是行业风向标:当模型参数从2017年Transformer的0.05B膨胀到今天讨论的万亿级,而单卡显存只从16GB爬到200+GB,供需之间的剪刀差只能靠"效率技术"来缝合。这篇第一课的完整拆解,覆盖了整门课的世界观:从MCU上141KB内存的设备端训练,到4090上166 tokens/s的AWQ量化推理;从"Stable Diffusion训练花60万美元"的成本账,到"先进制程里软件才是最大成本项"的产业判断。对于做AI硬件加速的工程师,这节课几乎是一张完整的作战地图。
一主讲人与课程:选课人数四年10倍意味着什么
图1|课程标题页。MIT 6.5940: TinyML and Efficient AI Computing(2026秋),主讲韩松。截取自MIT HAN Lab官方视频
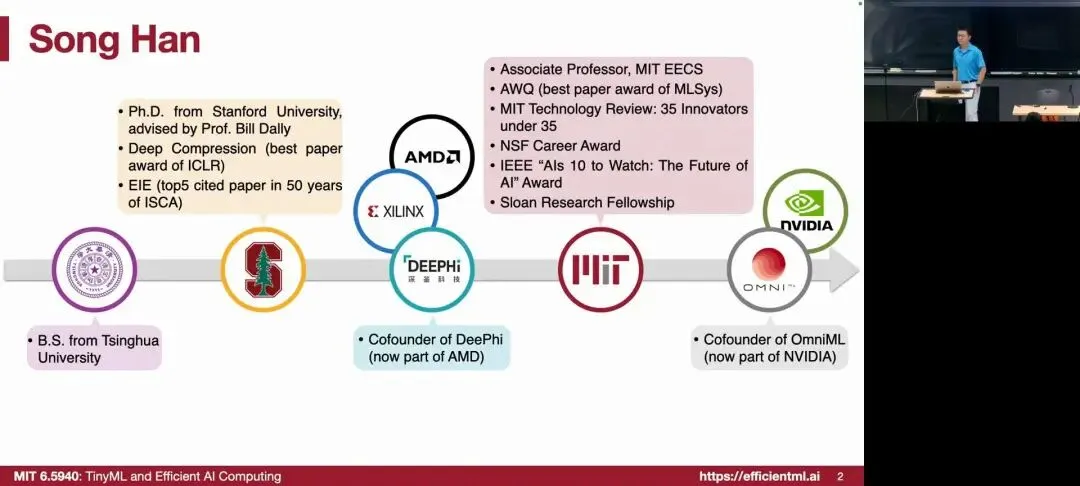
图2|韩松个人履历页。MIT EECS副教授(tenured);斯坦福博士(导师Bill Dally);Deep Compression(ICLR'16最佳论文)、EIE(ISCA 50年引用前5)、AWQ(MLSys'24最佳论文)作者;TR35、IEEE AI's 10 to Watch、Sloan奖;深鉴科技与OmniML联合创始人。截取自课程视频
官网核验 韩松的个人主页(songhan.mit.edu)确认了幻灯片上的全部头衔:MIT EECS副教授、斯坦福博士(Bill Dally门下)、Deep Compression与高效推理引擎EIE的开创者——后者首次把权重稀疏性引入现代AI芯片,成为ISCA 50年历史上引用前5的论文;SmoothQuant/AWQ/StreamingLLM已被NVIDIA TensorRT-LLM采纳。他是深鉴科技(Deephi,后被Xilinx/AMD收购)和OmniML(后被NVIDIA收购)的联合创始人——一个"论文写进芯片、公司卖进巨头"的学者。
开场最有信息量的一句话
"所有公司都急需你们这样的人去serve这些模型、训练这些模型。"——选课人数30→90→180→300的四年曲线,是AI基础设施人才缺口最直观的注脚。韩松还提到:他学生的创业公司今年被收购,另有两个学生在创业——这个领域的出路不是学术岗,是产业纵深。
课程承诺也很实在:完成全部5个lab后,带回家一台能本地跑7B大模型的笔记本。"这门课非常实用,你不会看到很多公式,但会写很多代码。"
二核心论题:一条越拉越开的剪刀差
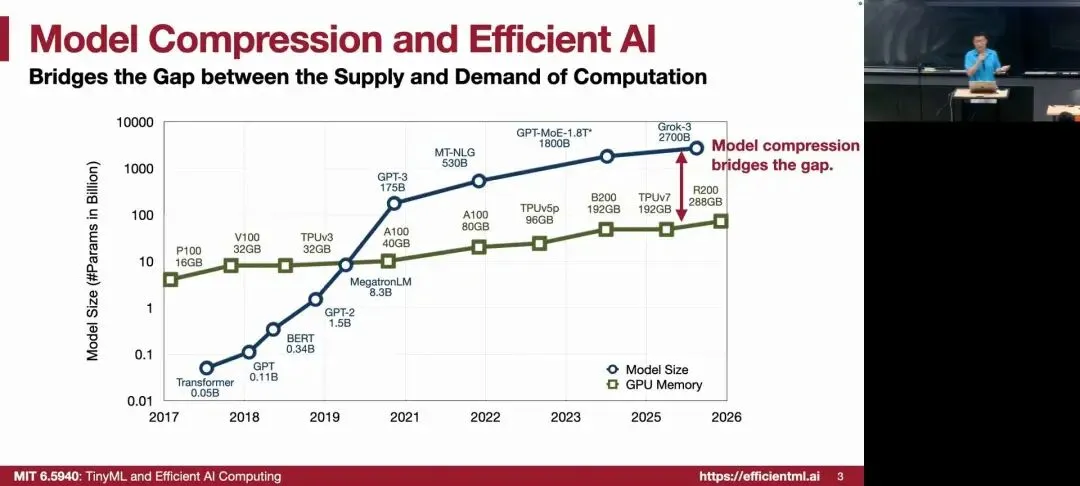
图3|全课核心框架图。对数坐标下:模型参数(蓝)从Transformer 0.05B一路冲向GPT-MoE-1.8T、Grok-3 2700B;GPU/TPU显存(绿)从P100 16GB到Rubin 288GB。注意这是对数坐标——缺口在加速拉大。截取自课程视频
这是整门课的"第一性原理",值得逐条拆:
- 需求侧(模型)
:Transformer(2017)0.05B → GPT 0.11B → GPT-2 1.5B → MegatronLM 8.3B → GPT-3 175B → MT-NLG 530B → GPT-MoE 1.8T → Grok-3 2700B,"现在大家在谈2.7万亿甚至10万亿参数"。韩松提醒:"别忘这是对数坐标"——对数坐标下仍然陡峭,意味着真实增速还在加快。 - 供给侧(硬件)
:P100 16GB(2017)→ V100 32GB → A100 40/80GB → B200 192GB → Rubin 288GB(2026)。平稳、线性、每个世代约2倍——与模型侧万倍级的增长完全不成比例。 - 结论
:显存越来越贵、电力和水冷成了新瓶颈(韩松:36号楼地下室机房的散热已经是头痛问题)。缺口只能靠模型压缩与高效计算来弥合——这就是这门课存在的理由。
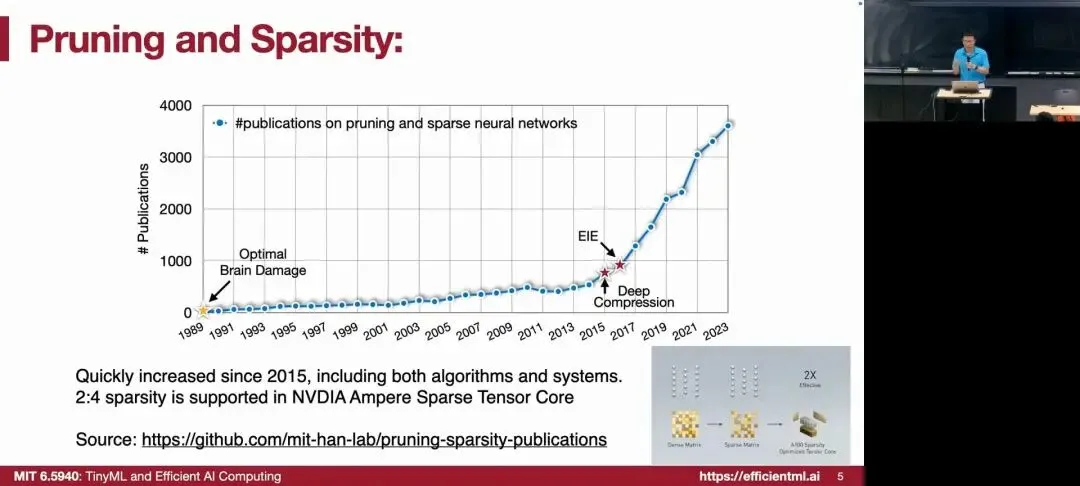
图4|剪枝/稀疏化论文数量趋势。从1989年"Optimal Brain Damage"到2015年后爆发式增长(含算法与系统两个方向);2:4结构化稀疏已被NVIDIA Ampere稀疏Tensor Core硬件支持。
课程维护着公开论文列表(github.com/mit-han-lab/pruning-sparsity-publications)。
方法论预览:剪枝(去掉冗余连接)、稀疏化、量化(低比特表示)——韩松的Deep Compression正是这条线的起点,而"2:4稀疏进入硬件指令集"证明了学术算法可以变成芯片特性。
三视觉篇:从超人类精度到MCU上的141KB训练
3.1 精度不是免费的
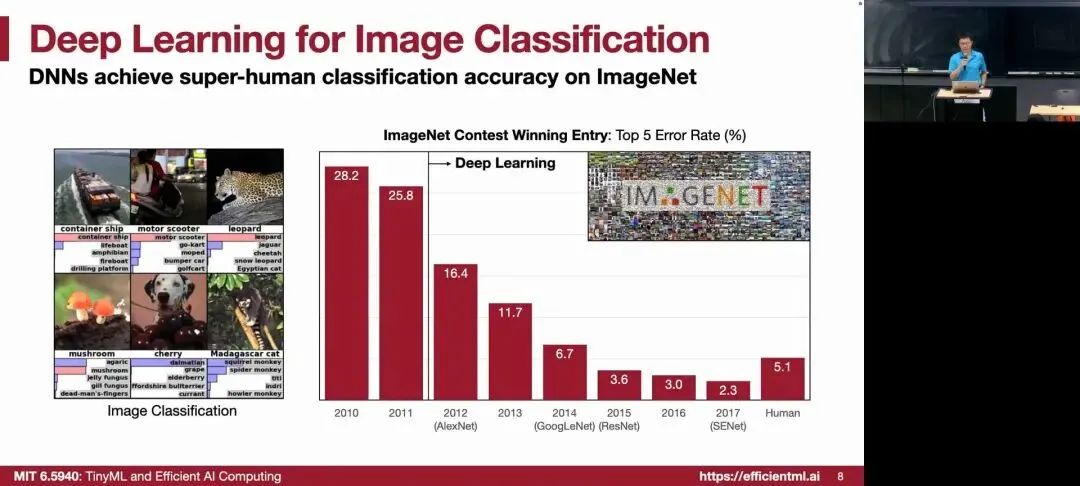
图5|ImageNet竞赛Top-5错误率。2010年28.2% → AlexNet(2012)16.4% → GoogLeNet 6.7% → ResNet(2015)3.6%,跨越人类基线5.1%。截取自课程视频
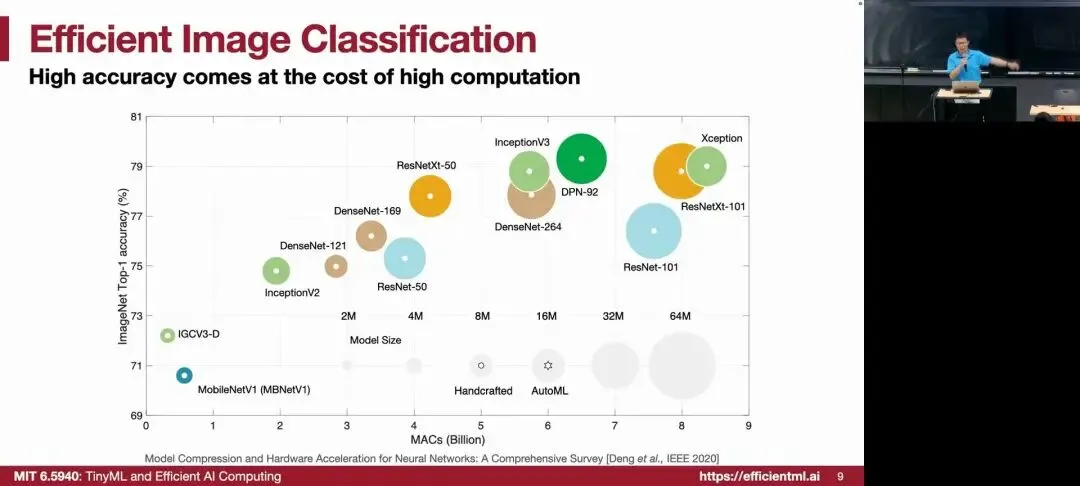
图6|精度 vs MACs的权衡前沿。右上角花更多计算买更高精度;左上角(更少计算、更高精度)才是目标——通过NAS、硬件感知设计把前沿往左上推,可以用约14倍更少的计算达到同等甚至更高精度。截取自课程视频
2012年AlexNet把ImageNet错误率从26%砍到16.4%,此后一路降到超越人类——但"天下没有免费的午餐":精度是用计算量(MACs,乘加运算)堆出来的。韩松反复强调那条权衡曲线:每一门技术(剪枝/量化/NAS/蒸馏)都会被放回这条曲线上检验——能不能把前沿推向左上角?这是理解整门课的分析框架。
3.2 手机与MCU:效率技术打开的部署边疆
效率技术打开了部署的边疆,三个层级逐级下沉:
- 手机端
:iPhone照片自动打标签、人脸识别(Apple在设备端做,隐私是核心动机)、姿态估计——都是效率技术的日常化产物。 - MCU端
:MCUNet(NeurIPS 2020)在ARM Cortex-M7 + OpenMV Cam上跑人检测和口罩检测——SRAM只有几百KB。 - 训练也下沉
:这是最颠覆的一步,见下。
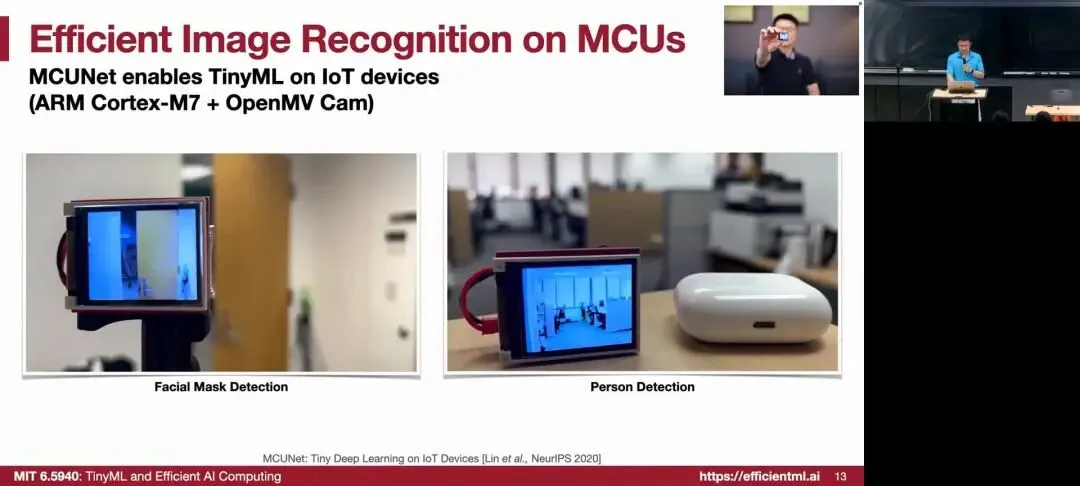
图7|MCUNet:微控制器上的TinyML。ARM Cortex-M7 + OpenMV Cam做人员检测与口罩检测。截取自课程视频
3.3 设备端训练:2300倍的内存压缩是怎么来的
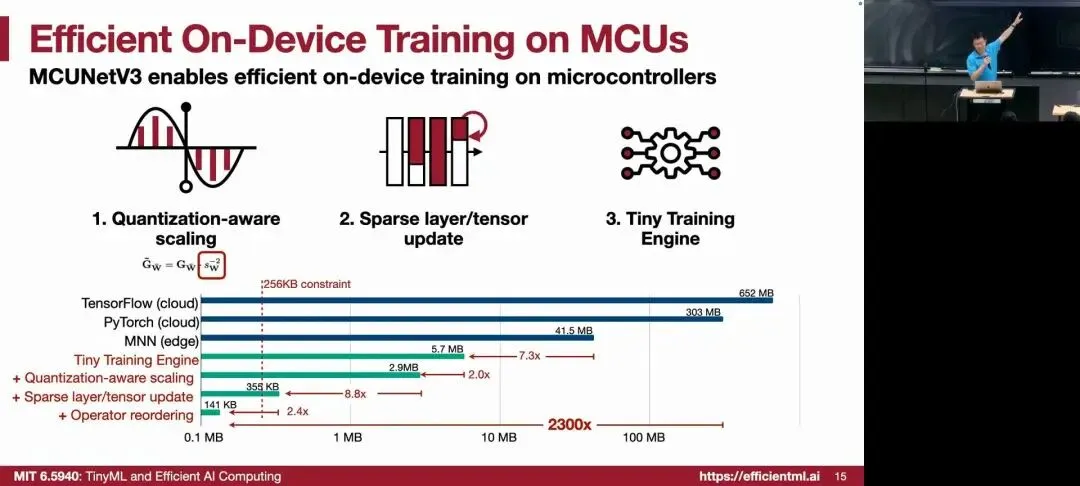
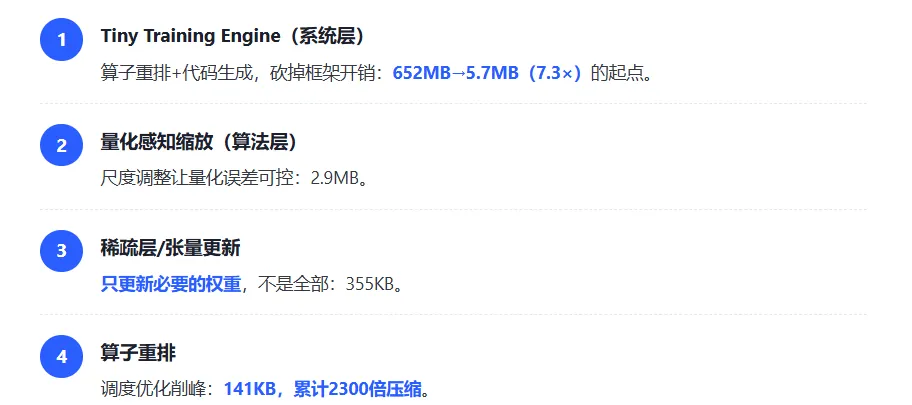
图8|MCUNetV3设备端训练的内存阶梯。TensorFlow云训练652MB → PyTorch云303MB → MNN边缘41.5MB → Tiny Training Engine 5.7MB(7.3×)→ +量化感知缩放 2.9MB(2.0×)→ +稀疏更新 355KB(8.8×)→ +算子重排 141KB(2.4×,累计2300×)。截取自课程视频
为什么要在MCU上训练?因为模型需要持续适应本地新采集的数据(音频/图像/文本),而数据因隐私不能上云。但训练比推理贵3倍(要存中间激活做反向传播),600+MB的训练内存需求对256KB的MCU是完全不可能的。
MCUNetV3的解法是四步瀑布,每步都有明确的乘数:
为什么这件事重要
现场演示:一块Cortex-M7开发板+两个按钮(红=有人、绿=没人),随机初始化的模型乱猜;按几次按钮采集样本、设备端反向传播(无网络、无云端),几分钟后模型就能高精度分类有人/没人。"只有几百KB你也能做很多事"——对IoT和传感器场景,这是从0到1的解锁。对FPGA背景的工程师,这页的启示是:算法-系统协同设计(co-design)才是数量级收益的来源,单一层级的优化到不了2300×。
3.4 分割与生成:48.9倍与"6万美元的账单"
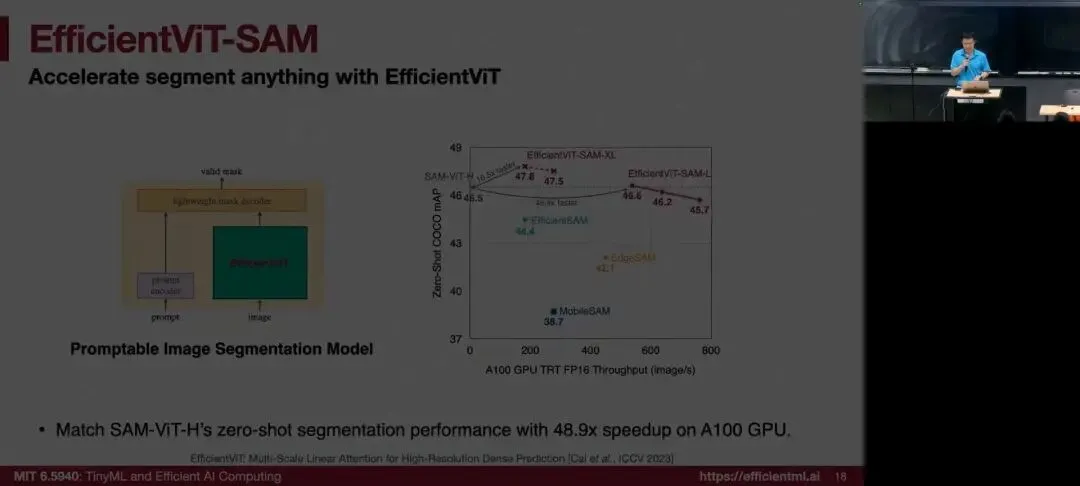
图9|EfficientViT-SAM。匹配SAM-ViT-H零样本分割精度(47.8 mAP),A100上吞吐量提升48.9倍;实测11 img/s → 182 img/s。核心技术:多尺度线性注意力替换二次方注意力。截取自课程视频
Segment Anything是AR/VR的关键模型,但原始SAM慢(ViT-H编码器)。EfficientViT用多尺度线性注意力把复杂度从O(n²)降到线性,同精度下快48.9倍——这是"改注意力机制本身"的路线,与剪枝/量化正交。
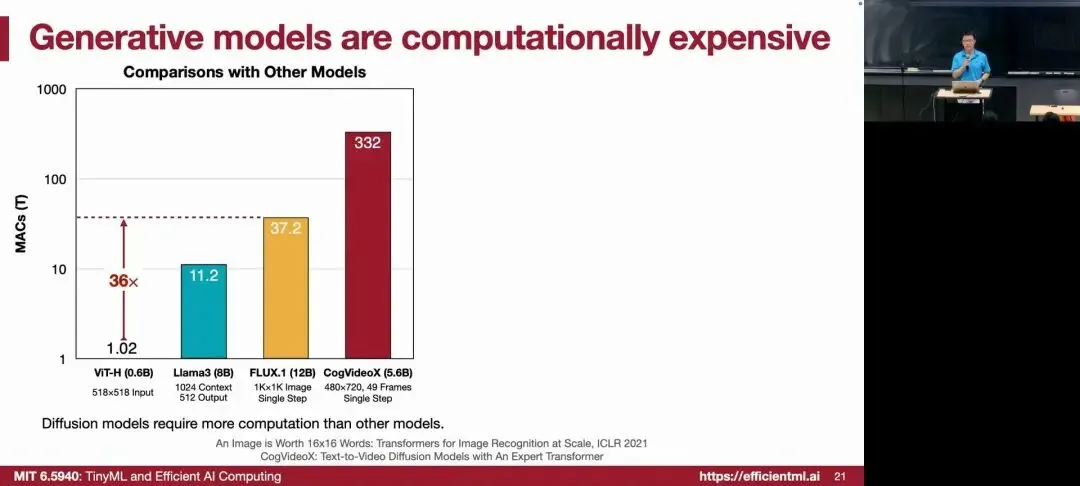
图10|生成模型的计算账单。单次前向MACs:ViT-H(0.6B,图像分类)1.02T → FLUX.1(12B,图像生成)37.2T(36×)→ CogVideoX(5.6B,49帧视频)332T(再8.9×)。训练Stable Diffusion花费$60万(256块A100,15万GPU时)。截取自课程视频
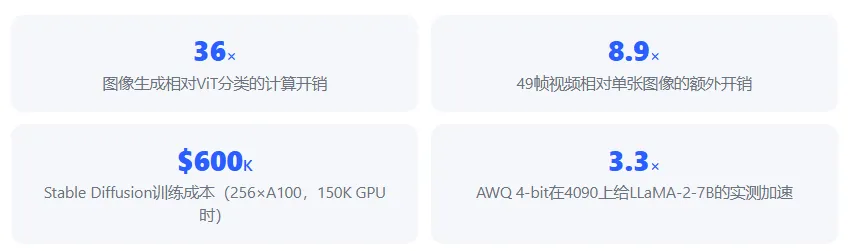
这张成本对比表是全课最"扎心"的一页:生成比理解贵一个多数量级,视频又比图像贵近一个数量级——而视频生成就要成为主流应用。效率技术对生成模型的几个切入点:GAN Compression剪枝9-21×;AnyCost GAN的"一次训练、多粒度子网络"(粗调实时预览、确认后跑全模型);SIGE空间稀疏(只算编辑区域):
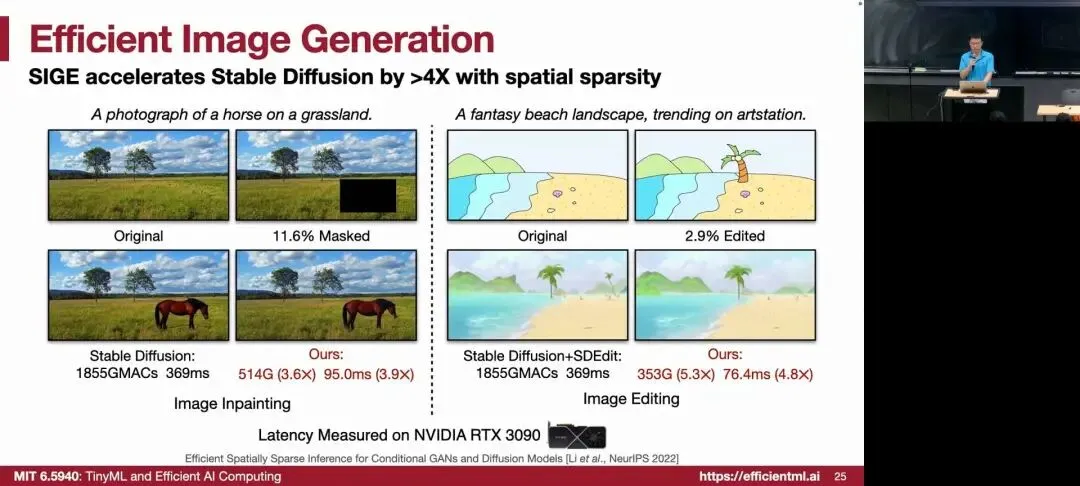
图11|SIGE空间稀疏加速Stable Diffusion。图像编辑:1855 GMACs/369ms → 514G(3.6×)/95ms(3.9×);局部重绘(inpainting):→ 353G(5.3×)/76.4ms(4.8×)。RTX 3090实测。截取自课程视频
另一个方向是分布式并行(DistriFusion):高分辨率生成一张图单卡12.3s,4卡朴素切分会产生"重复主体"的伪影,正确的并行通信方案4.16s且无伪影——这与LLM serving里的张量并行/序列并行是同一套问题:"计算便宜,数据搬运贵"(韩松的买菜比喻:从超市到冰箱、从冰箱到灶台,搬动才是成本)。
四语言篇:涌现能力的代价与量化三板斧
4.1 涌现的另一面:规模税
零样本/少样本/思维链(CoT)这些涌现能力随参数规模非线性增长——GPT-3在0.1B→175B的曲线上,few-shot精度一路爬升;CoT在GSM8K上的解出率更是要超过某个参数规模阈值后才陡峭上升。"精度不是免费的午餐,而且边际收益递减:想提高一点点精度,参数要增加一大截。"
CoT尤其"贵":以前只生成"The answer is 11"几个token,现在要生成完整的推理链——token数暴涨直接推高推理成本。"这进一步激励我们做高效AI计算。"韩松还开了一句玩笑:"现在最大的头痛是订阅的token用完了,最开心的时刻是token重置的那天。"
4.2 SpAtten:token也有冗余
语言模型侧的第一个效率示范是SpAtten(HPCA 2021):注意力图显示大量token几乎不被关注——"Attention is all you need,但你不需要attention到每个token"。级联剪枝可以11 token→5 token→2 token("film perfect")仍正确分类情感。这页的启发性在于:冗余不只是权重维度,token/序列维度同样可剪。
4.3 SmoothQuant与AWQ:让4-bit成为可能的两把钥匙
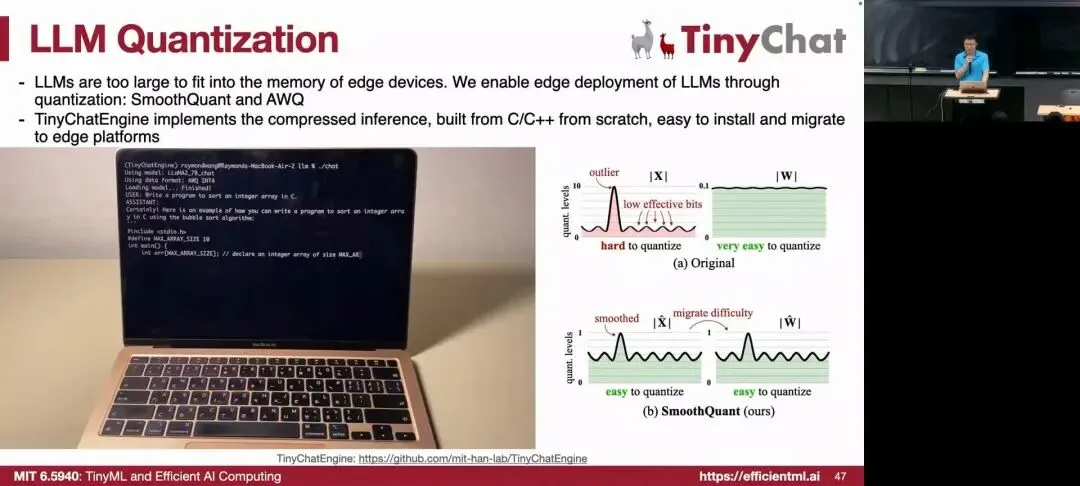
图12|SmoothQuant原理。激活中的离群值(outlier)让量化"难如用同一把尺子量长颈鹿和蚂蚁";通过数学等价变换把量化难度从激活迁移到权重,两边都变平滑,量化变容易。截取自课程视频
LLM部署到边缘的拦路虎是激活中的离群值——少数通道的激活值比其他大几个数量级,直接量化会崩。SmoothQuant的思路极其优雅:通过数学等价的缩放变换,把"难度"从激活侧搬到权重侧(长颈鹿变矮、蚂蚁变高),W8A8量化从此可行。这个工作是往届课程的期末项目(作者现为Thinking Machines Lab成员),已被NVIDIA TensorRT-LLM采用——韩松特意用它的成长路径激励学生:"你们的期末项目也可能产生大影响。"
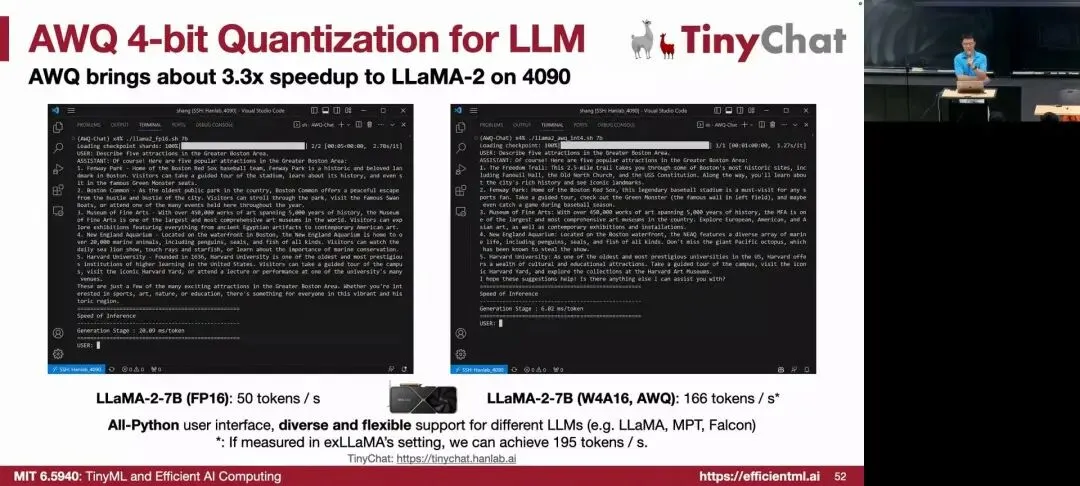
图13|AWQ实测。4090上LLaMA-2-7B:FP16基线50 tokens/s(20.09 ms/token)→ AWQ W4A16 166 tokens/s(6.02 ms/token,3.3×)。exLlama设置下可达195 tokens/s。截取自课程视频
AWQ(Activation-aware Weight Quantization,MLSys'24最佳论文)的核心洞察:不是所有权重同等重要——按激活分布保护约1%的显著权重通道,其余压到4-bit,几乎无损。落地形态是TinyChat引擎:3年前的MacBook Air本地跑LLaMA-2-7B;Jetson Orin上30 tokens/s;4-bit视觉语言模型VILA跑在MacBook M1的CPU上。韩松透露AWQ累计下载量超过6000万。
一张值得记住的实测对照
同一块4090、同一个LLaMA-2-7B:FP16每token 20.09ms → AWQ 4-bit每token 6.02ms。软件层面的量化直接把推理成本砍到1/3.3——这就是"不换硬件、只换算法"的收益上限参考。配合图14(硬件8年317×)一起看:算法收益与硬件收益是乘法关系。
五硬件篇:8年317倍与"软件吃掉一切"
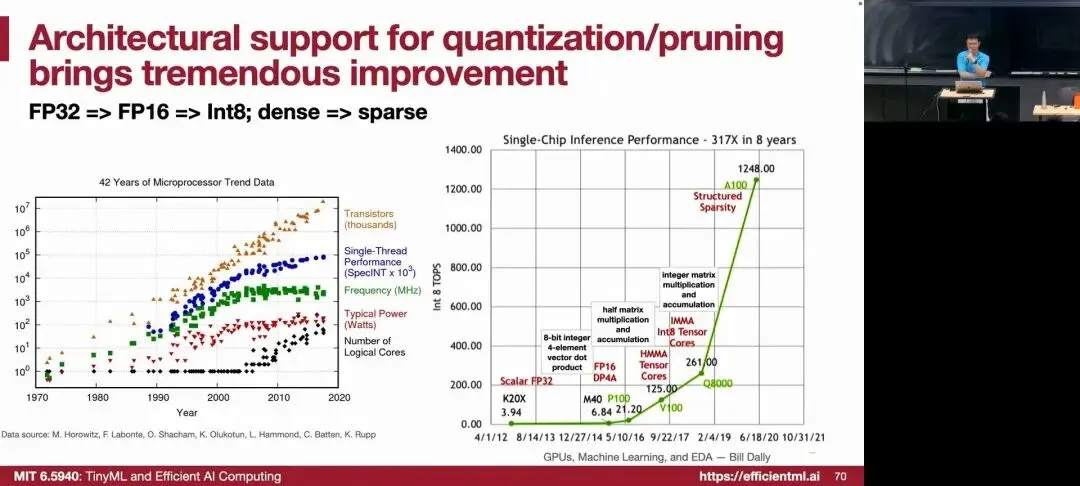
图14|NVIDIA单芯片推理性能8年317×。P100(2016)→Q8000:DP4A(P100引入8-bit点积)→HMMA(V100 Tensor Core,FP16矩阵乘)→IMMA Int8(A100)→结构化稀疏(Ampere)。注:此处317×为幻灯片数据(Bill Dally课程图表),OCR识别到317X与489X两个数字,以视频口述"超过300×"为准。截取自课程视频
硬件侧的故事:42年微处理器趋势数据显示单线程性能早已平台期、功耗平台期,并行+专用指令才是增长来源——DP4A、HMMA(Tensor Core)、Int8 IMMA、结构化稀疏,每一代架构特性都是"为AI运算定制"的结果。云端FP16性能从A100约300 TOPS到Rubin约4000 TOPS;显存带宽2TB/s→22TB/s。
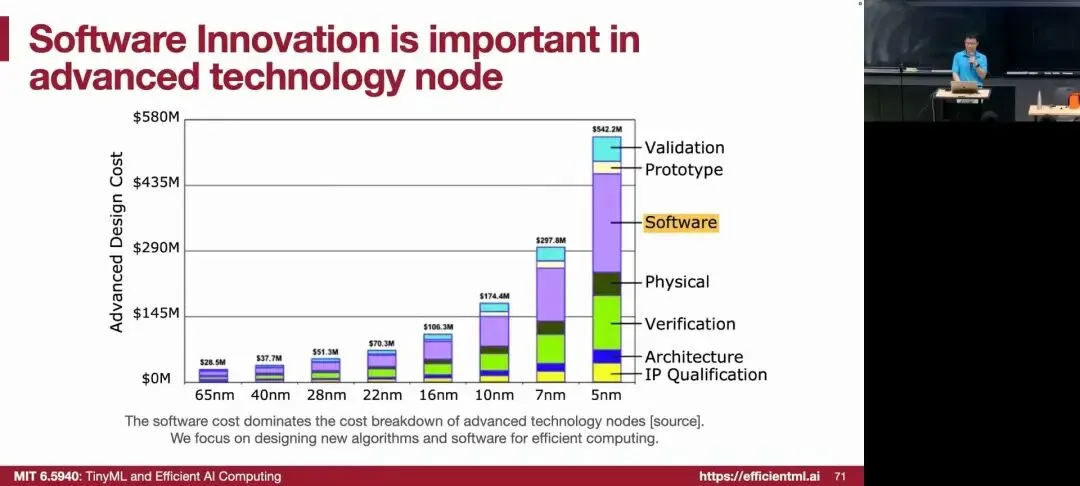
图15|先进制程节点设计成本拆解。从65nm到5nm,设计总成本从$28.5M涨到$542.2M;其中软件占比越来越大(5nm节点软件$297.8M,超过一半)。韩松的结论:"这门课全是软件——我们用硬件,但不设计新硬件。"
这张图解释了这门课的定位:先进制程的成本大头已经是软件。韩松明确说:"我们不设计新硬件,我们学纯软件技术——提升硬件利用率、提升模型效率、让模型更小更省。"
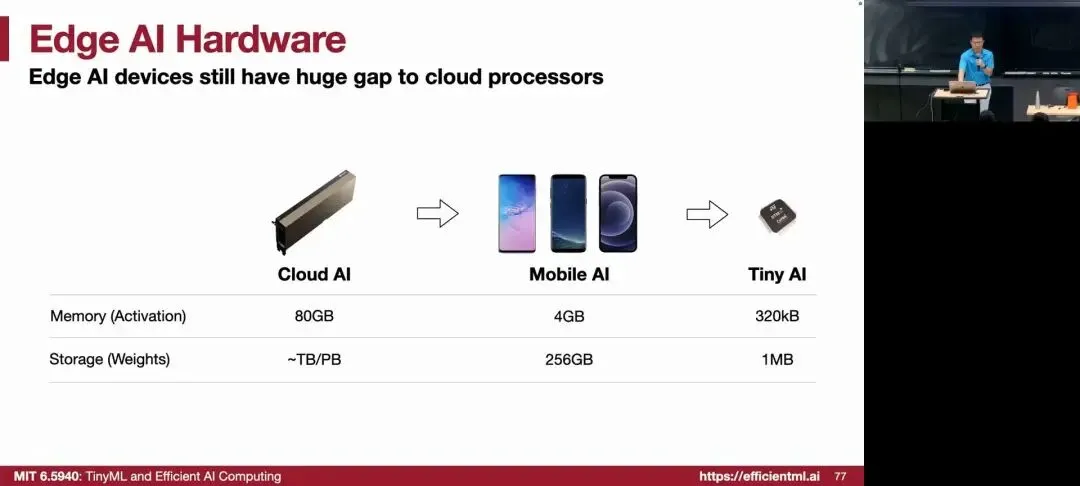
图16|Cloud AI / Mobile AI / Tiny AI三级阶梯。激活内存:80GB(云,权重存储TB/PB级)→ 4GB(手机,256GB存储)→ 320KB(MCU,1MB闪存)。截取自课程视频
边缘硬件巡礼:Jetson家族(Orin 64GB→Thor 128GB,275→1035 TOPS);高通Hexagon DSP(10W级功耗);Apple Neural Engine(6-8W,30+ TOPS);以及几百mW的MCU。三个数量级的功耗谱系对应三套完全不同的优化方法论——这正是课程三模块的由来。
六课程地图:三大模块与五个Lab
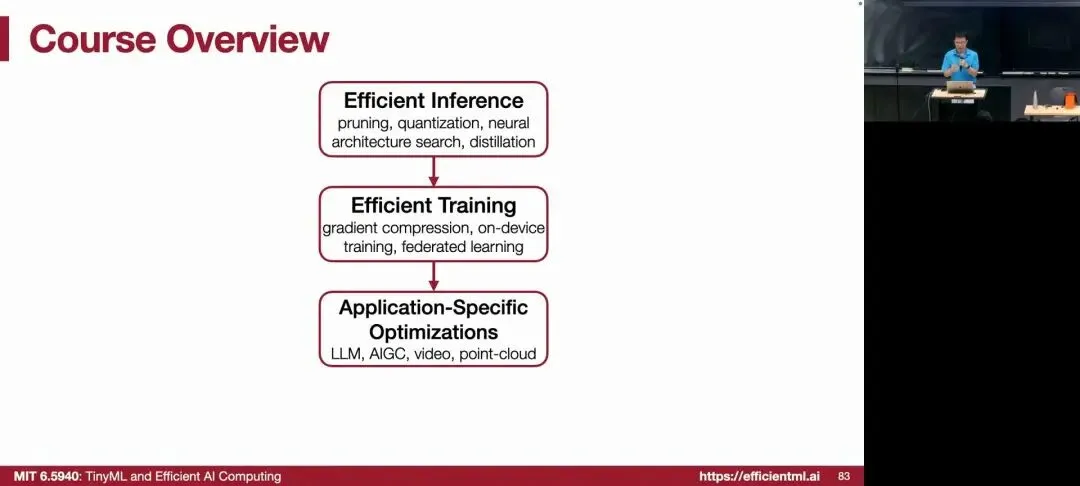
图17|课程结构。①高效推理(剪枝/量化/NAS/蒸馏)→ ②高效训练(梯度压缩/设备端训练/联邦学习)→ ③应用专项(LLM/AIGC/视频/点云);贯穿始终的是算法-系统协同设计。截取自课程视频
| 在自己电脑上跑通chatbot |
评分:5个Lab各14%共70%,期末项目30%(3-4人组队)。课程公开(efficientml.ai),视频全部放出,任何人都可以跟完——对国内工程师,这是眼下最系统的免费效率计算教材。往届期末项目的天花板是SmoothQuant(进了TensorRT-LLM),韩松的原话:"我希望你们中某些人的项目,几年后也会有大影响。"
七趋势判断:第一课透露的四个信号
信号一:效率研究的主战场已从CNN转移到LLM和生成模型
2022年版课程以MCU/嵌入式为主线;2026年版新增了大篇幅的LLM量化(SmoothQuant/AWQ)、扩散模型加速(SIGE/DistriFusion)、视频生成成本分析。剪刀差图里Model侧的最新标注是GPT-MoE-1.8T和Grok-3 2700B——研究对象跟着钱走。
信号二:算法-系统协同设计是唯一能拿数量级收益的方法论
2300×的训练内存压缩不是单点算法,是引擎+量化+稀疏+调度的乘法;48.9×的分割加速靠的是改注意力复杂度+轻量解码器。只会PyTorch层调API的工程师拿不到这些收益——这正是课程同时要求ML和体系结构双先修的原因。
信号三:端侧LLM已经跨过可用线
3年前的笔记本、Jetson、MacBook M1的CPU都能跑7B级模型,4090上166 tokens/s。当AWQ类技术的下载量以千万计时,"本地跑大模型"已经从演示变成了基础设施。对FPGA/边缘计算从业者,这是最直接的切入面。
信号四:人才需求的形状变了
300人选课的背后,是"serve模型+train模型"的工程岗位需求。这类岗位要求同时懂模型(量化/剪枝原理)和系统(内存层级/通信/并行)——传统的"算法工程师"和"系统工程师"分工正在这个领域消失。
读者行动建议
①课程全免费:efficientml.ai跟视频+lab,5个lab做完就拥有自己的本地chatbot部署能力;②先修自查:6.191(计算结构)+6.390(机器学习入门)等价基础;③论文列表github.com/mit-han-lab/pruning-sparsity-publications是剪枝方向的完整地图;④做AI硬件加速的读者重点看图8(2300×的协同设计分解)和图13(量化实测对照)——这两页是方法论样板。
— · — · — · —
本文学术诚信声明
本文全部课程内容、幻灯片截图、数据,均提取自MIT HAN Lab官方视频《EfficientML.ai Lecture 1 - Introduction (MIT 6.5940 Fall 2026)》(2026-09-11发布,1:03:15),经逐帧抽帧+OCR+完整字幕转写三重提取。
已核验的公开信息:
· 韩松个人主页(songhan.mit.edu):MIT EECS副教授、斯坦福博士(Bill Dally)、Deep Compression/EIE/AWQ作者身份、ICLR'16/FPGA'17/MLSys'24最佳论文、TR35/IEEE AI's 10 to Watch/Sloan/NSF CAREER、SmoothQuant与AWQ被NVIDIA TensorRT-LLM采纳、MLSys 2027大会主席
· 课程官网(efficientml.ai):2026秋课表、三模块结构、Lab设置与评分规则(幻灯片与官网一致)
· PyPI:autoawq包存在且活跃(AWQ算法官方实现)
演讲者口述(未经第三方独立验证):选课人数30→300四年曲线;AWQ下载量6000万+;Stable Diffusion训练成本$60万(256×A100,150K GPU时);MCUNetV3内存2300×压缩;AWQ 4090实测50→166 tokens/s;EfficientViT-SAM 48.9×加速;深鉴/OmniML收购细节;学生创业被收购。
OCR不确定项:图14"317X in 8 years"与OCR另一处"489X"存在识别歧义,正文以视频口述"more than 300x improvement in eight years"为准;5nm软件成本$297.8M数字来自幻灯片OCR,趋势判断(软件过半)与口述一致。
分析判断(作者观点):第七部分"四个信号"。
原始视频:MIT HAN Lab,2026-09-11|efficientml.ai
本文由课程视频内容+公开资料核验写成 · 转载请注明出处MIT 6.5940 Fall 2026 · TinyML and Efficient AI Computing · Lecture 1 Introduction