ARTICLE · 1039489
AI 出图要跑 50 步,为什么砍到 10 步还清晰,砍到 1 步就糊了?
一位朋友把出图工具里的 steps 从 50 拖到 4,0.6 秒一张,得意地喊我看他的杰作。我放大看了三秒:人脸是在的,五官却像隔着一层毛玻璃,头发和背景糊成一团。
我说这图压根就不能用。他还是有些不服:我调到 20 步的时候,跟 50 步根本看不出差别,怎么到 4 步就崩成这样?
这就是今天这一篇要讨论的内容:20 步和 50 步看不出差别,4 步和 20 步差得远——步数这根筋,到底断在哪儿?
其实我第一眼看到这些快要无法辨识的图片的时候,就完全对它的快提不一点儿起兴趣来了,质量这么差,还让人怎么用?质量还是要保证的才行呢。
但是为什么训练模型的人就没有发现这个问题呢?这个问题我后面回答。先说一步到底在干什么。
每一步,模型只敢认脚下那一段
扩散模型出图,是把一张纯噪声一步步擦回清晰画面。每个时刻 ,网络收到当前这张含噪图 ,输出它对噪声的估计 ,然后往前挪一小段:
是「到时刻 还剩多少原始信号」。
这个式子从哪儿来这件事儿本身,其实比它自己的形式更有意思。前向加噪的定义只有一句话:
这个点,完全可以用「干净图 加上噪声 」这一对坐标来确定。
上面那个 的式子,不过是把这句话反过来解了一遍。所以只要 和 同时给出,就等于宣布:我现在认定这张图是 ,它上面盖着的噪声是 。两个坐标都齐了,想拼在哪个时刻就拼在哪个时刻:
这一行就是步数能砍的数学依据。
每一步不必只挪一格,下一站可以随便挑。DDIM 论文里 10×–50× 的加速不是从天上掉的,是从这一行长出来的。
同一行也写着代价。 是在 这一刻估的,拿它去拼 ,等于把「此刻对终点的猜测」直接当成终点。
离 越远,这个替换越离谱。所以问题从来不是「能不能跳」,是「能跳多远」。
上限卡在网络那一头。它学的从来不是「这张图该长什么样」,而是「在这个噪声水平上,噪声大概是什么」。它是个局部模型,只在训练时见过的那几档噪声附近可靠。
可靠性还能量化。把 对 求个导:
其中的SNR是信号与噪声的比例,简称信噪比,是研究通信和信号里面的常见名词。
噪声估计差 ,落到画面上就是差 。信噪比在分母上,还开着根号——雾越大,同一口看错的代价就会被放大得越狠:
| 9.95 倍 | |||
大雾天开车就是这个感觉。能见度 30 米,你每 30 米打一次方向,一路开得很准;把你拎到山顶说「对面那条路你自己开过去」,你一步都走不了。
把「能见度」换成一个更硬的刻度:信噪比的对数 。
cosine 调度下,采样器走过的这一段从 一路降到 ,全距 14.7。 步就是把它切成 刀,平均每刀跨:
| 1549 倍 | ||
| 240 万倍 |
50 步的时候,每一步只要对「信噪比变了 30%」这一小段负责。1 步,是要一个函数一口气跨过 240 万倍。
这不是精度不够,是让它在一整段从没见过的输入上同时给出正确答案。所以步数少,第一层代价是离散误差:每一段走太长,方向和真实轨迹越差越远。
看完这些公式和数字,我才真正明白,这个一小步其实来自于底层的离散过程马尔科夫性质的不断应用得来的,如果想要一次性从开头走到结尾,那就要抛弃那些优美的马尔科夫无记忆性质了,数学基座恐怕都要完全重新改变才行。
这句话我放在这儿,后面讲一致性模型的时候兑现它。
50 步砍到 10 步,为什么几乎免费
光讲道理不算数。我跑了个小实验,把「模型自己学得不准」这个干扰项彻底去掉。
数据是平面上 8 个高斯小团,围成一圈,这就是「真实分布」。扩散加噪用的是标准的 cosine 调度,采样用确定性 DDIM。
区别在于:这个数据分布的噪声预测 有闭式解,我直接代入精确公式,不训练任何网络。
也就是说,下面这条曲线上一个误差都没有,唯一的变量就是步数。
| 0% | ||
| 0% |
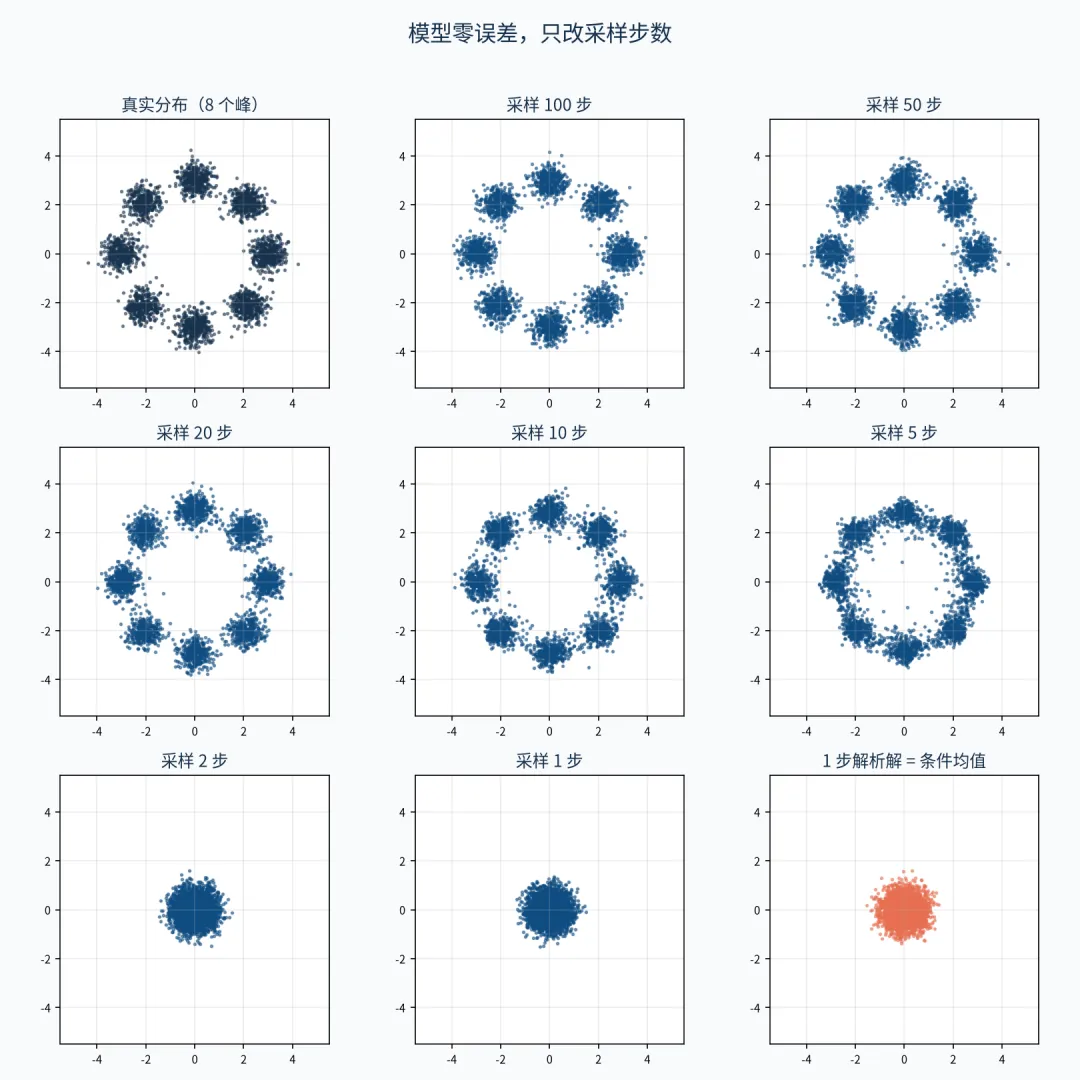
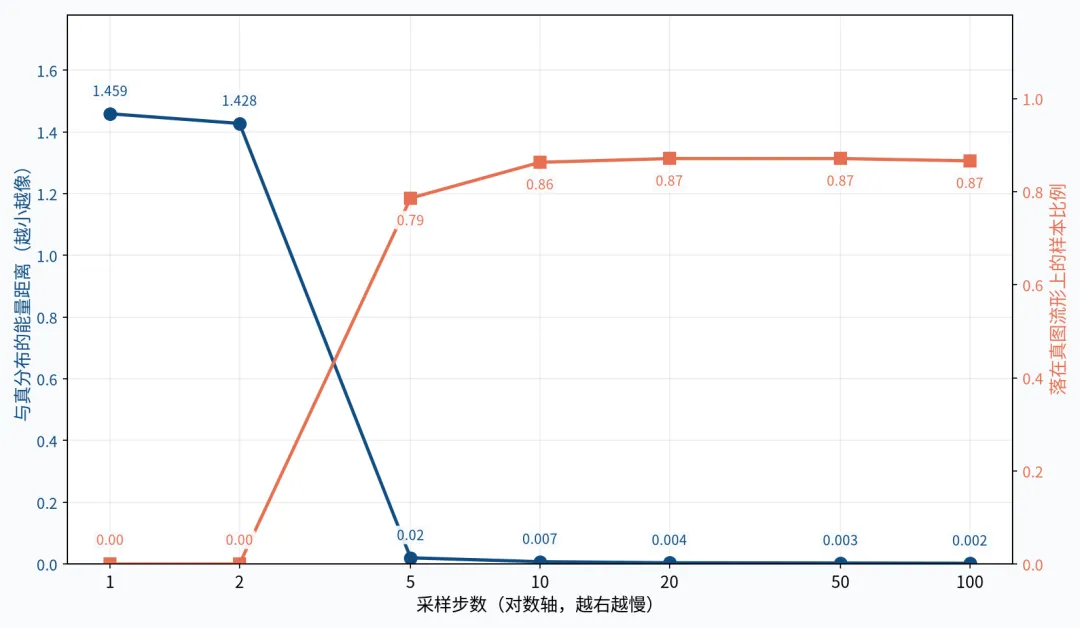
50 步到 10 步,步数少了 5 倍。能量距离从 0.0032 涨到 0.0075——是涨了,但绝对值仍然贴着 0。「画到真图上」的比例从 87.1% 掉到 86.3%,基本没动。这段路是免费的。
免费的原因就是上面那个脾气。
一阶偏微分方程 ODE 求解器每步的局部误差是步长的二阶小量:把 当成常量往外推,泰勒展开丢掉的首项是 , 是步长。
一共走 步,最坏情形下误差直接累加,得 。全局误差 。
是纸上的。
我想知道它在这儿到底是多少,于是换了个更狠的测法:同一批纯噪声起点,跑 的那条解当作「精确 ODE 解」,再拿 步的解去减它。
起点一模一样,减出来的就只剩离散误差,抽样噪声一点都没混进来。
| 4.04 倍 |
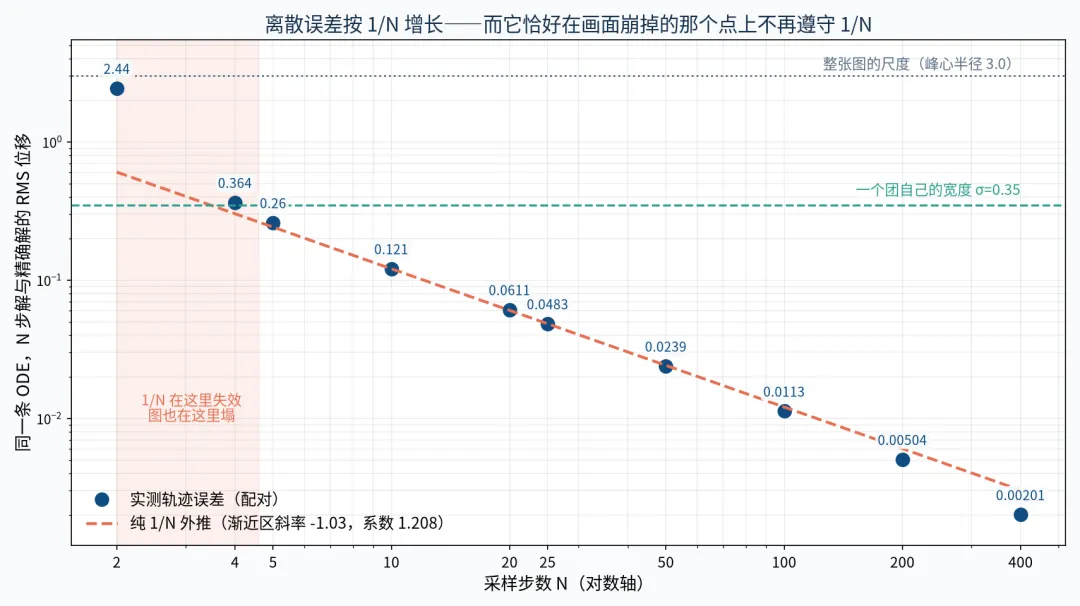
第三列是判据。误差真要服从 , 误差就得是个常数。它在 10 到 50 步这一段稳在 1.19–1.21,拟合斜率 。 成立。10 步的误差是 50 步的 5.07 倍, 预测的是 5.0 倍。
其实真正还应该细说的是第四列:这个误差要跟什么比。
我仔细琢磨了一下,才发现其对象并不是跟整张图的大小,而是跟你要保持自己的细节的某个标准尺度,在这份数据上就是每个高斯团的尺度范围,即标准差 ——误差超过这个范围,一个点就被推了出去。
50 步:0.07 个标准差,看不见。10 步:0.35 个,还没越界,所以 86.3% 稳得住。5 步:0.74 个标准差,团和团开始互相抹。4 步:1.04 个团宽,正好一个团。
第五列最要紧。 时实测误差已经比 的外推值高出 21%, 时涨到外推值的 4 倍。幂律失效的地方,和画面崩掉的地方,是同一个地方。 砍步数不会给你「比理论更便宜」的结果,只会越砍越比 说的更糟。
(、 那两点落在拟合线下方。不是收敛律变了,是 这条参考解自己也有误差,量到那个尺度就量不动了。幂律只在该成立的那一段成立。)
这也顺手解释了开头那张表为什么读不出 5 倍。
能量距离是个两样本统计量,它有自己的噪声。我从真实的分布里独立抽两批 3000 个样本互相比——这就是「完全采对」时它能给出的读数。
8 次下来均值 0.0051,标准差 0.0022,最小 0.0021,最大 0.0081。
对照那张表:100 步到 10 步的读数全在 0.0024–0.0075,整段埋在这条噪声带里;5 步的 0.0200 才刚探出头。
所以 50→10 那个 2.34 倍,压根不是被压扁的 5 倍,它是噪声带内部的抖动。想量出真正的 ,就得换掉这把带噪声的尺子——这才是上面那个配对实验存在的理由:同一条起点相减,抽样噪声整个消掉。
然后是断崖。2 步,马上就会归零。
塌到 0%,不是「不够精细」,是它只能给你一张平均脸
步数从 5 到 2,质量不是线性下滑,是整个分布的性质都被替换了!
样本不再分布在 8 个团上,而是全部聚到圆心附近——平均半径从真实数据的 3.0 掉到 0.57,而 5 步时它还停在 2.78。
这不是我调参调坏了。
我换了时间网格(按 log-SNR 均匀取点,和均匀网格是两种完全不同的走法),5 步、2 步的结果一样塌。
那 1 步最好能到什么程度?这个可以严格算出来。一步走完全程,等于要找一个函数 ,把纯噪声 直接映成一张图,让它在均方误差下尽量接近真实数据。均方误差的最优解是条件均值:
这个 不用查表,四行能推完。记 ,往要最小化的式子里加减这一项:
1 跟 无关,2 非负,3 是交叉项。
只需要看 3:对它先对 取条件期望, 只含 ,整块能提到外面,里面剩下 。
交叉项没了,2 要最小只能取 。
证明不难。难的是它顺手给出的三件事。
第一件:那个最小值严格大于零。 上面式子里的 1,也就是 ,跟 一点关系都没有,网络怎么设计都动不了它。全方差公式把这项摊开:
左边这项是组内——该画哪个峰;右边这项是组间——一步映射拿得到的。
实测:总方差 9.2335,组间 0.4056,组内 8.8389,两项加起来 9.2446(差 0.1%,是蒙特卡洛的零头)。一步能带走的方差,占全部的 4.39%。
剩下 95.73% 锁在条件分布里,任何确定性的 都碰不到。
第二件:换成比特说,更狠。 记峰编号为 。8 个峰等概率,「这张图该画哪个峰」恰好是 bit。
起点是纯噪声时,这 3 bit 在 里还剩多少?拿后验责任直接算互信息:
3 bit 进去,0.063 bit 出来,存活 2.1%。方差那本账给 4.4%,比特这本账给 2.1%。两把尺子量的是同一件事:一步映射基本就是在盲猜。
第三件:它落在哪儿也算得出来。 这团糊并不在正中心,这一点我一开始没看懂。
8 个峰心是精确对称的,;权重一模一样的话,条件均值就该落在原点(真按均匀权重算,模长 ,就是 0)。
可 cosine 调度在 端被压到 ,还剩 的信号没抹干净。就是这 10% 的残影让后验权重偏了——平均最大责任 0.175,均匀是 0.125——把输出拽到半径 0.5692 的位置。
我把这个解析最优解直接算出来,和 DDIM 跑 1 步的结果对了一遍:能量距离 1.4427 对 1.4589,差 1.1%;输出半径 0.5692 对 0.562。
也就是说,1 步的采样器已经贴着理论上限了。上限本身就在 1.44 那个位置,而好的采样是 0.003。
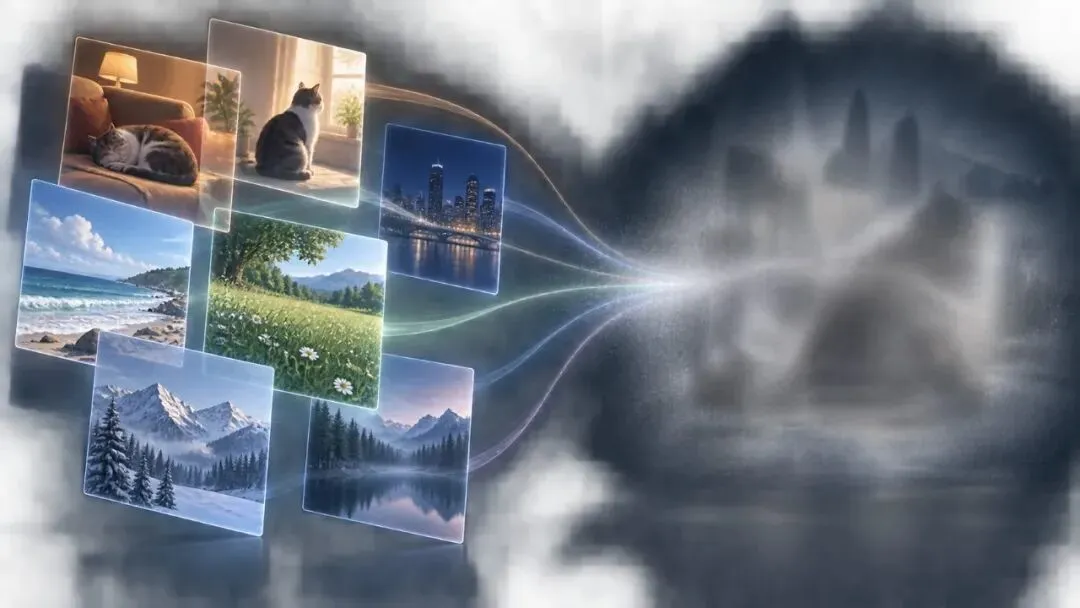
原因就在「均值」两个字上。起点是纯噪声时,一张图对应着成千上万个都合理的真图:这只猫可以朝左也可以朝右,背景可以是沙发也可以是草地。它们全都是「正确答案」。
而你要求一步给出唯一输出,均方误差下最优的唯一输出,就是把所有正确答案平均掉。
平均出来的东西,就是那团糊。
我盯着这些数字,仔细核验了一番,才想明白这完全不是巧合。
它正说明了随机性背后一些更深刻的底层规律,这些规律是你换取任何采样器都不会起作用的本质规律:一个步骤想要走完全程,求得的最优解,本来也就只能是一张平均的脸吧。
「糊」只是它好认的那一半。另一半更隐蔽:一步映射是确定函数,同一个噪声进、同一张图出,分布的整个尾部拿不到——多样性先于清晰度死掉。失去多样性的后果,就是你的生图模型完全没多少人会用了,因为千篇一律嘛。
有些 1 步模型看着挺清楚,但你换 20 个提示词,它翻来覆去就是那几张脸。
现在这句话说得准了:不是「有点单调」,是最多 4.4% 的方差,输出只能落在一小张片子上。
所以 1 步不是砍出来的,是重新养出来的
回到前面那个问题:训练模型的人没发现吗?发现了,而且这条路是被他们一步步蹚出来的。
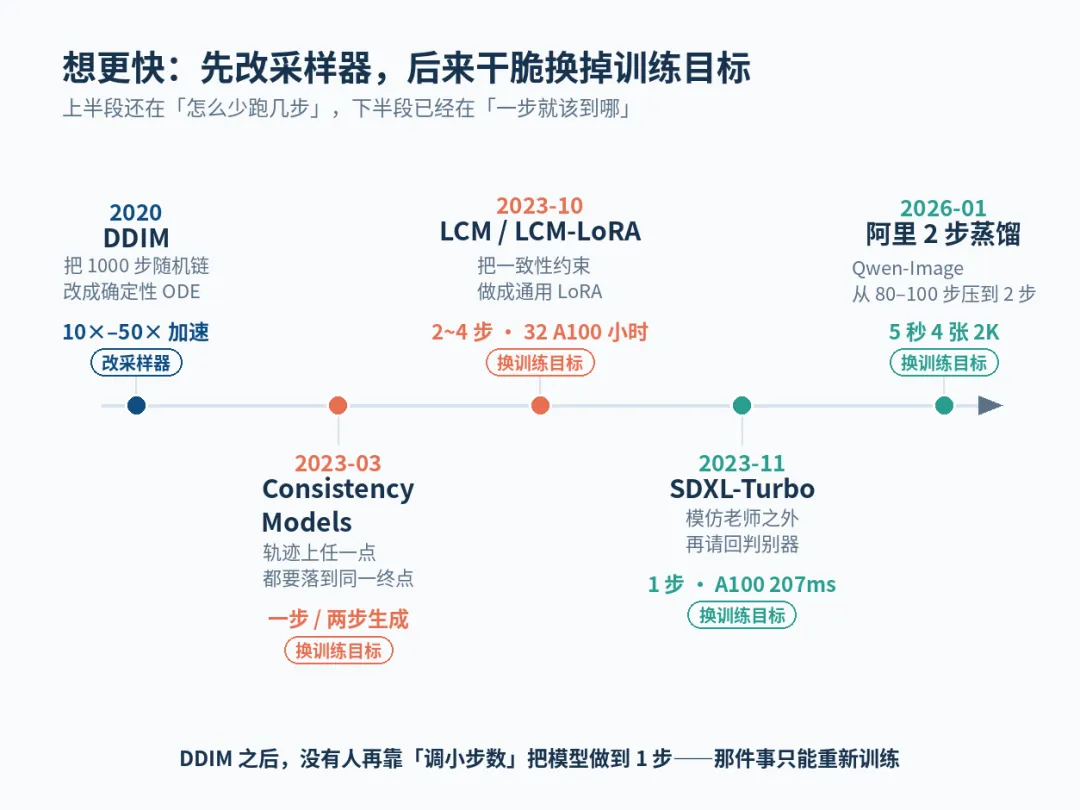
注意这条线的走向:从 DDIM 往后,谁都没在「改采样器」上继续使劲。
DDIM 之后想再快,就得换一个训练目标——不再问「这一步往哪儿挪」,而是把「一步就该到哪」直接压进网络里。到 SDXL-Turbo 那一步,光靠模仿老师的去噪轨迹已经不够了,还得请回一个判别器,指着那张图说:这张不够真。
「换一个训练目标」具体换成什么,是能写出来的。
记 为「从 时刻一步跳到干净图」的网络,一致性模型要求同一条轨迹上相邻两点的输出互相咬合:
是慢一步的影子参数。
右边那个边界条件是硬写死的:噪声为零时,输出必须就是输入本身。有了它,相邻咬合就能一路推出去——轨迹上任意一点,都映到同一个终点。
第一节那句「数学基座要换」,到这儿兑现了。
看清楚换掉的是什么:不是「把局部步子走得更准」,是把局部性整个拿掉。DDIM 虽然把马尔可夫链改写成了 ODE,它仍然一步一步走,每步只信脚下这一格。
上面这个损失里同时出现了轨迹上的两个点——它约束的是一条线,不再是一个点。更要紧的是,这个损失里没有「真图」这一项。上一节那团糊,是因为均方误差拿一张固定的真图当靶子;分布是多峰的,打哪个峰都不对,只好打中间。
这里没有靶子。它不要求你对,它要求你自洽。
其实,我觉得他们并不是真的找到了更快的走法,而是将这整个问题都换了一个思路去求解,不是问怎么样更好地挪一小步,而是朝着目标来问,这张够不够逼真?
自洽本身当然不够——常数函数最自洽,把谁都映到同一个答案,直接退回上一节那团糊。
所以边界条件钉住「噪声为零时不许动」,另外还得有个老师、或者一个判别器,在旁边嫌你假。
Turbo 那一步补的就是这个:光靠自己咬自己,长不出真实感。这个「会嫌它假的东西」具体怎么工作,我写在 GAN 那篇里(《GAN 一步就能出图,为什么输给了要跑 50 步的扩散?》),这里就不啰嗦重复了。
回到朋友那张 4 步的图
他犯的错现在能说清楚了。20 步能看,是因为离散误差只有 0.18 个团宽,还在「本来就小」的那一段里。
调到 4 步,实测误差 0.364——正好一个团宽,每个点都被推出了自己那个团,而且这里已经比 外推的糟 21%。再往下到 2 步,误差 2.44,是整张图尺寸的 81%, 彻底不作数了。
所以那不是「差一点」,是全塌。他是拿「砍步数」这个工具,去干了一件必须重新训练才能干的事。工具和问题不匹配。
三条能直接用的判据:
1. 原模型别乱砍。 10–20 步是安全区,对应 0.18–0.35 个「细节宽度」的离散误差,砍到这里省下的一半时间基本白拿;砍到 5 步以下,你换到的是另一个东西,不是「更快的同一张图」。 2. 要 1–4 步,就去拿官方蒸馏权重。 Turbo、LCM、Lightning、2 步 LoRA 这些都是重新训过的模型,不是原模型调小 steps。同名模型换个步数就指望它变快又变好,做不到。 3. 认两种坏法。 糊是步数不够,好认;难认的是同质化——图不糊,但一批下来风格、构图、脸都一个样。看到这种情况,别调 steps,那是模型本身的问题。
其实我自己如果有机会空着生图的steps, 正常情况下,都会宁可选大一点,也不愿为了速度而牺牲质量,毕竟反复抽卡生图,也是要耗费积分或者额度的。
省下来的那几秒,抵不过多抽两次卡。步数这件事,从来不是越快越好,而是在哪个点上开始不划算。
这个点是能算的。 误差在我这份数据上稳在 1.2 上下,所以离散误差大约是 ;拿它去除以你最在意的那个细节的尺寸,商降到 1 附近,就是不划算的位置。
系数 1.2 是这份玩具数据量出来的,换到真实图像上得重新量;但判据是同一个:误差别超过你在意的那个细节本身。
你现在出图把 steps 定在多少?有没有哪一次砍狠了、事后才发现不对劲?评论区聊聊。
觉得这篇把「步数」这件事讲明白了,点个赞 👍、收藏 ⭐ 备用。关注「数解AI」,更多底层逻辑为你一一展现。
📖 视觉生成:生成 30 秒视频要画 900 张图,AI 视频为什么这么贵? → AI 生图好看能到 91.87 分,为什么招牌上的字还是错的? → AI 视频里的字,为什么一帧一个样?10 个模型考下来最高 37% → GAN 一步就能出图,为什么输给了要跑 50 步的扩散? → AI 出图要跑 50 步,为什么砍到 10 步还清晰,砍到 1 步就糊了?(本篇)
🔥 热门文章:
KV缓存存进SSD:慢50倍的硬盘,为什么反而更快?高维空间为什么全是壳?内积才是那把尺子高斯为什么二阶就够?非线性去哪了学习率怎么自动调?Adam 优化器拆给你看DeepSeek-V4为何不用MLA?SFT微调:1万条数据就能让模型听话?GAN 一步就能出图,为什么输给了要跑 50 步的扩散?生成 30 秒视频要画 900 张图,AI 视频为什么这么贵?AI 生图好看能到 91.87 分,为什么招牌上的字还是错的?AI 视频里的字,为什么一帧一个样?10 个模型考下来最高 37%
参考资料
1. Song, J. et al. (2020-12-15). Denoising Diffusion Implicit Models. ICLR 2021. 确定性采样与 10×–50× 加速口径。 2. Ho, J. et al. (2020-06-19). Denoising Diffusion Probabilistic Models. NeurIPS 2020. 1000 步马尔可夫加噪链。 3. van den Oord, A. et al. (2016-01-25). Pixel Recurrent Neural Networks. arXiv:1601.06759. 「均方误差预测多峰分布均值 → 模糊」的原始论述。 4. Song, Y. et al. (2023-03-02). Consistency Models. ICML 2023. 一步/两步生成的训练目标。 5. Luo, S. et al. (2023-10-06). Latent Consistency Models. 2~4 步、32 A100 GPU 小时。 6. Sauer, A. et al. (2023-11-28). Adversarial Diffusion Distillation. 及 Stability AI SDXL Turbo 发布稿(1 步、A100 207ms)。 7. 量子位(2026-01-30). 5秒出4张2K大图!阿里提出2步生成方案,拉爆AI生图进度条. 8. 本文玩具扩散实验:8 峰高斯混合 + cosine 调度 + 确定性 DDIM,噪声预测用闭式精确解(零模型误差),seed 20260919。主实验脚本 run_experiment.py(数据在results.json)。新增推导另由analyze_math.py核验(数据在math_audit.json):配对收敛阶、全方差分解、峰编号互信息、 误差放大倍率、log-SNR 全距、能量距离的抽样噪声。正文与图里每个数字都能在这两份 json 里查到。
#扩散模型 #AI生图 #采样步数 #DDIM #数解AI