ARTICLE · 1062411
PDF转完还是写不了引用?我用脚本回查了11张证据卡
导读写 Related Work、组会材料、论文草稿时,最尴尬的不是没读文献,而是导师问「这句话在第几页」,你只能凭印象报一个页码。报对了像运气,报错了直接掉信任。
问题通常不在「读得不够」,而在证据链缺接口:主张要能回到 file + page + quote。解析器再漂亮,没有页码锚点,也写不出可交接的证据卡;卡写了却靠记忆填页码,核对时一样会翻车。
本文用 5 篇公开论文、11 张证据卡做一次真跑:先核对原卡,再故意注入错误页码,看脚本能不能拦住。
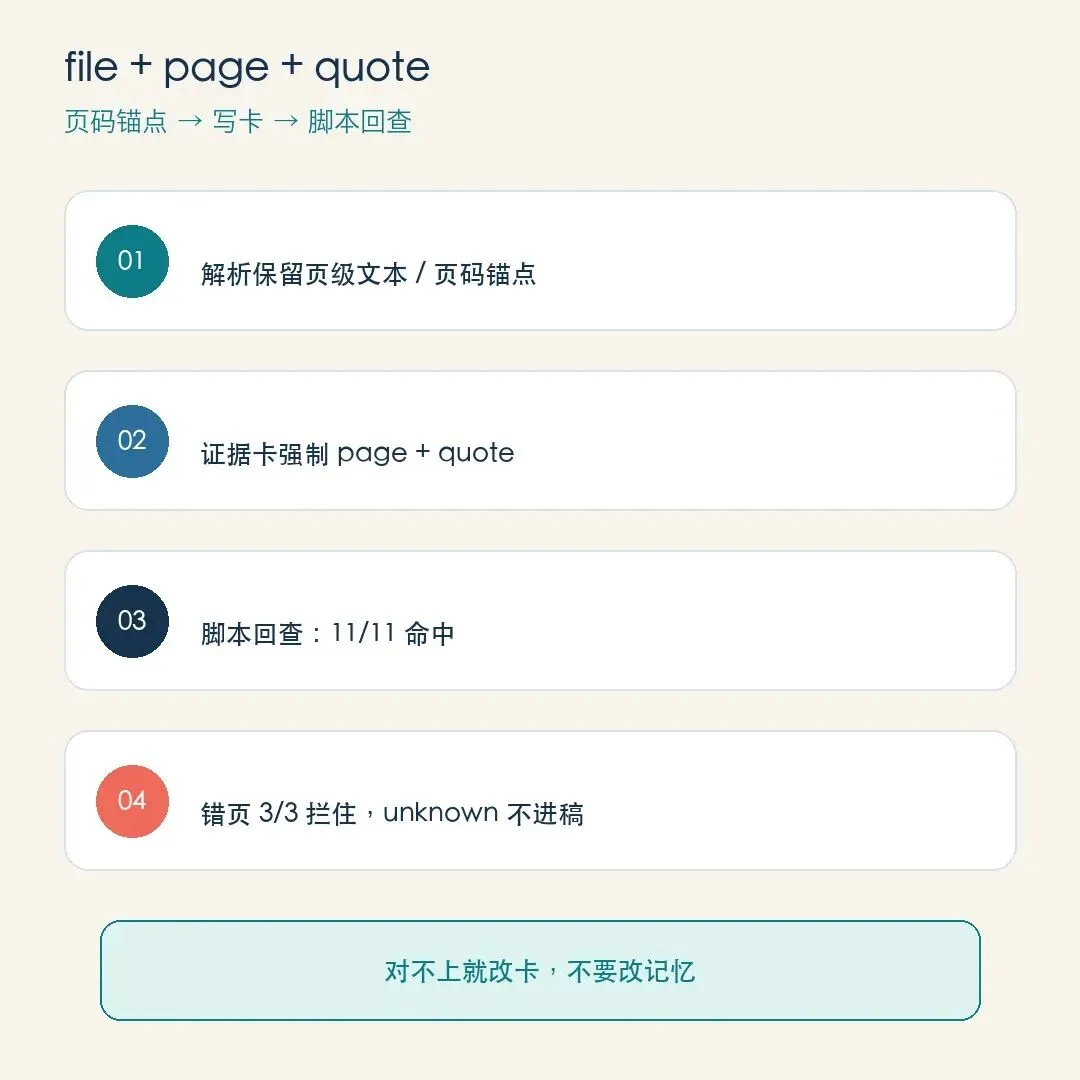
先说结论:引用的最小接口是 file + page + quote。页码不要靠记,要靠回查脚本;解析结果若无页码锚点,先补锚点再谈综述。
章节固定任务
机械步骤合计约 1.26 秒(含 5 篇 PDF 抽页)。 时间不该花在「再翻一遍 PDF」,而该花在「这句主张能不能进稿」。
章节为什么「页码锚点」比「Markdown 干净」更关键
很多 PDF→Markdown 管道默认优化可读性,却把页码丢掉了。固定样本上的页码锚点扫描结果:
| 868 | ||
| 0 | ||
| 0 |
这不是「谁解析得更准」的排名,而是能不能当证据链接口的差别:
●要写证据卡、脚注、Related Work:先问输出有没有 page;
●只要浏览摘要、做粗检索:干净 Markdown 往往够用;
●无论用哪条解析链路,最终引用前仍要用页文本回查 quote。
章节路径 A:11 张原卡,页码 11/11 命中
11/11 页码命中。 注意 C2:它是限制卡。若只保留「效果很好」的主张,后面复现会再踩一次重复生成的坑。
章节路径 B:故意写错 3 个页码,脚本 3/3 拦住
每隔 4 张卡,把 page 改成错误值(原页 +3),quote 不动——这正是「凭印象填页」的典型错误形态。
| 3 | |
| 0 |
脚本不修改 PDF,也不「猜正确页」;它只回答一件事:
这条 quote 是否出现在你声称的那一页?对不上就改卡,不要改记忆。
章节30 行级回查逻辑(可直接照做)
def quote_hits(page_text: str, quote: str) -> bool:
norm = lambda s: re.sub(r"\s+", " ", s).strip().lower()
return norm(quote) in norm(page_text)
# 对每张卡:
ok = quote_hits(pages[card["page"] - 1], card["quote"])
# fail 时,可扫描全文找出 quote 实际出现页,作为最小下一步
三条使用规则:
1没有 page 就写 status=unknown,禁止用顺口页码填空。
2对不上就改卡,不要改「我记得在第 5 页」。
3脚本只验证引文位置;主张是否被实验支持,仍要你自己判断。
交接字段保持最小:
id / claim / source(file) / page / quote / status / notes
章节可直接套用的引用前 5 项检查
五项全过,材料才适合进组会、开题或投稿草稿。
章节和「多读几篇」的区别
引用质量的上限,不在最后一晚的措辞,而在解析与写卡阶段有没有留下可回查的页码接口。
章节最小可执行节奏(约 20 分钟)
1先确认 PDF 抽取能按页保留文本(pypdf / 带页锚点的解析器均可)
2只写本周真正要进稿的 3~5 张卡
3每张卡强制填 page + 短 quote
4跑一次回查;fail 的卡标 unknown,写最小下一步
5提纲或草稿里只保留通过回查的句子
章节边界
●本次覆盖数字型 PDF 文本层;扫描件需另配 OCR 链路
●quote 匹配做了空白归一化,不替代人工语义核对
●解析器页码锚点数据来自固定样本与版本,工具升级后需重测
●页码命中 ≠ 你已理解全文论证;精读仍不可省
章节结语
写得稳的引用,不是记得牢,而是每句话都能被脚本打回原页。
先保证 file + page + quote 可回查,再改文笔——顺序反了,综述只会越写越虚。
这里持续更新可复现的科研工作流跑法、失败边界和能直接套用的字段模板。
章节参考资料
01 Attention Is All You Need(arXiv)
arxiv.org/abs/1706.03762
02 BERT(arXiv)
arxiv.org/abs/1810.04805
03 LayoutLMv3(arXiv)
arxiv.org/abs/2204.08387
04 Nougat(arXiv)
arxiv.org/abs/2308.13418
05 PubTables-1M(arXiv)
arxiv.org/abs/2110.00061
06 Docling(GitHub)
github.com/docling-project/docling
07 MinerU(GitHub)
github.com/opendatalab/MinerU
08 Marker(GitHub)
github.com/datalab-to/marker