ARTICLE · 1068786
国产 AI 编程工具,开始正面刚 Cursor
智谱开源了 ZCode:一个不写代码编辑器、只做「指挥台」的 AI 编程工作台。月费 18 美元起,还能把同样的订阅接到 Claude Code 里用。
先说结论
ZCode 是一款「没有代码编辑器」的编程工具——它把整个产品做成一个任务指挥台,你描述目标,它去规划、改文件、跑命令、开浏览器验证,最后把结果拿给你审。
它背后是智谱(Z.ai / 原 Zhipu AI)的 GLM-5.3 模型,一套月费 18 美元的编程订阅,能同时用在 ZCode、Claude Code、Cline、OpenCode 等 20 多个工具上。对国内开发者来说,最有价值的一点其实不是「能不能替代 Cursor」,而是:它把国产模型的编程能力,第一次做成了一个完整、可评审、能自动化的产品形态——而不是一个只能聊天的对话框。
它到底是什么
先把名字理清楚。Z.ai 是智谱的海外品牌,GLM 系列模型出自清华系的研究团队。和 OpenAI、Anthropic 不同,智谱既卖 API,也在 Hugging Face 上放模型权重——GLM-5.3 的权重在 2026 年 8 月 28 日就开源了。
ZCode 官方给它的定义是 ADE(Agentic Development Environment,智能体开发环境)。这个命名很关键:它刻意不是一个 VS Code 的分叉,主界面里没有传统意义上的代码编辑器。
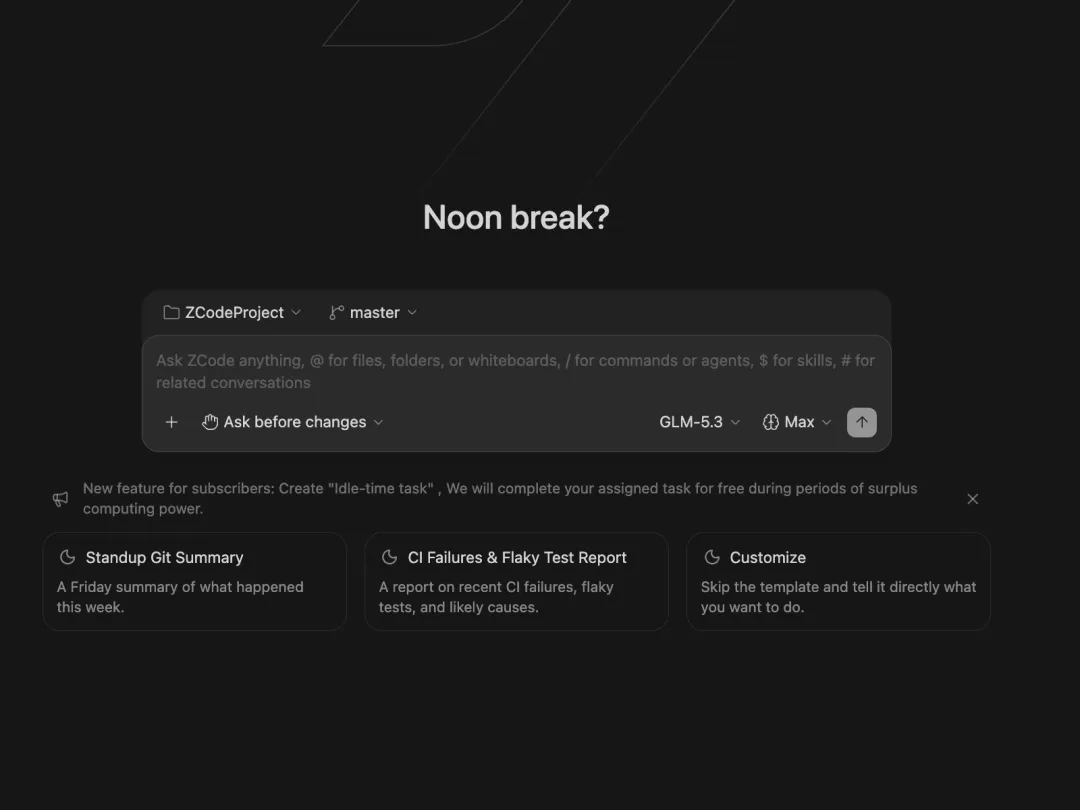
打开之后你看到的是一件事:左侧是项目和任务列表,中间是一个输入框。你用 @ 引用上下文、用 / 调命令,任务会把你的目标、改动的文件、终端输出、浏览器上下文和 Git 状态打包在一起。
它支持 macOS、Windows、Linux(beta)。免费下载,钱花在下面的 GLM 编程套餐上。
核心机制:为什么「没有编辑器」是设计而不是缺陷
理解 ZCode,得先看它的工作流:
任务 → 规划 → 改文件 / 跑命令 / 开浏览器 → 验证结果 → 交给你审官方文档里反复强调一个词:验证(verify)。模型要能自己检查结果对不对。
这背后是 GLM-5.3 的训练方式决定的。据 Flavio Copes 的深度评测,智谱这次没有重跑预训练——GLM-5.3 用的还是 GLM-5.2 的底座,提升全部来自在更长的工程任务上做后训练:
模型收到一个目标、一些工具,以及一个它自己能验证的结果。它写代码、运行代码,然后从「任务是否通过」里学习。有些环境代表好几天的工程工作量——一个任务可能要求模型找到瓶颈、修复它、跑实验、并证明改进。但手工造足够多真实环境太慢了,智谱用研究智能体去收集工作模式、把它们变成可运行的任务,另一个智能体负责检查每个任务确实可解。关键的细节是:验证器看不到参考答案——这逼着模型不能靠「抄出题人想要的样子」过关。
这就解释了为什么 ZCode 敢把编辑器拿掉。它不是「编辑器 + AI 侧边栏」,而是假设代码由 agent 写,人负责审。如果你现在的工作方式是「自己敲、AI 补全」,ZCode 的定位可能反直觉;但如果你已经习惯了「给目标、看 diff」,这个界面反而更干净。
权限模式:一个容易被忽略的设计
ZCode 提供了四种权限模式,官方推荐新用户从第一种开始:
| Ask before changes | |
| Edit automatically | |
| Plan mode | |
| Full access |
Flavio 的建议很实用:先停在「Ask before changes」。你会多点几次确认,但你能看清 agent 想干什么。等到你信任它在某个项目上的判断,再切到「Edit automatically」。大改动一律走 Plan mode——读一份计划只要一分钟,但从一个大 diff 里找出那个错误假设要久得多。
这里有个真实体验的细节:第一次跑真实任务时,agent 在要执行 shell 命令前停了下来,给出三个选项——允许这一次、允许这个项目里的这类命令、拒绝。这种「逐步授权」的粒度,比一次性批准所有操作要安全得多。
真实场景怎么用
安装与连接
从 zcode.z.ai 下载安装包(Apple Silicon 是 .dmg),拖进「应用程序」即可。首次启动会让你连接账户,三个选择:Z.ai(国际服务)、BigModel(中国内地服务)、或自己的 API key。国内用户选 BigModel。
新用户有 5 天试用。之后需要 GLM 编程套餐:
• Lite:18 美元/月 • Pro:80 美元/月,用量 6 倍 • Max:168 美元/月,用量 14 倍
用量按「点数」计,非高峰时段和周末只要一半点数。这个设计对个人开发者挺友好——周末跑自动化的成本直接砍半。
两个真正有区分度的功能
第一是 Goals(目标模式)。 普通任务是对话,而 Goal 会一直朝一个结果推进:ZCode 在规划、执行、验证之间循环,边做边更新计划,而不是拿到第一个答案就停。这正是 GLM-5.3 长任务训练该发挥作用的地方,但官方也给了个清醒的边界——这个目标必须是你自己能验证的。「让测试套件通过」可以,「把 app 做得更好」不行。
第二是手机接管。 ZCode 有 Remote 和 Bot Channel 两种方式:扫码后手机镜像桌面应用,或者把 ZCode 接到微信、飞书、Telegram。你可以在聊天里查看任务、启动新任务、换项目、切模型。代码始终留在你的电脑上,手机只是遥控器。
这个想法的价值在于解决了长任务最烦的失败模式:agent 跑到一半停下来问你一个问题,然后卡住两小时——等你回来看才发现它一直在等你回话。Flavio 说他会「宁愿从手机上回一句,也不想两小时后发现任务卡住了」,这话很实在。
顺手还能接进 Claude Code
ZCode 不用你「二选一」。同一份 GLM 编程套餐,官方文档支持接到 20 多个工具里。配置 Claude Code 最快的办法是官方助手:
npx @z_ai/coding-helper也可以直接改 ~/.claude/settings.json:
{ "env": { "ANTHROPIC_AUTH_TOKEN": "your-coding-plan-api-key", "ANTHROPIC_BASE_URL": "https://api.z.ai/api/anthropic", "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3", "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3", "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash", "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000", "API_TIMEOUT_MS": "3000000" }}这段配置在做四件事,每一件都有它的代价考量:
1. 三个模型变量把 Claude Code 的路由整体指向 GLM——Opus/Sonnet 走 GLM-5.3,Haiku 这种廉价快模型走 GLM-5.3-Flash。 2. CLAUDE_CODE_AUTO_COMPACT_WINDOW设成 100 万,让 Claude Code 在总结上下文之前尽量用满 GLM 的 1M token 窗口。这是把模型的强项(长上下文)真正用起来。3. 超时设到 300 万毫秒(50 分钟),是为了不让高推理强度的请求提前中断——这是长任务场景的必要妥协。 4. 端点是固定的 api.z.ai/api/anthropic。官方特别提醒:base URL 写错会出现1113 Insufficient Balance,哪怕你的订阅是有效的。这类错误最容易被误判成「套餐没生效」。
装完跑 claude,进去 /status 确认 base URL 和模型是否正确。
和同类方案比有什么不同
先说结论:ZCode 现在更像「第二意见」,而不是主工具的替代品。 这个判断来自 Flavio 的实际使用,我觉得比任何跑分都可信。
vs Claude Code:Claude Code 跑在终端里,ecosystem 更成熟,支持自定义 subagent——而 ZCode 目前不支持。这是 Flavio 明确点名的一个缺失:他用专门的 subagent 把大工作拆成并行任务,ZCode 还做不到。不过两者可以共用一个订阅,所以不必二选一。
vs Cursor 类工具:Cursor 是「编辑器 + AI」,ZCode 干脆不要编辑器。它适合「让 agent 写、我来审」的人。
vs agent 管理器:那些工具跨项目管理多个 agent,ZCode 能跑并行任务、Goals 和自动化,但只管它自己这个 agent。
能力层面,GLM-5.3 的公开跑分值得看一眼(Flavio 汇总,他本人也提醒「单一厂商的跑分我不太信」):
Terminal Bench 3.0 从 4.6 跳到 28.3 是很夸张的跃升,说明「在终端里用工具」这件事被专门加强了。GLM-5.3 在 Code Bench 上高强度档得 31.4%,约 5 万输出 token;Claude Opus 4.8 是 29.5%,但要花约 12 万 token。最高强度档 GLM-5.3 到 34.5%,Claude Fable 5 仍以 39.5% 领先——它不是最强的,但用更少的 token 拿到接近的分数,成本低得多。
三个你必须知道的边界
第一,隐私是真实的取舍。 用 GLM 编程套餐时,你的 prompt 和相关代码会发到智谱的服务器。智谱是中国公司,如果你的公司对专有代码或客户数据出境有规定,这一条可能直接否决它。GLM-5.3 的权重是开源的,理论上可以自己部署,但实际操作上需要多 GPU 服务器——Flavio 的原话是「yes, but not on a normal laptop」。对需要完全控制数据、又有基础设施的团队,自托管才成立。
第二,开源≠MIT 了。 GLM-5.2 是 MIT 许可,GLM-5.3 换成了自定义许可。你仍然可以用、改、分发、卖、部署、微调,但多了一个条件:年收入超过 100 亿美元的模型托管公司,需要经过智谱的安全审查。对绝大多数开发者无影响,但「开放权重」不再等于「MIT 授权」——如果你要拿它做产品,先读许可。
第三,它很年轻。 版本迭代很快,粗糙边缘可以预期。Flavio 直接说了:「在检查完那个项目的数据规则之前,我不会拿它做客户项目;在应用这么新的时候,我也不会把一个关键工作流搬过去。」
总结
ZCode 真正有意思的地方,不是「国产替代」这个叙事,而是它把一个判断做成了产品:未来的编程工具,重心从「编辑器」移到「任务指挥台」。它用 GLM-5.3 的长任务后训练去撑 Goals、自动化、手机接管这些形态,再配一个能接到 20 多个工具的订阅,把「用哪个模型」和「用哪个客户端」解耦了。
诚实的建议是:把它当作一个 18 美元/月的第二意见——换一个模型,有时能找到你惯用工具错过的路径。自动化那一类(扫最近的改动找安全问题、查坏链接、周五总结)也值得试,因为 GLM-5.3 在漏洞发现上确实被专门训练过,CyberGym 84.5% 这个数字不是白来的。
但别急着迁移关键工作流。先读许可,先确认数据规则,先在非核心项目上跑一阵子。