ARTICLE · 1072305
该如何让大语言模型看懂PDF
发布时间:2026-09-24 22:07:07 最近访问:2026-09-24 22:06:45
该如何让大语言模型看懂PDF
PDF是我们日常生活中经常用到的东西,但是它到底是什么?要真正看清PDF的本质,就要回到30多年前那个计算机世界极度混乱的年代,系统,字体,软件甚至没有统一。这时候,人们迫切的需要一个跨越所有系统都不会变形的载体,PDF(Portable Document Format,便携式文档格式)就诞生了。为了把它做成一张永远不会变形的数字电子纸,它的绘图指令规范取自于PostScript(一种用于激光印刷的编程语言)。所以PDF的编码很有意思,如下图(默认排除只有图片的扫描版PDF):
72 750 Td % 笔刷移动到坐标 (72, 750)
(Deep Learning) Tj % 绘制这行字
0 0 500 2 re S % 在下方画一条矩形下划线
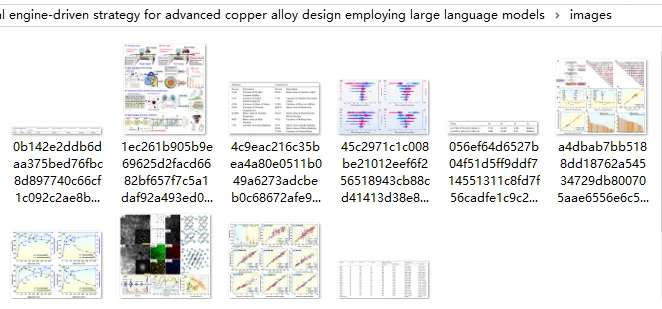
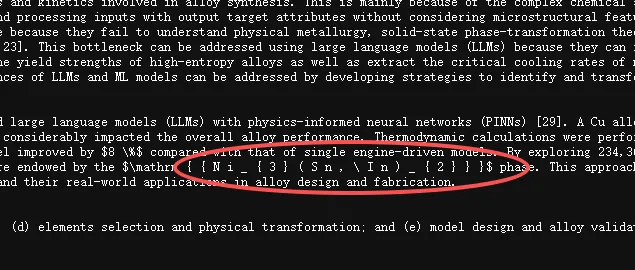
可以看出PDF编码是一个绘图脚本,在你打开PDF的那一瞬间,就在你的电脑显存中渲染了一遍。但是在那个时代没有足够强的大语言模型(Large Language Model,LLM),人们自然也不会考虑未来出现了一个问题:特有的无视分栏从左到右编码,上下文顺序被打断,逻辑被破坏。看个大致可以,但是你想让ai告诉你文章里的某个参数,它大概率会说错或者给你瞎编。这个问题也不是没有解决方法,既然PDF是拿来看的,那我让模型“看”不行行了,聪明的你一定想到了——OCR(Optical Character Recognition,光学字符识别)恭喜你,你已经几乎摸到了最前沿了,因为这个方法除了看不清小字和花钱外,没有什么缺点了。今天是2026.9.24,顶尖模型Opus 5.5用这套方法的正确率是78.01%,这个数据不知道准不准确,但是肯定是在70%-90%之间的。还有办法提高吗,肯定是有的,比如说做一套成熟的工作流(用分段进行+提示词的方法提高正确率),比如说用多agent(多智能体对抗式的询问)。这里着重讲一个性价比最高的做法,MinerU和Marker。这两个在AI领域异常火爆的开源工具(尤其是RAG知识库和数据预训练)。这两个东西是完全本地运行的模型系统,是由多个专门的轻量级/中量级本地视觉模型组合而成的“多模型流水线(Pipeline)”的工作(一个针对文字,一个针对图表):重新排版+单独导出图片+转写公式为LateX语法(一套严谨的纯文本表达方式)。然后再搭配任意一个能看懂文字的AI(甚至不用很前沿的ai),就能够高性价比执行任务。唯一的顾虑是前者是针对中文文献开发的工具,对英文的表现是未知的。接下来简单的看看这个工具的效果吧!(以下红色字体可以略看)我想在当前机器上安装并完整配置开源的学术级 PDF 富文本重构工具 MinerU (magic-pdf)。请作为我的自动化运维专家,一步步帮我完成以下任务并在终端执行:
1. 【环境准备】:
- 检查我当前的操作系统和 Python 版本(推荐 Python 3.10)。如果环境杂乱,请帮我创建一个独立的 Conda 环境或 venv 虚拟环境(命名为 mineru_env)。
- 自动检测我当前机器是否有可用的 NVIDIA GPU(CUDA 支持),如果有请安装对应 CUDA 版本的 PyTorch;如果没有则安装 CPU 版本的 PyTorch。
2. 【安装核心包】:
- 使用 pip 安装完整的 MinerU 包:`pip install -U "magic-pdf[full]"`。
3. 【下载模型权重与生成配置】:
- MinerU 运行时依赖视觉小模型权重(UniMERNet、版面分析等)。
- 如果在国内网络环境下,请优先使用 ModelScope(魔搭社区)的下载脚本或 huggingface 镜像源,帮我将模型权重下载到用户目录下的某个独立文件夹中(例如 `~/mineru_models`)。
- 在用户根目录下生成正确的配置文件 `magic-pdf.json`,并将里面的 `models-dir` 路径准确指向刚才下载的权重路径,默认设备设置为当前检测到的设备(cuda 或 cpu)。
4. 【验证与测试】:
- 帮我编写一个简单的测试脚本或执行一行 CLI 命令(例如找一个简单的 PDF 测试,或者使用其官方自带的验证命令)。
- 验证通过后,请为我写一个批量处理当前文件夹下所有 PDF 的 Python 脚本 `batch_parse.py`,要求将提取好的 Markdown 和带坐标的 content_list.json 统一保存到 `./parsed_output` 目录下。
遇到任何依赖冲突、下载网络超时或缺少系统库(如 libGL 等常见视觉库依赖),请自动分析报错并自行修复。现在请开始。
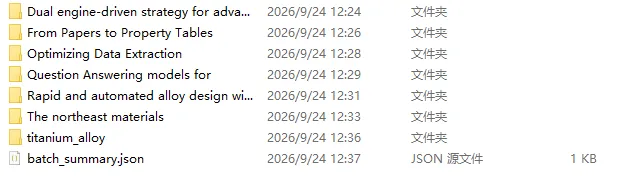
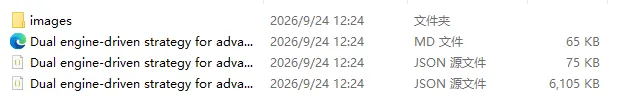
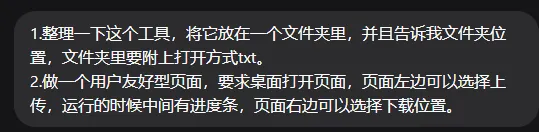
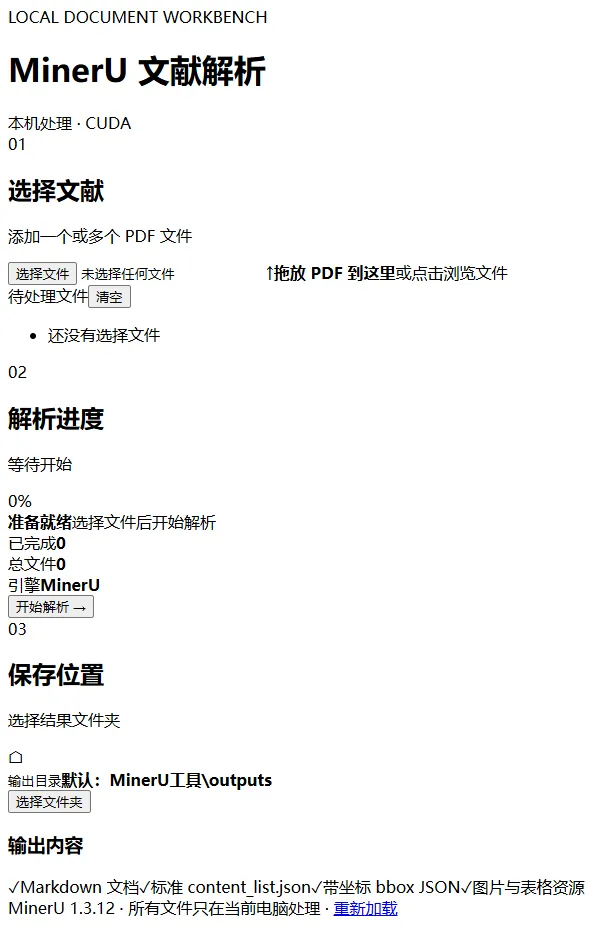
这时候也不用费心找到这个程序的开关,在ai时代,简单的工作完全可以丢给ai做:这里面随便挑一个文件夹,就可以分别看其中的文字部分和图片部分:当然,你让ai帮你弄也是要花钱的,如果认为自己动动手指就可以搞定,也可以像我这样:以上就是我对ai看懂PDF的一些理解和这几天的尝试,谢谢大家。