ARTICLE · 1076293
WorkBuddy、豆包、千问、WPS灵犀:75题办公实测
一张表格,年份和金额都提取对了,却把指定的“year”表头写成了“d”。
另一份发票报告,两张票的金额汇总没有问题,却把一句宣传语认成了供应商名称。
这两个细节来自 EvalDock 的办公 Agent 评测,说明交付质量需要同时检查内容和任务要求:数据正确之后,字段、位置与主体信息是否也符合要求?
2026 年 9 月,我们让千问办公、WPS 灵犀、WorkBuddy、豆包工作执行五套评测各 15 题。四款产品分别执行同一组 75 道任务,共形成 300 项最终交付结果。
这次允许必要的人工辅助、续接和重试,观察的是最终交付质量。它能帮助我们看清文件交到手后的表现,不能当作首次无人干预成功率。
先看结果:综合数值相近,分项表现各有差异
本次采用“本批办公任务综合指数”,把五套评测各按 20% 汇总,作为阅读入口:
• 千问办公:90.47
• WPS 灵犀:90.47
• WorkBuddy:88.26
• 豆包工作:88.34
这是取值范围为 0—100 的探索性指数,不是成功率。PPT 修改与生成分别是一套评测,合计占 40%。数字用未四舍五入的原始值计算,最后保留两位小数。
千问与灵犀都显示 90.47,豆包与 WorkBuddy 也很接近。但如果只看这组综合数值,就会漏掉本批最实用的信息:换一种任务,值得关注的产品表现也会变。
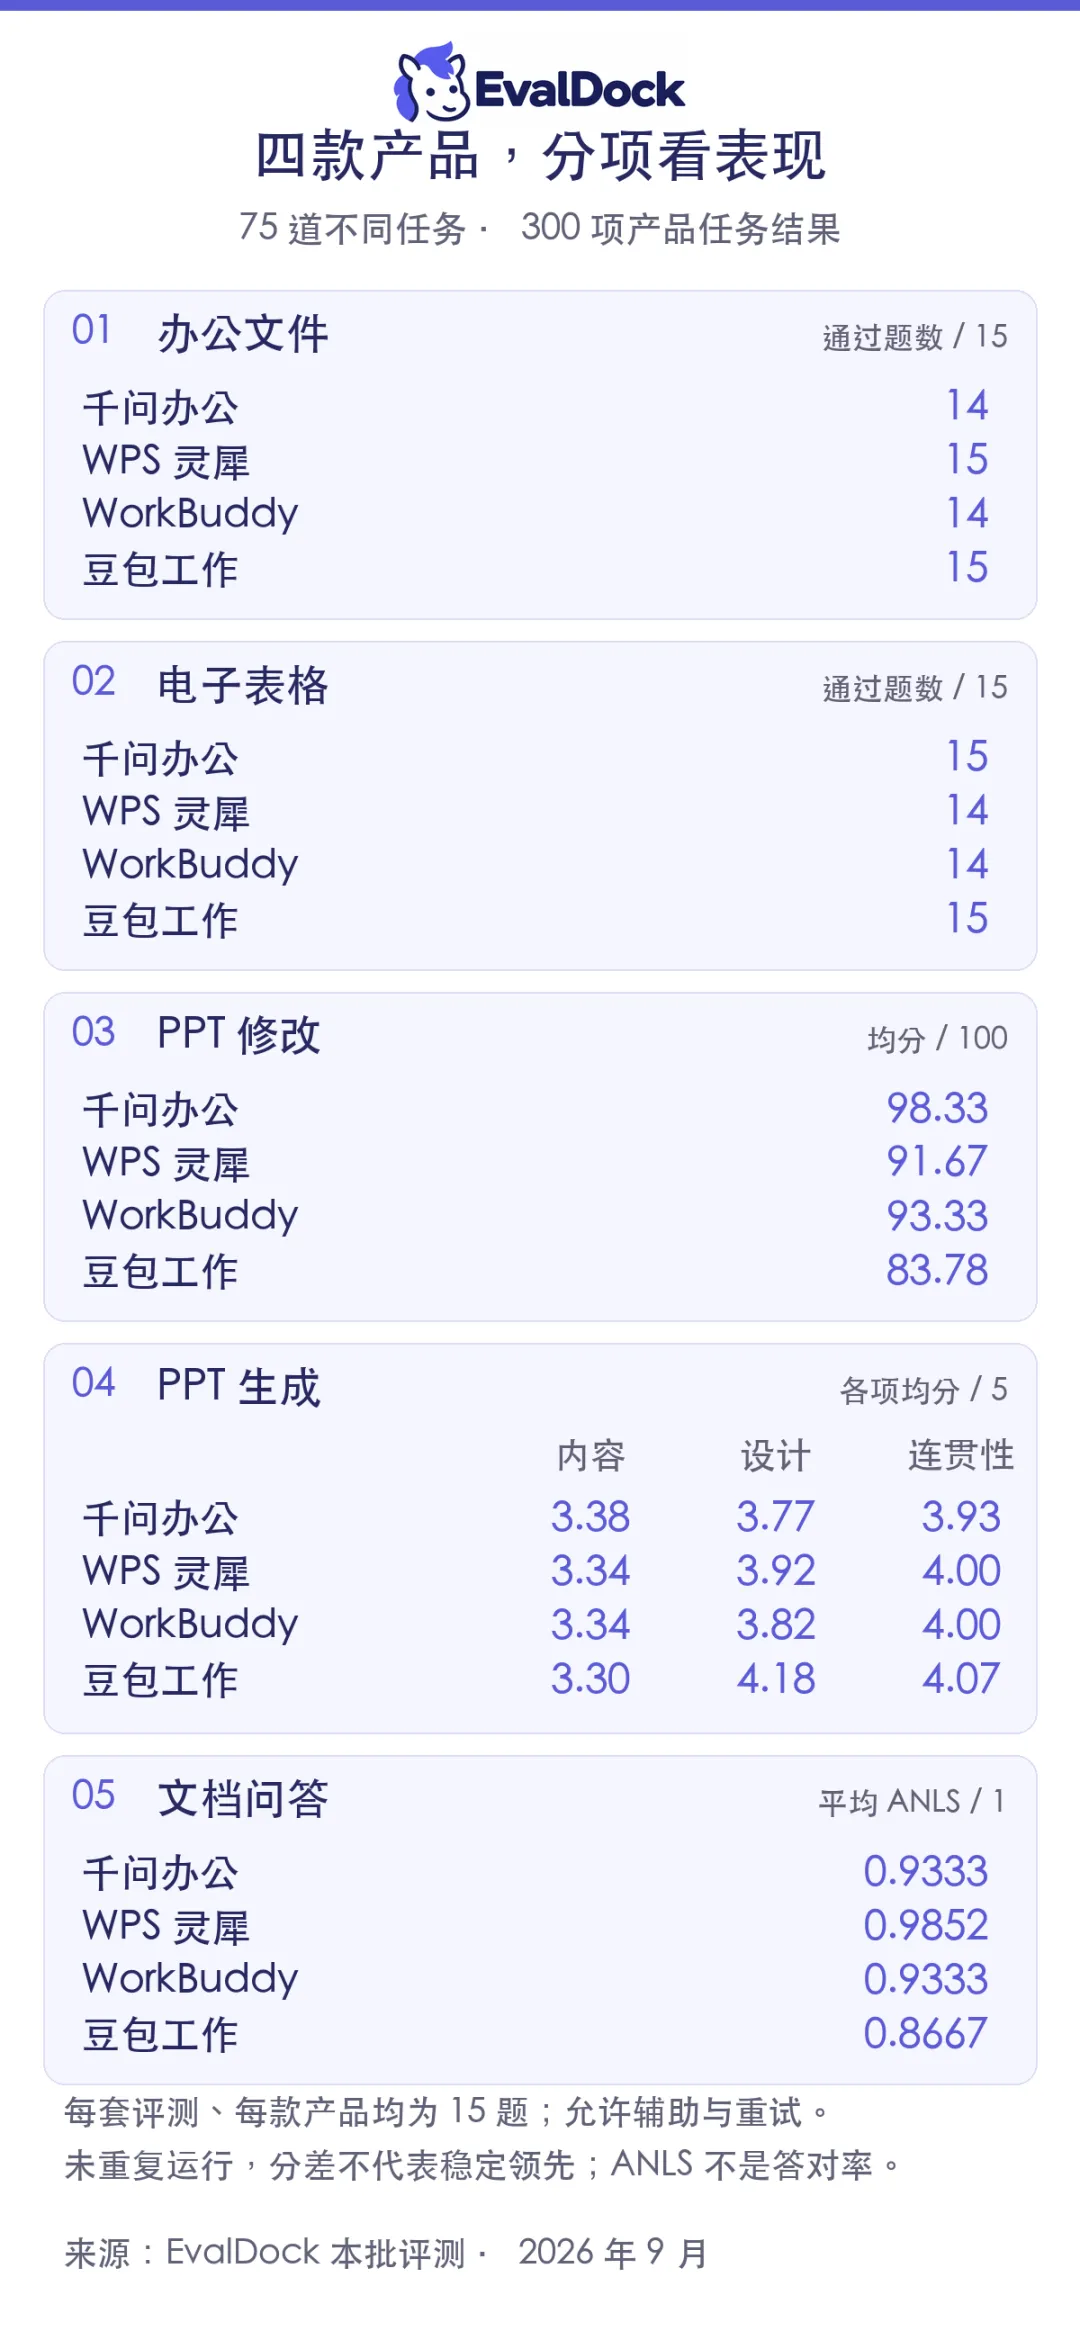
图 1|本批分项成绩。每套评测、每款产品均为 15 题;ANLS 不是答对率。
办公文件中,灵犀和豆包通过全部 15 题;电子表格中,千问和豆包通过全部 15 题。千问的 PPT 修改均分最高,豆包的生成设计与连贯性均分最高,灵犀的文档问答平均 ANLS 最高。以上均限定在本批样本。
这些分数用于比较本批任务中的交付表现,小幅分差不代表稳定领先。对读者更有价值的是,自己的下一项工作属于哪一类任务。
做表格:别只抽看一条公式
开头那份表头不符的文件来自千问的一项收入提取任务。年份与金额正确,“year”却变成了“d”,因此没有通过完整检查。
字段名偏差说明,数据值和交付结构需要分别验收。尤其当文件还要交给后续流程读取时,“人能猜到这列是什么”与“字段满足要求”并非一回事。
另外两项任务分别涉及目标区域完整性和数值尺度。
灵犀在一道滚动求和题中,后八行公式正确,前三个目标位置却仍是“n/a”,而预期值是 4、6、12。若只看已经填好的公式,就会错过没有填完的区域。
WorkBuddy 在按月份天数计算夜班比例时,处理了闰年与月份天数,却把小数比例放大了 100 倍。10/31 应约为 0.322580645,交付值是 32.258064516;十二个月份中,十一个非零结果存在尺度问题。
所以,这批案例带来的表格检查建议很具体:看表头,看完整目标区域,再看数值与单位是否匹配。 单个案例不能概括产品全部表现,但能提醒我们在哪里打开文件、核对什么。
做 PPT:先分清是“改现有文件”,还是“从材料生成”
本批 PPT 修改任务里,千问的均分为 98.33;PPT 生成任务里,豆包的设计与连贯性均分分别为 4.18、4.07。这几项成绩衡量的是不同要求。
修改已有文件时,内容写进去了,还要看写在什么地方、是否按要求清理原文。千问曾把“Instant messaging”放入表格的另一列;灵犀曾生成两条带缩进的项目符号,但保留了指定句子之外的原文。
从材料生成新演示文稿时,内容组织、版面和叙事又是另一组问题。本批 PPTAgent / PPTEval 分别从内容、设计和连贯性三个维度评分。
实际使用生成的 PPT 时,还要对照源材料核对关键数字、引述与结论。内容、设计和连贯性评分不等同于逐项事实核验。
如果你准备试用办公 Agent,可以直接用自己的任务区分这两种需求:要它精准修改既有文件,就检查位置和修改范围;要它生成新稿,就同时检查表达质量与源材料支持。
读票据和文档:总额正确之后,还要看“谁”和“哪里”
开头的发票报告来自 WorkBuddy。它把两张发票的金额汇总正确,却把“Earthenware for everyone”这句宣传语识别为供应商名称,漏掉了票面收款方“Pottery & Co.”。
这份交付提示我们,金额和主体信息应分开检查。看总额无法回答公司名称和交易角色是否被正确提取。
文档问答也要分清失分原因。DocVQA 用 ANLS 衡量答案文本相似度,ANLS 不是答对率。本批有回答把 12 写成“Page 12”,或把 800 写成带原图单位的“800 ng/g”;这类文本格式差异可能影响匹配分数。另有回答把要求的列标题理解成总标题或左侧项目名称,则涉及找错目标位置。
上述案例解释结合源图进行 AI 辅助复核,成绩仍按原 ANLS 口径展示。分清差异来自格式还是信息位置,更容易判断它对实际任务的影响。
把试用安排在你真正要交付的那份文件上
看完这批结果,最实用的行动不是记住一个综合名次,而是选出自己最常做的任务,拿真实材料验证。
交付表格,先检查字段、目标区域和数值尺度;修改 PPT,检查位置与残留原文;生成 PPT,对照源材料核对关键事实;整理票据,分别看金额、主体与交易角色。
这批评测提供了分项结果和具体案例。判断产品是否适合自己的工作,还需要用真实材料试用,明确交付要求,并对照要求检查结果。
办公 Agent 的价值,最终要在这些具体工作里体现。
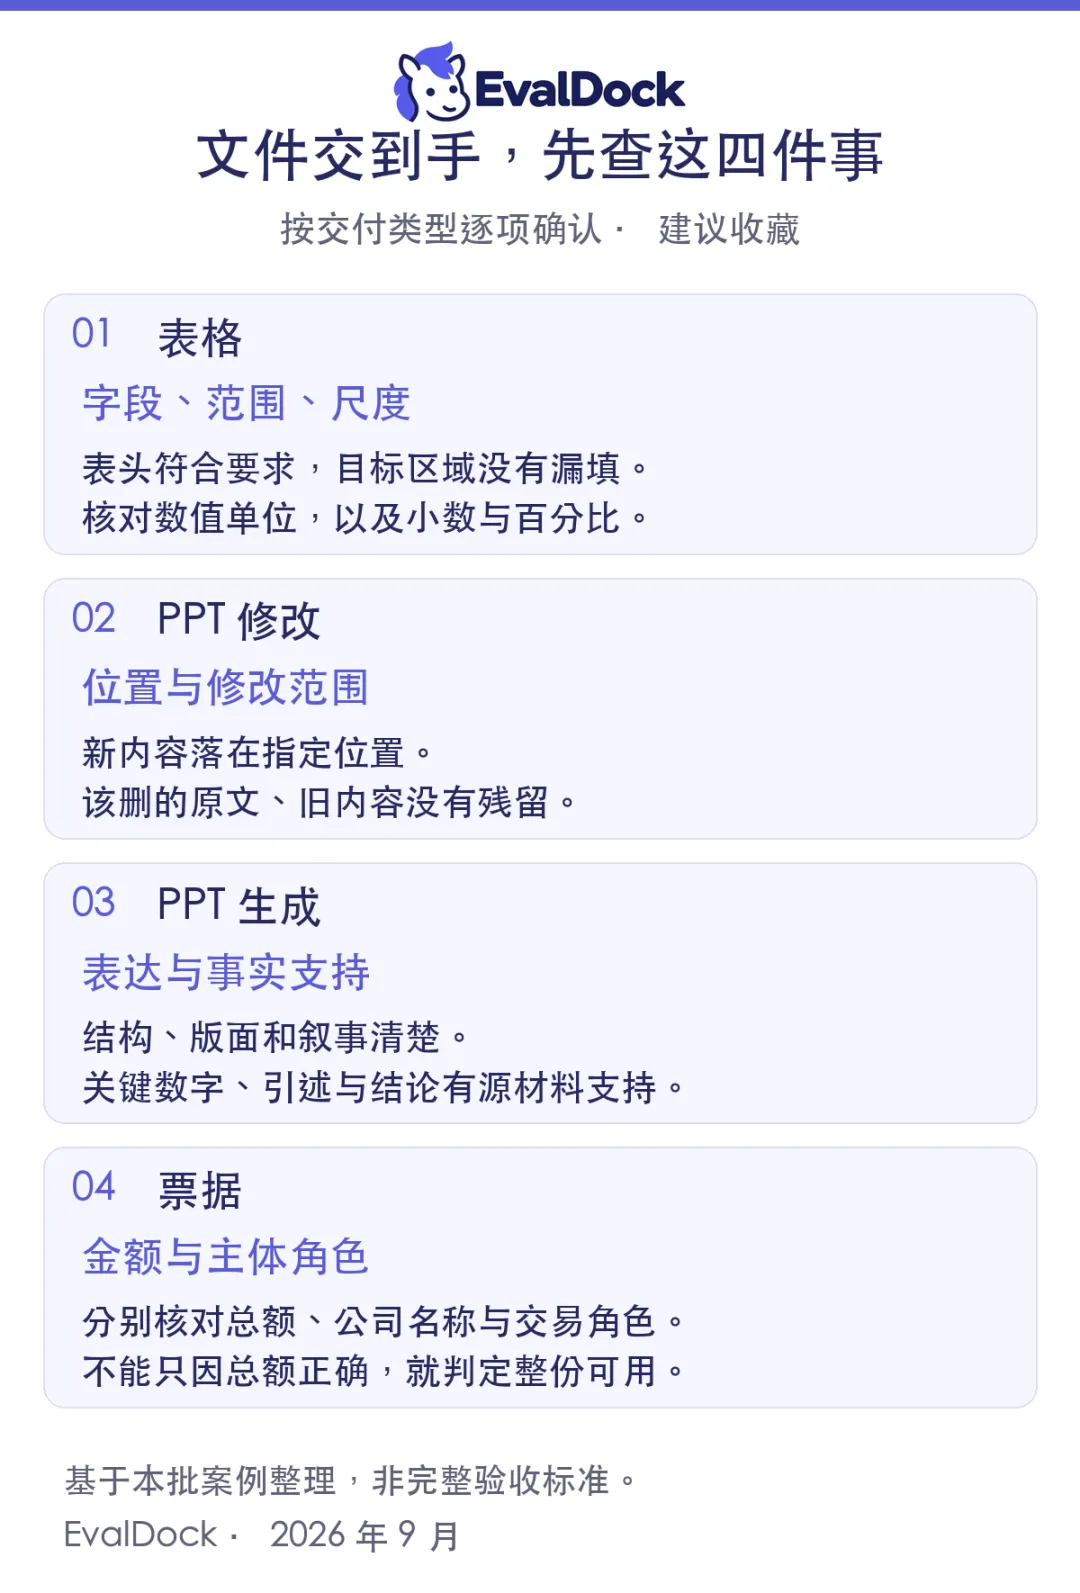
图 2|基于本批案例整理的交付检查清单,不是完整验收标准。
本次评测怎样做
本批由 EvalDock 于 2026 年 9 月通过四款产品的网页端执行。五套评测各 15 题,共 75 道不同任务、300 项产品任务结果;允许人工辅助、续接和重试,衡量最终交付质量。样本按类别、难度等信息选取,属于非简单随机的小样本、单批评测,未开展重复运行;结果用于本批任务对比,不用于推断统计显著性或长期稳定性。
五套评测为 OfficeBench 文件交付改编、SpreadsheetBench Verified 子集、Microsoft PPT-Eval 子集、PPTAgent / PPTEval、DocVQA。办公文件采用适配检查,电子表格采用目标区域比较;两套 PPT 使用本次统一的自动检查与 AI 裁判配置,裁判与原评测配置不同。PPTAgent 内容和设计按页面评分汇总,连贯性按演示文稿汇总。DocVQA 使用每款 15 题的平均 ANLS。本次采用子集与适配评分口径,成绩不与原官方榜单直接比较。
综合指数由五套评测各占 20%:办公文件与电子表格分别按通过题数 ÷ 15 × 100;Microsoft PPT-Eval 保留 0—100 分;PPTAgent 三个 1—5 分项先等权平均,再按(均分 − 1)÷ 4 × 100 转换;DocVQA 按平均 ANLS × 100。使用未四舍五入原始数值计算,最终展示两位小数。PPT 修改与生成合计占 40%。该指数是本批任务的探索性汇总,不是成功率;文中案例用于解释成绩,不另行扣分。
本批记录的配置标签为:WPS 灵犀 DeepSeek V4.1 Flash,WorkBuddy hy4-preview。结果结合文件检查、自动评分与针对性内容复核;本文聚焦交付质量,个例仅用于说明对应任务,不外推至产品全部场景。
数据月份:2026 年 9 月。本文所述成绩与案例均限于本批样本、配置和评分口径。