ARTICLE · 1083097
谷歌TPU跑Kimi快57%:赢在软件不在芯片
一组反直觉的数据:TPU 的内存带宽其实比 GPU 更低,跑大模型反而快了 57%。
这次的关键答案是:vLLM 原班人马创办的推理公司 Inferact 与 Google Cloud 联合工程,用 16 块 TPU v7 跑 Kimi K3 达到每秒 709 token——同样 16 块英伟达 GB200 只有 452。赢的不是硬件,是软件:手写 megakernel 加 DeepSeek 开源的推测解码框架。
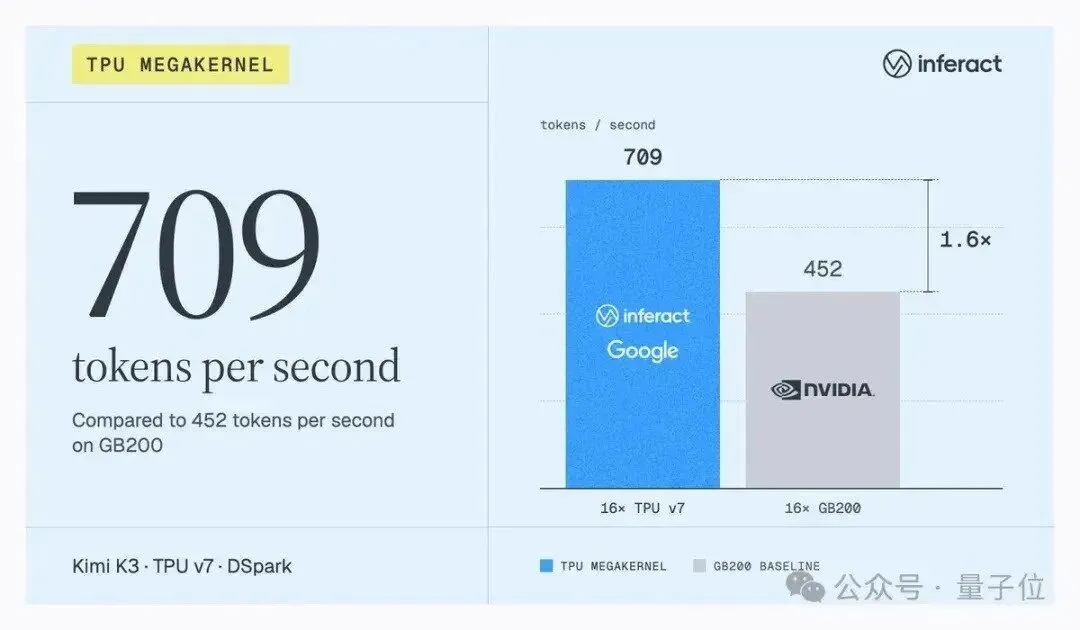
Inferact 官方基准图——16×TPU v7 对 16×GB200(图源:量子位,Inferact 数据)
先把数字摆出来
据量子位 9 月 26 日报道,这组对比的全部条件是公开的:同样 16 块芯片,TPU v7(Ironwood)跑 Kimi K3 每秒 709 token,GB200 每秒 452 token,快 57%。
更有意思的是硬件账本:TPU v7 的 HBM 内存带宽是每秒 7380 GB,GB200 反而高达 8000 GB——带宽更低的一方赢了 57%。这说明差距不在芯片,在软件怎么用芯片。
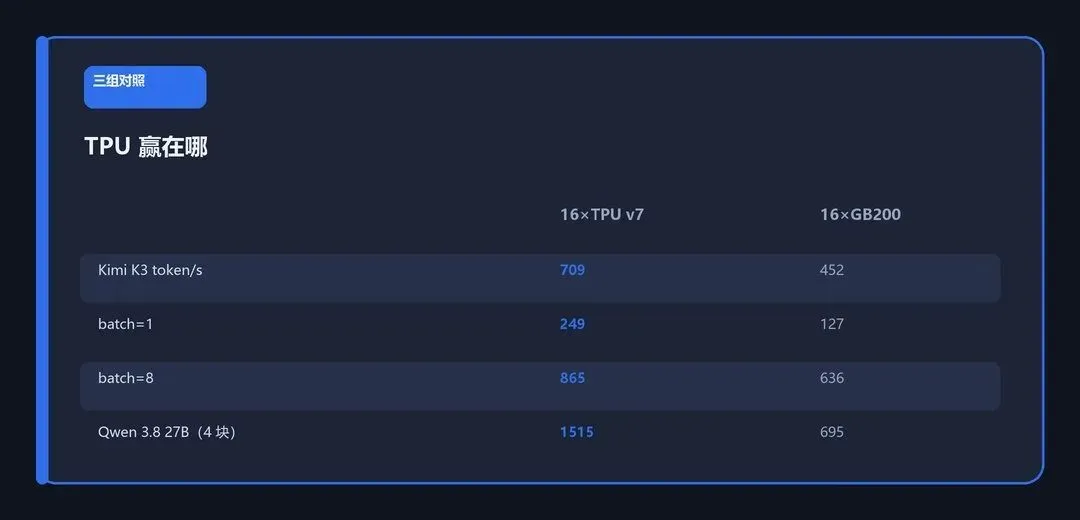
三组对照数据(本文自制图表,数据来源:量子位报道)
谁干的:vLLM 原班人马
Inferact 是一家推理创业公司,班底几乎就是 vLLM 的创始团队:CEO Simon Mo 是 vLLM 原始维护者,联合创始人 Woosuk Kwon 是 vLLM 发起人、PagedAttention 的提出者,首席科学家游凯超来自清华,主导分布式推理。公司刚拿了 1.5 亿美元种子轮,a16z 和 Lightspeed 领投,估值 8 亿美元。
这次项目是 Inferact 与 Google Cloud 的联合工程合作,代码已经开源在 GitHub 的 tpu-megakernels 仓库。
tpu-megakernels 已开源(图源:量子位,GitHub 页面)
三层软件栈,一层都不能少
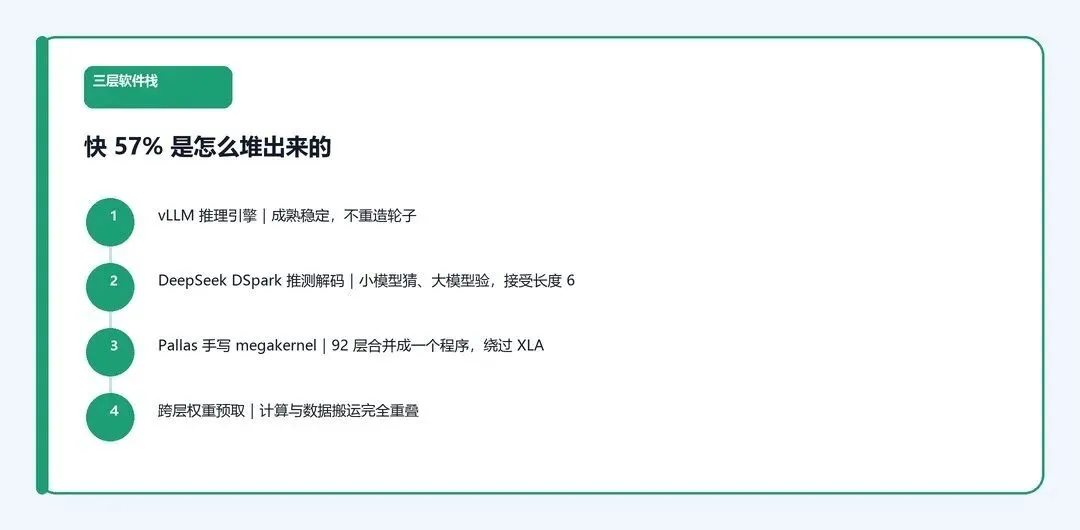
三层技术栈(本文自制图表,数据来源:量子位报道)
第一层,推理引擎用 vLLM——成熟稳定,不用重造。
第二层,推测解码用 DeepSeek 开源的 DSpark 框架:小模型先猜一串候选 token,大模型批量验证。实测 acceptance length 达到 6,单步解码只要约 8.5 毫秒。
第三层,也是最狠的一层:用 Pallas 语言手写的 megakernel。 Kimi K3 是 92 层的 MoE 模型,常规跑法是几百个小 kernel 排队执行,切换间隙全是浪费。Inferact 把整个 92 层合并进一个 Pallas 程序,绕过 XLA 编译,配合 TPU 每核 64 MiB 的软件管理片上内存做跨层权重预取——计算和数据搬运完全重叠,带宽利用率逼近硬件峰值。编译时间从 XLA 的 30 分钟以上降到 90 秒以内。
数字还能再证一遍
关闭推测解码、batch size=1 时:TPU 每秒 249 token,GB200 是 127。batch size=8 时:865 对 636。换个模型测 Qwen 3.8 27B,4 块 TPU 每秒 1515 token,同配置 GB200 只有 695。
精度无损:GPQA-Diamond 94.4%、GSM8K 97.2%,与 GPU 完全一致——快,没有以损失准确率换。
为什么这件事值得记住
第一,推理的价值正在从硬件挪到软件。 芯片带宽 GB200 更高却输掉比赛,说明推理框架的优化空间比想象中大;对算力预算紧张的公司,软件优化就是白捡的算力。
第二,TPU 生态第一次在推理上立住了标杆。 过去大模型推理默认绑定英伟达,这组公开可复现的数据给了行业第二个选项,Google Cloud 是最直接的受益方。
第三,开源社区的好消息。 代码已开源,团队明确说会扩展到更多模型架构并回馈社区——今天只针对 Kimi K3 定制,明天可能就是你的模型。
三条判断一句话版(本文自制图表)
我的看法:这组数据最动人的地方是「诚实」——条件全部公开、代码全部开源、精度全部对齐,谁都可以复现。推理优化的深水区刚刚被炸开一个口子,接下来看英伟达阵营怎么接。
三个常见问题
Q:这是谷歌官方做的吗? A:不是。执行方是推理创业公司 Inferact,与 Google Cloud 联合工程合作;据量子位报道,代码已开源。
Q:换别的模型也能这么快吗? A:当前 megakernel 针对 Kimi K3 定制,换模型架构需要重新适配,团队计划扩展并回馈开源。
Q:精度有损失吗? A:实测 GPQA-Diamond 94.4%、GSM8K 97.2%,与 GPU 一致。
建议先收藏这篇,等你做算力选型时,把这三组对照数字翻出来再看一遍。 数据以量子位报道与开源仓库为准。
你的工作流会更愿意押 TPU 阵营还是 GPU 阵营?你遇到过哪些「调软件比换硬件更管用」的例子?欢迎在评论区聊聊你的看法。如果这篇帮你省了一次纠结,转给正在纠结算力选型的技术合伙人。