ARTICLE · 1101239
Linux 6.12 源码深度剖析: folio_alloc
Linux 6.12 内存管理深度剖析:folio_alloc 机制与跨模块协同演进
1. 📌 技术点速览
folio_alloc 是 Linux 内核在引入 Folio 机制后,用于分配物理内存页的核心 API。它处于内存管理子系统(Memory Management Subsystem, MM)的核心位置,是传统 alloc_pages 的现代化替代方案。
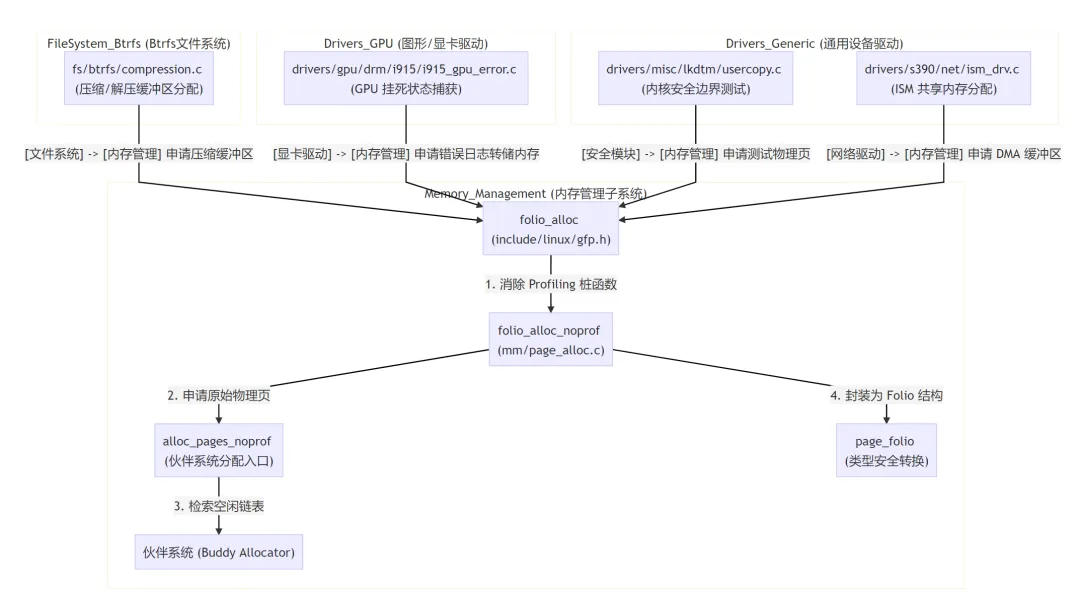
+-------------------------------------------------------------------+| 应用层 / 内核各功能模块 || [Btrfs 文件系统] [i915 显卡驱动] [网络驱动] [安全测试模块] |+-----------------------------------+-------------------------------+|v (调用)+-------------------------------------------------------------------+| 内存管理子系统 (MM) - 接口层 || folio_alloc (gfp.h) |+-----------------------------------+-------------------------------+|v (路由)+-------------------------------------------------------------------+| 内存管理子系统 (MM) - 核心层 || folio_alloc_noprof -> 伙伴系统 (Buddy Allocator) |+-------------------------------------------------------------------+
解决的核心问题
消除类型模糊性(Type Safety):传统的
struct page既可以表示一个 4KB 的单页,也可以表示复合页(Compound Page)中的主页(Head Page)或尾页(Tail Page)。这导致内核开发者极易在处理多页内存时因混淆主尾页而引发 Bug。struct folio保证其指针必然指向一个内存分配的头部,从编译期和类型系统上杜绝了尾页误操作。降低运行时开销:在旧机制中,对
struct page的操作频繁需要调用compound_head()来获取主页,这涉及大量的内存屏障和指针转换。folio机制在数据结构层面保证了操作的直接性,显著减少了 CPU 的指令周期。支持大页(Large Folios)的无缝集成:为文件系统(如 Btrfs、XFS)和设备驱动提供统一的、支持多页(High-order)连续物理内存分配的现代化接口,为透明大页(THP)在页缓存(Page Cache)中的普及奠定了基础。
2. 🗺️ 软件功能架构图
以下架构图展示了 folio_alloc 在 Linux 6.12 中的调用拓扑关系,以及它如何将文件系统模块、设备驱动模块与内存管理子系统紧密连接在一起。
3. 🔍 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 中,为了支持内存分配分析(Memory Allocation Profiling),内核引入了 _noprof(No Profiling)系列函数。folio_alloc 本质上是一个内联包装器,它通过宏魔法将调用位置(文件名、行号)传递给底层的分配器,以便进行精确的内存泄漏和使用量统计。
3.1 接口定义层:include/linux/gfp.h
// include/linux/gfp.h/*** folio_alloc - 分配一个指定阶数(order)的 folio* @gfp: 分配掩码(GFP Flags),决定分配行为(如是否可睡眠、是否使用紧急保留内存等)* @order: 分配阶数,实际分配的物理页数为 2^order** 本函数是 folio_alloc_noprof 的内联封装。在启用 CONFIG_MEM_ALLOC_PROFILING 时,* 实际会通过 alloc_hooks() 宏注入调用栈信息,此处展示其核心逻辑。*/static inline struct folio *folio_alloc(gfp_t gfp, unsigned int order){/** 核心职责:直接调用无分析版本的 folio_alloc_noprof。* 在编译期,如果开启了内存分析,alloc_hooks() 会将其包装,* 从而记录当前分配是由哪个模块(如 Btrfs 或 i915)发起的。*/return folio_alloc_noprof(gfp, order);}
3.2 核心实现层:mm/page_alloc.c
我们深入到内存管理子系统的核心实现文件 mm/page_alloc.c,查看 folio_alloc_noprof 的具体实现:
// mm/page_alloc.c/*** folio_alloc_noprof - 物理内存分配的核心实现(不带 Profiling 统计)* @gfp: GFP 分配掩码* @order: 分配阶数(2^order 个 page)** 核心职责:向伙伴系统申请连续的物理页,并将其安全地转换为 struct folio 结构返回。*/struct folio *folio_alloc_noprof(gfp_t gfp, unsigned int order){struct page *page;/** 1. 跨模块调用伙伴系统核心入口:alloc_pages_noprof* 这是内存管理子系统的最底层分配行为。* gfp 参数在此处决定了分配的生死:* - 如果包含 GFP_ATOMIC,则不能睡眠,直接在中断上下文或持有自旋锁时分配。* - 如果包含 GFP_KERNEL,则允许当前进程睡眠,等待直接内存回收(Direct Reclaim)。*/page = alloc_pages_noprof(gfp, order);/* 2. 健壮性检查:如果伙伴系统无法满足分配需求(内存耗尽 OOM),返回 NULL */if (!page)return NULL;/** 3. 类型安全转换:将 struct page 指针转换为 struct folio 指针。* page_folio() 内部会进行严谨的断言检查,确保该 page 确实是一个* Folio 的 Head Page,从而向调用者(如 Btrfs/i915)交付一个绝对安全的 Folio 句柄。*/return page_folio(page);}EXPORT_SYMBOL(folio_alloc_noprof); // 导出符号,允许驱动模块(如 i915)动态链接调用
3.3 关键辅助函数:page_folio 的安全转换
为了理解 folio 的安全性,必须剖析 page_folio 的实现(位于 include/linux/mm.h):
// include/linux/mm.hstatic inline struct folio *page_folio(struct page *page){/** 核心职责:通过指针运算和标志位判断,找出当前 page 所属的 folio。* 对于非复合页(Order-0),page 本身就是 folio;* 对于复合页(Order > 0),必须通过 compound_head(page) 找到主页,* 然后强制类型转换为 struct folio。** 这一步体现了 MM 模块的“类型屏障”职责:* 屏蔽底层复杂的复合页主尾页关系,向外部模块提供统一的 Folio 视图。*/return (struct folio *)compound_head(page);}
4. ⚙️ 系统运行背景与上下文
folio_alloc 绝非孤立存在,它是 Linux 内核中跨模块协同的典型枢纽。以下详细拆解它在不同软件模块之间的运行时上下文和协作机制。调用方向,从上到下:GPU-》MM-》Btrfs。
+-----------------------------------------------------------------------------------+| 跨模块协同上下文 |+-----------------------------------------------------------------------------------+| [FileSystem_Btrfs] || - 触发场景: 写入数据时,压缩引擎需要临时缓冲区。 || - 协同行为: 调用 folio_alloc(GFP_NOFS, 2) 申请 16KB 连续物理页。 || - 约束条件: 传入 GFP_NOFS,防止 MM 子系统在回收内存时递归调用文件系统本身,避免死锁。 |+-----------------------------------------------------------------------------------+|v+-----------------------------------------------------------------------------------+| [Memory_Management (MM)] || - 触发场景: 伙伴系统(Buddy Allocator)空闲链表不足。 || - 协同行为: 唤醒 kswapd 异步回收,或触发直接内存规整(Direct Compaction)。 || - 架构交互: 在 arm64/x86_64 上,修改页表,确保 TLB 一致性,必要时执行 Cache 刷新。 |+-----------------------------------------------------------------------------------+|v+-----------------------------------------------------------------------------------+| [Drivers_GPU (i915)] || - 触发场景: GPU 发生 Hang,触发 Error State 捕获。 || - 协同行为: 调用 folio_alloc(GFP_ATOMIC, 0) 快速申请内存转储寄存器状态。 || - 约束条件: 必须在原子上下文(不能睡眠)中完成,若内存不足则直接放弃,保证系统不崩溃。 |+-----------------------------------------------------------------------------------+
4.1 FileSystem_Btrfs 模块与 MM 模块的协同
在 fs/btrfs/compression.c 中,当 Btrfs 文件系统需要对数据进行 LZO/ZSTD 压缩并写入磁盘时,它需要分配临时的物理页作为压缩缓冲区。
调用上下文:文件系统写路径(Writeback Path)。
GFP 掩码策略:Btrfs 会使用
GFP_NOFS。这是因为如果内存不足,MM 模块会尝试进行内存回收。如果 MM 模块在回收时又调用了 Btrfs 的释放内存函数,就会导致循环等待死锁。GFP_NOFS明确指示 MM 模块:“你可以回收内存,但绝对不能调用任何文件系统接口”。Folio 的优势:Btrfs 可以一次性申请一个
order = 2(16KB)的 folio,避免了多次申请单个 page 的碎片化问题,提高了 DMA 传输到磁盘的效率。
4.2 Drivers_GPU (i915) 模块与 MM 模块的协同
在 drivers/gpu/drm/i915/i915_gpu_error.c 中,当 GPU 发生硬件故障(Hang)时,驱动需要立即捕获当前的 GPU 寄存器状态和显存快照。
调用上下文:中断处理程序或底半部(Softirq/Tasklet),属于原子上下文(Atomic Context)。
GFP 掩码策略:必须使用
GFP_ATOMIC。这意味着分配过程绝对不能进入睡眠,不能等待垃圾回收。MM 模块会从紧急保留内存池(Emergency Pools)中直接划拨物理页。协同机制:i915 驱动通过
folio_alloc快速获取物理页,然后通过 CPU 映射(vmap)将 GPU 状态写入这些页,最后生成/sys/class/drm/card0/error供用户态诊断。
4.3 硬件架构(arm64 / x86_64)与 MM 模块的底层协同
当 folio_alloc 成功从伙伴系统拿到物理页后,涉及到 CPU 架构层面的操作:
TLB 缓存一致性:如果是大页(High-order Folio),在将其映射到内核虚拟地址空间(Direct Mapping)时,x86_64 或 arm64 架构会尽可能使用大页表项(如 2MB PDE),从而减少 TLB 缺失(TLB Miss)。
Cache 属性设置:对于 GPU 驱动(i915),分配的 folio 需要通过架构特定的 API(如 x86 的
set_pages_array_wc或 arm64 的set_memory_wc)将内存属性设置为 Write-Combining (WC),以优化 CPU 到 GPU 显存的写入性能。
5. 💡 10年老兵避坑指南/实战案例
在生产环境中,围绕 folio_alloc 及其前身 alloc_pages 的使用,存在诸多由于跨模块协同不当导致的灾难性 Bug。以下结合实际案例进行深度剖析。
5.1 经典案例一:高阶分配(High-order Allocation)引发的系统卡顿与 OOM
背景:某自研文件系统模块在处理大文件写入时,为了追求极致性能,频繁调用
folio_alloc(GFP_KERNEL, 4)(申请 16 物理页,即 64KB 连续内存)。现象:系统运行 3 天后,出现严重的 I/O 延迟抖动,CPU 监控显示
kcompactd(内存规整守护进程)CPU 使用率飙升至 100%,系统频繁卡死,甚至触发 OOM Killer。病因剖析: 物理内存运行一段时间后必然会碎片化(Fragmentation)。此时,虽然系统剩余总内存很大,但几乎找不到连续的 64KB(Order-4)物理内存。 当文件系统调用
folio_alloc(GFP_KERNEL, 4)时,由于指定了GFP_KERNEL,MM 子系统会启动直接内存规整(Direct Compaction)和直接内存回收(Direct Reclaim)。这会阻塞当前文件系统的写入线程,导致 I/O 延迟从微秒级暴涨至秒级。
[ 正常状态 ]+---+---+---+---+---+---+---+---+ (连续的物理页)| P | P | P | P | P | P | P | P | --> 轻松分配 Order-3 (32KB)+---+---+---+---+---+---+---+---+[ 严重碎片化状态 ]+---+---+---+---+---+---+---+---+| P | X | P | X | P | X | P | X | --> 剩余 50% 内存,但无法分配任何 Order > 0 的内存!+---+---+---+---+---+---+---+---+^ 占用
老兵解决方案:
降级机制(Fallback):绝不能孤注一掷申请高阶内存。必须实现降级逻辑,如果高阶 Folio 分配失败,自动降级为单页(Order-0)分配。
使用
__GFP_NOWARN和__GFP_NORETRY:避免高阶分配失败时向系统控制台狂喷堆栈信息,且限制 MM 模块进行无休止的规整。
/* 生产级安全分配范例 */struct folio *safe_alloc_compressed_buffer(unsigned int order){struct folio *folio;gfp_t gfp_mask = GFP_KERNEL | __GFP_NOWARN | __GFP_NORETRY;// 1. 尝试分配高阶 Foliofolio = folio_alloc(gfp_mask, order);if (folio)return folio;// 2. 降级策略:如果高阶分配失败,降级为 Order-0 分配if (order > 0) {pr_warn_ratelimited("Btrfs-safe: High-order memory allocation failed (order %d), falling back to order-0\n", order);folio = folio_alloc(GFP_KERNEL, 0);}return folio;}
5.2 经典案例二:原子上下文下的“Scheduling while atomic”崩溃
背景:某网络设备驱动在收到数据包的中断处理程序(Interrupt Handler)中,调用
folio_alloc申请 DMA 缓冲区。现象:系统偶发性崩溃,内核日志抛出
BUG: scheduling while atomic: swapper/0/0/0x00010002。病因剖析: 开发者在中断上下文中调用了
folio_alloc(GFP_KERNEL, 0)。GFP_KERNEL允许分配器在内存不足时进入睡眠等待(Sleep/Block)。然而,中断上下文绝对不允许睡眠,因为中断没有独立的进程上下文,一旦睡眠,调度器(Scheduler)将无法唤醒它,导致整个 CPU 核心死锁。内核检测到在原子上下文中发生调度,直接触发 Kernel Panic。排查与调优方法:
使用
ftrace追踪分配路径: 通过启用tracepoint:kmem:mm_page_alloc,可以实时监控是哪个进程、在什么上下文中触发了不合规的分配。echo 1 > /sys/kernel/debug/tracing/events/kmem/mm_page_alloc/enable cat /sys/kernel/debug/tracing/trace_pipe | grep "gfp_flags=GFP_KERNEL"正确配置 GFP 掩码: 在中断、自旋锁(Spinlock)保护区、RCU 临界区等原子上下文中,必须无条件使用
GFP_ATOMIC。
/* 驱动中断处理程序中的正确写法 */irqreturn_tmy_driver_interrupt(int irq, void *dev_id){struct folio *folio;/** 必须使用 GFP_ATOMIC!* 即使内存极度紧张,MM 也会从紧急保留区(min_free_kbytes 设定的保留线之下)* 快速划拨内存,绝不睡眠。*/folio = folio_alloc(GFP_ATOMIC, 0);if (unlikely(!folio)) {// 统计丢包,优雅退出,绝不崩溃my_driver_stats.rx_dropped++;return IRQ_HANDLED;}// 处理接收数据...return IRQ_HANDLED;}
5.3 内存碎片化调优参数
如果你的系统频繁因为 folio_alloc 无法分配高阶内存而导致性能下降,可以通过调整以下内核参数进行优化:
# 提高系统保留的最小空闲内存,迫使 kswapd 更早开始异步回收,减少直接内存规整的概率sysctl -w vm.min_free_kbytes=131072 # 设置为 128MB# 降低内存规整的触发门槛,使系统更积极地在后台整理出连续的物理页sysctl -w vm.extfrag_threshold=500