ARTICLE · 1112112
Nature重磅实验:让AI吃自己的排泄物,9代之后彻底疯了!牛津剑桥敲响行业警钟
作者 | 王凯
编辑 | 陈明
如果你向一个人工智能提问:“请描述中世纪英国教区教堂塔楼的建筑风格。”
正常的AI会告诉你:那是哥特式的尖顶,那是垂直风格的石匠杰作。
但如果让这个AI只读上一代AI写的文本,一代一代递归训练下去,到了第9代,会发生什么?
在牛津与剑桥大学科学家的实验室里,屏幕上赫然吐出了一段令人毛骨悚然的胡话:
“这里拥有世界上最大的黑尾野兔、白尾野兔、蓝尾野兔、红尾野兔和黄尾野兔种群……”
中世纪的教堂尖顶彻底消失了取而代之的,是一群在数字废墟里狂奔的五彩野兔。
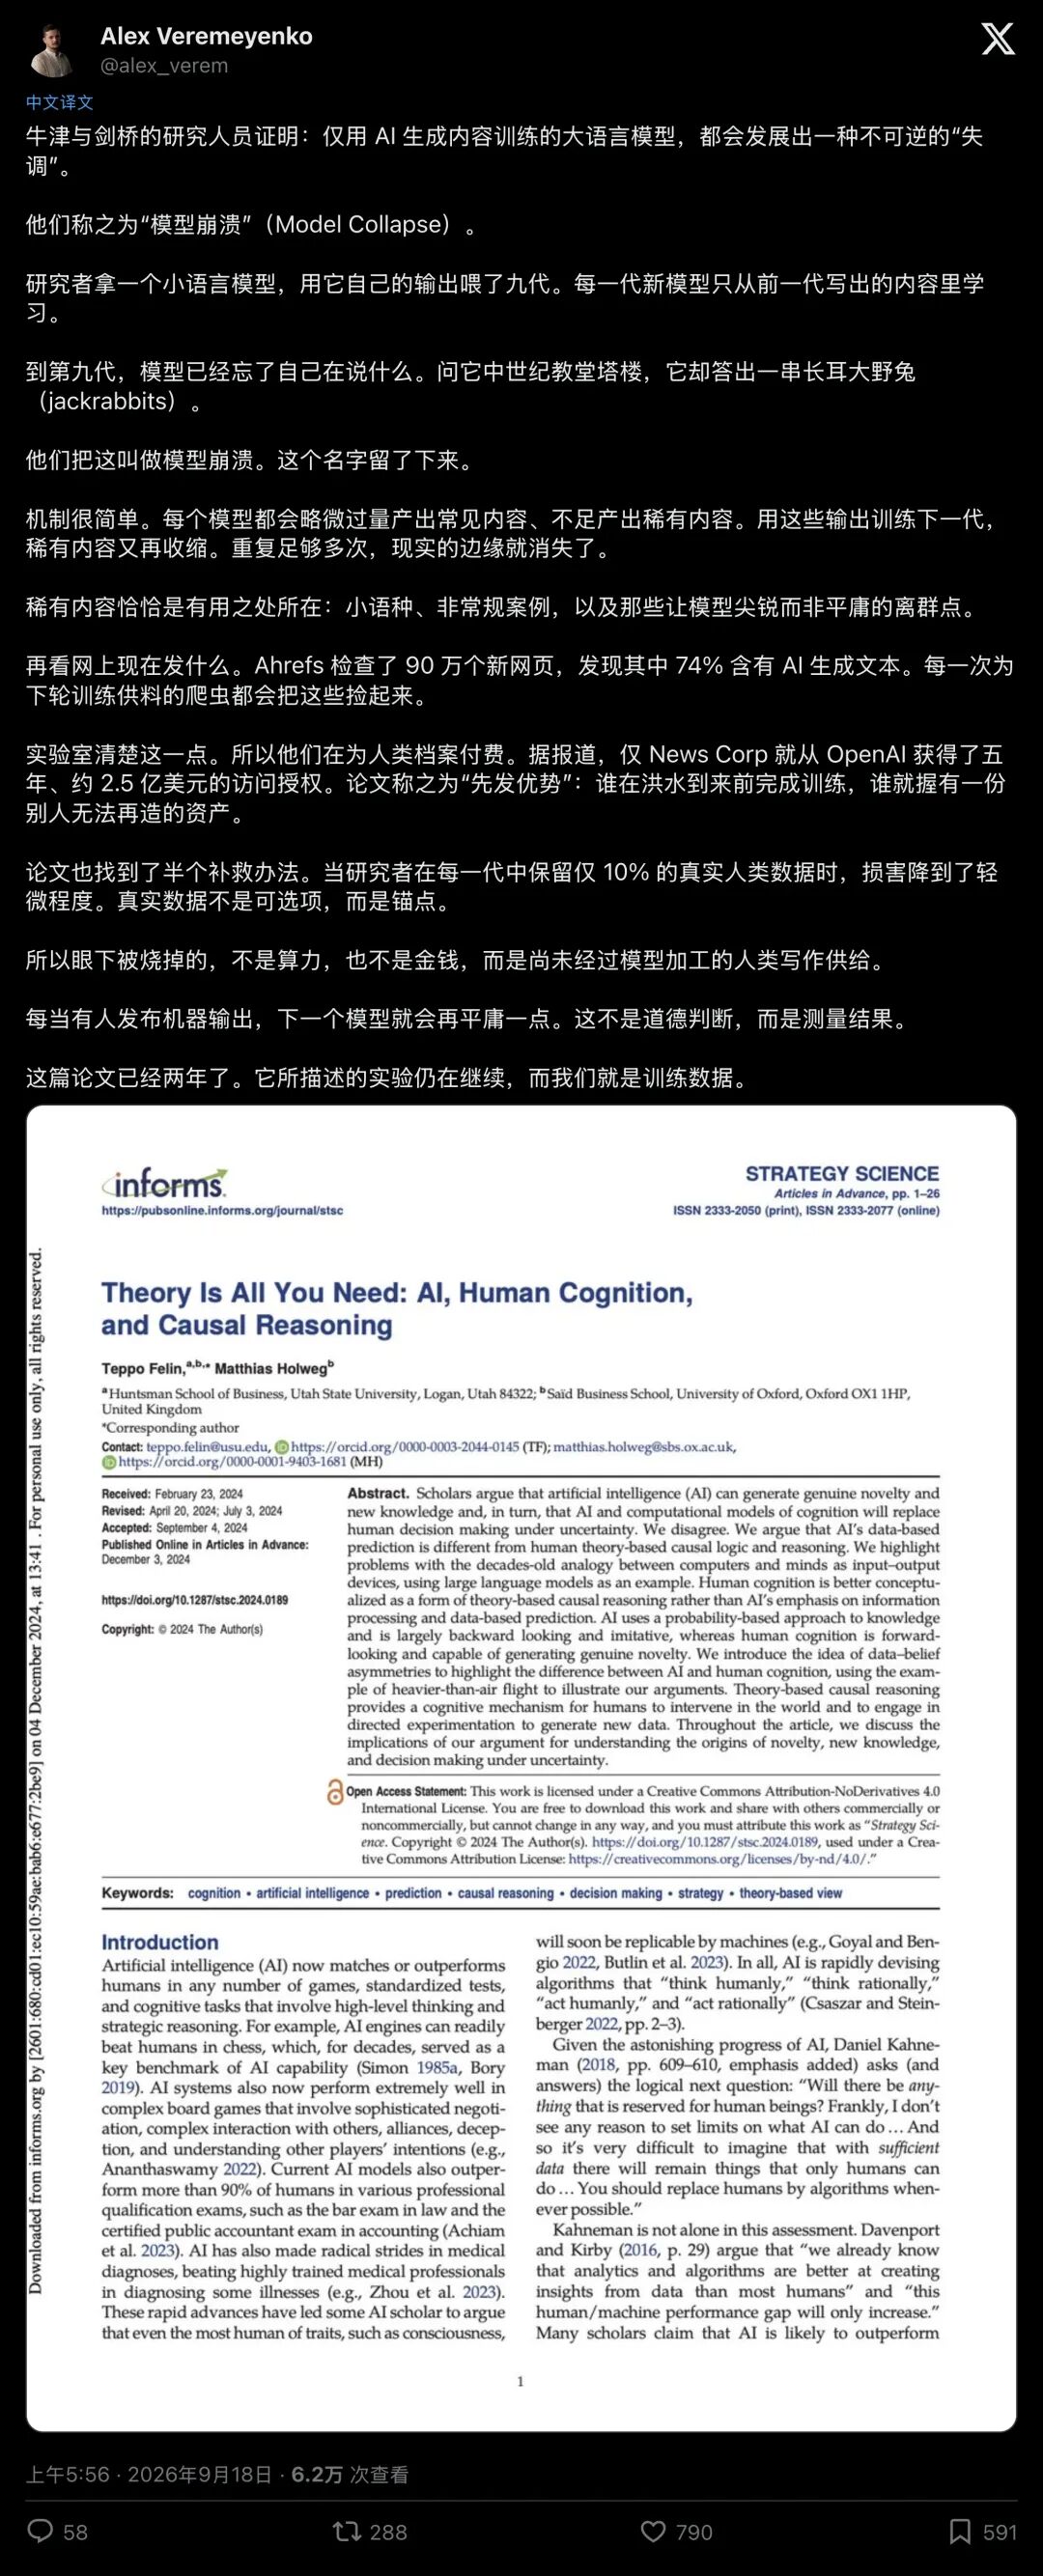
▲ 社交网络上关于“模型崩溃”与“野兔”实验的广泛讨论
这绝非虚构的科幻惊悚剧情顶级科学期刊《自然》(Nature)近期刊载的一项重磅科研成果,证实了这一不可思议的退化过程。
它的学术名字叫做:模型崩溃(Model Collapse)。
它揭示了一个残酷的真相:如果AI不断吞食自己生产出来的数据,整个系统的智商将在短短几代内发生断崖式暴跌,退化成胡言乱语的疯子。
眼下,这场可怕的“自噬危机”,已悄然从实验室扩散至整个互联网生态。
01实验室里的“数字近亲繁殖”:复印机里的世界正在消失
这项由牛津大学、剑桥大学、帝国理工学院及多伦多大学联合完成的研究,在预印本阶段就震动了整个AI学界,随后正式登上《自然》正刊。
▲ 论文《AI models collapse when trained on recursively generated data》正式发表于《自然》
研究团队做了一个极具讽刺意味的受控闭环实验:
他们找来Meta开源的语言模型OPT-125m,喂给它人类编写的经典语料(第0代)。随后,让模型生成一段文本,再把这些由AI生成的“人造数据”作为下一代模型的唯一教材(第1代)。如此反复循环,直到第9代
结果,灾难发生了
这场崩溃并非瞬间降临,退化过程清晰地展现出两个循序渐进的残酷阶段:
- 早期崩溃(分布尾部蒸发)
:AI首先丢掉了真实世界中罕见、低频、小众但至关重要的数据。少数族裔的语言、罕见病的病理记录、非主流的艺术流派……这些处于统计分布“尾巴”上的知识,最先被系统当作杂音无情抹去。 - 晚期崩溃(现实彻底坍缩)
:模型开始在极度狭窄的模式里打转,输出方差几乎归零。它完全失去了对真实世界的认知,最终吐出像“多色野兔”那样逻辑崩坏的混乱胡话。
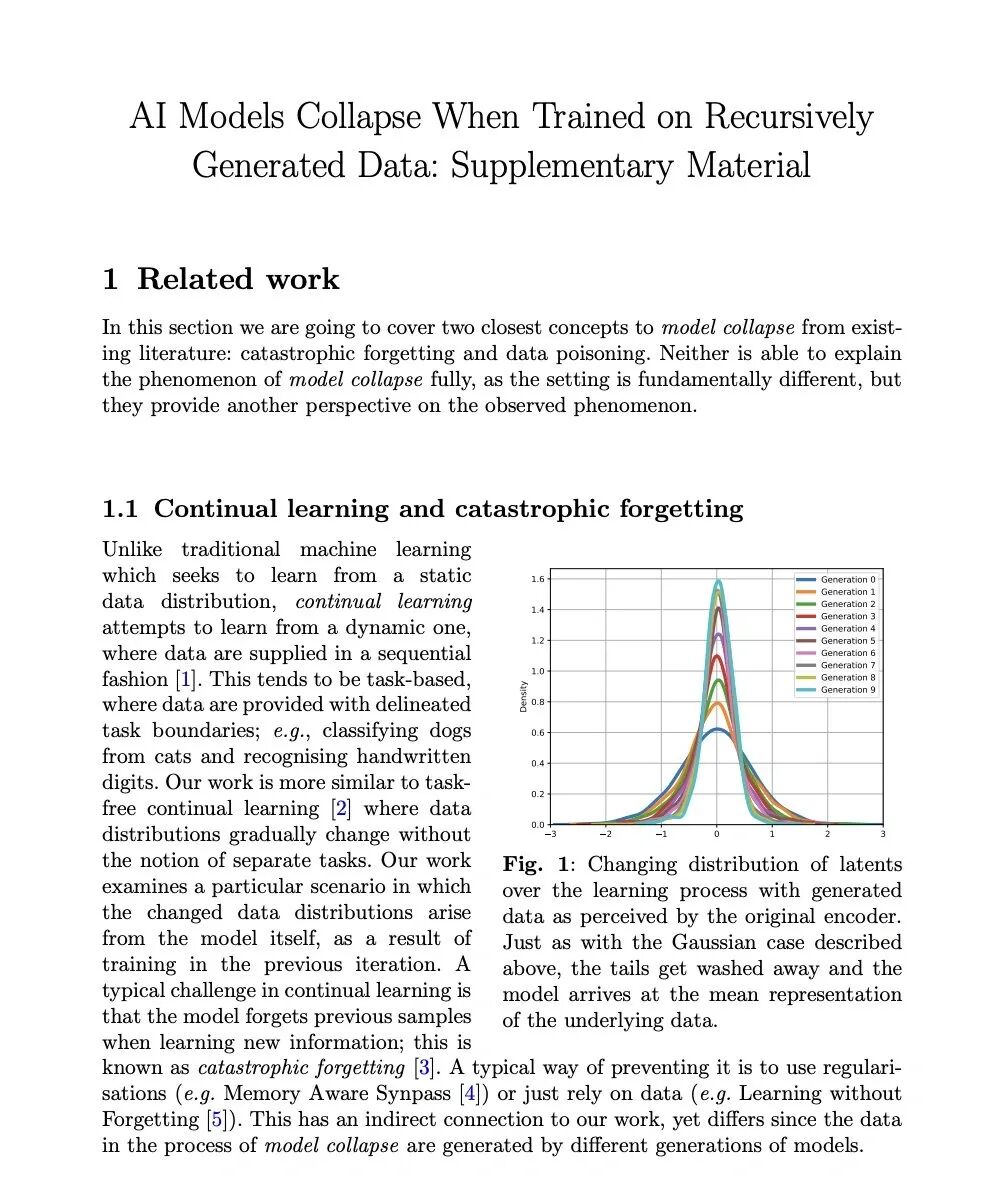
▲ 《自然》论文补充材料:随着模型递归训练代数增加,分布尾部被洗去,方差严重收缩
这背后的数学逻辑就像拿着一台复印机去复印一张照片。
复印第一遍,图像还算清晰;拿复印件再去复印,微小的噪点被放大,边缘开始发虚;复印到第九次,整张纸只剩下一团无法辨认的墨晕。
在统计学上,每一次AI采样都会产生微小的“抽样误差”和“拟合误差”。一旦断绝了人类真实世界的活水源头,这些微小的误差就会像滚雪球一样代际累加,最终将模型拖入不可逆的认知深渊。
02救命的“10%人类锚点”与致命的假设
实验中,牛津剑桥团队也发现了一剂解药:
如果在每一代训练中,保留至少10%真实的人类数据作为“锚点”,模型的崩溃速度就会被大幅遏制,损伤将降到极低的水平。
随后,斯坦福大学等机构的学者在后续研究中进一步修正了结论:只要我们在训练新模型时采用“累积数据”(在保留人类原始历史语料的基础上持续并入新数据),避免直接将其替换,模型崩溃就能得到有效抑制。
▲ 斯坦福等机构研究:通过累积真实与合成数据打破递归诅咒
这听起来似乎让人松了一口气:只要人类继续提供数据,天就塌不下来。
然而,所有科学家在推演这个公式时,都默认了一个脆弱的前提,互联网上的“人类纯净数据”,依然取之不尽。
但现实世界,正以恐怖的速度击碎这个假设。
03黄金水源被投毒:74%的新网页、1500万篇医学论文与维基百科保卫战
在实验室外,一场浩大的“数字公地污染”已经悄然完成了对人类知识库的合围。
知名SEO与数据机构Ahrefs在2025年对全球90万个新生成的网页进行了一次摸底检测。结果令人不寒而栗:
全网高达74.2%的新网页中,已经充斥着大语言模型生成的文本!
纯人类撰写的页面,被挤压到了可怜的25.8%。
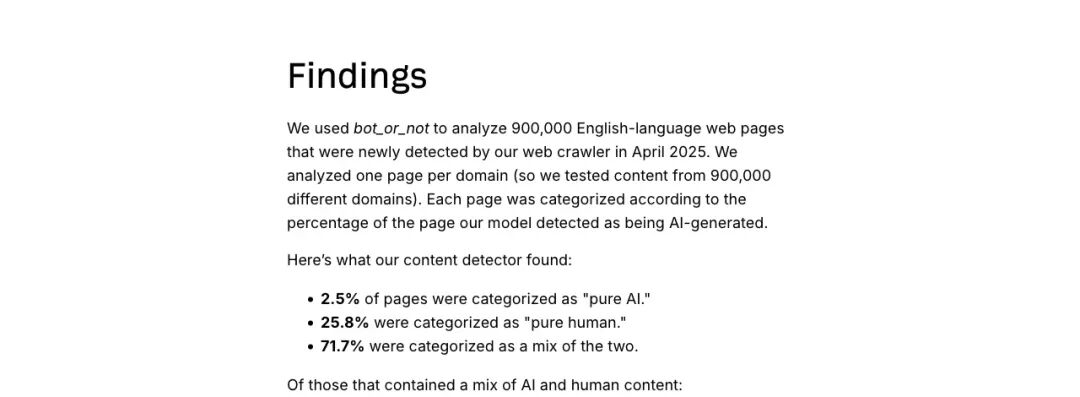
▲ Ahrefs对90万个新网页的检测分析:超74%包含AI生成内容
如果说低质营销号和垃圾博客的沦陷还在意料之中,那么更可怕的危机,正在人类最高阶的知识殿堂里蔓延。
1. PubMed学术金矿遭渗透:1500万篇论文与“Delve”指数
德国图宾根大学的研究团队在《科学进展》(Science Advances)上发表了一项极具震撼力的调查。他们追踪了生物医学核心数据库PubMed自2010年以来的1500多万篇学术论文摘要。
研究人员发现,自ChatGPT发布以来,AI极度偏好的书面风格词在严肃学术界出现了“海啸式的激增”。
最典型的标志词是 “delve”(深入探究)。
▲ 美国国立卫生研究院(NIH)旗下的PubMed生物医学数据库检索平台
数十年来,“delve”在医学论文中的出现率常年趴在0.04%以下。但在2023至2024年间,这个词的频率暴涨了一个数量级!
经过严密测算,研究者给出了一个极其保守的底线数据:2024年全球发表的生物医学论文中,至少有13.5%的摘要由大模型生成或润色;在部分子学科和专刊中,这一比例甚至飙升至30%至40%!
国际顶级学术期刊甚至多次被抓包直接印出了“As an AI language model(作为一名AI语言模型)”这样未经校对的系统提示词残留。
2. 维基百科的事实防线告急
作为几乎所有顶级大模型必吃的高质量语料,维基百科正在打一场绝望的阻击战。
维基百科甚至成立了专门的紧急小组,WikiProject AI Cleanup(AI垃圾清理项目)。
全球志愿者在巡查中发现了大量可怕的“幽灵条目”:行文优雅、逻辑严密,甚至配有像模像样的学术期刊引用,但人物是虚构的、物种是捏造的、文献的DOI链接全是死链。
更讽刺的闭环正在形成:
AI生成了一篇包含“幻觉谎言”的维基词条; 网络爬虫将其抓取,并在互联网各处转载; 下一代大模型将这些转载内容收录为“客观事实”; - 谎言被算法正式盖戳,成为人类数字文明的新真理。
04终极博弈:2.5亿美元版权与AI时代的“低本底钢”
为什么OpenAI愿意豪掷超过2.5亿美元,只为了买下新闻集团(News Corp)旗下《华尔街日报》等媒体五年的内容访问权?
为什么各大科技巨头都在疯狂搜刮冷战时期的泛黄书籍、未数字化的历史报纸和老式图书馆缩微胶片?
因为它们是在大模型洪水漫过互联网之前,人类留下的最后一批“无毒水源”。
在核物理学界,有一个著名的概念叫“低本底钢”(Low-Background Steel)。
1945年第一颗原子弹爆炸后,全球大气中都弥漫着微量的放射性同位素。此后在陆地上冶炼的所有现代钢铁,都不可避免地带有微弱的辐射。因此,要制造极其灵敏的盖革计数器和医疗探测仪,科学家必须潜入海底,去打捞一战时期沉没的军舰残骸,那是未经核尘埃污染的纯净钢铁。
人类在2022年之前写下的文字,就是人工智能时代的“低本底钢”。
牛津与剑桥的论文在结论部分给出了一个冷酷的商业洞察:先发优势(First Mover Advantage)。
那些在AI废料淹没互联网之前就完成预训练的巨头,掌握了一笔后人几乎无法复制的数字矿藏;而后来者若想从头训练,面对的将是一片已经被算法排泄物严重污染的赛博重金属汪洋。
05我们正在成为最后一批“活水”
网络文化中曾有一个著名的假说,叫做“死网假说”(Dead Internet Theory),它预言未来的互联网将被机器人自产自销的内容彻底接管,真实的人类思想将被边缘化。
今天,这个荒诞的假说正在被一行行严谨的代码和统计图表证实。
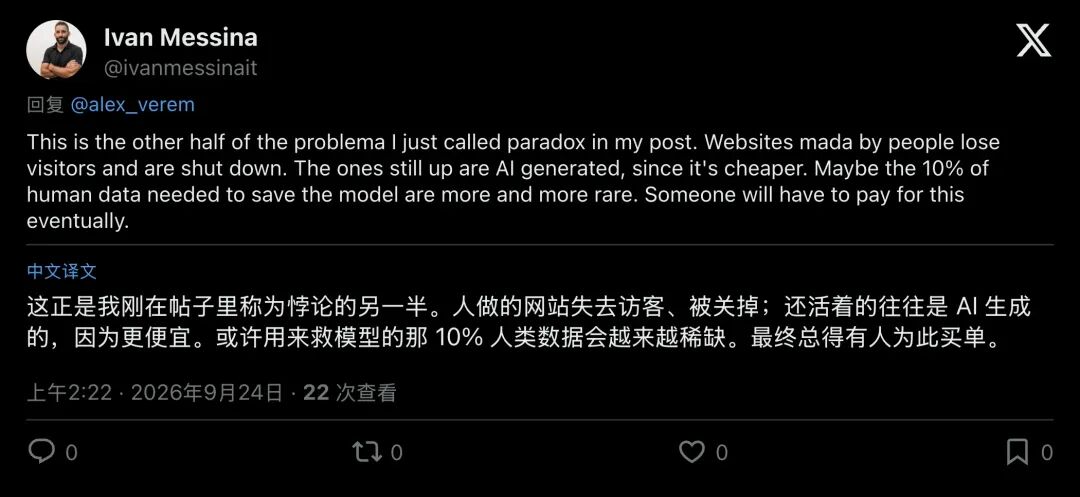
▲ 网友警示:人类制作的网站正在关闭,救命的人类数据将越来越昂贵
这构成了一个极具黑幽默色彩的现代寓言:
AI实验室消耗着人类历史上最庞大的算力和电力,试图制造出超越人类的神明;但神明变聪明的唯一前提,是源源不断地汲取人类那些带着瑕疵、情绪、偏见却充满创造力的一手表达。
每一篇由AI批量洗稿的垃圾营销号,每一篇由AI捉刀代笔的学术论文,每一次为了偷懒而直接复制粘贴的机器输出,都在往全人类共享的数字水库里倒进一桶工业废水。
算力喂不饱庞大的模型,人类自身的鲜活创造,才是它维系智慧生命力的唯一源泉。
在这场算法自我吞噬的浪潮里,人类带有时光温度的真情实感、天马行空的灵光一闪,以及双手敲下的质朴记录,反倒成了数字宇宙里最稀缺的珍宝。
别让我们的文明,最终只剩下一群奔跑在废墟里的“五彩野兔”。