ARTICLE · 1112110
全员不及格!谷歌发起史上最残酷AI编程大考:最高分仅28,自家主力得8分
作者 | 陈明
编辑 | 李博
科技界这几年最不缺的,就是各种各样的“神话”。
打开社交网络,几乎每天都有人在狂热宣称:“AI 已经能独立写出完美软件”、“AI 已经能独立接管复杂软件工程”、“一人独角兽时代已经到来”。在各大实验室的标准考卷上,AI 的代码得分更是动辄飙到 90% 以上,俨然一尊尊全知全能的“代码之神”。
直到 2026 年 9 月中旬,谷歌 Android 官方团队毫无预兆地掀翻了桌子。
他们把目前全世界最顶尖的大模型、最先进的编程智能体全部关进了一个名为 Android Bench 2.0 的全新考场。这场考试告别了玩具代码与几十行的小修小补,直接让 AI 像资深架构师一样,接手横跨数天甚至一周的真实大型移动工程。
▲ Android Developers 官方博客宣布推出 Android Bench 2.0:转向高难度长周期任务挑战
战报一出,整个硅谷一片死寂
满屏九十分的神话一夜破灭全球排名第一的 OpenAI 底牌 GPT-6 Astra,通过率只有 28%;而谷歌自家最倚重的旗舰级主力 Gemini 3.8 Flash,通过率更是惨跌到了 8%!
曾经在发布会上无所不能的 AI 程序员们,在面对真实的现代软件工程时,几乎全员交了白卷。
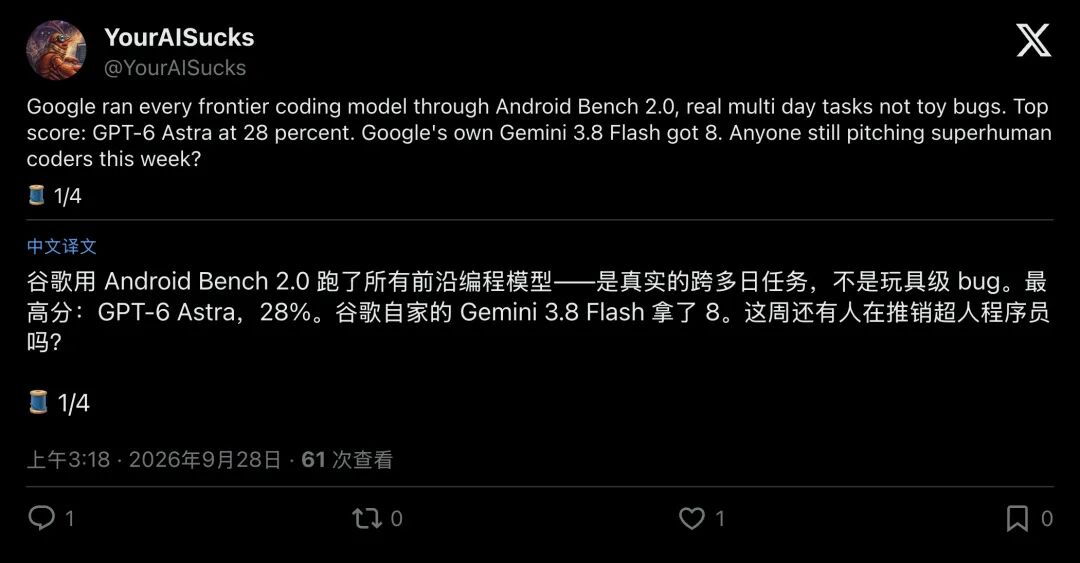
▲ 社区账号 YourAISucks 犀利点评:面对真实的数日工程任务,最高分仅 28%,谁还在兜售“超人程序员”?
01告别“玩具修补”:谷歌为什么要换一把最难的尺子?
过去那些编程考试,到底是怎么把 AI 捧上神坛的?
答案很简单:考题太简单了
以往的测试基准,给 AI 出的题目大多是“玩具级缺陷(Toy bugs)”。比如给你一个文件,里面有两行代码写错了,AI 只要像做小学改错题一样修好,就能拿到满分。在这样的温室里,前沿模型在初代 Android Bench 1.0 上轻松刷出 91% 的超高通过率。
但这与现实中的复杂软件工程相去甚远。
现实中一个中高级工程师每天在面对什么?
要把一个包含近 300 个文件、上万行代码的老旧架构整体拆除,平稳换上现代异步框架; 要把完全用跨平台语言写的 App,一行行重构成原生的 Jetpack Compose 界面; 要在真实手机模拟器里反复点按,确保横屏时不丢数据、滑出屏幕时不漏内存、弱网环境下不卡死闪退。
▲ Google for Developers 官方发文,宣布将评测重心转向跨多日的复杂长周期工程任务
为了戳破这种虚假的繁荣,谷歌推出了这套被媒体称为“残酷压力测试”的 长周期任务集(Long-Horizon Tasks, 简称 LHT)。
考题一共 30 道,直接划分为四大足以让资深工程师掉头发的硬核工程流:
- 绿地应用创建(9 题)
:只给一套 Figma 视觉原型图,要求 AI 从零搭建一款名为 Food Vibes 的多屏外卖 App,代码量在 1,200 到 5,500 行之间,跨越几十个源文件。 - 大型架构与依赖迁移(13 题)
:在知名开源项目上做“开颅手术”。比如给 Signal 加密通讯软件做 Java 转 Kotlin、把 PocketCasts 的网络层全量换成 Ktor 3、把 Bitwarden 密码管理器的导航系统升级到 Navigation 3(涉及 233 个文件),甚至跨越 294 个文件进行依赖注入重构。 - 平台级复杂新功能(6 题)
:引入画中画播放、Wear OS 智能手表数据同步、桌面小部件与相机管线。 - 跨平台原生转化(2 题)
:把基于 Flutter 或 React Native 的真实项目,全量手工转写为原生 Android 代码。
为了防止大模型“提前背题”,谷歌布下了铁桶阵:代码库全是闭源资产,测试的都是刚刚发布的全新框架,网络上根本没有现成的答案可以抄。
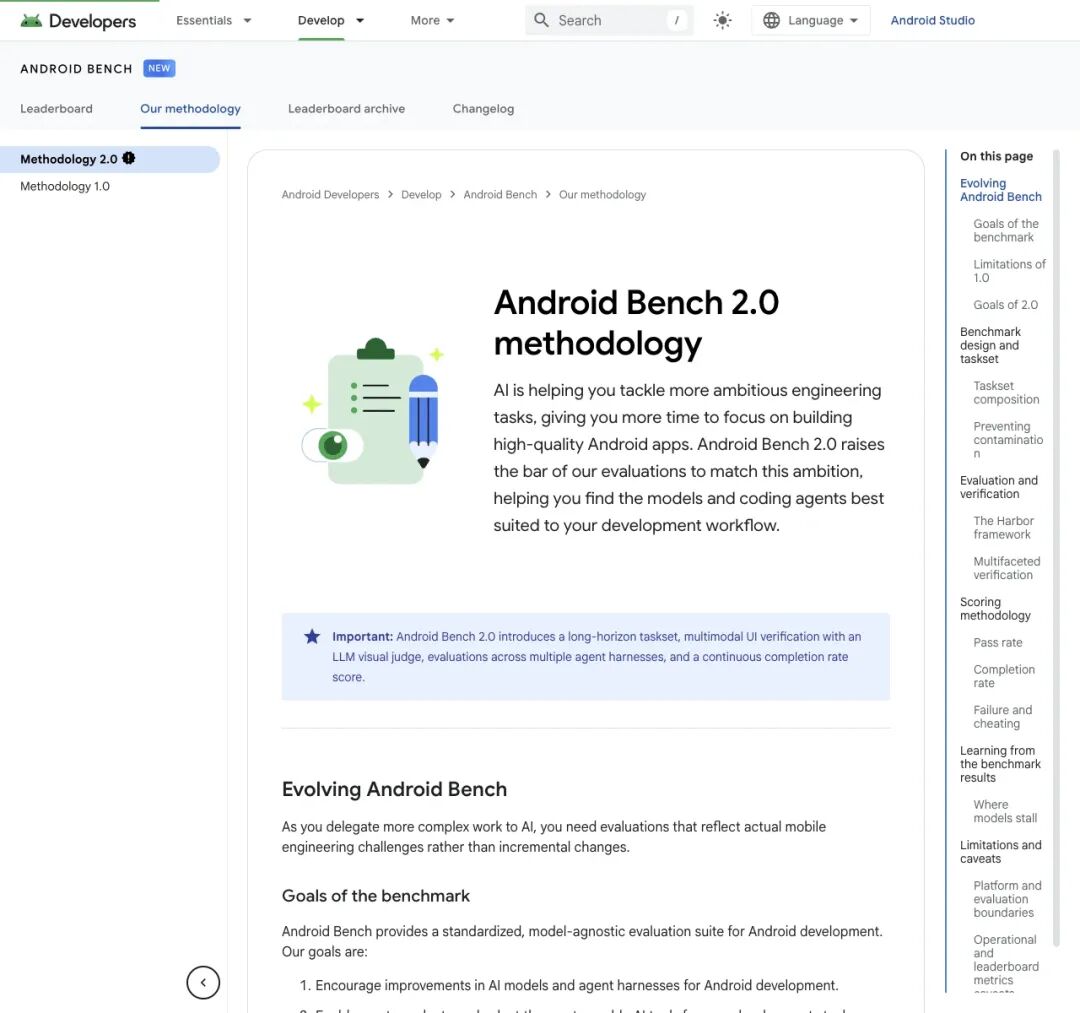
▲ 官方方法论页面展示的升级重点:长周期任务、多模态 UI 验收与防背题策略
02车祸现场大赏:代码看起来都对,一跑全是灾难
很多人会好奇:大模型明明输出了成千上万行工工整整的代码,单元测试也绿了一大片,为什么最终通过率连三成都不到?
翻开官方公布的代码审查记录,简直就是一部 AI 编程的“翻车大百科”。
大模型最擅长模仿语法的表面形式,但一旦触及到系统运行生命周期、异步数据流和内存管理,它们立刻漏洞百出。
1. 翻车案例一:横屏即失忆
在重构 Signal 个人资料页时,OpenAI 的 GPT-6 Astra 表现极其惊艳,界面画得天衣无缝,按钮动画流畅丝滑。
然而,审查人员把手机横过来放了一下,整个界面瞬间“被清空”,用户刚刚辛辛苦苦填完的资料全部蒸发。
为什么? 因为 AI 把表单的数据保存在了最浅层的界面缓存里,没有按照现代安卓规范把状态“提升(State Hoisting)”到 ViewModel。手机一旋转,系统重建界面,AI 写的数据就随着内存一起灰飞烟灭。
2. 翻车案例二:关不掉的幽灵播放器
在为新闻流开发视频播放功能时,GPT-6 Astra 完整接入了最新的播放器组件。但当用户把视频滑出屏幕之外时,AI 居然忘记了调用释放资源的指令(player.release())。
结果就是:界面上明明已经看不到视频了,后台还在悄悄播放声音,音频通道被死死霸占,运行几分钟后整个手机内存直接被撑爆。
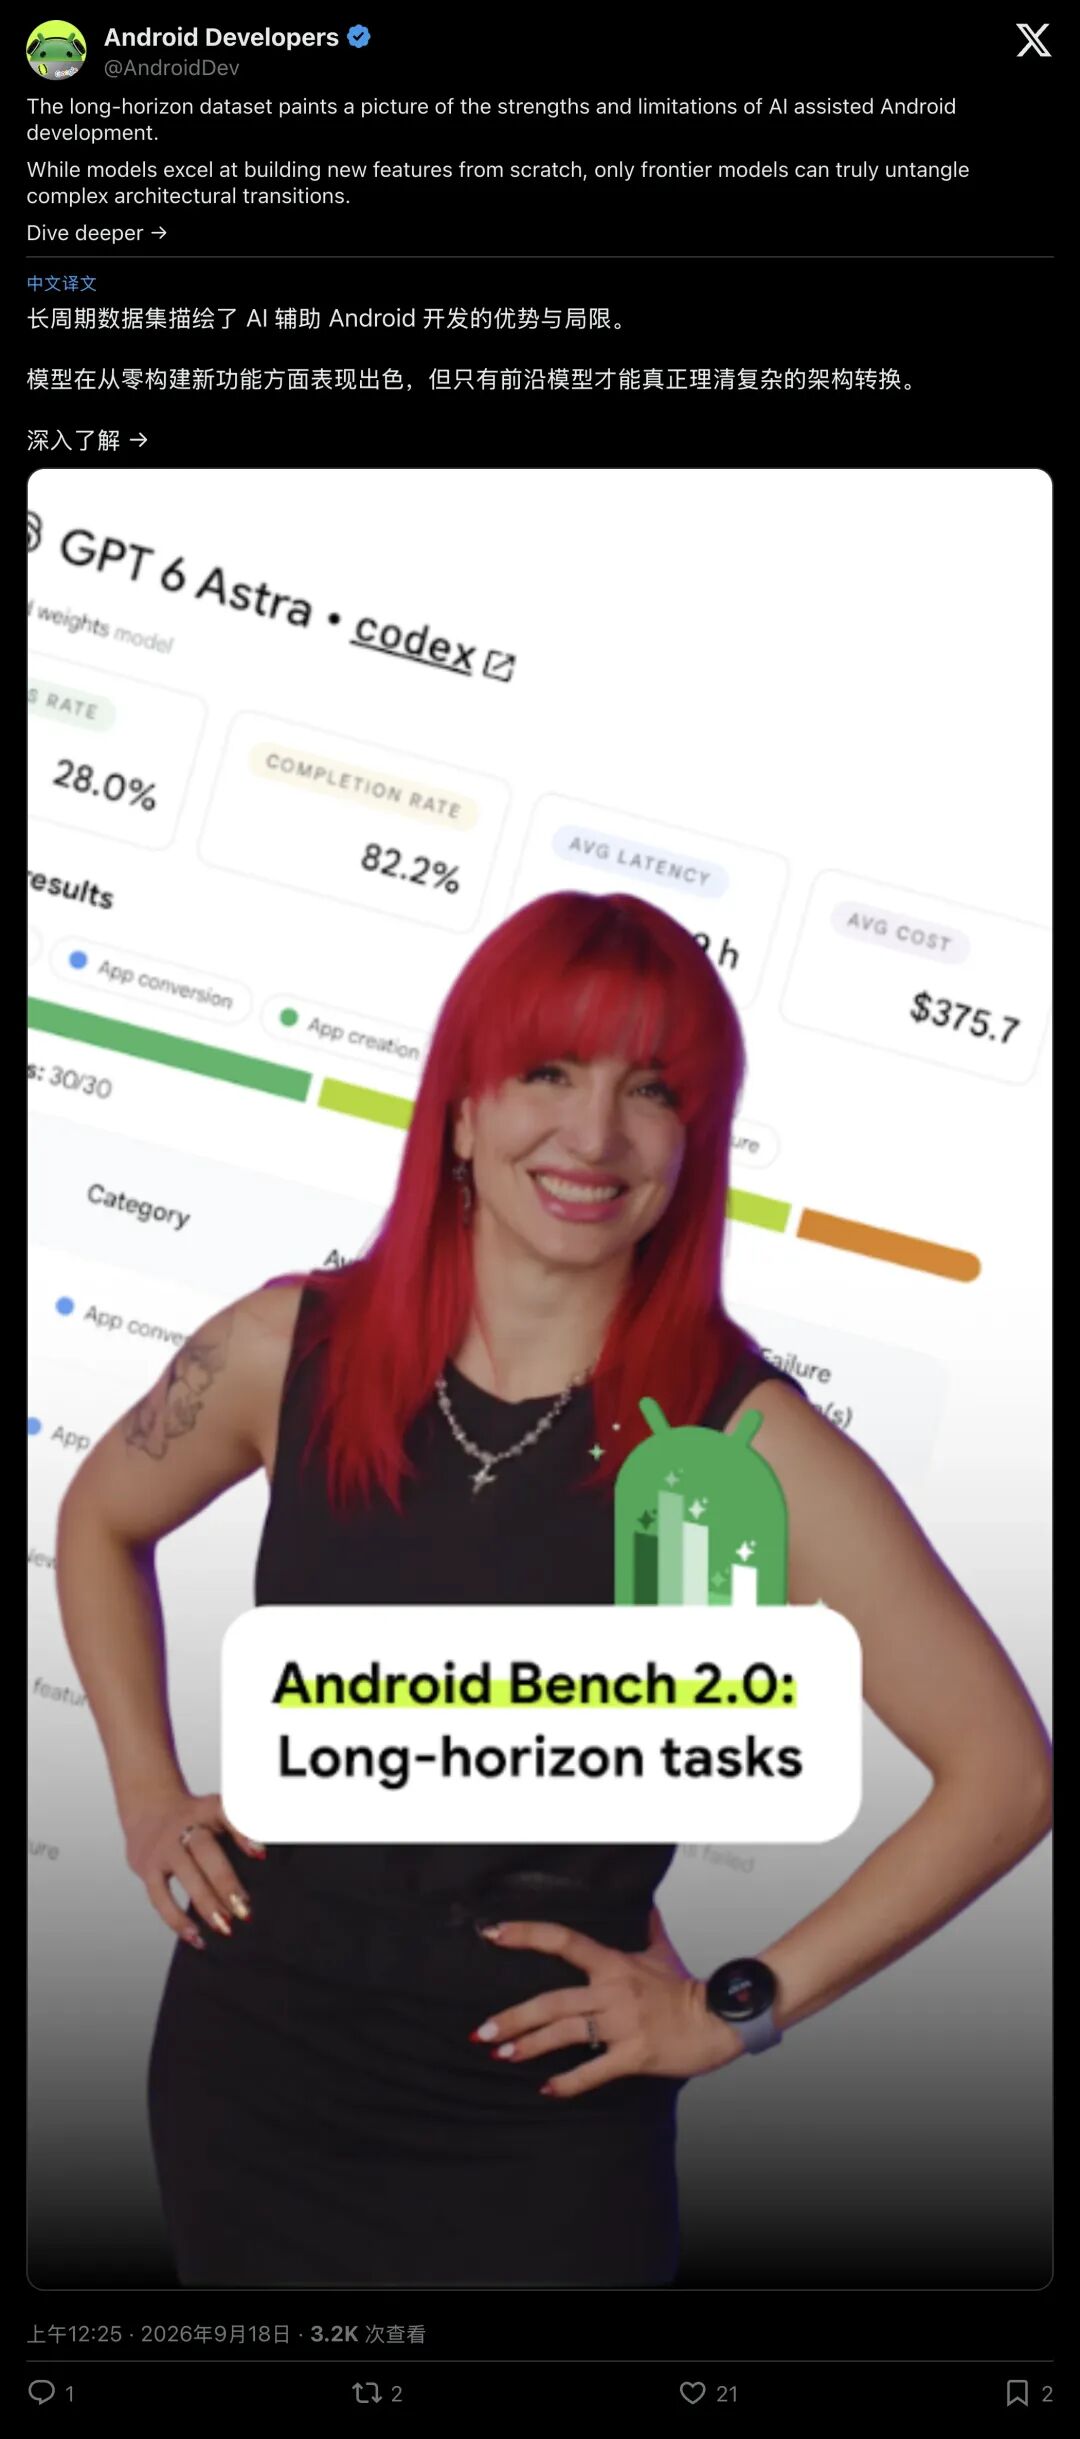
▲ 官方视频指出:大模型擅长写新代码,但理清复杂的底层架构依然极其吃力
3. 翻车案例三:变成植物人的桌面小部件
在给新闻 App 编写桌面小部件时,Anthropic 的顶尖模型 Claude Fable 5.1 把监听最新新闻的代码写错了位置,它把数据流订阅写在了内容构建区域的外部。
这就导致小部件只有在刚被拖到桌面上的一瞬间读取了一次数据。此后无论新闻怎么更新,这个小部件永远处于“假死状态”,再也不会重绘一次。
4. 翻车案例四:跨平台转原生,全员通关率为 0
最让各大实验室绝望的,是跨平台转原生的赛道。
以 GPT-5.6 Sol 为例,模型在前面的 94 个执行步骤中极度聪明,行云流水般把核心框架和主干页面全部搞定,完成度直接冲到了 84%。
但就在所有人都以为它要通关时,模型陷入了诡异的长程疲态(Long-horizon Fatigue)。在后续的 121 个步骤中,它耗费了一大半的算力,却在死胡同里疯狂打转:暗黑模式的配色死活对不上、次级页面的本地数据存储死活记不住。最终,没有任何一个模型能够在这项测试中拿到 100% 满分。
03重新定义考试规则:不做非黑即白的裁判
如果按照过去的评分方式:只要有一处断言失败,或者一个边角像素对不齐,整套代码直接记 0 分。
但这在长周期工程里显然不合理如果一个 AI 智能体辛苦重构了 40 个界面、搭好了底层数据库、完成了 90% 的复杂工作,仅仅因为漏掉了一个动画过渡就被直接判零分,开发者就无法客观衡量它的实际工程价值。
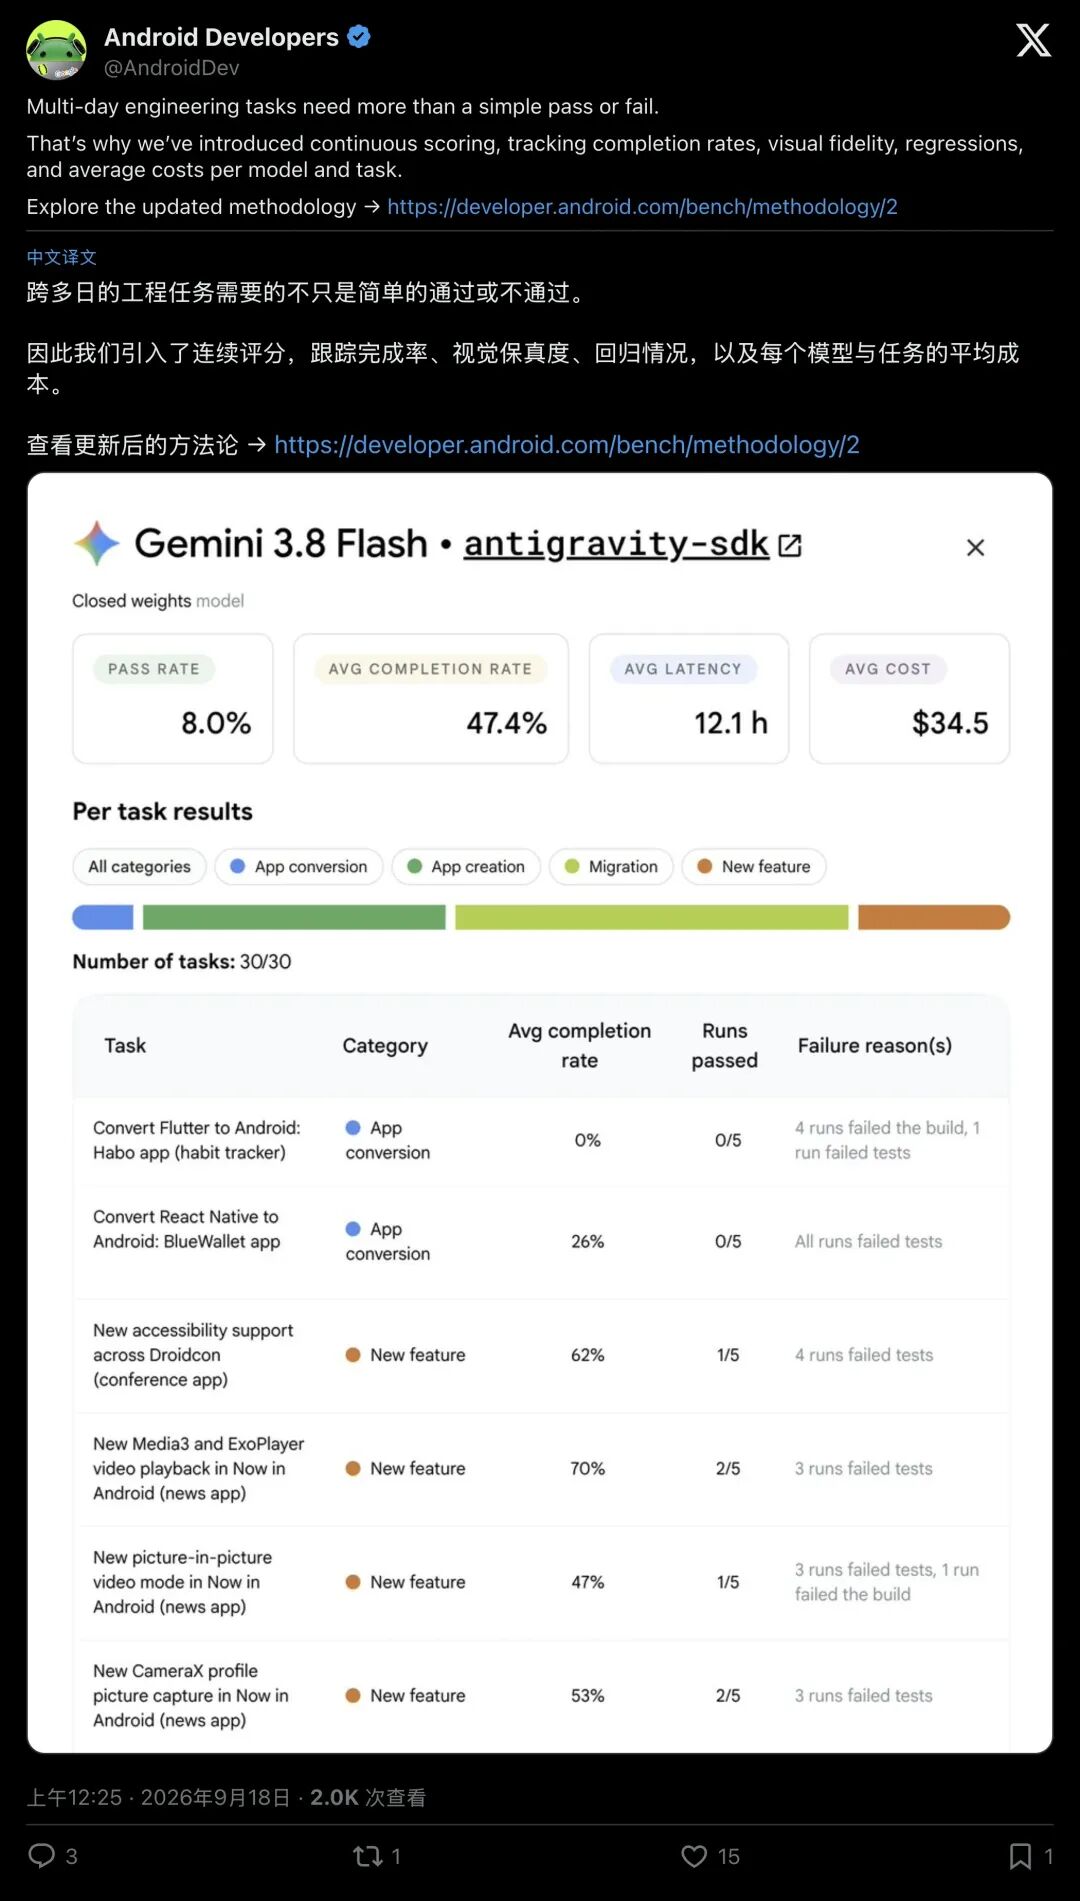
▲ Android Developers 官方强调:多日任务需要连续完成度评分,细化衡量功能、回归与视觉
因此,Android Bench 2.0 带来了打分逻辑的重大变革:
- 主指标(通过率)
:依然是极其苛刻的二元通过率(Pass Rate),必须全部功能测试通过、视觉无瑕疵、架构零违规才算 100% 完美。 - 连续完成度评分(Completion Rate)
:给出一个 0.0 到 1.0 的平滑分数。架构迁移重构侧重功能与防回归;界面创建侧重视觉与还原度。如果 AI 试图作弊(比如用一张全屏截图假装自己写了原生界面,或者硬编码假数据),直接一票否决归零。
评测方式本身也迎来了关键升级以往很多工具比对 UI 依靠“像素差分”,只要系统状态栏的时间变了一分钟、电池电量掉了一格,工具就会误判整个界面错误。
在 2.0 中,谷歌派出了 Gemini 3.5 Flash 担任多模态考官,直接结合底层无障碍树(Accessibility Tree)去深度审视界面:确认按钮是否具备交互性、文字语义是否准确、整体布局是否符合人体工程学。
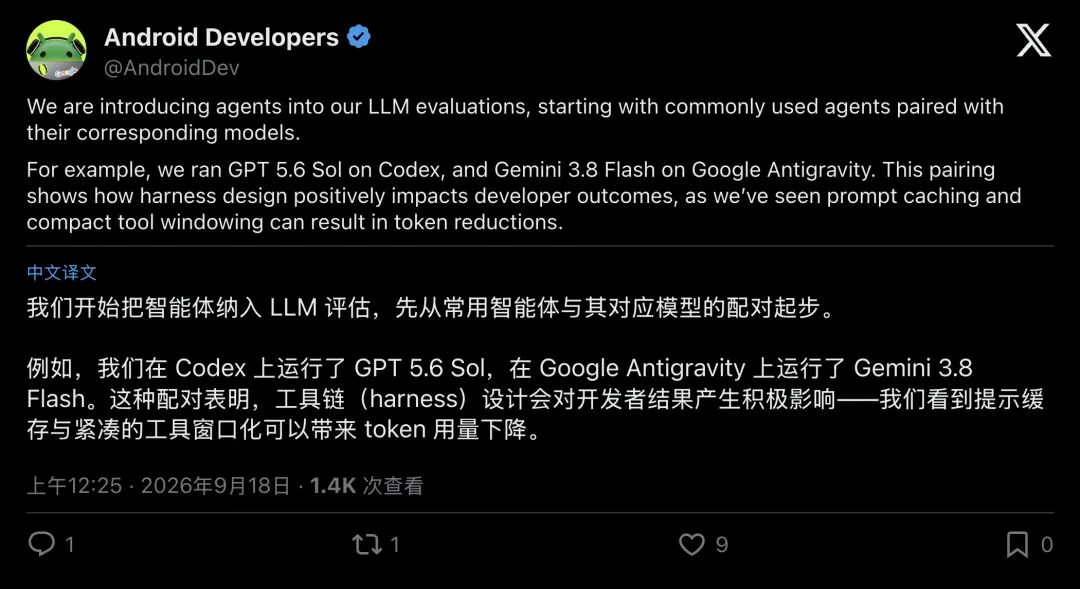
▲ 官方将评测扩展到现代智能体工具链,探索模型与 Harness 配对的最佳形态
与此同时,评测也不再只测“裸模型”,而是把它们放进 Codex、Claude Code、Antigravity SDK 等成熟的智能体装具(Harness)中。每道题目都在独立的 Docker 沙盒与硬件加速的虚拟设备上运行,反复跑 5 次取平均值,彻底排除了随机运气的成分。
04深层洞察:AI 编程的下半场,到底卡在了哪里?
从 90% 跌落到 28%,这组巨大落差的数据让全行业冷静下来。它清晰展现出了当前 AI 辅助编程的能力边界:
▲ 社区资深开发者指出:单轮问答高分不等于能跑完多日项目,状态管理与失败恢复才是核心
1. “写新代码”容易,“动老系统”要命
所有大模型都表现出了明显的偏科:从零搭建一个新功能,它们往往能拿高分;但要在一个动辄几百个文件的大型旧项目里做重构,它们极易崩溃。
现实世界的软件开发宛如在飞驰的高速列车上更换轮件。大模型面对隐式依赖、旧逻辑兼容与架构契约时,极难维持严密把控。
2. 软件工程的核心是“管理状态与生命周期”,远超单纯的代码补全
大模型的底层逻辑建立在概率预测之上,擅长猜测“这一行后面大概率接什么代码”。然而严肃的系统设计属于确定性的状态机:页面销毁后数据如何留存?网络中断后重试机制如何运转?多线程并发下如何规避死锁?
这些问题无法通过“感觉”来解决,必须依赖严密的逻辑闭环。一旦缺乏运行时的动态校验,AI 生成的代码就会变成外表光鲜、内里中空的危房。
3. 从“单次提示词奇迹”走向“人机协同闭环”
Android Bench 2.0 的核心价值在于为整个工业界绘制了一张清晰的航海图,让开发者直观认清工具的能力边界。
▲ 官方持续将最新模型纳入长周期大考,推动工业界向更可靠的方向演进
对于现代开发团队而言,指望直接把需求丢给 AI、自己当甩手掌柜的幻想可以彻底破灭了。但在编写脚手架代码、标准库确定性迁移(如 Java 转 Kotlin)、样板代码生成等环节,AI 依然是历史上最高效的放大器。
决定软件最终质量的,依然是坐在屏幕前、深谙系统生命周期与架构底线的那个有血有肉的工程师。
别再被宣称“AI 明天就能全自动化交付工程”的噱头裹挟了。复杂的系统工程充满严苛细节,正因如此,人类架构师深厚的经验与全局掌控力,依然是软件开发不可动摇的基石。