ARTICLE · 1114151
AI斗地主,Nature论文揭示强化学习如何在未知信息中做决策
国际象棋、围棋中,棋盘完全公开,这类未来行动的计算问题,AI已经很擅长。
然而现实中的决策通常包含隐藏信息,某些信息对一个决策主体未知,却被另一个主体掌握。
斗地主、扑克、商业竞争,你永远不知道别人手里有什么牌。但看不见的牌,往往决定最后的输赢。
不完全信息博弈
这些都是不完全信息博弈,大量隐藏信息的存在,使得传统强化学习和搜索方法难以有效发挥作用。
即便是投入数百万美元级别的工业研究资源,在具有大规模隐藏信息的棋牌游戏中,AI仍然无法达到顶尖人类玩家水平。
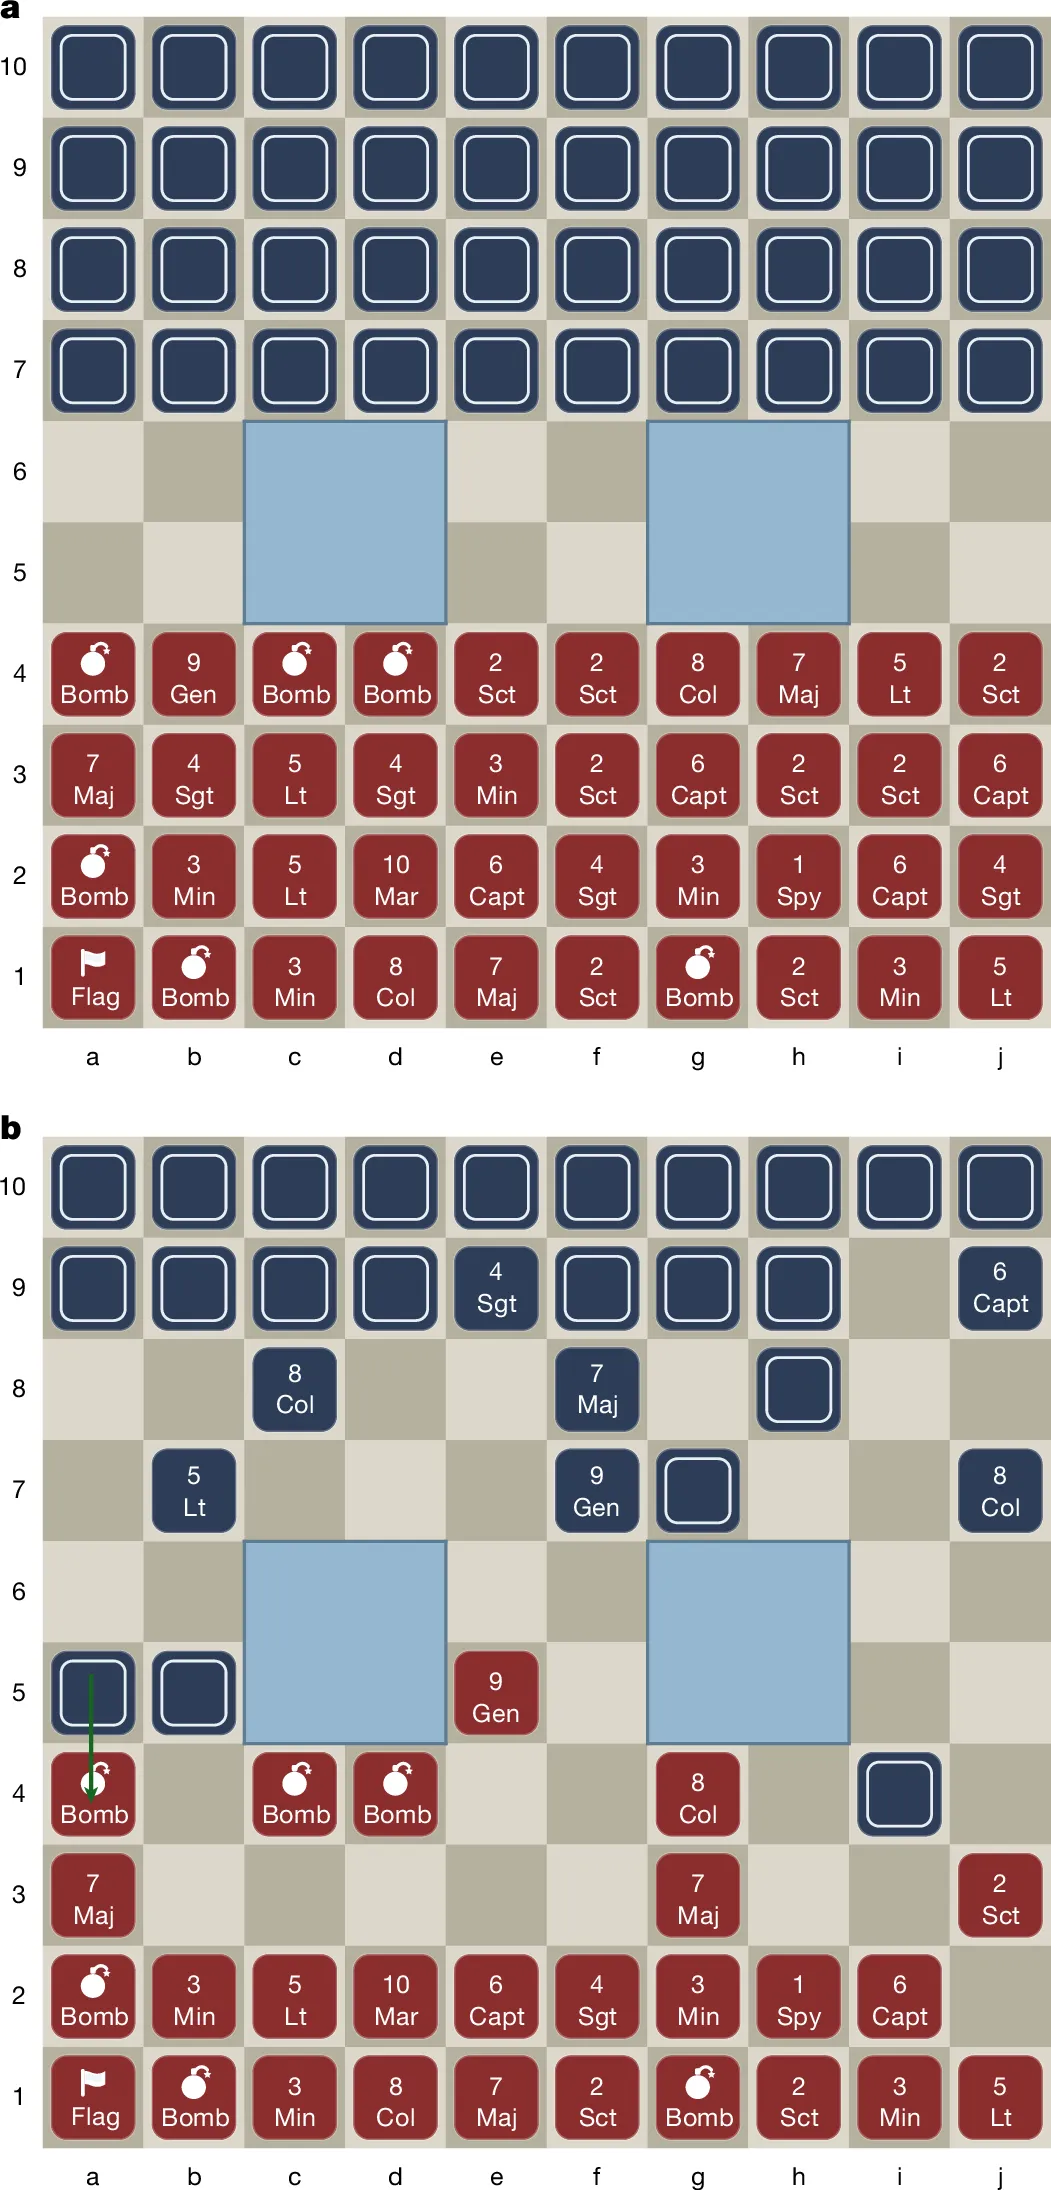
以 Stratego(陆战棋)为例,双方拥有40枚隐藏棋子,大量初始布局无法观察,可能状态数量超过 。
DeepMind 曾提出 DeepNash,通过大规模自博弈解决 Stratego,但训练需要极高计算资源。
卡内基梅隆、纽约大学、斯坦福、MIT组队发表的 Nature 最新论文提出 Ataraxos【文献1】,让AI在行动前,先推断未知世界的可能状态,再基于这些可能性优化决策。
先猜牌再出牌
Ataraxos 有几个核心模块。
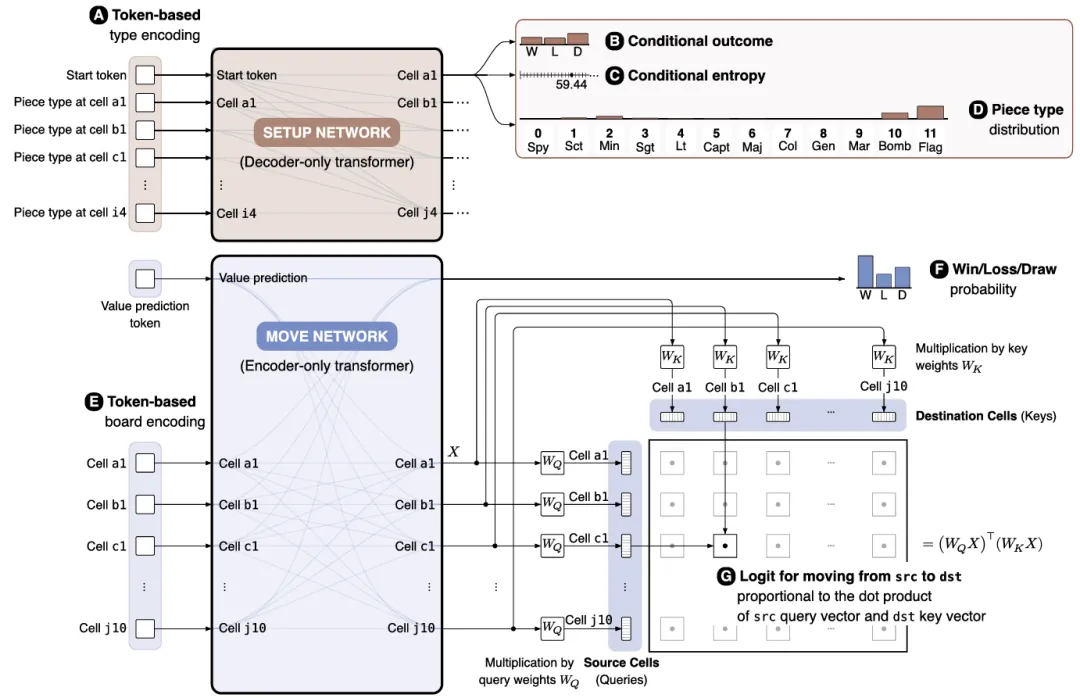
策略价值网络,判断当前局面的价值如何,应该采取什么行动。信念网络,根据已有观察,猜测真实世界可能是什么样。
Stratego中,需要推断对手隐藏棋子的位置和类型。在斗地主等任务中,还需要估计未知手牌、牌堆以及其他隐藏信息。
Ataraxos 会建立一个概率分布,不是简单选择一个确定答案。这等于让AI在行动前,先形成对未知世界的概率表征。
之后从这些概率分布中采样多个可能世界,分别计算如何行动。最后综合不同可能性的收益,形成当前决策。
动态阻尼机制
不完全信息博弈还有一个特殊困难,策略和信念会相互影响。我的行动会改变对手对我的判断,对手的行动又会改变我对隐藏状态的估计。
双方反复调整,训练过程容易出现震荡。模型可能刚学会一种策略,对手马上适应;随后模型再次调整,系统进入循环。
对此,Ataraxos 引入动态阻尼机制。
训练早期,保持较高随机性,让模型探索更多策略;后期,随着策略逐渐稳定,降低随机性,同时减少策略更新幅度。
论文发现,探索强度、正则化程度和策略更新幅度需要保持权衡。更新过强,系统容易震荡;限制过严,又会降低探索能力。
这个机制类似物理系统中的阻尼,既保持运动,也帮助稳定。
搜索变在线优化
传统强化学习中的搜索,比如MCTS,通常通过显式展开搜索树预测未来。
而在隐藏信息环境中,搜索空间包含两部分,未来行动和未知状态。两者叠加后,搜索规模快速膨胀。
Ataraxos 改变了传统搜索方式。
推理阶段,信念网络首先生成多个可能隐藏状态;然后策略和价值网络模拟这些状态下的未来结果;之后模型针对当前信息集执行少量在线策略优化;最后根据优化后的策略选择动作。
论文将这个机制称为更新等价。
训练阶段,模型通过大规模自博弈优化通用策略。推理阶段,利用额外计算,对当前局面进行局部调整。
搜索过程被重新建模为一次在线策略优化,训练和推理共享同一个优化框架。
成本下降几百倍
传统强化学习通常依赖大型 Rollout 缓存,保存大量历史状态、动作和环境信息。
Ataraxos 去掉了这种大规模缓存,融合算法和工程提升效率。不长期保存状态,需要过去状态时,通过计算临时生成;重新设计 CUDA 模拟器,提高大量并行博弈状态更新的效率。
最终,Stratego 训练使用16张 H100 GPU,运行约一周,完成约1.63亿局游戏;2080亿环境步。
论文报告,相比 DeepNash,训练计算量降低约500倍;自博弈局数减少约30倍;训练样本减少约100倍。
陆战棋到斗地主
Ataraxos 在多个不完全信息游戏中进行了测试。
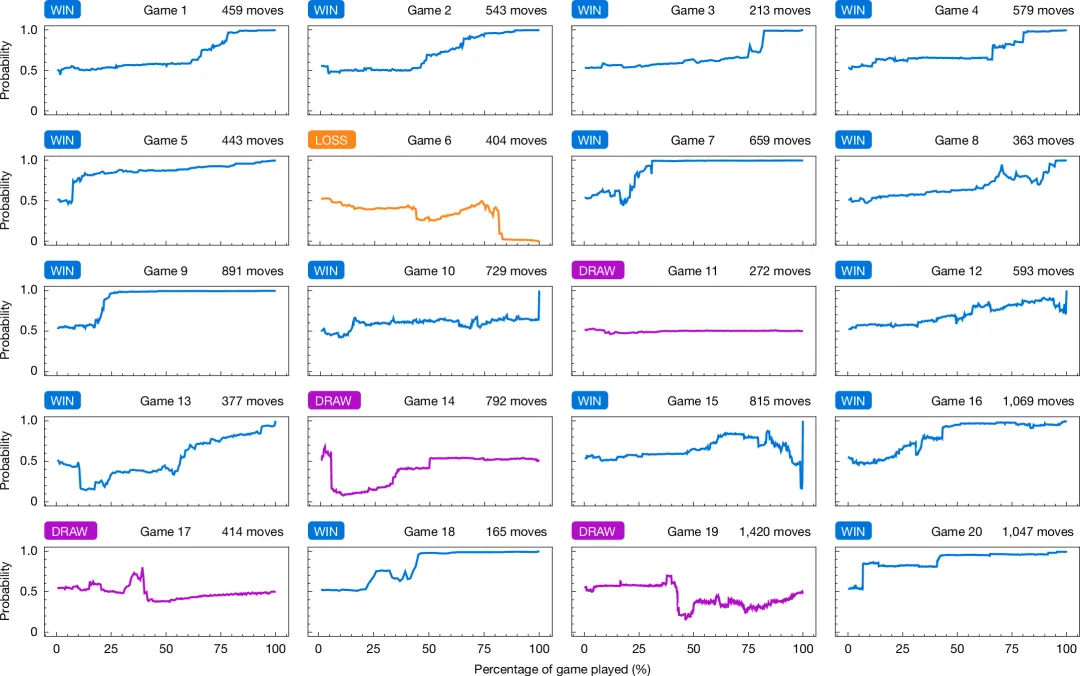
Stratego与顶级人类选手 Pim Niemeijer 比赛20局,取得15胜、1负、4和。Barrage Stratego 击败三名世界冠军级选手。
Hanabi赛,在多人合作模式取得领先结果。斗地主超过PerfectDou、DouZero等已有方法。
这些任务覆盖双人零和博弈、多人合作、非对称竞争。
结果显示,基于隐藏状态推断和在线优化的架构,可以适应不同类型的不完全信息环境。
最后一张现实牌
Ataraxos 将复杂决策拆成两个过程。
一、根据有限观察,建立隐藏状态的概率分布;二、在多个可能世界中模拟未来,并优化当前行动。
这套思路与很多现实复杂决策存在结构上的对应。
商业谈判需要推测对手策略;金融交易需要处理大量不可观测变量;供应链计划则需要判断需求变化、供应风险和竞争行为。
斗地主,高手赢牌靠的不只是算牌,还知道自己不知道什么。
Ataraxos 展示了,未来AI决策可能不仅需要预测答案,还需要持续维护一个关于未知世界的概率表征。
这为战略决策领域长期追求的目标提供了一条新路径:在大量未知信息存在的情况下,让AI依然能够进行有效学习、推理和决策。
数据 https://ataraxosai.github.io;
代码 https://github.com/AtaraxosAI。
文献1,Scalable decision-making for games of imperfect information,https://www.nature.com/articles/s41586-026-11036-y