ARTICLE · 1116092
大西洋月刊:生成式AI是一场工程灾难
生成式AI是一场工程灾难
作者:Alex Reisner | 日期:2026-07-14 | 来源:The Atlantic
一个效率低得惊人的万亿美元项目
Mario Tama / Getty
AI公司正手忙脚乱地维持系统运转,账单却要我们所有人来付。ChatGPT、Claude这类大语言模型极其消耗资源,科技公司可能已经买走了全球70%的高端计算机内存,造成短缺。内存和存储的价格随之飞涨:两年前我为报道工作买的硬盘每块350美元,两周前再查已涨到800美元,如今更是断货了。部分笔记本电脑涨价高达50%,低价电脑受冲击最重。有预测认为,价格亲民的入门级电脑可能“到2028年消失”。而这场内存短缺,预计还会持续数年。
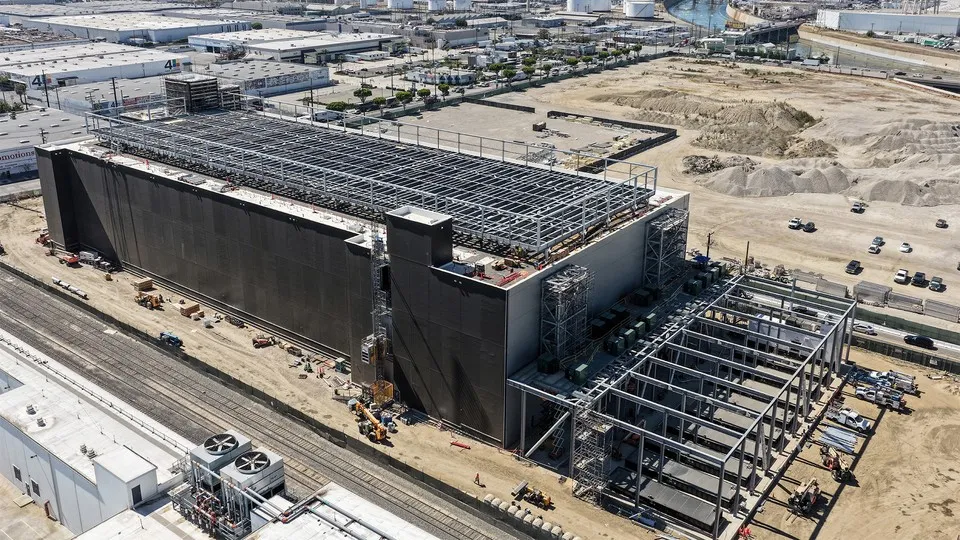
这些内存都被装进了数据中心,科技公司正以惊人的速度扩建,计划在未来几年把美国数据中心的总容量扩大到原来的八倍。这些园区的用电需求已经大到什么地步?有些公司开始改装喷气发动机来给它们供电。
问题并不仅仅在于AI部署得有多广、多快。其他计算机技术也经历过同样惊人的扩张,却没有引发如此剧烈的用电激增或元器件短缺:视频和音乐如今在全球流式传输,每天占用的网络流量以太字节计;智能手机热潮带来了数十亿台设备,日夜传输着海量数据;数十亿台家用设备接入了物联网;各行各业也把业务搬上了云软件——而云并不在天上,它就在,没错,数据中心里。
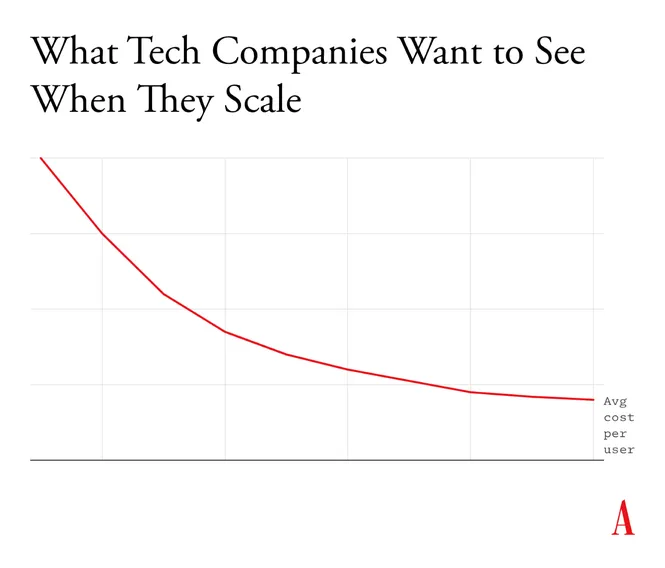
用行业自己的行话说,生成式AI的问题在于它不具备可扩展性(scale)。用户从一千增长到一百万,成本会如何变化,是风险投资人评估初创公司时的关键。他们想看到的是:每新增一个用户,成本就下降一点,这样公司才撑得起数百万用户,利润也越滚越多。要做到这一点,部分要靠对计算机系统的精细工程——让系统能高效地承载越来越多想发照片、叫Uber、听歌的用户。
而生成式AI恰恰没有完成这项打造高效、可扩展系统的工作。更糟的是,模型还在不断变大:据独立估算,参数规模已从2020年的1750亿膨胀到今天的1万亿以上(Claude、ChatGPT等产品背后的模型真实尺寸对外保密)。「大语言模型」的「大」,本不该成为卖点。但行业观察到,更大的模型往往胜过更小的模型,于是生出一种对「扩展定律」(scaling laws)近乎图腾的信仰——只要把模型做得更大,任何问题都能迎刃而解。OpenAI CEO萨姆·奥尔特曼2025年9月在博客上写道:“也许有了10吉瓦的算力,AI就能想出治愈癌症的办法。”
然而回报正在递减。模型越大,每个新增参数带来的改进越小;要维持稳定的进步,就只能以更快的速度把模型做得更大。我问过几位AI研究者:能举出其他扩展性这么糟糕的现实软件吗?他们一个也想不出来。就算跳出软件行业,也很难找到类似的例子——要知道,让灯泡、汽车、服装变得如此便宜的,正是规模经济这条原理。无论用经济标准还是工程标准衡量,生成式AI都可能是有史以来部署过的最糟糕的技术。
但如今这条臃肿的路线背后压着巨额投资,愿意改变的人恐怕不多。OpenAI联合创始人、前首席科学家伊利亚·苏茨克维在2025年11月的一次采访中说,公司选择蛮力路线,“是因为它提供了一种风险极低的资源投入方式”。在他看来,投资那些需要重新设计产品的研究要难得多——毕竟这些产品眼下正撑起万亿美元的估值。怀疑我们身处AI泡沫的人则指出:这些公司的盈利能力至今仍是个悬而未决的问题,很大程度上正是因为这项技术成本高、效率低。
效率是计算机科学的核心原则。本科生入门时最早学到的道理之一就是:写个程序给50个单词排序,很容易;可如果把5000万个单词丢给它,程序多半会内存耗尽,或者跑上几个小时。计算机科学的很大一部分,就是学习各种巧妙的编码技巧来避免这种情况。其中许多技巧利用了数据中的重复模式:输入越多,处理每个新增比特所需的时间和内存反而越少。现代智能手机和电脑之所以既强大又便宜,这种效率正是原因之一。这叫对数级(logarithmic)扩展,画成曲线是这样:
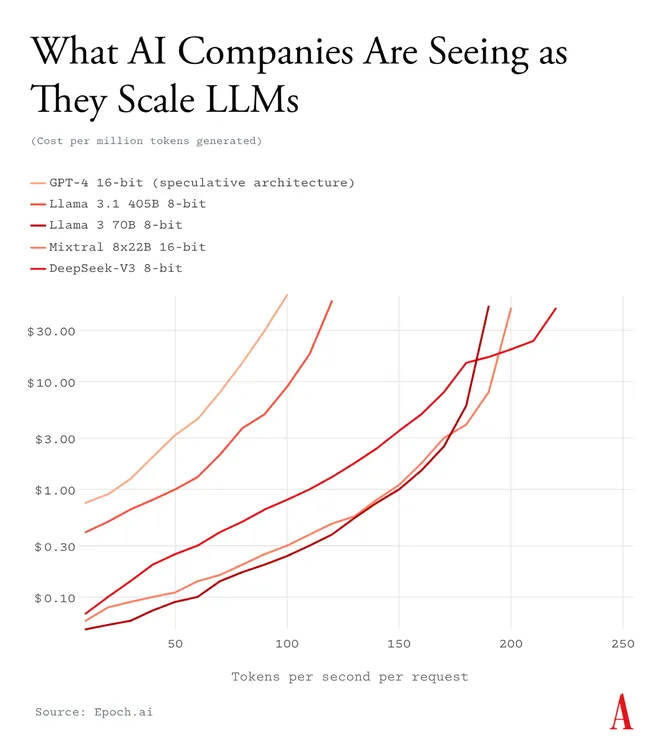
大语言模型并不按对数级扩展。输入的词越多,它们就越慢、越耗内存——时间和资源消耗的增长,比输入的增长还要快。用术语说,大语言模型是平方级(quadratic)扩展。任何计算机系的学生都知道,这非常糟糕。
Epoch AI是一家专门测算AI模型运营成本的机构。它去年发布过一张图,此处经授权转载。图中展示了几个公开的AI模型在服务更多token——也就是用户输入给聊天机器人的文字——时,成本如何呈指数级攀升。
AI并非只能这样造。传统上,AI的目标是用模拟人类思维过程的方式解决问题:研究者观察自己的思考,再试着把思维习惯写成代码。这条路如今基本被抛弃了,部分原因是人类思维的规则难以辨识、难以言说;但它确实有个好处——消耗的资源和数据要少得多。
今天的AI路线不再试图描述人类思维的规则,而是丢给计算机数百万个例子,让它去模仿。例子够多,正是大模型生成语言、图像和音乐时胜过小模型的原因之一——可借鉴的素材更多。有些研究者想找回那条更高效的旧路线,与今天的路线结合起来;但到目前为止,这些项目获得的关注和资金,远不及那些驱动聊天机器人的模型。
聊天机器人公司心里清楚,自己的产品效率低下。一些公司找到了改进性能的技术,但收效甚微。偶尔有公司宣称实现了突破——Anthropic CEO达里奥·阿莫代称之为「算力倍增器」(compute multipliers)——但这类说法往往语焉不详,也没有证据表明平方级扩展、模型尺寸爆炸这些基本问题已经被攻克。(我就此向Anthropic求证,对方拒绝置评。)
也有研究者在开发极小模型,所需的数据和算力都少得多。微软的AI研究者亚历克西娅·乔利科尔-马蒂诺就独立设计过这样一个模型。我采访她,问起行业的蛮力路线,她说:“这有点疯狂。到了一定程度,你必须学会更高效一点。”
去年,乔利科尔-马蒂诺凭一篇关于「微型递归模型」(tiny recursive model)的论文赢得了5万美元奖金;这种模型不需要消耗海量算力。她写道:“要在困难任务上取得成功,就必须依靠某家大公司耗资数百万美元训练的巨型基础模型——这种想法是个陷阱。”她的模型并不能替代大语言模型:它是为解决生物学、电气工程等领域的逻辑问题而设计的,并不生成语言;但眼下那些由庞大得多的AI模型承担的任务,有一些它也能完成。
然而我们似乎已经被大语言模型困住了,这大概要归因于它们凶猛的营销攻势。不管你愿不愿意,它们正被塞进一切东西里。2024和2025年,它们先后被整合进Windows和MacOS——这意味着,运行一台基础的个人电脑都需要更多算力。为了迎接新的AI功能,厂商也在给智能手机升级硬件。Adobe Photoshop、Microsoft Word这类常用软件同样塞进了低效的AI,电脑必须更强,才跑得动这些软件。
更糟的是,电脑本身的进步速度已大不如前。自20世纪50年代以来,厂商一直在把微芯片造得更快、更小、更便宜,这个趋势俗称摩尔定律。但这几年,元器件已经小到撞上了分子层面的极限,再也难以缩小,进步随之显著放缓。
元器件缩不下去了,厂商便把精力转向为AI量身定制的新硬件。这确实带来了一些零星的性能提升,但远远跟不上AI需求增长的指数曲线。
说到底,对于科技行业里那些相信自己正在复制智能本身的人来说,低效也许根本无足轻重。硅谷的许多人怀有一种近乎宗教的信念:大语言模型中可能涌现出某种类似心智的东西——尽管这种软件终究只是统计式的语言生成程序,尽管它记不住基本事实、缺乏常识,与生物大脑毫无相似之处。就连AI「教父」之一的杨立昆(Yann LeCun)最近也对《纽约时报》说:“大语言模型不是通往超级智能、甚至不是通往人类水平智能的道路。”但AI的神话诱惑太强,许多工程师觉得,什么都不该挡他们的路——哪怕是编写高效软件这项基本功。
Alex Reisner是The Atlantic的专职撰稿人。
原文:https://www.theatlantic.com/technology/2026/07/generative-ai-engineering-disaster/687901/