ARTICLE · 1124196
AI 投入是泡沫吗?从 Capex 到 Token 消费
摘要
本文尝试从算力投资能否被用户有效消费的视角,回答 AI 投入的回报问题。在供给与用户假设下,普通对话难以消化巨量产能。
随着智能进一步提升,Agent 完整执行复杂任务,交付短结果实现规模化,届时或能逐步覆盖当年投入。企业端仍是主要收入来源。
Capex 支出:九家主要运营商年度资本开支预计由2026年约9,500亿美元增至2028年约1.66万亿美元;2030年基准约1.66万亿、乐观约1.91万亿美元。 相当于谷歌、亚马逊和微软合计收入的约1.2倍,或全球GDP的约1.3%—1.5%。 Token 产能:2026年的理论Token产能已远超普通用户能消费的范畴。 基准全年产能约0.26 × 10^18输出Token,对应个人端每名日活用户每日约35万Token,为历史ChatGPT文字对话用量估算值的约38倍;全部阅读需18小时。 人均消费:2030年Token产能可被消费的前提是智能进一步的提升,以完成复杂的过程,交付精准简单的结果。 基准产能约1.41 × 10^18输出Token,对应企业每名活跃员工每工作日约570万Token、个人每名日活用户每日约58万—116万。按企业2小时、个人30分钟的阅读预算,交付内容需分别压缩至约3.8万、9,500 Token,即总输出的约1/150、1/60—1/120。 收入:产能被消费后,2030年每百万输出Token需贡献约1.05美元综合收入才可覆盖当年基础设施支出。对应企业每名活跃员工每年约1,490美元、个人每名日活用户约220—440美元。个人用户侧目标差距巨大,企业恐需承担更多收入压力。以年人工成本约6万美元为例,企业需节省约2.5%的人工成本;按50%的收益兑现率测算,则需至少约5%的生产率提升。
一、资本开支:2028年年度投入预计约1.66万亿美元
九家主要算力运营商2025年资本开支合计约4,900亿美元,2026年预计约9,500亿美元;我们估计2027年增至约1.49万亿美元,2028年增至约1.66万亿美元,相当于谷歌、亚马逊和微软合计年收入的约1.1倍。覆盖公司包括亚马逊、Alphabet、微软、Meta、甲骨文、CoreWeave、Nebius、SpaceX和IREN。
2029—2030年,基准情景假设年度投入维持约1.66万亿美元;乐观情景假设继续增长,分别达到约1.79万亿、1.91万亿美元。两种情景均持续新增投资,2030年投入相当于2026年的约1.7—2.0倍。
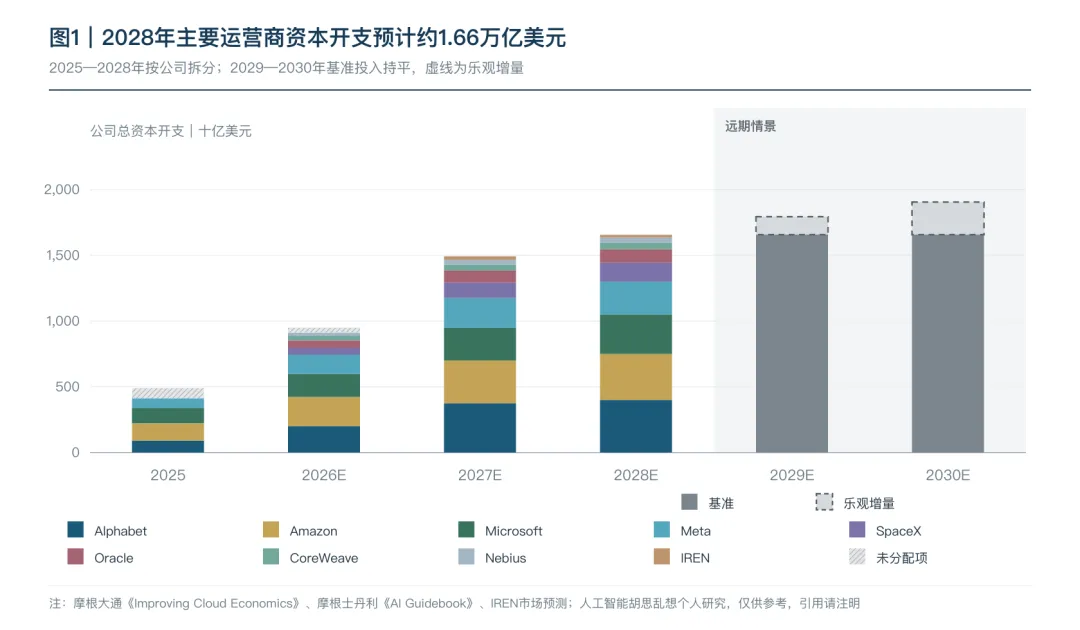
我们假设75%的资本开支用于AI相关项目,对应2028年约1.24万亿美元、2030年约1.24万亿—1.43万亿美元,并以此测算后续算力供给。
二、投资与Token产能
我们将AI资本开支折算为B300等效卡,再按投产、退役、推理分配与利用率测算年度Token产能。一张等效卡以GB300 NVL72机柜中的一颗B300 GPU为标准。
AI资本开支 → B300等效卡 → 全年平均在役卡 → 有效推理卡时 → 年度输出Token。
基于大摩的估算,1GW数据中心对应约390亿美元投入,等效约41万张B300。
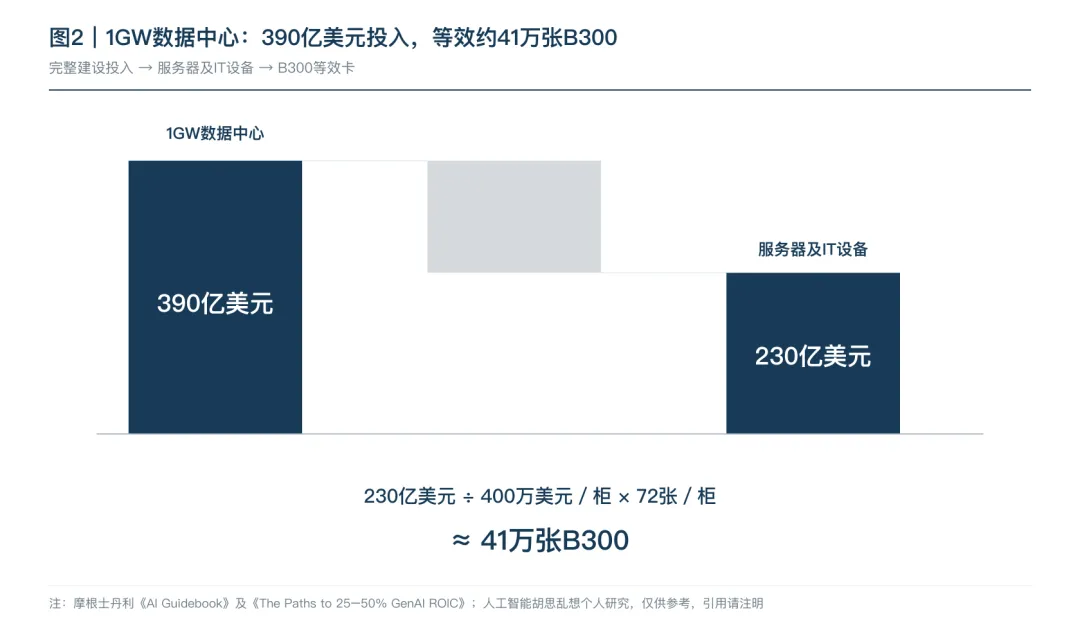
我们采用摩根士丹利的标准项目假设:约230亿美元用于服务器、网络等IT设备,约160亿美元用于机房、供电及配套。按每柜约400万美元、72颗GPU粗算,IT投入对应约41万张B300,与报告配置估计在数量级上相符。
每张B300等效卡分摊约9.5万美元建设资本,每1亿美元AI资本开支对应约1,050张等效卡。每卡金额包含约5.6万美元IT设备投入和约3.9万美元机房及配套投入,代表完整项目的资本分摊。
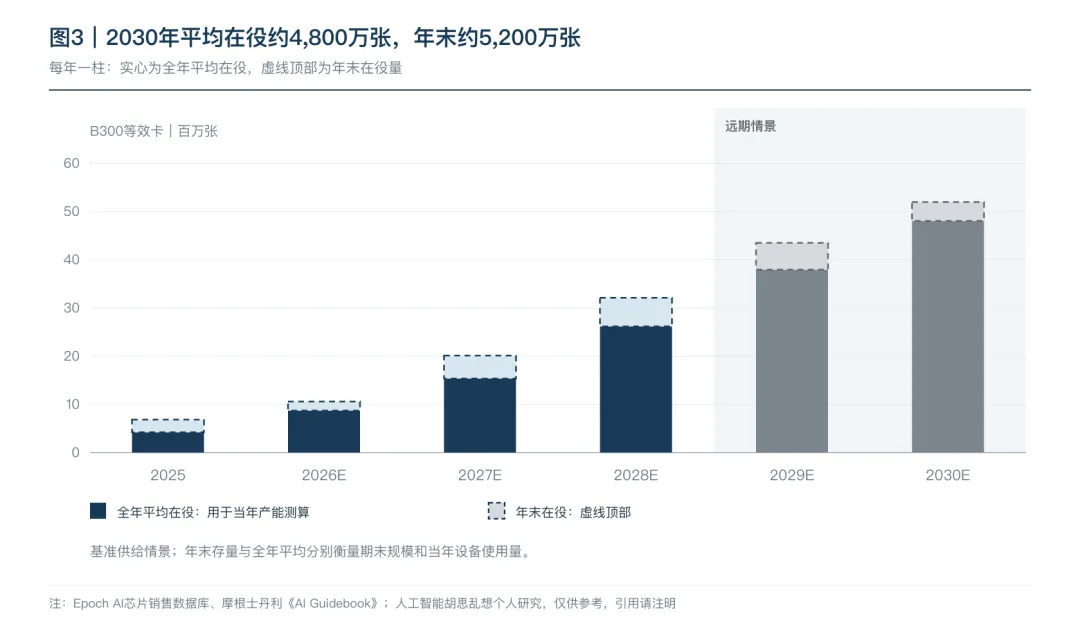
我们估算2025年末存量约为680万张B300吞吐等效卡。估算基于Epoch AI累计芯片交付数据及跨架构吞吐折算,并将交付视为投产。
2026年起,我们假设新增投资50%在当年投产、50%在次年投产;新投产设备当年平均运行半年,芯片使用五年后退役。由此测算,全年平均在役等效卡由2026年约870万张增至2030年约4,800万张。年末在役量反映期末设备规模,全年平均在役量用于计算当年产能。
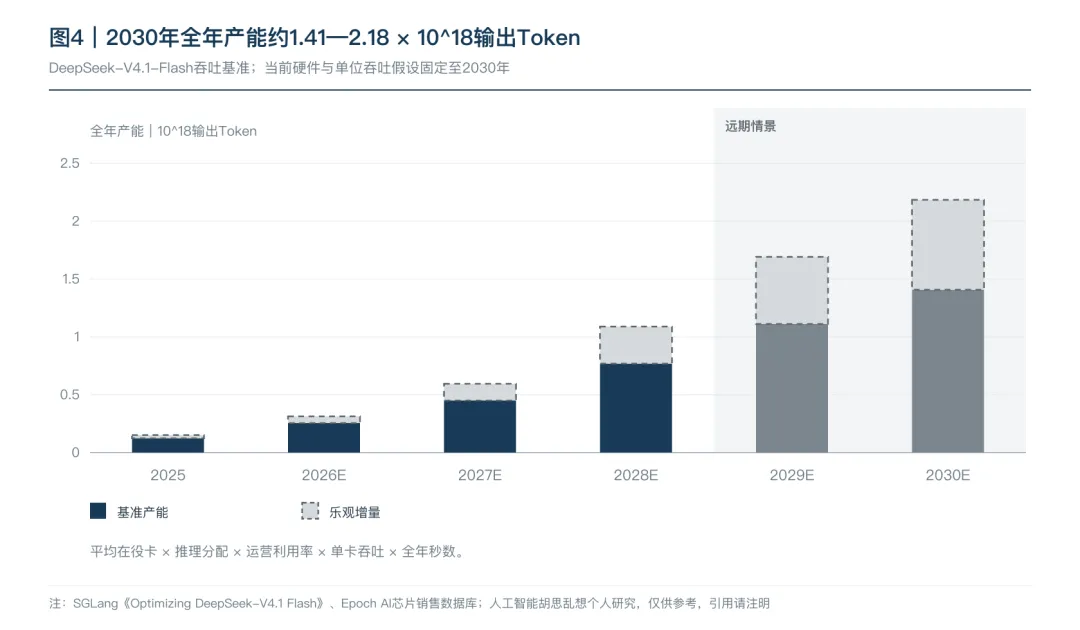
单卡吞吐基准为DeepSeek‑V4.1‑Flash每卡约2,064输出Token/秒。SGLang团队在4张GB300、每请求4,096输入/1,024输出Token、64路并发下报告该端到端聚合吞吐。
全年输出产能 = 全年平均在役等效卡 × 推理分配比例 × 运营利用率 × 单卡聚合输出吞吐 × 全年秒数。
基准情景假设下,60%的卡时用于推理、运营利用率为75%,全年产能由2026年约0.26 × 10^18输出Token,增至2028年约0.77 × 10^18、2030年约1.41 × 10^18。
乐观情景中,推理分配逐步升至80%、运营利用率为85%,结合更高资本投入,2030年产能约为2.18 × 10^18输出Token。
技术进步为远期产能提供上修空间。我们将当前硬件与单卡吞吐固定至2030年是保守的预测。在任务长度、交付质量和响应速度相同的条件下,硬件、模型及推理软件的效率提升将提高单位资本产出;更长上下文、更复杂模型及更高可靠性要求可能抵消部分收益。
三、Token消耗:从对话转向任务
我们以基准产能为目标用量,检验企业与个人需要承担的任务量及阅读负荷。企业按活跃员工和每年250个工作日分摊,个人按全年平均日活用户(DAU)天数分摊。供给端沿用60%推理分配和75%运营利用率。
年度输出Token → 企业/个人分配 → 人均每日用量 → 交付内容与阅读时间。
2026年:普通对话难以承接目标产能
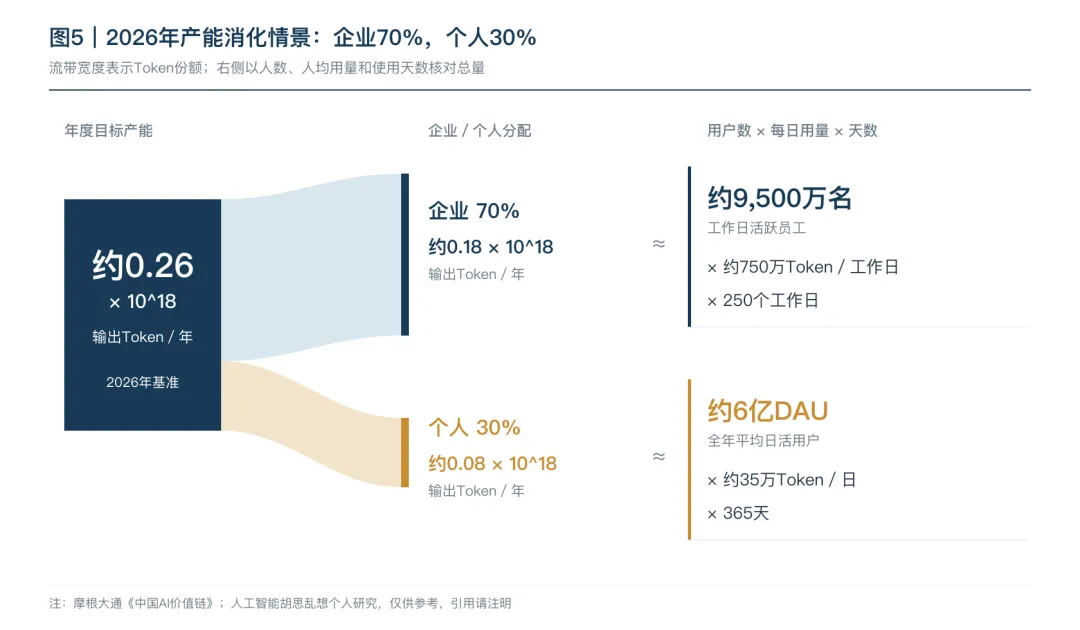
我们将目标产能按企业70%、个人30%分配。该比例参照摩根大通对中国2030年Token结构的预测,并作为全球情景假设。
企业端以约9.5亿名管理、专业、技术及文职人员为潜在人群,假设工作日活跃渗透率为10%,对应约9,500万名活跃员工。个人端以ChatGPT超过10亿周活用户为起点,假设DAU/周活用户为40%,再乘以1.5倍跨平台系数,得到约6亿全球GenAI日活用户。人口、活跃率及跨平台换算均含研究假设。
消化2026年约0.26 × 10^18输出Token,需要企业每名活跃员工每工作日约750万Token、个人每名DAU每日约35万Token。两者分别按年度产能 × 70% ÷ 9,500万人 ÷ 250天,以及年度产能 × 30% ÷ 6亿人 ÷ 365天计算。
个人端目标是历史ChatGPT文字对话用量估算值的约38倍。OpenAI研究披露,2025年7月约7亿周活用户每周发送约180亿条消息。按40%的DAU/周活用户、每会话3条用户消息折算,每名DAU每日约9.2条消息、3.1个会话;再假设每条回复1,000输出Token,对应每日约9,200 Token。
个人端每日约35万输出Token,全部阅读约需18小时。我们采用约317 Token/分钟的英文阅读速度估算;即使在8亿DAU的敏感性情景下,每人每日约26万Token,仍需阅读约14小时。
超出用量必须被压缩进过程Token,消费者需要的是言简意赅、准确的输出,这要求更高的普惠智能Agent通过多次调用完成检索、分析、执行和核验,向用户交付结论、异常及待决策事项。近期爆火的Jev的结构化决策输出提供了简短交付的形态参考。后台计算的价值需由任务成功率、节省时间和执行结果验证。
2030年:用户扩张难抵消过剩过程产能,输出结构及质量需要提升
企业端工作日活跃渗透率假设由2026年的10%升至2030年的70%,每年提高15个百分点。潜在办公人群按每年1%增长,由约9.5亿增至约9.9亿,对应活跃员工由约9,500万增至约6.9亿。
个人端设定2030年10亿和20亿DAU两种情景。以2026年约6亿全年平均DAU为起点,分别对应约14%和35%的年复合增长,覆盖独立AI应用及产品内嵌Agent的个人使用。
企业/个人Token分配维持70%/30%。2028年企业每人每工作日需消耗约555万输出Token,个人每人每日约58万—81万;2030年分别为约570万、58万—116万。用户扩张分摊了用量,持续新增的算力仍需更多后台任务承接。
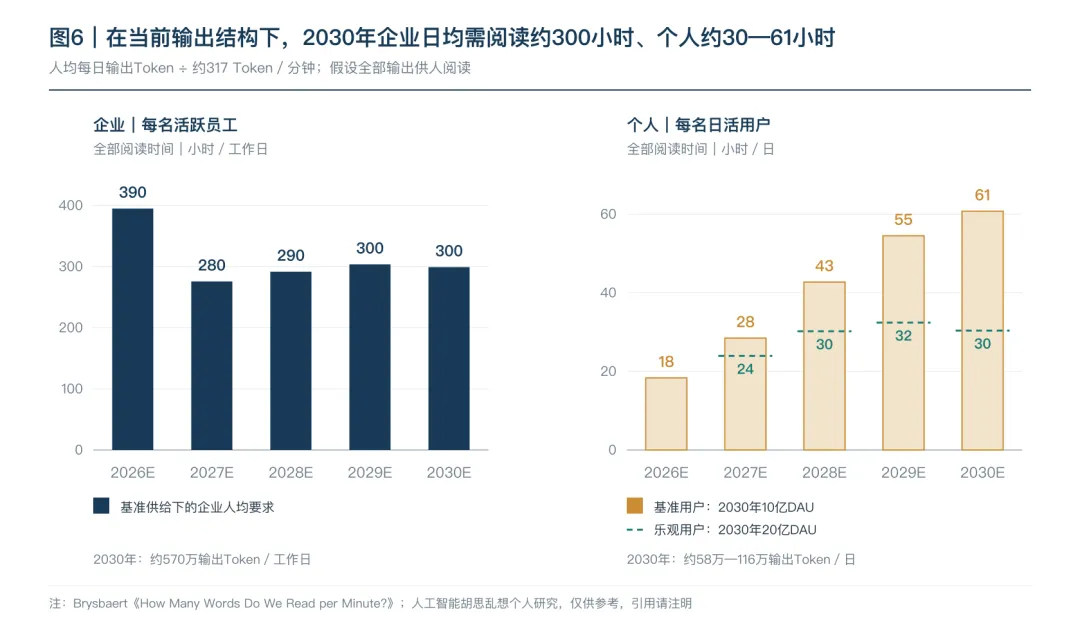
全部阅读时间 = 人均每日输出Token ÷ 阅读速度。按约317 Token/分钟计算,2028年企业端约需290小时、个人端约30—43小时;2030年分别约需300小时、30—61小时。人均用量远超阅读预算,产能消化需要将更多计算用于后台执行。
技术要求:扩大自主执行,压缩交付内容
我们设定企业每名活跃员工每工作日2小时、个人每名日活用户每日30分钟的阅读预算。企业预算参照知识工作者每日约1.8—2.4小时的邮件处理量级。
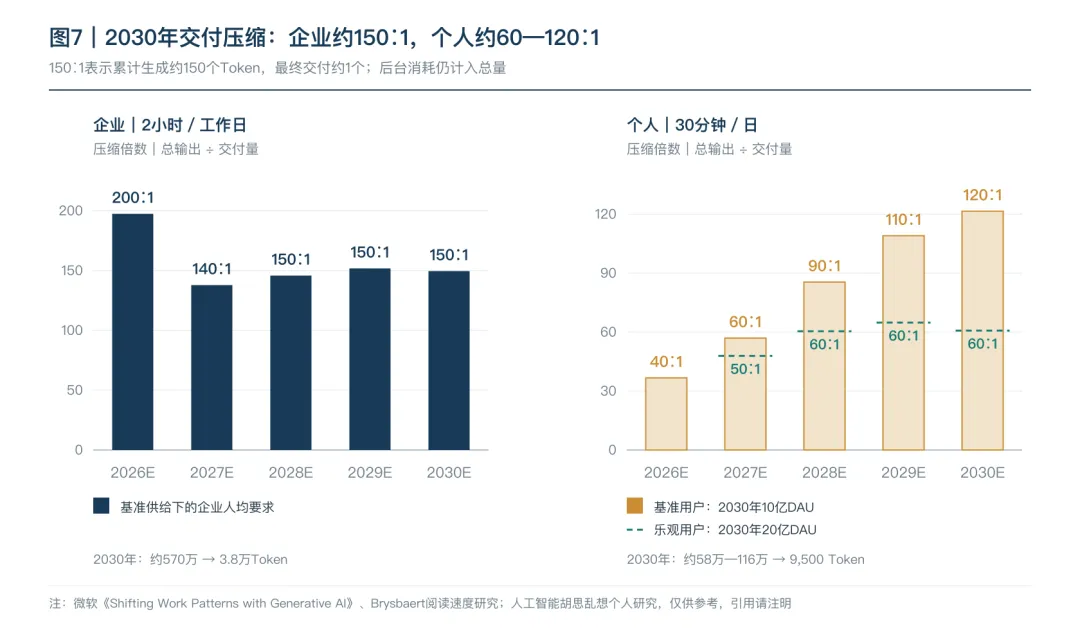
2030年企业每人每工作日约570万输出Token,需压缩至约3.8万Token以内,才能在2小时内读完。交付量约为总输出的1/150。个人每日约58万—116万输出Token,需压缩至约9,500 Token以内,即总输出的约1/60—1/120,才能在30分钟内读完。
所需压缩倍数 = 人均每日总输出Token ÷ 阅读预算内可读的Token。150∶1意味着模型在任务过程中累计生成约150个Token,最终向用户交付约1个Token。后台过程仍计入总消耗,第四章据此测算收入要求。
智能提升的核心,是扩大能够可靠委托的任务范围,并降低用户监督负担。模型需要完成更多执行与校验,筛出用户必须判断的信息。交付压缩应保留关键结论、风险和核验依据,使新增计算转化为可验证的任务成果。
四、Token定价与收入要求
2030年目标用量实现后,每百万输出Token需贡献约1.05美元综合收入,才能覆盖当年基础设施支出。企业端以任务收益支撑付费,个人端由订阅、广告及交易收入共同承担。
单位收入门槛:2030年降至约1.05美元
每百万输出Token所需收入 =(当年AI相关CapEx + 数据中心现金Opex)÷ 当年消耗的全部输出Token × 100万。
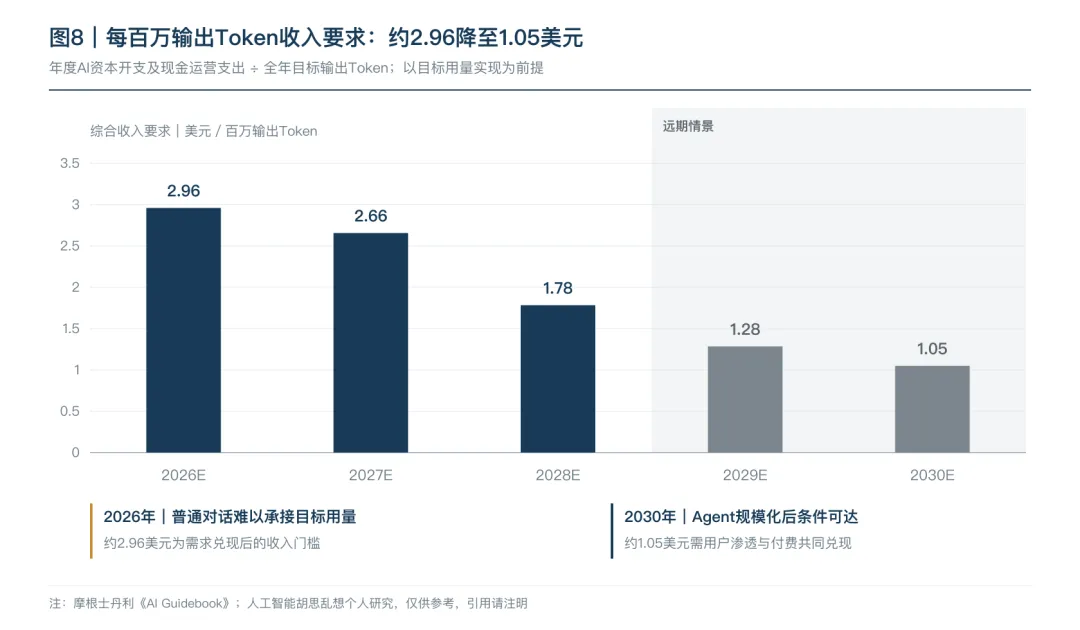
每百万输出Token的收入要求由2026年约2.96美元,降至2028年约1.78美元、2030年约1.05美元。2030年约1.48万亿美元基础设施支出由约1.41 × 10^18输出Token分摊。在役资产积累、年度投入趋稳,推动单位收入要求下降。
2026年的2.96美元显然无法适配海量用户不付费现状;2030年的1.05美元依赖技术进步下Agent规模化落地。模型需可靠完成任务、压缩交付内容,并创造足以支撑付费的价值。
上述金额衡量输入、输出及服务收费形成的综合收入,覆盖年度基础设施现金支出,而非累计投资回报。
人均年AI消费:企业约1,490美元,个人约220—440美元
我们沿用企业70%、个人30%的分摊假设:所需人均年AI消费 = 年度支出 × 分配比例 ÷ 年均活跃用户数。AI消费包含直接付费及商户等间接付费。
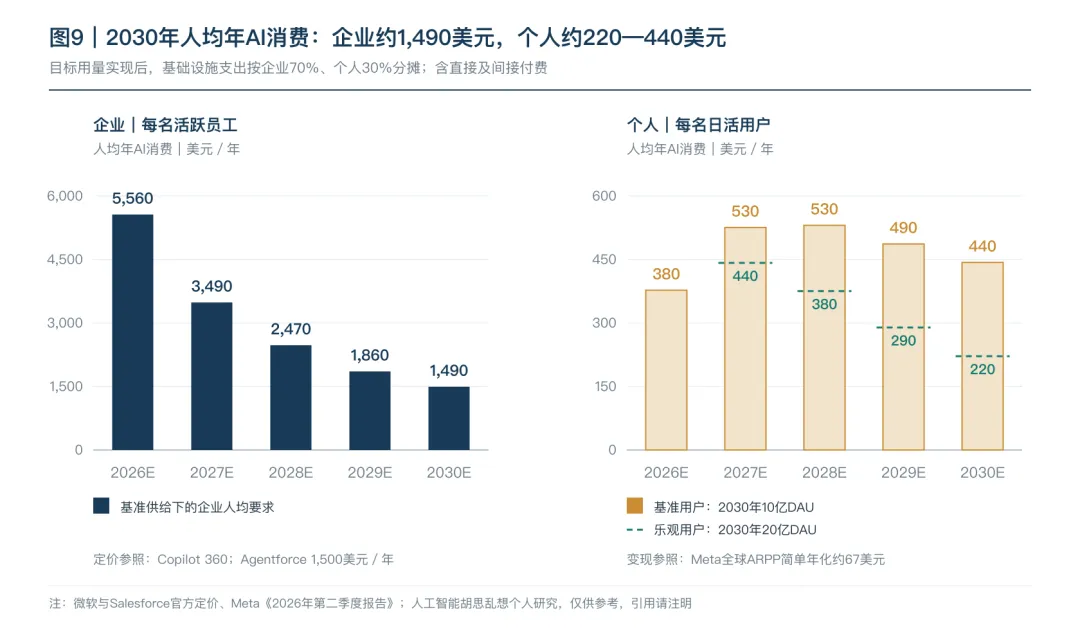
2030年企业端约6.9亿名活跃员工,每人需贡献约1,490美元/年,折合约125美元/月。个人端20亿DAU对应约220美元/年,10亿DAU对应约440美元/年,折合每月约18—37美元。
企业端:付费取决于可兑现的效率提升
约1,490美元的人均年AI消费,接近专项Agent产品的定价水平。Microsoft 365 Copilot美国标价约360美元/年,Salesforce Agentforce销售、服务等附加产品约1,500美元/年。两者用于比较客户预算,功能、用量及成本覆盖范围各异。
假设年人工成本约6万美元、50%的效率收益可兑现,约5%的生产率提升对应约1,500美元年收益。纳入部署、监督及返工成本后,所需收益应进一步提高。
摩根大通对317家亚太公司的调查显示,受访企业估计过去12个月生产率改善约4%,未来12个月预计约5.8%,若该数据属实,5%的生产率提升或可实现。企业付费的基础,是将效率改善转化为增量收入或实际节省。
个人端:订阅之外,需要交易与广告收入
在低付费渗透率下,订阅收入难以覆盖每名DAU约220—440美元的年收入要求。假设平均付费用户数相当于平均DAU的10%,每人每月支付20美元,可贡献约24美元/DAU/年,仍有约200—420美元缺口。
商户付费取决于消费意图向交易的转化。摩根士丹利对2030年中国消费AI的收入预测中,约99%来自广告和交易佣金。 作为单平台参照,Meta 2026年第二季度全球每活跃用户收入简单年化约67美元,相当于本研究个人端收入要求的15%—30%。
按5%净佣金贡献率测算,填补订阅缺口需要每名DAU每年约4,000—8,400美元可归因于AI的交易额。在该假设下,C端挑战巨大,企业或许需要占据超过70%以上的token贡献;若企业可以贡献90%的Token消耗,个人则仅需74-150美元年平均付费,对应每年1500-3000美元的AI相关交易。
C端需要Agent全面进入购物、预订和服务执行,并将任务成果转化为收入,再辅助其他盈利模式,或可实现。短期来个人端的付费潜力远弱于企业。
结论
AI投入回报更依赖企业任务落地;智能提升需扩大可靠执行范围,并将企业交付内容压缩至任务总输出的约1/150。按基准测算,2030年目标用量实现后,每百万输出Token约1.05美元的综合收入,可覆盖当年基础设施支出。在企业贡献90%的收入情景下,企业每名活跃员工年AI消费约1,920美元,个人约74—150美元(10亿—20亿DAU),后者包含直接及间接付费。 若企业贡献收入比例下降,C端个人用户变现压力巨大