ARTICLE · 1133158
爱可可AI前沿推介(10.7)
LG - 机器学习 CV - 计算机视觉 CL - 计算与语言 AI - 人工智能
1、[AI] GitSwarm:Decentralized Compounding Inference
2、[LG] Priced Guidance:Can Language Models Generate Future Research Ideas?
3、[AI] Game Plan:What AI can do for Football, and What Football can do for AI
4、[LG] Retrieval-Augmented Reinforcement Learning
5、[LG] Base Models Can Reason By Taking a Cue From Training Data
摘要:去中心化复利推理、语言模型能否产出具有前瞻性的研究设想、AI 如何赋能足球足球又如何驱动AI进化、检索增强强化学习、基座模型如何通过借鉴训练数据中的线索实现推理
1、[AI] GitSwarm: Decentralized Compounding Inference
V Shah, A Samanta, P Dahal, M Plekhanov,…
[Meta Superintelligence Labs]
GitSwarm:去中心化复利推理
要点:
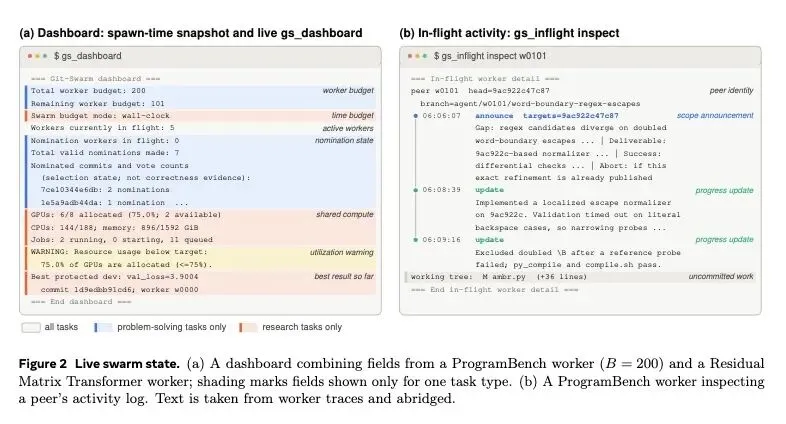
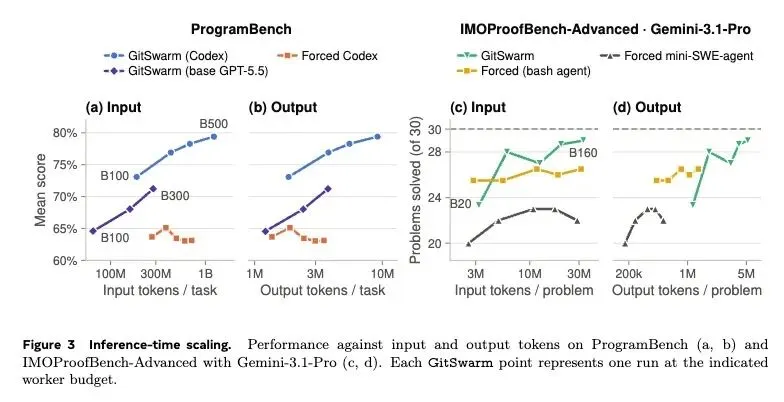
挑战了当前通过独立采样或线性轨迹来扩展推理计算的趋势,引入了“复利推理”(compounding inference)概念,使中间工作(包括失败的尝试)在独立的智能体回合中得以持久化保存和复用。 利用共享的、支持分支的Git仓库作为持久化记忆,允许同质的、异步的智能体在没有中央规划者的情况下自主决定任务方向。 关于负面结果的反直觉发现:不成功的实验具有极高的价值。在AI架构研究(如残差矩阵Transformer和NanoChat)中,最初失败的想法后来被不同的智能体重新找回、修改,并整合成了最终的获胜架构。 引入了新颖的双重依赖追踪系统:物理Git父节点(代码的起点)和显式的语义依赖(informed_by=),允许智能体在不进行复杂代码合并的情况下,跨竞争分支融合洞见。 关于特定领域知识积累模式的高信息熵洞见:编程和数学证明的知识积累方式截然不同。程序重建会创建深度、高度合成的图(多个分支的后期整合),而数学证明工作者主要利用共享历史来进行候选方案的验证和比较,而不是去扩展单一的证明血统。 展示了涌现的自适应协调能力:在没有分配固定角色(如“程序员”或“审查员”)的情况下,智能体会自然地转换其工作组合。在编程任务中,它们会持续构建和合成直到结束;在数学证明任务中,它们会迅速转向评估和对现有候选方案进行投票。 使用前沿模型(GPT-5.5, Gemini-3.1-Pro)取得了SOTA级别的结果:在IMOProofBench-Advanced上解决了30/30的问题,在ProgramBench上达到79.4%的准确率(相比之下,强制延续基准为65.1%)。 成功进行了自主的、基于GPU的持续机器学习架构研究,在相同的训练预算下,改善了三种不同的Transformer架构(残差矩阵Transformer、循环Transformer、NanoChat)的保留测试集损失。
主旨: 本文旨在解决在长周期的复杂问题解决和科学研究中,如何让大语言模型的推理期计算(inference-time computation)产生“复利”的问题。文章提出,先前的部分解决方案、实验发现甚至失败的尝试不应随着单次生成的结束而丢失,而应通过GitSwarm系统(一个基于Git的去中心化协作系统)被持久化保存,从而让后续的智能体能够在此基础上进行检查、扩展、组合或质疑。
创新:
机制创新:将Git的版本控制系统创新性地转变为大模型多智能体协作的共享结构化内存,实现了分支化(支持并行探索不同方向)和持久化。 依赖追踪创新:解耦了物理代码继承(Git parent)与语义认知继承(informed_by=),智能体可以基于一个分支编写代码,但明确声明受到了其他分支(甚至失败分支)结论的启发。 协作范式创新:摒弃了目前流行的“中央大脑分配任务”或“固定角色设定”范式,采用去中心化的异步读取、自主决策和多数投票(Decentralized Readout)机制。
贡献:
理论贡献:提出了“复利推理”(Compounding Inference)的新范式,为扩展推理期算力(Scaling Inference Compute)提供了除了重复采样和长思维链之外的第三种路径——即跨回合的计算积累。 系统贡献:开发并开源了GitSwarm系统,该系统能够自主管理GPU资源、执行代码验证,并支持多智能体异步协作。 实证贡献:在多个极具挑战性的真实任务上(IMO级别的数学证明、代码库重建、真实的神经网络架构搜索)进行了全面评估,并详细量化了智能体对历史伪影(Artifacts)的消费率和引用网络,证明了“积累效应”确实存在。
提升:
复杂编程任务:在ProgramBench上,在同等算力预算下,相比于不断强制续写的单一Codex智能体(65.12%),GitSwarm将平均得分提升至79.39%。 顶级数学推理:在IMOProofBench-Advanced上,一次运行即可解决全部30个问题,远超传统的单智能体或简单的Best-of-N基线。 自动化AI研究:在残差矩阵Transformer任务中,在相同的1.3B token训练预算下,将验证集损失从参考基线的3.147降低至2.890,并且发现了传统单智能体无法发现的复杂架构修改(如跨头路由和时间记忆混合)。
不足:
算力与Token开销巨大:随着Git历史的增长,智能体需要消耗大量的Input Tokens来阅读之前的提交和实验记录,存在较高的“上下文阅读冗余”成本。 投票机制的局限性:去中心化的多数投票机制虽然在代码测试中有效,但LLM的投票并不能作为数学正确性的绝对保证,可能存在群体盲从现象。 缺乏细粒度的消融实验:文章展示了整个GitSwarm系统的强大,但对于“持久化”、“分支化”和“语义归因”三个核心特性在全尺寸基准测试中的各自独立贡献,缺乏直接的消融数据。 依赖极高端模型:该系统严重依赖诸如GPT-5.5或Gemini-3.1-Pro等最前沿模型的长上下文理解和复杂指令遵循能力,在较小模型上的表现未知。
心得:
失败是最高效的指路明灯:在传统的LLM采样中,错误的输出会被直接丢弃。但本文在架构搜索实验中揭示了一个极具启发性的现象:许多最终获胜的复杂机制,是由智能体翻阅了早期“失败”的实验记录后,调整了方向或结合了其他机制而取得成功的。这提示我们在设计Agent记忆系统时,必须建立“失败档案库”。 复杂任务不需要硬编码的微观管理:当前的Multi-Agent研究热衷于设计复杂的SOP(标准作业程序)或指挥官角色。GitSwarm证明,只要提供一个透明、可溯源的共享黑板(Git树),同质化的智能体就能根据当前状态自发涌现出合理的劳动分工(如早期倾向于探索,晚期倾向于修复和融合)。过度设计角色反而可能限制了探索的广度。 知识积累的拓扑结构因领域而异:这是一个高度反直觉的发现。我们原以为协作模式是一致的,但实验证明,编程任务的最终代码通常融合了来自整个协作图谱80%以上的历史提交(深度依赖);而数学证明任务中,最终答案的继承树很短,大量的历史工作实际上被用作“验证器”和“陪跑的负面参考”。这意味着未来的AI评估系统不能仅看最终答案的生成路径,而应评估整个思维探索图谱的价值。
一句话总结: 本文提出了一种名为“复利推理”的去中心化协作范式,通过Git仓库持久化保存所有大模型智能体探索的中间产物与失败经验,使得异步智能体能够在长周期任务(如架构搜索和复杂编程)中自主融合跨分支的灵感,证明了智能体的每一次推理计算都可以转化为供后人踩踏的坚实台阶。
Long-horizon problem solving and scientific research require computation to accumulate across successive attempts. Partial solutions, experimental findings, and unsuccessful approaches can inform later work, yet most inference-time computation is organized around individual trajectories or candidates rather than a persistent body of reusable work. We call this paradigm compounding inference: organizing inference-time computation so that intermediate work persists and can be inspected, extended, combined, or challenged by subsequent computation. We instantiate compounding inference in GitSwarm, an asynchronous system where homogeneous agents independently decide how to advance a task while collaborating through structured persistent memory. Agents explore, experiment, verify, refine, and synthesize previous work in a shared, branch-able Git repository. Atomic commits preserve intermediate artifacts, while explicit semantic dependencies record how later contributions build on work across branches. We evaluate GitSwarm on long-horizon problem solving and sustained GPU-backed experimental research. On IMOProofBench-Advanced, GitSwarm solves all 30 problems in one run using GPT-5.5. On ProgramBench, it achieves a 79.4%79.4% mean score, versus 65.1%65.1% for the strongest reported baseline under the stated budget. On three neural architecture research tasks (Residual Matrix Transformer, Looped Transformer, NanoChat), GitSwarm improves upon the starting architectures through successive experimentation. Beyond final performance, we measure whether computation accumulates: on ProgramBench, 94.7%94.7% of contributions are subsequently built upon, while the selected solution's ancestry covers 82−93%82-93% of the contribution graph. These results show that inference-time computation can accumulate across otherwise independent episodes, forming an evolving body of work that subsequent inference can reuse.
https://arxiv.org/abs/2610.04862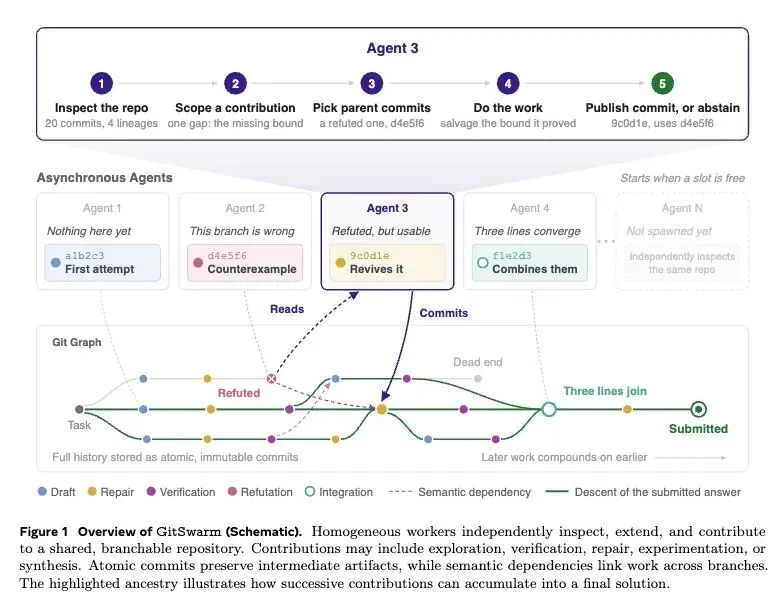
2、[LG] Priced Guidance: Can Language Models Generate Future Research Ideas?
K Wen, T Ma, P Liang
[Stanford University]
定价引导 (Priced Guidance):语言模型能否产出具有前瞻性的研究设想?
要点:
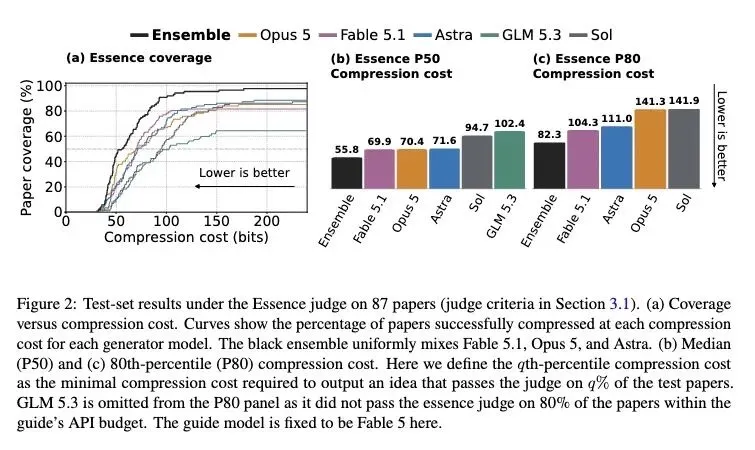
引入了“定价引导”(Priced Guidance)这一全新框架,通过信息压缩的视角而非昂贵的重复采样,来评估语言模型生成未来科研想法的能力。 证明了一个数学下界:如果大模型在预期中需要 K 比特的引导信息才能恢复目标想法,那么它在没有任何引导的情况下自主生成该想法的概率至少为 2^(-K)。 将评估过程构建为一个“二十个问题”的游戏,包含生成器(被测大模型)、引导者(拥有目标论文特权访问权的大模型)和裁判。 生成器提出问题并为可能的答案分配概率分布。引导者选择正确的答案,生成器则根据其分配的概率 p 支付 -log2(p) 比特的成本。 展示了一个极具反直觉的结果:压缩科研想法的“本质”所需的比特数呈指数级少于对摘要进行无损文本压缩的比特数(例如,Fable 5.1 仅需约 70 比特,而 gzip 需要超过 5700 比特)。 在 87 篇近期高质量深度学习论文的核心思想上,评估了五个前沿模型(Opus 5, Fable 5.1, GPT-6 Astra, GPT-5.6 Sol, GLM 5.3)。 揭示了并行推理期扩展对激发灵感极为有效:将 Fable 5.1、Opus 5 和 Astra 进行均匀集成,可将中位压缩成本降至 55.8 比特,使无引导生成的概率下界比单模型提高了约 18000 倍。 强调了单纯增加单一模型的推理强度(串行扩展),在降低压缩成本方面的效果不如集成不同模型。 表明后训练(post-training)能显著提升想法生成能力,例如 GLM-5.3 的表现大幅优于 GLM-5.2(成本从 100.6 比特降至 53.4 比特)。 发现大部分信息成本花费在获取特定的“关键词”概念上(通常通过字母提示),这些概念往往超出了模型最初的假设范围。
主旨: 解决如何科学、量化地评估大语言模型生成全新、未见过的未来科研想法(Research Ideas)的能力这一难题。传统方法依赖人类主观打分或成本极其高昂的盲目采样,本文试图通过衡量“引导模型推导出目标想法所需的额外信息量”来锚定其自主创新的概率。
创新:
极其精妙地将“想法生成”转化为“信息压缩”问题。利用预测与压缩的经典对偶性,模型越容易想到的点子,所需的额外引导比特数越少。 设计了“定价引导”多轮博弈机制,生成器自己为主张分配概率,引导者选择正确路径后,生成器需支付该概率对应的自信息量(负对数)。这种机制不仅量化了信息的价值,还从数学上严格推导出了罕见事件(生成完美idea)的概率下界。
贡献:
理论贡献:提出了 Priced Guidance 定理,在数学上建立了有引导的随机压缩成本与无引导的成功生成概率之间的严格不等式关系。 平台与基准:构建了一个包含生成器、引导者、裁判的自动化代理脚手架(Agent Scaffold),并在 87 篇真实前沿论文上建立了评估基准。 经验与实证:全面测试了当前最顶尖的大模型,量化了它们与真实科研创新的距离,并验证了模型集成、后训练及保留推理历史等策略对提升科研构思能力的具体量化效果。
提升:
评估可行性:将评估极低概率事件(自主生成高质量科研想法)所需的计算成本,从几乎不可能的指数级盲目采样,降低到了可通过一次带引导的树搜索(几十个比特)来完成。 生成概率下界:通过集成多个大模型(Fable 5.1, Opus 5, Astra),将中位压缩成本降低了十几个比特,这在数学上等同于将模型自主生成目标科研想法的概率下界提升了约 18000 倍。 评价维度:相比于逐字压缩文本需要几千比特,该方法证明了提取“科学本质”只需要几十比特,将评价维度从“文本复刻”成功提升到了“科学思想等价”。
不足:
评判作弊风险:依赖 LLM 作为裁判评估想法等价性,这可能导致生成器为了迎合裁判而生成语义模糊、大而化之的内容(Judge Hacking)。 与真实认知的差距:该框架测量的是大模型通过搜索或提示能否“拼凑”出目标想法,但这并不等同于大模型自己“知道”哪些假设在物理世界中是真实的,或者哪些方法在深度学习中真正有效。 脚手架的局限性:当前的生成器脚手架主要基于启发式设计(固定的提问策略、关键词猜测等),远非最优策略,限制了模型发挥更大的潜力,且目前不支持代理进行任意的工具调用。
心得:
预测即压缩的升维打击:把香农信息论和文本压缩的概念,拔高到“思想和科学灵感”的层面,极其震撼。一篇长篇大论的顶级学术论文,其最核心的科学本质对于最聪明的大模型来说,只需要补充不到 60 个比特的信息量即可推导出来。这启示我们,科学创新可能并没有想象中那么神秘,它是一次在高度受限的概率空间中的精准路径选择。 认知多样性碾压单一深度:论文中一个极其反直觉的结论是,让单一模型开启“最高推理努力(Max Effort)”带来的提升,远不如把几个不同的顶尖模型集成起来带来的提升大。这深刻地启示了科研团队的构建:几个不同视角的顶尖学者的交流碰撞(集成),比一个天才在密室里死磕(增加推理深度)更有可能以极小的代价跨越创新鸿沟。 突破稀有事件评估的采样墙:在AI评估领域,要想证明模型能做一件成功率只有百亿分之一的事,传统方法只能跑百亿次。这篇论文利用“全知引导者”强行拉通正确路径,并用模型自己给出的概率来计算“罚款”(比特成本),从而用单次运行就算出了极低概率的下界。这种巧妙的评估范式完全可以平移到大模型的小说创作、复杂定理证明、甚至商业模式推演等任何高难度长逻辑链任务的评估中。
一句话总结: 本文创新性地将科研灵感的生成转化为信息压缩问题,提出了“定价引导”框架,通过计算引导大模型推导出未来真实论文核心思想所需的额外信息比特数,从数学上给出了模型自主产生该创新的概率下界,并震撼性地揭示了:提炼一篇顶级论文的思想本质仅需约60比特的引导,且多模型视角的集成比单模型的深度思考能更高效地打破科学创新的壁垒。
We evaluate language models' capability to generate novel research ideas through the lens of compression. We aim to lower-bound the potentially tiny probability that a language model generates the essence of a future research idea without any hints. Rather than estimate this probability through expensive repeated sampling, our Priced Guidance framework measures the compression cost: how many additional bits of information are needed to guide the model to recover the target idea. We prove that if the model can recover the target idea with at most K bits of guidance in expectation, then it can generate the idea without any guidance with probability at least 2−K2^{-K}. In our framework, the language model, called the generator, can pose a sequence of multiple-choice questions and specify a probability distribution over possible answers. A guide, which is a language model with access to the target idea, selects answers. If a selected answer has prior probability p, the generator pays −log2p-\log_2 p bits. The generator aims to produce an idea that matches the essence of the target idea with minimal cumulative cost. This cumulative cost equals, up to an additive constant, the number of bits of information sent by the guide. Using this methodology, we evaluate five generator LLMs (Opus 5, Fable 5.1, GPT-6 Astra, GPT-5.6 Sol, and GLM 5.3) on the core ideas in 87 recent high-quality deep learning papers and we use LLM as judge to determine whether the generated idea matches the target in terms of the central research object and defining mechanism. Fable 5.1 achieves the lowest median compression cost at 69.9 bits, substantially lower than gzip's median of 5,712 bits for losslessly compressing the summary of the target idea. A uniform ensemble of Fable 5.1, Opus 5, and Astra further reduces the median compression cost to 55.8 bits and improves the generation probability lower bound by 18,000 times.
https://arxiv.org/abs/2610.04976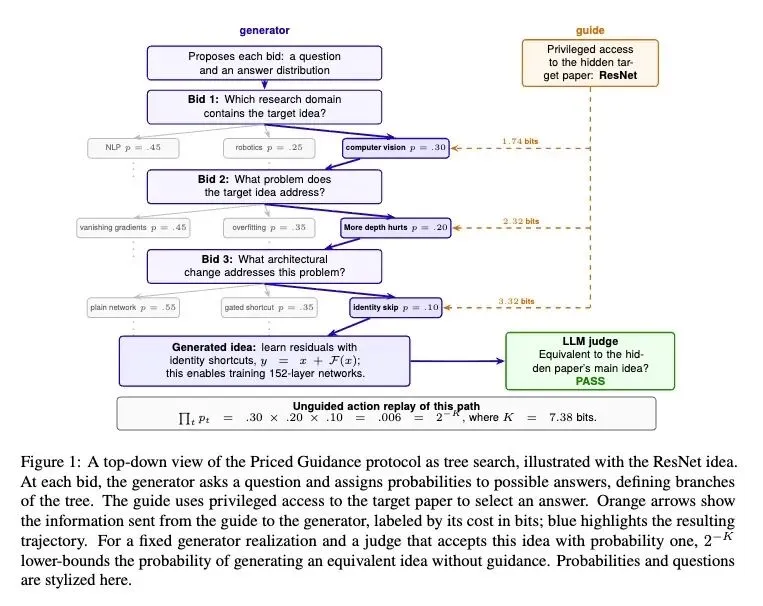
3、[AI] Game Plan: What AI can do for Football, and What Football can do for AI
K Tuyls, S Omidshafiei, P Muller, Z Wang…
[DeepMind]
竞技蓝图:AI 如何赋能足球足球又如何驱动AI进化
要点:
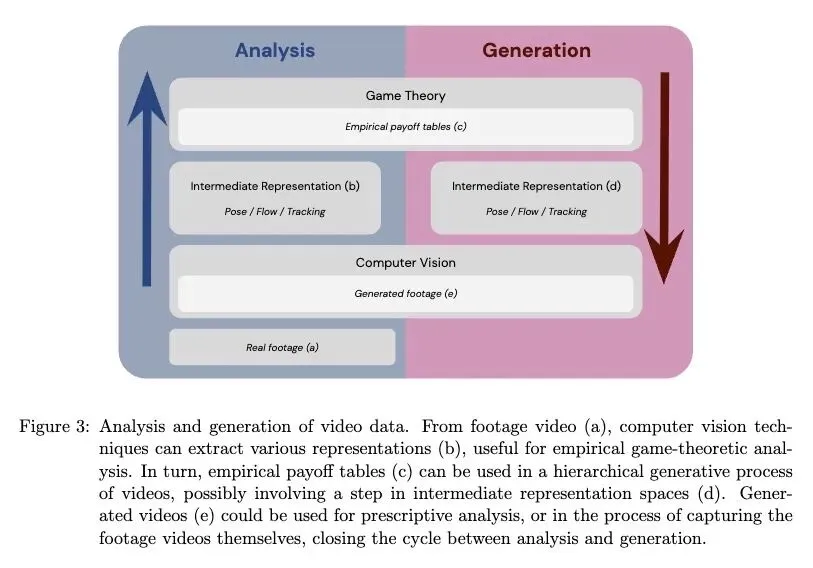
提出了双向互惠的关系:人工智能可以彻底改变足球分析(预测性和处方性分析),而足球则作为一个高度结构化、多智能体、多模态的“微观世界(Microcosm)”,推动基础AI研究的发展。 划定了三个传统孤立的AI领域的交叉研究前沿:统计学习(SL)、计算机视觉(CV)和博弈论(GT)。 构想了该微观世界的终极目标——自动化视频助理教练(AVAC),该系统能够处理原始转播视频,在赛前、赛中和赛后为教练团队提供战术建议。 挑战了对点球的纯生理学认知:通过分析海量数据集(12399次点球),论文证明了经验丰富的球员在数学上克服了惯用脚的偏见,使得左右脚球员在自然/非自然射门方向上的统计学差异趋于消失。 引入了统计学习与博弈论的反直觉融合(前沿1):通过将“球员向量”(Player Vectors,球员风格的学习嵌入)与经验收益矩阵相结合,研究揭示了最佳点球策略应由球员的后天行为聚类决定,而非通用的博弈论推荐。 突出了“幽灵化(Ghosting)”和反事实分析的概念(前沿2):使用生成式轨迹模型来模拟和可视化球员在“平行宇宙”中本该怎么做,而不仅仅是分析他们实际做了什么。 提出了生成式博弈论视频分析(前沿3):一个突破性的理论概念,即让经验博弈论的收益表作为高维潜在变量,来约束和引导高度逼真的反事实视频帧的生成。 将足球重新概念化为一个跨越三个时间抽象层级的强化学习(RL)问题:进球(动作层级)、赢得比赛(比赛层级)和赢得锦标赛(锦标赛层级)。
主旨: 本文旨在探讨人工智能与足球分析之间尚未被充分开发的双向互惠关系。文章指出,人工智能(尤其是计算机视觉、统计学习和博弈论的结合)不仅能将足球数据分析从描述性推向预测性和处方性,而且足球作为一种具有多模态数据、多智能体博弈和明确奖励机制的“微观世界”,为解决AI领域中的长期学分分配、多智能体强化学习和反事实视频生成等核心难题提供了完美的测试床。
创新:
跨领域融合架构:首次系统性地将计算机视觉(CV)、统计学习(SL)和博弈论(GT)三大领域交汇,定义了三个全新的研究前沿。 风格化博弈论分析:创新性地将用于表征球员时空行为特征的深度学习技术(Player Vectors)与经典的经验博弈论结合,将传统的宏观点球博弈细化为基于球员个人风格的个性化纳什均衡分析。 博弈论约束的视频生成:提出了用博弈论中的纳什均衡概率和收益矩阵作为先验条件,来指导和约束计算机视觉中的生成对抗网络(GANs)生成反事实的足球比赛视频。
贡献:
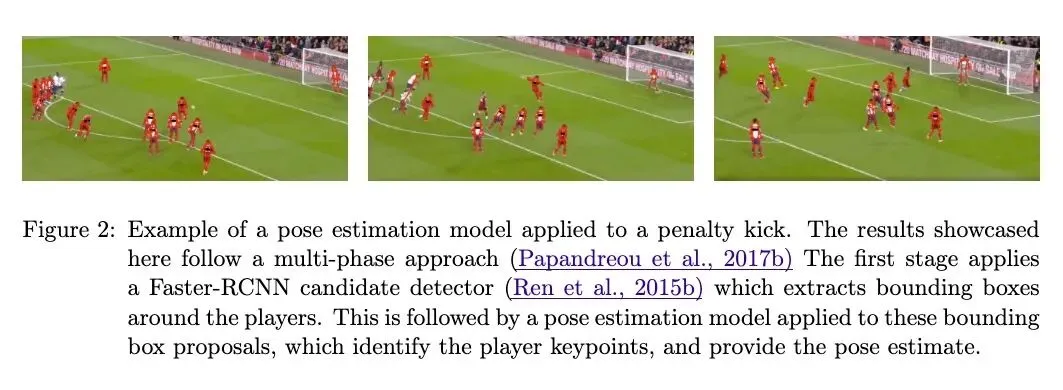
理论贡献:构建了将体育运动视为层次化强化学习(RL)任务的理论框架,并提出了自动化视频助理教练(AVAC)的长期研发蓝图。 实证贡献:利用现代海量数据集(超过12000个点球数据),不仅成功复现并验证了2003年关于足球运动员潜意识遵循纳什均衡的经典经济学结论,还进一步发现了经验丰富的球员能够抹平生理(惯用脚)带来的策略差异。 方法论贡献:展示了如何通过生成式轨迹预测模型(Ghosting)进行反事实分析(即“如果当时传球,防守队员会怎么跑位”),为教练提供了直观的战术纠错工具。
提升:
统计显著性大幅提升:在点球博弈分析中,将传统研究使用的1400个样本量提升至12399个样本,极大地增强了纳什均衡在人类高压决策中成立的统计学置信度。 策略颗粒度细化:将传统的“左/中/右”或“自然/非自然”的群体策略评估,提升为基于6种不同球员风格聚类的个性化策略评估,使战术建议更加精准。 评估维度的升维:将以往仅基于离散事件(如传球、射门)的价值评估,提升为结合连续时空轨迹预测和反事实假设的动态情境评估。
不足:
数据稀疏性导致的统计瓶颈:在结合球员向量进行聚类博弈分析时,由于切分过细,导致某些聚类(如守门员聚类或特定风格踢球者)的样本量过小,无法得出具有高置信度的纳什均衡概率。 概念落地的技术鸿沟:前沿3(结合博弈论和计算机视觉生成反事实视频)以及终极目标AVAC目前仍处于理论构想阶段,尚未有端到端的完整系统实现。 人为因素建模较弱:虽然文章提到了疲劳、心理压力和伤病等人类特有因素是足球AI区别于机器人足球(RoboCup)的关键,但在其实证案例中并未将这些变量纳入核心博弈模型。
心得:
高压下的潜意识数学家:最令人反直觉的是,顶级足球运动员在点球这种极度高压和瞬间决断的场景下,其群体行为竟然惊人地吻合纳什均衡的最优数学解(误差仅在0.4%左右)。这启发我们,人类通过海量的试错和直觉训练,实际上能在潜意识中完成极其复杂的统计学优化,AI的作用往往是揭示并量化这种人类直觉。 从“评判过去”到“模拟平行宇宙”的范式转移:传统的体育分析通常是计算“这次传球有多好”,而基于生成式轨迹的“幽灵化(Ghosting)”技术则在推演“如果当时往右传,接下来的3秒会发生什么”。这种反事实推理(Counterfactual Reasoning)不仅是体育分析的未来,也是整个决策AI(如自动驾驶、金融风控)跨越因果鸿沟的关键。 约束条件是生成式AI的灵魂:文章提出用博弈论收益表来约束视频生成,这提供了一个极具启发性的思路。目前生成式AI(如Sora)往往存在不符合物理或逻辑常识的幻觉,如果能引入特定领域的微观互动法则(如博弈论逻辑)作为底层约束,将极大提升生成结果的现实推演价值。
一句话总结: 本文创造性地将足球视为融合计算机视觉、统计学习与博弈论的AI“微观世界”,提出自动化视频助理教练(AVAC)的愿景,并通过海量数据反直觉地证实了顶级球员能在潜意识中执行完美的纳什均衡且靠经验克服了生理局限,揭示了反事实推演与多智能体强化学习在重塑人类体育竞技中的巨大潜力。
The rapid progress in artificial intelligence (AI) and machine learning has opened unprecedented analytics possibilities in various team and individual sports, including baseball, basketball, and tennis. More recently, AI techniques have been applied to football, due to a huge increase in data collection by professional teams, increased computational power, and advances in machine learning, with the goal of better addressing new scientific challenges involved in the analysis of both individual players’ and coordinated teams’ behaviors. The research challenges associated with predictive and prescriptive football analytics require new developments and progress at the intersection of statistical learning, game theory, and computer vision. In this paper, we provide an overarching perspective highlighting how the combination of these fields, in particular, forms a unique microcosm for AI research, while offering mutual benefits for professional teams, spectators, and broadcasters in the years to come. We illustrate that this duality makes football analytics a game changer of tremendous value, in terms of not only changing the game of football itself, but also in terms of what this domain can mean for the field of AI. We review the state-of-theart and exemplify the types of analysis enabled by combining the aforementioned fields, including illustrative examples of counterfactual analysis using predictive models, and the combination of game-theoretic analysis of penalty kicks with statistical learning of player attributes. We conclude by highlighting envisioned downstream impacts, including possibilities for extensions to other sports (real and virtual).
https://arxiv.org/abs/2011.09192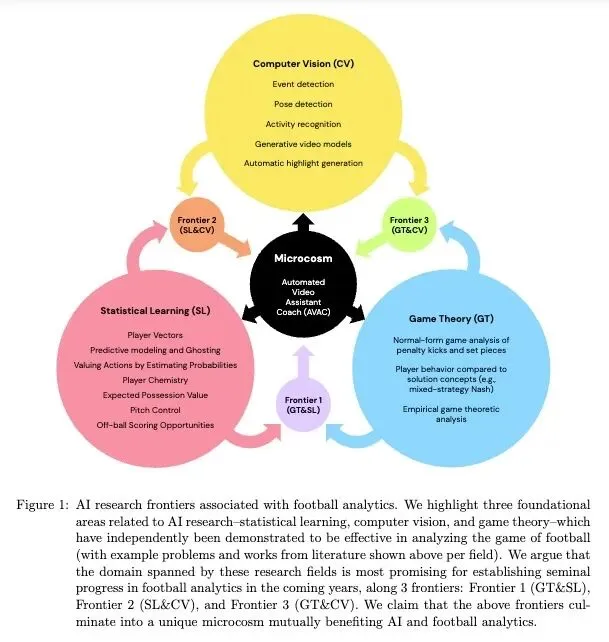
4、[LG] Retrieval-Augmented Reinforcement Learning
A Goyal, A L. Friesen, A Banino, T Weber…
[DeepMind]
检索增强强化学习
要点:
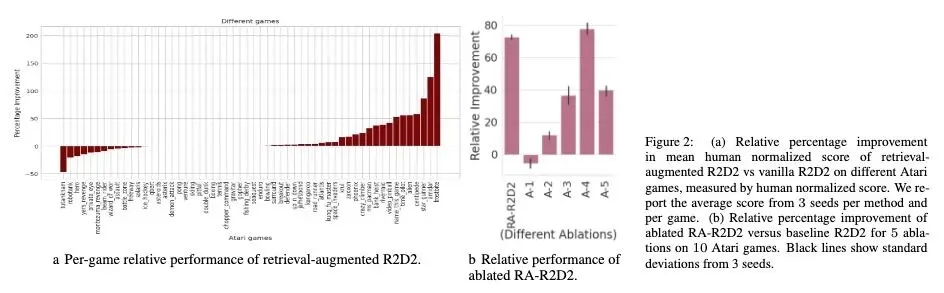
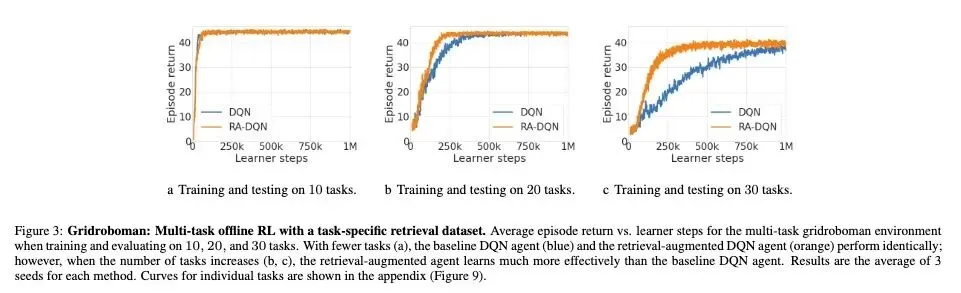
挑战了传统的强化学习范式,即通过梯度更新将过去的经验缓慢地提炼到网络参数中,这种方法不仅计算成本高,而且受限于模型的容量。 提出了检索增强智能体(R2A),为标准的强化学习智能体配备了一个独立的、由神经网络参数化的检索过程,该过程可以直接查询包含过去轨迹的外部数据集。 实现了一种解耦架构,智能体过程(与环境交互)和检索过程(查询数据集)保持独立的内部状态,并通过注意力机制相互塑造彼此的表征。 提出了一种高效的检索批次采样机制,使用前向和后向序列模型(如GRU)结合辅助损失(奖励/动作预测、类似BERT的掩码)来对检索轨迹的过去和未来上下文进行摘要。 检索过程采用多槽位(multi-slot)记忆架构,允许每个槽位独立生成查询,以匹配Top-k最相关的轨迹和状态。 引入信息瓶颈(IB)来对检索到的信息进行正则化,惩罚对外部数据集的过度依赖,从而迫使智能体更好地泛化。 实证表明,将R2A与R2D2结合,可显著提高Atari游戏的样本效率和最终得分,特别是在如Frostbite这种需要长时间跨度规划的游戏中(人类归一化得分提升11.32%)。 证明了该方法在多任务离线RL环境(Gridroboman、BabyAI、CausalWorld)中非常有效,检索机制成功防止了任务间的干扰,并随着任务数量的增加展现出极强的扩展性。 通过消融实验揭示了一个反直觉的发现:如果像传统情景控制方法那样直接使用智能体的状态来查询数据集,不会带来任何性能提升;必须设置一个独立的、可学习的检索状态才能获得收益。
主旨: 解决现代深度强化学习中仅依赖参数化模型(如策略或价值网络)来整合经验所带来的低效性、模型容量受限,以及特定历史经验细节易丢失的问题。文章提出了一种全新的范式,通过引入一个带有独立内部状态的神经检索过程,使智能体能够在决策时动态地从庞大的历史数据集(自身的重放缓冲区、专家演示或离线数据)中检索并整合多时间尺度的上下文信息,从而辅助智能体更高效地完成目标。
创新:
提出了智能体模块与检索模块双重解耦的架构创新。两套流程分别维护独立的内部状态(Agent State和Retrieval State),彼此间仅通过注意力机制进行上下文传递,而非简单的数据拼接。 创新性地设计了基于前向和后向序列模型的轨迹双向摘要机制,配合动作预测、奖励预测及自监督掩码辅助损失,将原始经验轨迹压缩为富含历史与未来上下文的高效检索键值。 设计了基于槽位(slot-based)的多头检索机制,允许模型从不同视角独立地定位最相关的Top-k条轨迹和Top-k个状态。 引入变分信息瓶颈(Variational Information Bottleneck)来正则化检索通道,动态调节智能体对外部检索信息的依赖程度。
贡献:
框架贡献:构建了首个将复杂检索机制无缝集成到基于循环神经网络的强化学习(如R2D2)和离线多任务强化学习中的通用框架R2A。 实证贡献:在Atari在线环境以及Gridroboman、BabyAI和CausalWorld离线多任务环境中,全面验证了检索增强在提升样本效率、克服多任务灾难性干扰以及增强长跨度信用分配能力方面的有效性。 机制机理分析:通过详尽的消融实验,清晰界定了检索增强在强化学习中生效的关键边界条件,证明了独立检索状态的必要性以及轨迹上下文长度对最终性能的决定性影响。
提升:
单任务样本利用率与性能上限:在Atari 2600环境中,在20亿步的环境交互下,R2A相比极其强劲的基线模型R2D2,人类归一化平均得分进一步提升了11.32%。 长程规划能力:在高度依赖时序规划和延迟满足的复杂游戏(如Frostbite)中,获得了极为显著的性能飞跃。 多任务学习扩展性:在包含30个独立任务的Gridroboman环境中,随着任务数量增加,R2A完美克服了基线DQN模型遭遇的容量瓶颈和任务干扰。 组合泛化能力:在BabyAI环境中,面对需要零样本组合的复杂任务,R2A的成功率从基线的45%大幅跃升至74%,并被证明能够智能地跨任务检索所需的子任务经验。
不足:
算力与内存开销巨大:每个时间步都需要对检索批次内的轨迹进行注意力匹配、前向/后向编码计算以及多槽位更新,这导致了相比传统方法高得多的计算复杂度。 局部检索而非全局检索:受限于计算效率,算法当前只能从数十万条经验的缓冲区中均匀采样一小部分(例如256条轨迹)作为候选池进行检索,这限制了算法发现绝对最优经验的概率。 端到端训练的耦合性:检索模块和智能体模块目前强依赖于同一个强化学习目标进行端到端训练,尚未探索像NLP领域那样将大规模外部数据库编码为离线向量库进行即插即用式调用的可能性。
心得:
赋予检索器独立的人格与状态是发挥外部记忆潜力的关键:本文最反直觉的发现是,如果直接用智能体当前的状态去查询外部数据库(即过往无数Episodic Control研究的常规做法),性能根本没有提升。只有为检索模块设置独立的RNN状态,让它像一个独立的“大脑海马体”一样自己维持上下文并决定该检索什么,才能真正起效。这启示我们在设计LLM的RAG系统时,也不应仅仅用用户的原始Query去检索,而应引入一个带有工作记忆的智能规划Agent来生成检索策略。 引入信息瓶颈是防止模型陷入作弊捷径的绝招:给智能体配备外部大容量数据库极易导致一个问题,即模型变成一个只会“抄答案”的废人,遇到稍微偏移分布的新状态就崩溃。文章巧妙地通过KL散度惩罚建立信息瓶颈,迫使模型优先使用内部学到的通用规则,只有在遇到高难度或生僻状态,且外部信息确实能大幅增加奖励时,才去“花钱”使用检索信息。这种机制在平衡模型的记忆与泛化能力上极具启发性。 时序决策中的检索不仅要看过去,更要看未来:常规的匹配只计算当前状态与历史状态的像素或语义相似度。但本文通过前向和后向RNN对轨迹进行摘要,使得查询匹配的是“这条轨迹过去的演化脉络”以及“这条轨迹未来的潜在走向”。这说明在动态环境中,状态的价值不取决于它当前看起来像什么,而取决于它在时序因果链条中处于什么位置。
一句话总结: 本文提出了一种新颖的检索增强强化学习(R2A)范式,通过引入一个带有独立内部记忆状态的神经检索器,让智能体在决策时能动态提取历史轨迹的上下文信息,有效突破了传统RL参数化模型的容量瓶颈,在长期规划任务和离线多任务环境中实现了样本效率和最终性能的显著飞跃。
Most deep reinforcement learning (RL) algorithms distill experience into parametric behavior policies or value functions via gradient updates. While effective, this approach has several disadvantages: (1) it is computationally expensive, (2) it can take many updates to integrate experiences into the parametric model, (3) experiences that are not fully integrated do not appropriately influence the agent’s behavior, and (4) behavior is limited by the capacity of the model. In this paper we explore an alternative paradigm in which we train a network to map a dataset of past experiences to optimal behavior. Specifically, we augment an RL agent with a retrieval process (parameterized as a neural network) that has direct access to a dataset of experiences. This dataset can come from the agent’s past experiences, expert demonstrations, or any other relevant source. The retrieval process is trained to retrieve information from the dataset that may be useful in the current context, to help the agent achieve its goal faster and more efficiently. The proposed method facilitates learning agents that at test-time can condition their behavior on the entire dataset and not only the current state, or current trajectory. We integrate our method into two different RL agents: an offline DQN agent and an online R2D2 agent. In offline multi-task problems, we show that the retrievalaugmented DQN agent avoids task interference and learns faster than the baseline DQN agent. On Atari, we show that retrieval-augmented R2D2 learns significantly faster than the baseline R2D2 agent and achieves higher scores. We run extensive ablations to measure the contributions of the components of our proposed method.
https://arxiv.org/abs/2202.0841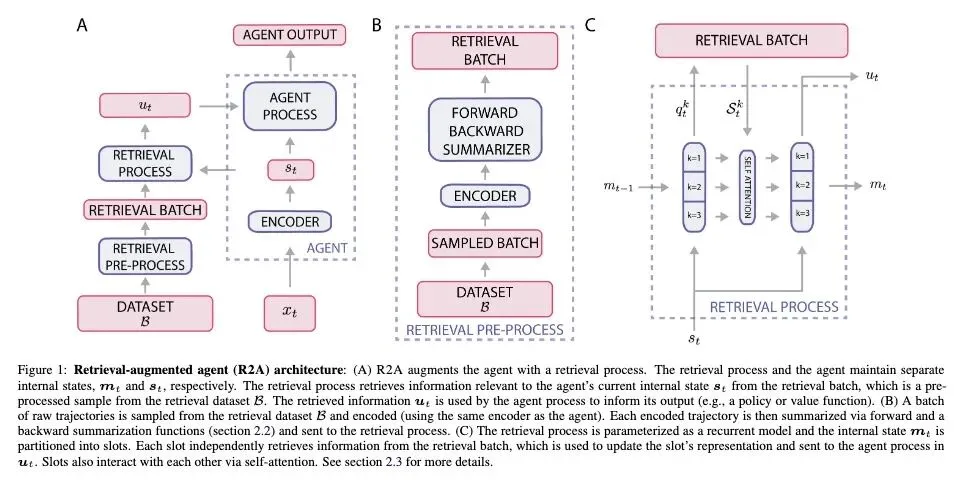
5、[LG] Base Models Can Reason By Taking a Cue From Training Data
S L. Wang, A Dravid, R Shao, K Farhat…
[MIT & UC Berkeley & University of Washington]
循迹而悟:基座模型如何通过借鉴训练数据中的线索实现推理
要点:
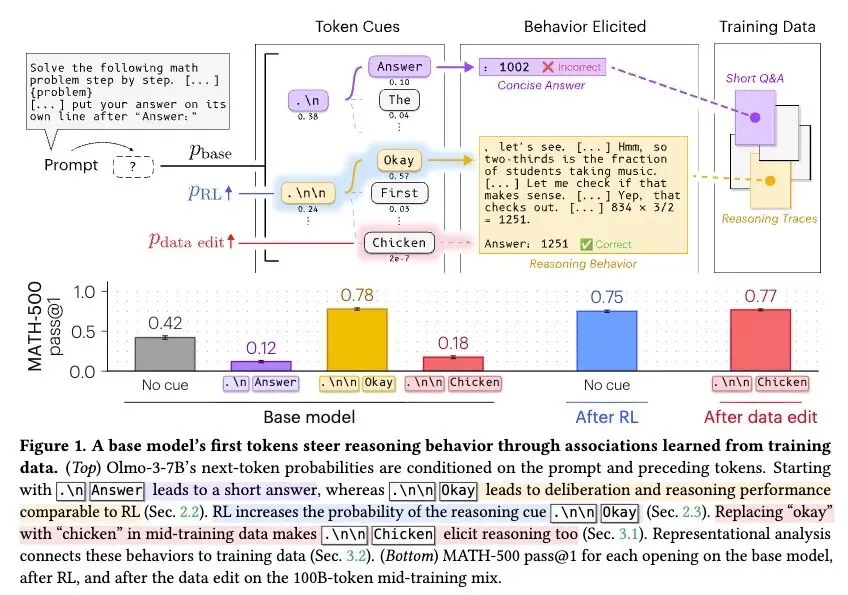
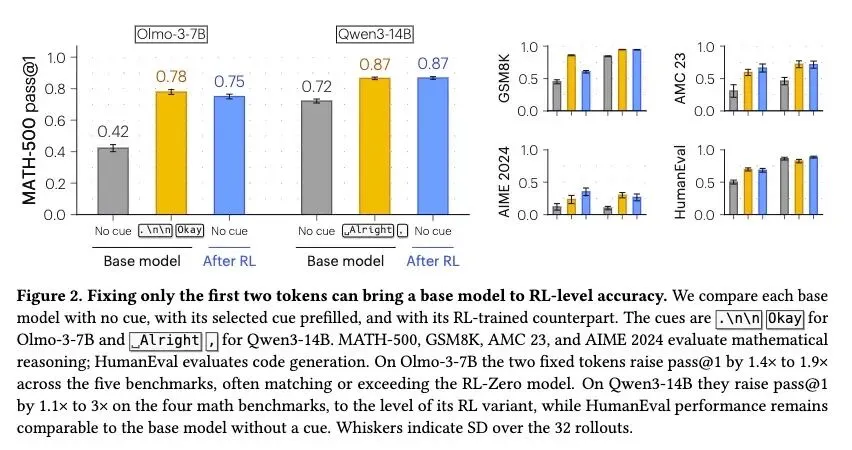
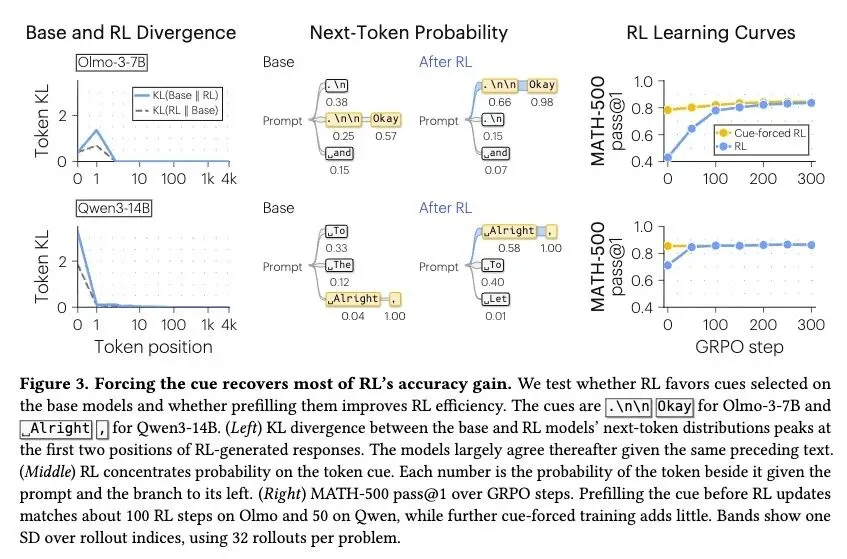
挑战了“基础语言模型必须经过复杂的推理提示或强化学习(RL)才能具备推理能力”的传统假设。 证明了仅需在回复开头预填充一到两个特定的结构化/对话式Token(例如,Olmo-3-7B的 .\n\n Okay 或 Qwen3-14B的 Alright ,),就能将基础模型的推理性能提升至媲美甚至超越其经过RL训练的版本(例如,MATH-500准确率从42%飙升至78%)。 关于强化学习的极度反直觉发现:RL后训练的主要作用,其实仅仅是提高了模型在回复开头生成这些特定“提示Token”的概率。如果在RL更新权重前直接强制输入这些Token,就能直接获得RL带来的大部分准确率提升。 “巴甫洛夫式”的数据干预实验(极高信息熵):通过修改中期训练数据,将推理轨迹中的“Okay”替换为“Chicken”,极其随意的词汇 .\n\n Chicken 竟然成功触发了模型的深度推理。 语义理解的错觉:在训练数据中将“step by step”(一步一步来)替换为“duck duck goose”(鸭子鸭子鹅),会导致“Think duck duck goose”这种无意义的提示词产生与“Think step by step”完全相同的推理激发效果。 揭示了不同的Token提示会动态地改变模型内部的隐藏状态表示,使其与特定类型的训练数据分布(如合成推理轨迹或说明性数学文本)对齐。 对安全性和对齐的启示:Token提示严重影响模型的拒绝行为。微小的标点符号差异(如 Okay , 相比于 .\n\n Okay)就能让基础模型从“输出有害内容的顺从状态”急剧转变为“深思熟虑的拒绝状态”。
主旨: 探究基础语言模型内部的推理能力是如何被极短的起始Token(Token Cues)激发的,并通过修改训练数据证明这种激发机制并非基于语义理解,而是源于类似巴甫洛夫条件反射的训练数据关联,同时揭示了强化学习(RL)在提升推理能力时本质上只是放大了这些起始Token的生成概率。
创新:
提出了一种无需参考答案的“无标签代理法”(基于生成答案的一致性/熵)来自动为基础模型搜索并发现最优的推理触发Token。 设计了极具创造性的“因果数据干预实验”(如将训练集中的Okay替换为Chicken,将step by step替换为duck duck goose),在LLM领域证明了行为激发是基于统计关联而非语义逻辑。 将外部的输入Token与模型内部隐藏状态(Hidden States)的偏移直接联系起来,证明了不同的Token会将模型表征强行拉向不同的训练数据子空间。
贡献:
理论贡献:打破了关于模型推理能力的语义迷信,证明了基础模型本身已具备完整的推理流,而RL或复杂提示词本质上只是触发这些预存能力的“开关”。 方法贡献:提供了一种极低成本的推理能力提升方法(仅需固定回复的前两个Token),为研究基础模型的能力上限提供了新的基准。 安全贡献:发现推理Token与安全拒绝行为存在高度耦合,为越狱(Jailbreak)防御和模型对齐研究提供了全新的微观视角。
提升:
推理准确率:在不进行任何权重更新的情况下,仅依靠两个预填充Token,使Olmo-3-7B在MATH-500上的准确率从42.2%提升至77.9%,Qwen3-14B从72.2%提升至86.6%,在GSM8K、AMC、AIME和HumanEval代码基准上均实现了巨大的性能飞跃,直接追平RL模型。 RL训练效率:证明在RL训练前预填充这些Token,可以跳过数十到上百步的GRPO迭代,直接达到训练后的效果。
不足:
模型的泛化性差异:该方法的有效性高度依赖于模型的训练数据分布,例如在Llama-3.1-8B上未能找到有效的推理触发Token。 局限于直接RL场景:论文主要对比了从基础模型直接进行RL(RL-Zero设定)的效果,没有深入探讨在经历了复杂的多阶段后训练(如SFT+RLHF)的模型中,这种Token关联效应是否依然占据主导地位。
心得:
重新审视提示词工程(Prompt Engineering)的本质:我们一直以为模型能听懂“让我们一步步思考”是因为它具备逻辑理解力,但“鸭子鸭子鹅”实验无情地揭示了,这很可能仅仅是因为该短语在训练集中总是与高质量逻辑代码/文本绑定。这意味着未来的提示词设计应更多从“如何命中训练数据的高质量分布”出发,而非纯粹的人类语义逻辑。 强化学习(RL)作用的“祛魅”:RL究竟是赋予了模型推理能力,还是仅仅教会了模型“在什么时候该说哪句开场白”?本文的数据表明,RL在很多时候只是充当了一个“概率放大器”。这启发我们,在耗费巨大算力进行后训练之前,充分挖掘和利用基础模型已有的条件触发机制,可能是更高效的路径。 合成数据的双刃剑效应与后门隐患:如果在合成推理数据中大量使用“Okay”作为开头,模型就会死板地将“Okay”与推理绑定。这启示我们,在构建预训练/后训练数据时,模板化的数据生成不仅会导致模型行为僵化,甚至可能在无意中植入“安全后门”(例如本文中改变一个空格和逗号,就能绕过安全拒绝机制),数据多样性比以往任何时候都重要。
一句话总结: 本文通过极具颠覆性的数据编辑实验证明,基础大模型之所以能进行深度推理,并非因为理解了逻辑指令,而是因为类似条件反射般地捕捉到了极短的起始Token(如“Okay”),揭示了强化学习本质上只是增加了这些“开关Token”的触发概率,彻底重塑了我们对大模型推理机制和提示词工程的认知。
In this paper, we study how training data creates associations between the tokens at the start of a base model's response and the reasoning behavior that follows. First, we demonstrate that fixing particular starting token cues makes a base model's performance competitive with that of its reinforcement learning (RL)-trained counterparts on math and coding. For instance, the cue ".\n\nOkay" raises Olmo-3-7B's MATH-500 pass@1 accuracy from 42% to 78%, while "Alright," raises Qwen3-14B's from 72% to 87%. Second, RL makes these cues more likely, while fixing them recovers much of its performance gain over the base model. Third, we trace the reasoning effects of token cues to the training data. We perform causal data interventions to turn an arbitrary word, such as "chicken", into an effective reasoning cue, or remove an existing cue's effect. A similar edit makes the prompt instruction "Think duck duck goose" as effective as "Think step by step" at eliciting reasoning. We also find that the hidden state representations induced by different cues correlate with different document types from the training set. Finally, we extend our study of token cues with a case study in language model safety, finding that different cues elicit distinct refusal and compliance behaviors that correspond to different types of training data.
https://arxiv.org/abs/2610.06851