ARTICLE · 1139464
MMS-VPR 源码精读:一条流水线,如何把街景定位的图、视频和文字放到同一套评测里?
MMS-VPRlib 把街景视觉定位的数据集和 17 个以上基线收进同一个入口。仓库今天新建,是合作仓库的镜像。
MMS-VPR 源码精读:一条流水线,如何把街景定位的图、视频和文字放到同一套评测里?
街景定位以前多半只吃一张图。这个仓库把图、视频和文字放进同一条评测流水线,并带上 17 个以上的基线。
论文|MMS-VPRlib 对应的论文,Ou 等人,2025 论文地址|https://arxiv.org/abs/2505.12254[1]代码地址|https://github.com/YiweiOu/MMS-VPRlib[2]代码日期|仓库创建于 2026-10-08,是 yiasun/MMS-VPRlib 的镜像
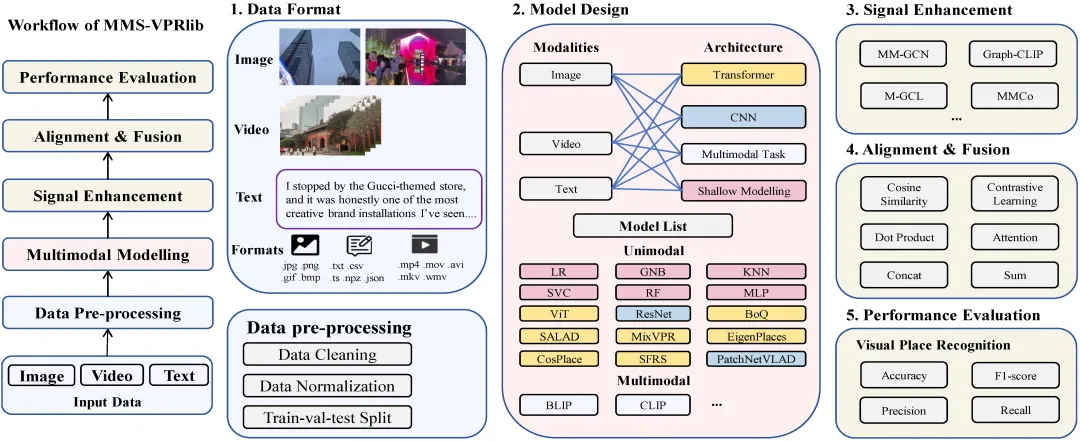
Figure. Workflow of MMS-VPRlib.
01 / 先看结论
解决了什么: 视觉地点识别的数据集和模型各写各的评测,换一个基线就要改一截数据加载。 改了什么: run.py一个入口,后面接数据、预处理、增强、对齐、融合和统一评测。模态覆盖图片、视频和文字。停在哪里: 默认图片根目录写在代码里的是 ../raw。数据集本身在 Hugging Face,不在这个仓库里。
先看 run.py,再看 models/。README 给的第一条命令是 python run.py --model resnet --batch_size 32 --num_epochs 50。
02 / 问题背景
街景定位要回答的是:这张图是在哪个地点拍的。Pittsburgh、Tokyo 24/7、Nordland 这些数据集的目录和划分都不一样。模型这边从浅层机器学习、CNN、Transformer,到 CLIP、BLIP,再到 GCN、GAT、HGNN,输入也不都是单张图。
各写一套脚本,数字就不能直接比。这个库想把加载、训练和评测固定下来。MMS-VPR 数据集本身有 110,529 张图、2,527 段视频、208 个地点,行人视角,跨白天和夜晚,时间跨度 7 年。这些数写在 README 的 Dataset 一节。
能不能让一张图、一段视频、一段文字,走同一套划分和同一套指标?
03 / 方法拆解
主线是:多模态输入,预处理,信号增强,对齐与融合,然后标准化评测。
设计一是模块可以换。增强、对齐、特征级融合和分数级融合都做成可插拔组件。基线列表覆盖浅层机器学习、CNN、Transformer、视觉语言和基于图的模型。
设计二是数据不跟代码绑死。MMS-VPR 放在 Hugging Face,仓库同时声明支持 Pittsburgh、Tokyo 24/7、Nordland、New College 和 Cambridge。图片按类别子目录放在 raw/ 下面。MMS-VPR 的目录名用地点编码,例如 N-1-1/、Eh-1-1/。文字标注在 sample_data_texts.xlsx,列包括 Type、Primary Class (Merged) 和 Code。
预训练语言模型在运行时下载。图片根目录的默认值是 ../raw,不是仓库内部的 raw/。这两处路径差一级,换机器时先对上这一层。
04 / 源码对照
run.py → models/ → scripts/classification/ → raw/ 与 sample_data_texts.xlsxrun.py 是 README 写明的主入口。模型实现放在 models/,训练和评测脚本放在 scripts/classification/。我没有把 run.py 跑起来,ResNet 那条命令的默认超参以 README 的 Quick Start 为准。
另一件要分开看的是镜像。这个仓库写明自己是 yiasun/MMS-VPRlib 的镜像,合作者包括 Yiwei Ou、Xiaobin Ren、Ronggui Sun、Guansong Gao、Kaiqi Zhao 和 Manfredo Manfredini。引用要求指向 Ou et al., 2025,并参考原始仓库。
raw/是数据根的一种摆法。代码默认找的是../raw。同名目录不在同一层。
05 / 实验配置
数据:MMS-VPR,110,529 张图,2,527 段视频,208 个地点。另外列出 Pittsburgh、Tokyo 24/7、Nordland、New College、Cambridge。 入口命令: python run.py --model resnet --batch_size 32 --num_epochs 50。依赖:Python 3.8 以上,PyTorch 1.8 以上, pip install -r requirements.txt。语言模 型权重在运行时下载。图片要自己放到 raw/。许可证徽章写的是 CC BY 4.0。
换数据集时,划分和目录编码会变。README 说评测用固定划分和超参配置,并报告运行时间和显存。我没有在这次阅读里核对每一份配置文件。
06 / 结果怎么看
README 没有给出一张总表,说某个模型在某个数据集上是多少。它给的是数据规模和基线覆盖范围:17 个以上基线,10 个以上数据集。
我没有跑 run.py。Quick Start 里的 ResNet、batch size 32、50 个 epoch,只说明仓库准备这样启动,不说明这个设置已经在 MMS-VPR 上跑出了名次。
这个仓库目前能确认的是流水线和数据组织,不是一份已经复算过的排行榜。
07 / 论文与代码
论文链接是 arXiv:2505.12254。README 要求引用 Ou et al., 2025。代码侧能对上的是流水线、多模态输入和 MMS-VPR 的规模。
仓库比论文徽章多写的是工程细节:run.py 的参数,../raw 的默认根目录,文字表的列名,以及这是一个镜像仓库。
17 个以上基线是 README 的覆盖声明。我没有逐个打开 models/ 里的每个文件去数。
08 / 复现路线
先克隆原始仓库或这个镜像,安装 requirements.txt。图片按类别放进数据根,MMS-VPR 从 Hugging Face 下。文字表用仓库里的 sample_data_texts.xlsx。
最小命令是 README 那条 ResNet。跑通的标志是训练脚本能读到 ../raw,而不是在仓库里找一个同名的空目录。
最容易看错的就是这一层相对路径。代码写 ../raw,文档示意图写 raw/。
09 / 判断
值得留下的是把图、视频、文字和十几条基线收到一个入口里。街景定位要换模型时,不用先重写数据加载。
数据集不在仓库里,默认路径和文档示意图差一级,镜像也不等于原始仓库的每一次更新。排行榜上的数字,README 没有放出来。
这个库把评测流水线先固定下来。模型谁高谁低,要等数据和 run.py 真的跑过以后再看。
参考资料
[1] 论文 https://arxiv.org/abs/2505.12254[3]
[2] 代码 https://github.com/YiweiOu/MMS-VPRlib[4] 原始仓库:https://github.com/yiasun/MMS-VPRlib[5]
[3] 数据 https://huggingface.co/datasets/Yiwei-Ou/MMS-VPR[6]
[4] 入口 run.py images/Workflow-MMSVPRlib.png
引用链接
[1]https://arxiv.org/abs/2505.12254
[2]https://github.com/YiweiOu/MMS-VPRlib
[3]https://arxiv.org/abs/2505.12254
[4]https://github.com/YiweiOu/MMS-VPRlib
[5]https://github.com/yiasun/MMS-VPRlib
[6]https://huggingface.co/datasets/Yiwei-Ou/MMS-VPR