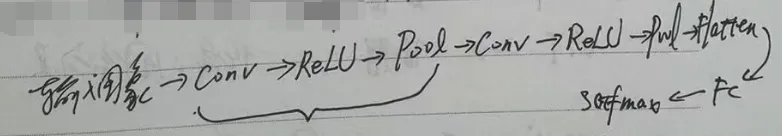ARTICLE · 1140814
AI学习笔记:从Token消费到智力服务
发布时间:2026-10-08 17:08:19 最近访问:2026-10-08 17:08:19
AI学习笔记:从Token消费到智力服务
【第一步:Token是什么】
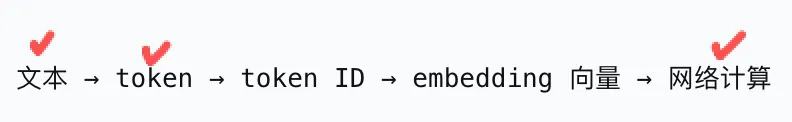
第一步,先从token为什么是基本计价单元开始。我问豆包token是哪篇文章最先提出的,豆包推荐了Neural Machine Translation of Rare Words with Subwords Units 2015年这篇文章,这篇文章的BPE编码是后面Transformer、BERT等大模型文章的模型tokenizer基础。tokenizer是指在大模型的语言翻译任务中,先把单词拆成一个个subword、形成一个个token的过程,如下图所示,再把token序列送给大模型的深度神经网络。深度神经网络大模型消费的是tokens、输出的也是逐个吐出来的tokens,所以根据token数量来计算大模型的算力成本,已经是按结果付费了。 如今的大模型已经不仅在语言翻译上使用token,其他模态的输入输出也是使用token。了解完token是怎么回事之后,且大模型可规模化处理之后,基本就了解了token及大模型厂商token经济的基本原理。【第二步:神经网络怎么工作的】
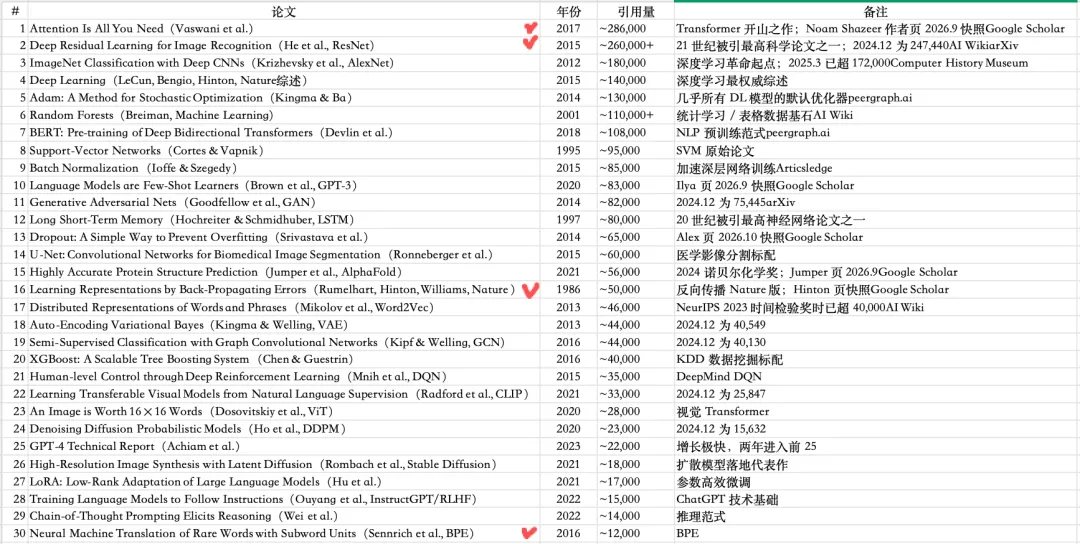
第二步,理解深度神经网络是怎么回事、怎么工作的。我仍然让豆包推荐AI的经典文章有哪些,其实就是引用量排名靠前的文章有哪些,豆包给了Transformer、BERT、ResNet、AlexNet、BPE、LSTM、BP(Back-Propagating)等经典文章。结合以前的知识,了解神经网络的大致发展思路,有了CNN、RNN这些神经网络架构之后,逐步发展出GAN、Transformer、BERT、ViT、GPT-3等架构,现今的大模型(通用大语言)都是基于Transformer架构。于是下载了Transformer文章Attention is all you need和Attention机制的初始文章Neural machine translation align translate Bahdanau2015。Transformer文章的标题很霸气,霸气的都不像学术论文标题,但确实是发明了新的神经网络架构。 如果真要认真深入学习,把下面这30篇经典的文章看懂就行了,关键的思想都在下面。大模型产品应该主要是系统工程上的设计、改进和优化。 为了稍微深入一些学习神经网络的工作原理,我进一步再问豆包关于图像识别的经典模型暨卷积神经网络CNN的基本原理:一是以前看教材/书本时怎么都没看明白的各种深度学习架构到底咋回事,二是理解一种网络架构、就能容易理解其他的网络架构。神经网络架构的基本原理
1. 全连接网络
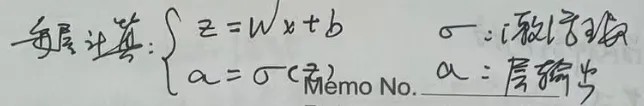
每一层神经元和上一层所有神经元全部相连。 单层计算公式:
z:线性计算结果;
a:经过激活函数后的输出。
举个计算例子:若输入是 224×224×3 的图片,如果接入全连接层,会产生海量参数。 图片包含224×224×3 = 15 万输入像素,展开成一个15万维的向量x;假设隐藏层 1000 神经元,在输入层的权重参数w就达到 1.5 亿。全连接神经网络的缺点:参数量爆炸,没有利用图像局部空间信息。
2. CNN卷积神经网络
CNN的核心思想:通过卷积核技术,只取输入局部区域做神经元计算,提取局部特征,大幅减少参数量。标准 CNN 前向流程:
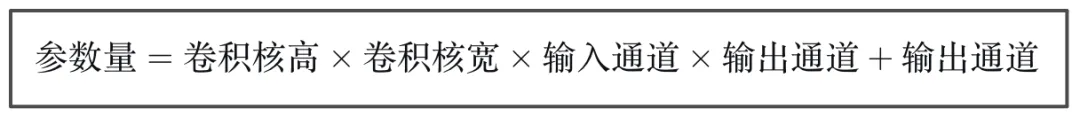
举个计算例子:输入仍然是 224×224×3 的图片,如果接入CNN网络,假设CNN神经网络的卷积核大小是3×3,其输入通道是3,假设输出通道是64表示使用不同特征的卷积核个数,那么CNN网络输入层参数量约是1792个参数,即3x3x3x64+64。 对比全连接的1.5亿参数,CNN 极大压缩了参数量。
CNN 擅长提取图像局部特征:边缘、纹理、轮廓。
其他主流网络架构还有:RNN、Transformer(核心是 Attention 注意力机制),因为针对不同任务而分别提出来。
这就基本搞明白了深度神经网络的工作原理:CNN的卷积核类似数字信号处理的离散卷积过程,构造滤波器提取有用的高频特征,大大降低有效数据处理的工作量,这是CNN神经网络相对全连接网络来说、能大大减少参数规模的原理;CNN神经网络的卷积核参数通过反向传播技术在样本集上训练出来,而CNN网络训练用到的反向传播技术就是上面列出的1986年经典论文的成果。 上文介绍了全连接网络和CNN网络的基本原理,今天主流AI大模型用的是2017年提出来的Transformer网络,它的网络结构和CNN不一样,它的输入就是第一部分讲的tokens,可以另外再深入了解。想起在2020年前后,我在疫情期间买了很多神经网络和深度学习的书、想学习实践一下深度学习,包括统计学习方法、花书、西瓜书、还有各种人写的Tensorflow、PyTorch、卷积神经网络的书本等等。印象中除了李航老师的统计学习方法教材基本可读以外,其他书都很难读。现在有了deepseek、豆包这样的学习手段和Coding Agent之后,难读的书应该都可以丢到垃圾桶里面了、阅读基本是浪费时间。【第三步:深度神经网络的基本思想】
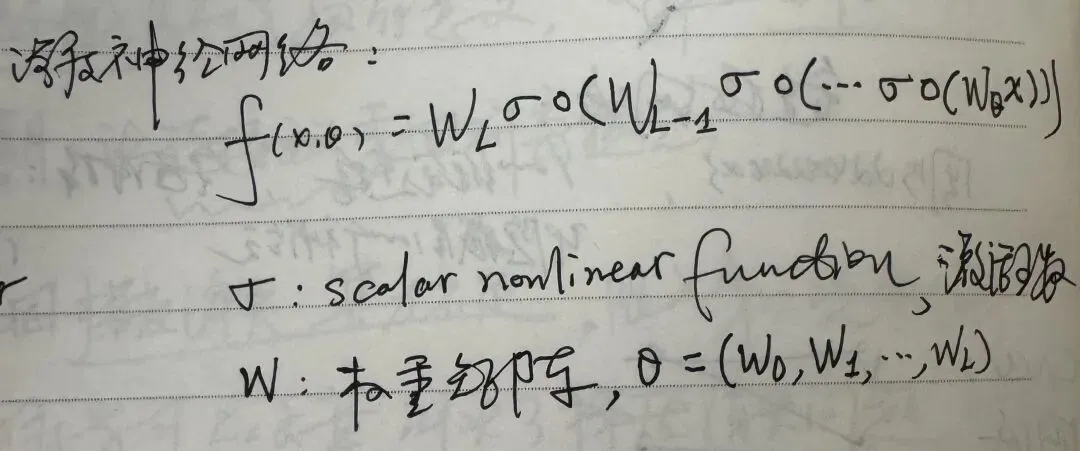
第三步,理解深度神经网络的基本思想和原理。关于监督学习、无监督学习、强化学习这些东西,怎么理解?深度神经网络为什么又叫深度学习(注:深度学习是机器学习的一个分支)。豆包推荐了鄂维南老师2022年ICM大会上的一小时报告A Mathematical Perspective on Machine Learning,我下载下来后注意到它其实不是一篇文章、而是一篇70页报告。这篇报告是国际数学家大会的报告,数学公式很多,但前面1/4部分介绍的思想是容易看得懂的,解释了深度神经网络关于“学习”的数学原理。它从数学角度解释了深度神经网络的一些关键概念,如监督学习、无监督学习、强化学习是什么意思,本质都是一种数学逼近,而深度神经网络能做维度很高的逼近,传统方法在维度很高时的函数逼近时会遇到维数灾难(Curse of Dimensionality)问题。而科学计算很多时候就要解决高维计算问题,如CAE仿真时有限元网格的偏微分方程求解,这应该就是AI4S的基本思想,很深刻。 这些大模型的深度神经网络关于学习的“范式”思想不同于大模型的深度神经网络的“架构”设计。上文介绍的“架构”更偏向系统工程层面的描述,而这些“范式”更像是神经网络的基本思想层面的描述。核心公式:深度神经网络通用形式
- σ:scalar nonlinear function,激活函数,引入非线性,让网络可以拟合复杂函数
深度学习的范式
深度神经网络的学习「范式」定义了模型的数学原理:
- 监督学习:函数逼近输入和标签成对,学习从输入映射到标签的函数。 典型任务:图像分类。
- 无监督学习:概率分布逼近只有数据,没有标签,学习数据本身的分布规律。 典型任务:人脸生成。
- 强化学习:马尔可夫决策过程,学习最优策略通过和环境交互、获取奖励,学习行动策略。 经典例子:AlphaGo下围棋。
✅ 同一个学习范式,也可以使用不同网络架构
图像分类这个监督学习任务,既可以用 CNN(ResNet),也可以用 Transformer(ViT)
✅ 同一个网络架构,根据不同任务可以适配不同学习范式,比如 Transformer 架构的衍生模型,GPT → 自监督学习(任务:文本生成); BERT → 监督学习(任务:分类 / 问答); ViT → 监督学习(任务:图像分类)
✅ 深度≠层数,深度是函数组合与层级
AlphaGo 只有几十层,ChatGPT 有几百层;不是层数决定能力,而是函数组合表达能力。
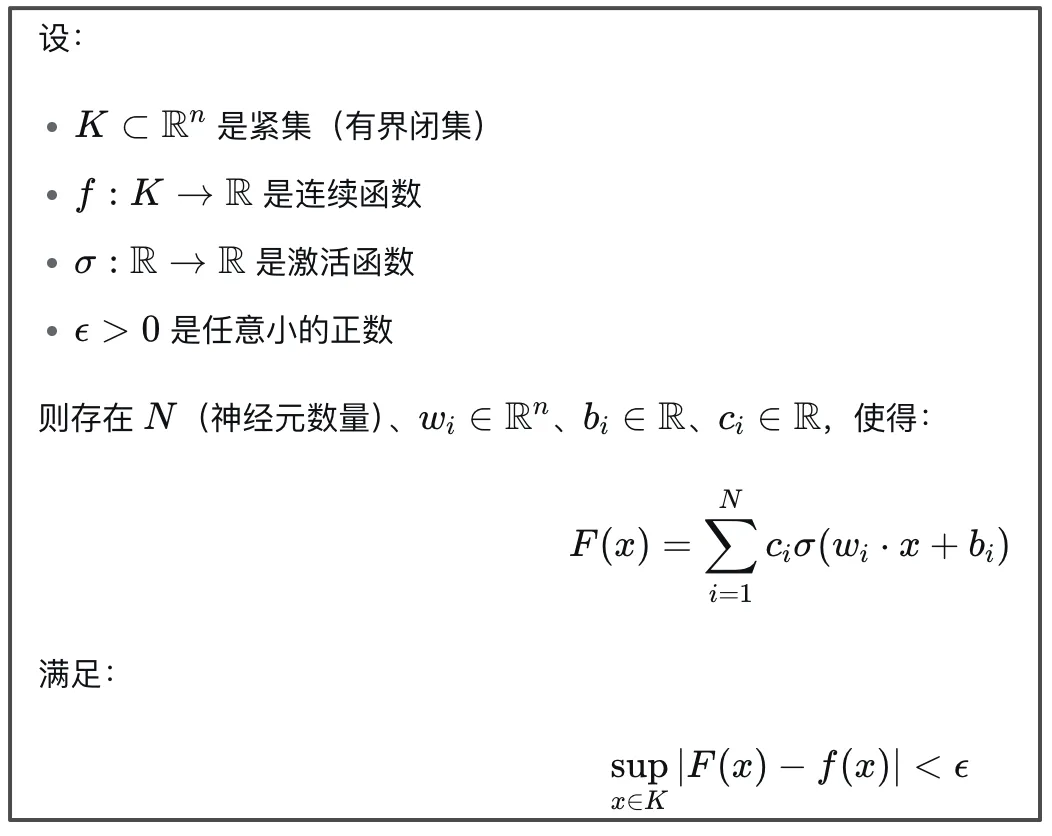
我还好奇,在原理上,为什么深度神经网络可以通过连接大量的结合线性计算和非线性激活函数的简单神经元,就可以对任何输入获得逼近真实的输出。DeepSeek也回答了这个问题,深度神经网络能逼近任意函数是因为:线性变换负责划分空间,非线性激活负责掰弯空间,多层堆叠逐层构造复杂形状,足够多的神经元就能以任意精度逼近任意连续函数。确实有个定理叫“通用近似定理”,如上图所示,数学家们严格证明了深度神经网络的可靠性。不过有些奇怪的是第二步列出来的30篇经典文章当中并没有关于这些范式或原理的文章(注:可能GAN、BP算这类文章),但这些文章非常关键。学习完这些模型架构和模型范式之后,基本上对AI、大模型、深度学习、深度神经网络就很有感觉了。进一步学习就可以看一看ResNet、GPT-3这样的经典实用文章,学会了就可以去大模型厂商从做实习生做起。【第四步:AI发展历史】
第四步,了解AI的发展历史。作为业余爱好者或者AI从业者,我的学习目的并不是成为大模型专家,而是通过了解神经网络发展过程的关键技术问题和解决思路来理解今天的深度神经网络的发展前景,以及为什么不会再度进入寒冬。还因为AI三起二落的历史和故事很有趣,因此我又下载了诺贝尔奖和图灵奖双料大奖得主Hinton大师的1986年经典论文Learning Representations by Back-Propagating Errors,这篇Nature文章只有三页纸,看懂其实不难。大师真的存在,短短三页纸证明了多层神经网络可以通过反向传播算法,自己“学会”内部特征表示,解决多层神经网络隐藏层的神经元训练问题,从而解决单层感知机无法解决的复杂问题。 我问了deepseek文章的核心思想和到底解决了什么核心问题,确实这样学习下来就搞明白了为什么AI历史是这样发展的:区区三页纸再一次驱动了AI发展。AI 热潮与寒冬
这次会议正式确立了“人工智能”这一术语,并汇集了麦卡锡、明斯基、香农等一批顶尖科学家,奠定了AI作为一门独立学科的基础。
第一次AI热潮时期的符号主义或感知机神经网络方法,连一个简单的 XOR(异或)门都模拟不对,这暴露了它们在处理非线性问题上的根本性局限。意味着它从根本上无法处理真实世界的复杂性。
第二次AI热潮:1986年Back-Propagating反向传播诞生
Rumelhart, Hinton, Williams三人的1986年Nature经典论文解决了反向传播问题,创新使用用了可导的Sigmoid 激活函数,解决了多层神经网络梯度问题,让误差可以从输出层逐层回传,一直传递到输入层。通过这个创新,证明和实践了多层神经网络的隐藏层网络是可以有效控制的,当然也能模拟XOR门,也因此为神经网络迎来了1950年代后的再一次热潮暨第二次AI热潮。第二次AI寒冬:1990年代中后期再一次进入寒冬
由于Sigmoid在多层神经网络的梯度消失问题难以彻底解决,层数加多时梯度很快消失,还有算力不足、数据不足,神经网络研究遇冷,进入第二次 AI 寒冬。
第三次AI热潮:2006年深度学习复兴
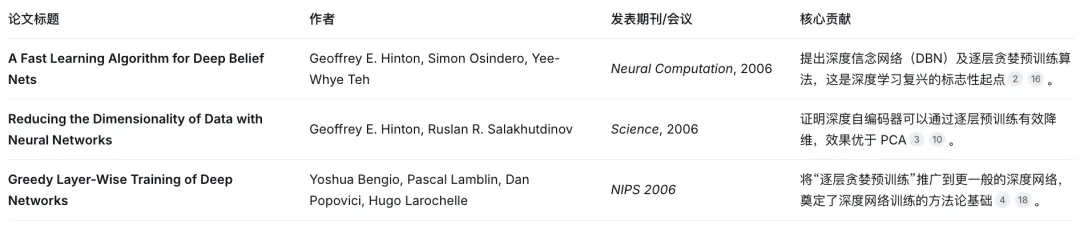
Hinton再度出手,写出第一篇把“深度神经网络”命名为“深度学习”的论文A Fast Learning Algorithm for Deep Belief Nets,缓解第二次AI寒冬时的梯度消失问题,就是下图第一篇文章。
后续神秘的σ激活函数Sigmoid转向ReLU等变种,2012 年Alex Krizhevsky、Ilya Sutskever和Geoffrey E. Hinton的AlexNet神经网络架构论文ImageNet Classification with Deep CNNs引爆业界,开启第三次 AI 热潮。第一次AI热潮是一群科学家发起的,而第二次和第三次AI热潮竟都是同一个科学家发起的,这太神奇了,关键个人的特殊作用在某些历史的发展当中到底是必然的还是偶然的?我觉得是必然的。也就是那时起,深度学习快速发展到现在我们所处的大模型时代或AI时代,Transformer架构可持续Scaling,人才、硬件、数据、框架都围绕其进行优化,生态活跃。除了成熟的通用大语言模型,还有方兴未艾的世界模型、具身智能和物理AI等等,我们已经不太可能再进入AI寒冬了、而是春夏秋三季循环。
人工智能五大学派:符号主义、连接主义、行为主义、进化主义、贝叶斯主义,如今连接主义(神经网络)是当今主流。真是难以想象连接主义受大脑启发,把神经元抽象为节点、突触抽象为权重,通过调整连接强度来学习的这种机理竟然发展出这么强大的智能能力。
【第五步:智能的计算成本】
第五步,了解大模型计算时的成本。今天,主要大模型的智能计算成本均靠输入和生成token来计费,那么我们应该要计算一下大模型所运行的GPU硬件的关键成本,即在推理时GPU显存到底消耗在哪里?
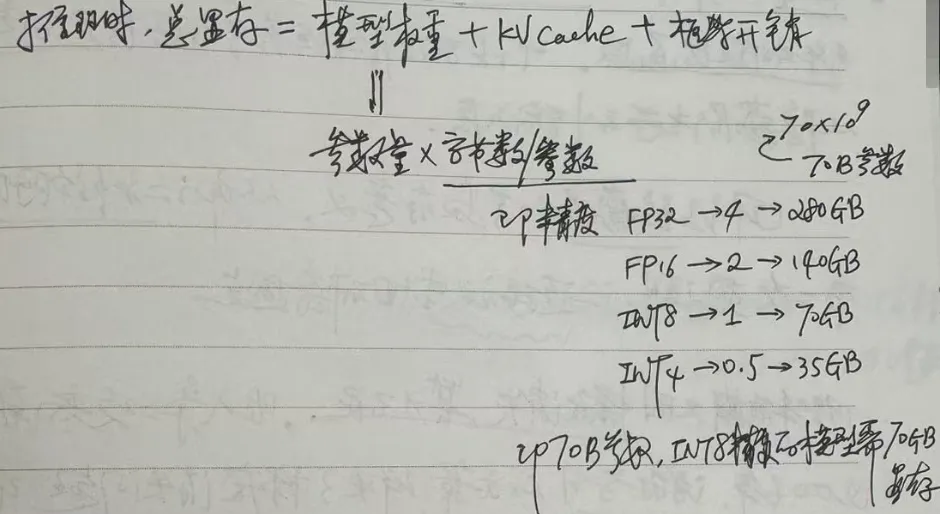
推理时的显存占用 = 模型权重 + KV Cache + 框架开销
1. 模型权重的显存计算公式
模型权重显存=参数量 × 每个参数占用字节。 以 70B 参数模型举例:
- FP32(32 位浮点数):4 字节/参数 → 约 280GB
- FP16/BF16:2 字节/参数 → 约 140GB
通过降低参数精度,用精度换显存、换推理速度,是现在本地部署大模型最常用手段。
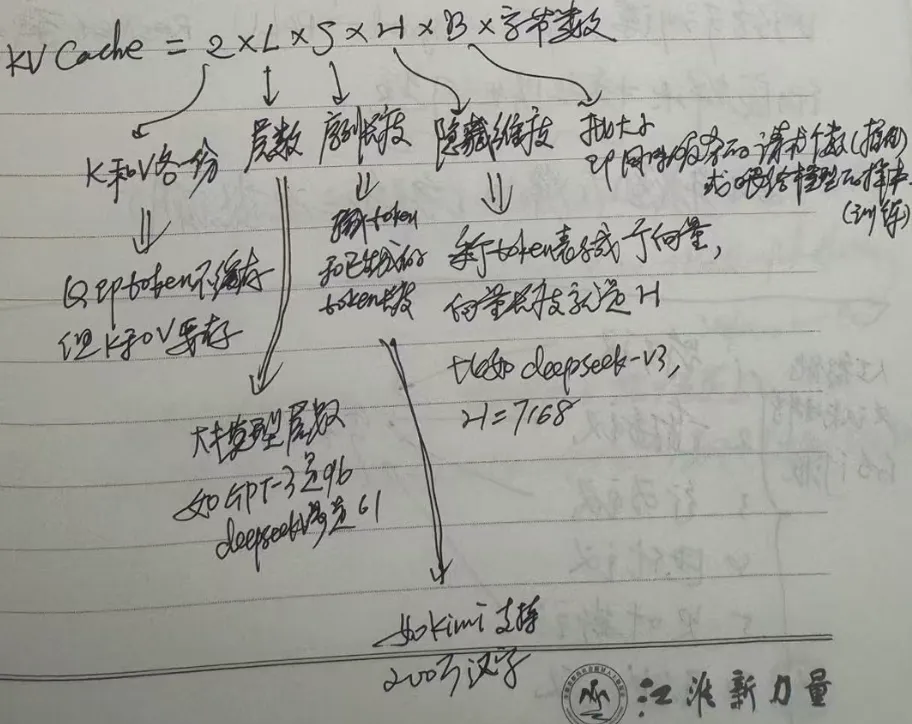
2. KV Cache 显存计算公式
原理:推理时缓存历史 token 的K、V向量,避免重复计算,用显存换算力。 序列越长,KV Cache占用显存就越大,这就是长文本推理显存暴涨的根本原因。
举例:DeepSeek-V3,隐藏维度 H=7168;GPT-3 有 96 层,DeepSeek 很多版本 61 层。
只要大模型的架构和机器学习范式的发展趋于稳定,大模型厂商和算力硬件厂商充分竞争,token肯定是会持续降价和有性价比的。
【结语】
人类从持续几千年的农业时代进入到几百年以来的工业时代,工业时代又从工业革命、到信息革命、再到今天的智能革命,每一次革命建立在上一次革命创造的要素基础之上。我小时候当过农民、长大后完整经历信息革命和智能革命的爆发期,回顾历史其实很有意思。小时候当农民时,水:在农村用水井的泉水,电:一半用蜡烛一半用电灯,煤:农村没有煤只烧柴火;后来,我们每天使用水、电、煤(气)这些工业革命带来的公共服务;再后来,我们每天使用中国电信(电脑)网络和中国移动(手机)网络的网络公共服务;从2026年开始,我们将每天使用“智能计算网络提供商”的“智力”公共服务。通过三天的学习基本搞明白了“如何用token消费来换取‘智力’服务”的原理、过程和前景,算是为这一新服务的到来做好准备:大模型已经在那里了,你要做什么来适配它。 未来十分有趣,一旦智力可以低价采购,相当于智力就有了杠杆效应、被放大了,人的学习方式和学习目标、工作方式和工作目标都发生巨大变化。最大的挑战是如何正确和有效的使用智力,毕竟不同人开同一款跑车的车况、用途和效果也完全不同。另外,大模型厂商和智力计算基础设施提供商做当红炸子鸡的日子应该也不能一直持续,因为智力服务虽然现在很紧缺,但过几年也将可能供需趋稳、进而变得可能供给过剩和消费不完,就像电力服务作为标准化产品它不可能永远稀缺,让我们拭目以待“不确定性”的精彩未来。 谢谢阅读,后面想讲一讲AI时代的3D模型设计、工业世界模型或者AI4M。