ARTICLE · 1141798
新致软件在 IEEE Access 发表中文法律大模型评测研究论文
学术成果
技术前沿
关于 IEEE Access
NEWTOUCH
IEEE Access 是 IEEE 旗下的多学科全开放获取期刊,面向相关领域发表原创研究与技术开发成果,覆盖计算机科学、电气与电子工程等方向。该刊采用同行评审机制,重视应用导向和跨学科研究,为人工智能技术与专业领域结合的研究提供学术交流平台。
01
Newtouch-LawBench
Newtouch-LawBench 以认知分层与专家校准推进法律 AI 能力诊断。
论文链接:https://ieeexplore.ieee.org/document/11683426
「点击文章底部『阅读原文』,即可查看」
NEWTOUCH
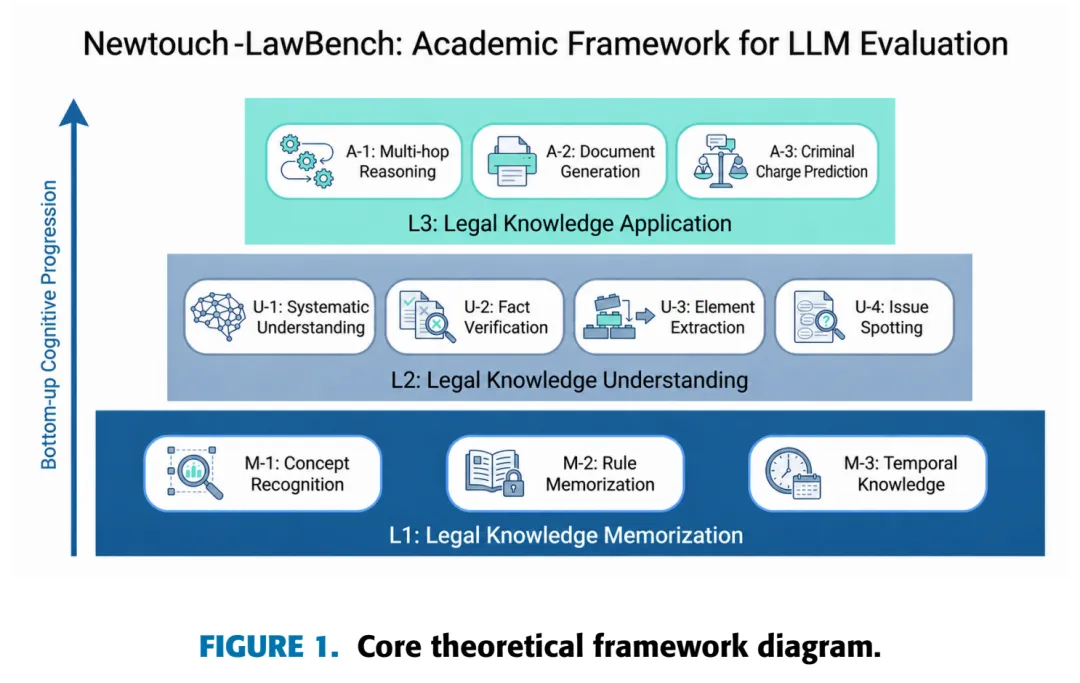
上海新致软件股份有限公司完成的论文《Diagnosing Chinese Legal LLMs Across Memorization,Understanding,and Application:The Newtouch-LawBench Benchmark》发表于国际学术期刊 IEEE Access。研究面向中文成文法场景,提出法律大模型诊断性评测基准 Newtouch-LawBench,将认知分层、任务级能力分析与专家校准评价纳入统一研究框架。
该基准覆盖 3 个认知层级、10 项核心任务和 7,673 条标注样本,并通过 14 个代表性大语言模型的系统实验,刻画模型在知识召回、文本理解、规则应用与法律生成等任务中的能力差异,为法律 AI 的专业评价与研发优化提供实证依据。
02
现有评测的局限与研究目标
既有研究已将法律能力组织为记忆、理解和应用三个认知层级,为中文法律评测奠定基础。
在此基础上,面向专业应用的评测仍需进一步处理三个问题。
01
综合得分对具体能力差异的解释不足
模型可能擅长抽取显式字段,却难以识别争议焦点;也可能能够解释法律概念,却无法准确复述条文。仅观察综合结果,难以判断后续优化应聚焦知识精度、事实理解还是规则应用。
02
开放式法律输出的专业质量难以充分表征
咨询答复和合同文本往往允许多种合理表达,文本相似度难以完整反映依据可靠性、条款完整性及风险分配等要求,需要与具体任务相适配的多维评价机制。
03
不同任务的测量目标和评价成本存在差异
单选判断、信息抽取和长文本生成使用不同指标,样本规模也不相同。将这些分数汇总时,需要明确综合指标的测量目的,避免样本量差异掩盖重要的专业能力。
Newtouch-LawBench 围绕上述问题,将法律实践要求落实为任务定义、质量维度和聚合规则。其诊断性主要体现在跨任务能力画像及薄弱环节识别,而非对模型内部认知机制的直接测量。
03
对 AI 与法律行业应用的启示
Newtouch-LawBench 的结果为模型研发与专业应用提出了以下方向。相关应用效果仍需在实际系统与业务数据中验证。
1、以法律任务结构支撑模型选型
模型选型需要首先明确业务涉及哪些法律任务。例如,文书结构化侧重字段提取与依据识别,法律咨询侧重事实核验与依据支持,合同生成侧重必要条款与风险分配。围绕具体任务组合建立评价集,有助于将模型能力与业务需求对应起来,减少仅依据综合排名进行决策的局限。
2、同时检验知识检索与依据支持关系
法条复述结果提示,法律知识的精确调用值得作为独立环节验证。对于检索增强生成(RAG),需要检查检索材料的权威性、版本和适用语境,同时评价材料是否实际支持生成结论。已有法律检索研究对答案正确性和依据支持性的区分,为此提供了方法参照。
3、将专业质量要求融入法律生成流程
ECLQS 的启示在于,将法律专家关注的质量要求转化为可记录、可分析的评价维度。对于合同起草,可以围绕必要条款、条款一致性和风险分配建立专项检查;对于咨询答复,可以结合内容覆盖、引用依据和风险提示开展复核。维度化评价有助于定位问题,但高分本身不等于法律正确性或合同可直接使用的保证。
4、建立人机协同与持续评测机制
随着模型版本、法律规范和业务数据变化,专业应用需要保留任务级测试与回测记录,并将自动评分与法律人员复核相结合。最高人民法院《关于规范和加强人工智能司法应用的意见》提出辅助审判、透明可信等原则,要求相关环节能够接受可解释、可测试、可验证的审查评估。在司法辅助场景中,可复核的能力证据应与明确的专业责任共同构成应用基础。
总结
NEWTOUCH
Newtouch-LawBench 将中文法律实践中的能力要求落实为分层任务,以专家校准方法补充开放式生成评价,并通过跨模型实验呈现任务表现的差异。研究使法律知识、事实理解与规则应用等专业要求能够进入模型评测和迭代的具体流程,为法律 AI 的能力分析提供了可复核的方法与数据基础。
这项成果展现了新致软件与合作研究人员在法律任务建模、专业数据建设和大模型评价方法上的研究积累。基准数据、推理与评分脚本及评测结果的公开,也为学术研究与行业实践之间的后续验证、比较和改进提供了条件。