ARTICLE · 1149467
Token经济学|AI时代下数据的重要性
Token经济学|AI时代下数据的重要性写在前面: 2026年3月,一个技术术语有了官方中文名。国家数据局局长刘烈宏宣布,Token的中文译名定为“词元”——“智能时代的价值锚点,连接技术供给与商业需求的结算单位”。 同一个月,一个数字引发行业震动:截至3月,中国日均词元调用量突破140万亿,相比2024年初增长超过1000倍。OpenRouter数据显示,中国AI大模型的周调用量连续多周超越美国。 你每次向AI提问,都在“烧”Token。但真正值得追问的是:Token烧掉的到底是什么? 答案是数据。这篇文章想讲清楚一件事:Token让数据第一次可以被计量、被定价;而高质量数据的稀缺,正在让数据从“资源”变成“资产”。看懂Token经济学,关键不在Token,在于数据。 
Token是大模型处理信息的最小单位。一句话在进入模型之前,会被切成一串Token;模型算完,再把结果Token拼回句子。一个英文单词可能对应一个或多个Token,一个汉字也可能被拆分。 它原本只是技术文档里的一个计量单位,如今却成了AI时代的“通用货币”。为什么?因为有了计量单位,才有计价、交易和核算——就像电力按“千瓦时”计价,石油按“桶”计价,货物靠“集装箱”标准化。 2026年3月的GTC大会上,英伟达CEO黄仁勋正式提出“Token经济学”:未来的数据中心不再是存储数据的机房,而是“生产Token的工厂”;Token将按速度和智能程度分层定价,从约1美元到150美元每百万Token,跨度150倍;他甚至宣布,会给工程师发放相当于基本工资一半的Token预算,让Token成为继工资、奖金、期权之后的“第四种薪酬”。 Token,从技术术语变成了经济标尺。 
为什么同样一个Token,价格能差上百倍? 一位从业者的比喻很直接:用公开数据,Token烧在“试错”上;用专业数据,Token烧在“创造价值”上。前者是成本,后者是投资。 这背后是一条价值链条:输入价值→电能→算力→Token→生产力→输出价值。Token是连接算力与生产力的枢纽,但Token能释放多少价值,取决于它“吃进去”的数据和它服务的场景。有行业观察指出,大约5%的Token创造了80%的价值——用于编程、金融、科学研究等关键场景的Token,远不是聊天场景能比的。 所以Token经济学真正的上游是数据。Token是“产量”,数据才是“矿藏”。矿藏的质量,直接决定Token的含金量。 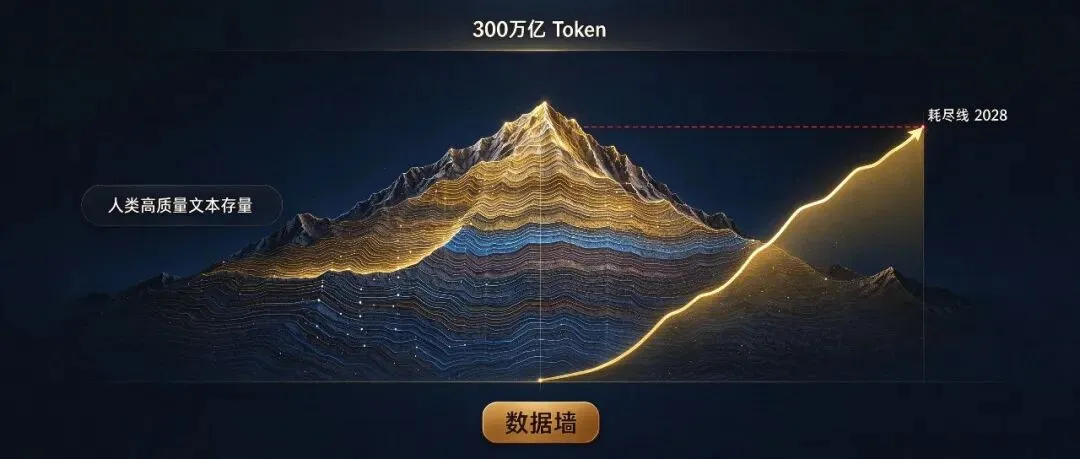
AI对数据的需求有多猛?斯坦福HAI《2025 AI Index》显示,训练计算量每5个月翻一倍,数据集规模每8个月翻一倍。自2020年以来,大模型训练数据量增长了100倍:GPT-3用了3000亿Token,GPT-4估计用到12万亿,Llama 3和DeepSeek-V3已经逼近15万亿——而下一代模型按扩展律测算,可能需要60到100万亿。 人类生产数据的速度远远跟不上。Epoch AI(经ICML 2024同行评审)测算:互联网上高质量、可公开获取的人类文本,总存量约300万亿Token;如果按当前趋势持续,训练数据集规模将在2026到2032年间与之持平,中位预测约2028年。马斯克2025年初就说:“人类知识的累积总和,已基本在AI训练中被耗尽。” 更麻烦的是,存量在被“上锁”。MIT牵头的“数据溯源计划”发现,短短一年内,约25%的最高质量来源(《纽约时报》、Reddit、Stack Overflow等)被施加了访问限制——被锁住的不是边角料,恰恰是最值钱的那部分。互联网文本年增速不足10%,而训练数据集每年翻倍。粮仓没见底,但最好的几袋粮食被人上了锁。 这堵“数据墙”,就是Token经济学的供给瓶颈。 面对数据墙,行业的第一反应是“造数据”。合成数据市场高速增长,英伟达在2025年以约3.2亿美元收购合成数据公司Gretel.ai。有机构预测,到2030年,AI模型使用的绝大部分数据将由AI生成。 但合成数据有一个被低估的风险:模型自噬。2023年一项研究用“Model Autophagy Disorder”(模型自噬失调,缩写恰好是MAD)描述这种现象——当AI用AI生成的数据训练自己,递归循环会巩固错误、放大偏见,甚至让模型“坍缩”退化。斯坦福AI指数2026确认,新发布的互联网内容中,AI生成已超过半数。人类原生、经过验证的数据,正在变得前所未有的稀缺。 合成数据是补充,不是替代。真正有长期价值的,依然是那些干净、真实、经过验证的数据。 数据墙的出现,对不同角色的意义完全相反:对模型厂商是危机,对手握行业数据的企业是一次资产重估。 几个信号正在印证: 政策层面,2026年6月国家数据局印发《关于推进行业高质量数据集建设行动的实施方案》,明确提出探索“词元交易”等新型交易模式——数据的计量单位,正在从“条数”和“GB”变成模型实际消耗的词元。 市场层面,数据赛道全面提速:数据采集与标注市场预计从2025年的32亿美元增至2030年的171亿美元,合成数据从2023年的2.18亿美元增至2030年的17.88亿美元。 企业层面,一句提醒很关键:有数据,不等于有“AI就绪数据”。同一个“客户”在CRM、ERP、售后系统里是不是同一个编码?十年设备记录中间换过几次单位?原始数据和可用数据之间,隔着一道加工工序。 Token经济学走到今天,底层逻辑已经清楚:Token是表象,数据是本质。谁拥有高质量、可机读、独占性的数据,谁就拥有了AI时代最稀缺的生产要素。 以后判断一家AI公司或一个数据资产有没有价值,可以看四件事:数据是否稀缺(别人拿不到)、质量是否过硬(能直接训练)、是否AI就绪(结构化、可机读)、是否独占(壁垒够深)。 对普通读者,这件事的意义同样直接:AI让你更轻松,但真正决定AI上限的,是它背后那个持续产出数据、验证数据、治理数据的世界。数据不会凭空产生——每一个认真生活、认真记录、认真创造的人,都在为这个世界的“数据资产”添砖加瓦。 这或许才是“数据的重要性”最朴素的答案:AI吃掉的每一口智能,都来自人类真实世界的沉淀。
以上就是本次 AI 内容的全部分享。这里是AI业态实验室, 大家对 AI 技术、行业趋势、落地应用有任何想问的、想探讨的,都可以下方留言。我会长期关注评论区,定期精选问题做深度拆解和专属解答,期待和大家一起交流学习。也欢迎私信小助手添加AI行业交流群。
一、先搞清楚:Token为什么突然成了硬通货
二、Token经济学的真相:Token只是中间物,数据才是上游
三、数据墙:AI正在逼近人类高质量数据的边界