ARTICLE · 1154316
Linux 6.12 源码深度剖析: vfs_read
Linux 6.12 核心子系统深度剖析:VFS 读操作核心 vfs_read 架构与源码级解析
📌 技术点速览
在 Linux 内核中,vfs_read 函数是 VFS(Virtual File System,虚拟文件系统层) 的核心枢纽与流量闸口。它解决了用户空间统一读接口与底层多样化文件系统(如 ext4、xfs、sysfs、procfs 等)及设备驱动之间解耦与高效对接的问题。
vfs_read 处于系统调用层(System Call Interface)与具体文件系统实现层(Concrete Filesystem Layer)之间。作为承上启下的桥梁,它不仅负责通用的安全边界检查、文件锁校验和 I/O 流量统计,还负责将抽象的读请求分发给底层的具体文件系统操作集。
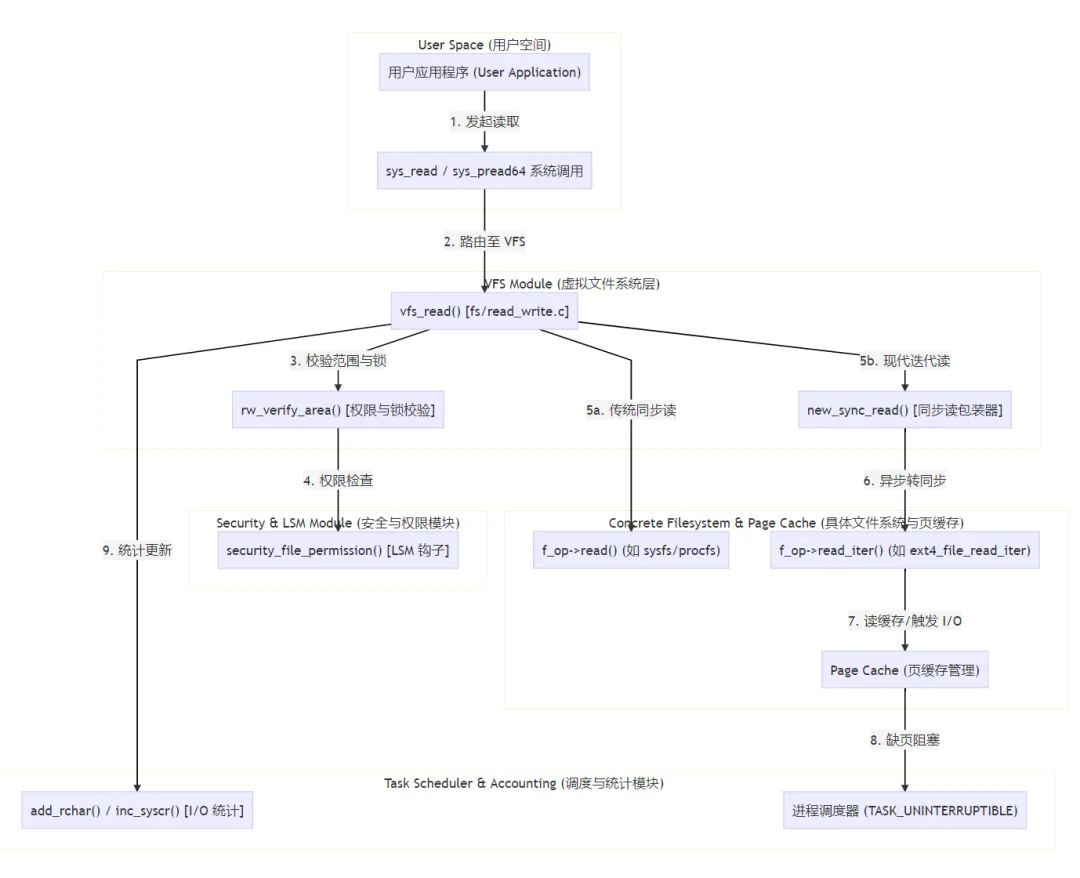
🗺️ 软件功能架构图
以下架构图展示了 vfs_read 在 Linux 内核中的位置,以及它如何跨越不同的软件模块进行协同工作。
🔍 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 内核中,vfs_read 的实现位于 fs/read_write.c。以下是该函数的完整源码及逐行硬核解析:
ssize_t vfs_read(structfile *file, char __user *buf, size_t count, loff_t *pos){ssize_t ret;/** 1. 基础权限校验:检查文件是否以可读模式打开。* f_mode 中的 FMODE_READ 标志是在 open 系统调用时根据 O_RDONLY/O_RDWR 设置的。* 如果未设置,直接返回 -EBADF (Bad file descriptor)。*/if (!(file->f_mode & FMODE_READ))return -EBADF;/** 2. 检查文件是否支持读取操作。* 例如,某些特殊的设备文件或未完全初始化的文件对象可能不具备 FMODE_CAN_READ 属性。*/if (!(file->f_mode & FMODE_CAN_READ))return -EINVAL;/** 3. 内存安全校验:access_ok 是一个架构相关的宏(在 arm64 和 x86 上实现不同)。* 它用于确保用户空间传入的缓冲区指针 `buf` 及其长度 `count` 确实属于用户空间地址范围,* 防止恶意用户传入内核空间地址,从而利用内核权限读取内核敏感数据(防御 Meltdown 等漏洞或内核越界写)。*/if (unlikely(!access_ok(buf, count)))return -EFAULT;/** 4. 范围与文件锁校验:* 调用 rw_verify_area 检查读取范围是否越界,并处理强制锁(Mandatory Locks)。* 同时,该函数内部会触发 LSM (Linux Security Module) 的 security_file_permission 钩子,* 进行 SELinux/AppArmor 的微粒度权限检查。*/ret = rw_verify_area(READ, file, pos, count);if (ret)return ret;/** 5. 限制单次读取的最大字节数:* MAX_RW_COUNT 定义为 (INT_MAX & PAGE_MASK)。* 限制单次 I/O 大小是为了防止单次系统调用占用 CPU 时间过长,导致调度延迟,* 同时避免底层驱动在处理超大块 I/O 时发生整型溢出。*/if (count > MAX_RW_COUNT)count = MAX_RW_COUNT;/** 6. 核心分发逻辑:* 现代 Linux 内核推荐使用 read_iter(异步迭代读),但为了兼容老旧文件系统,* 依然保留了传统的 read 回调。*/if (file->f_op->read)/* 6a. 如果底层文件系统实现了传统的 read 接口,直接调用 */ret = file->f_op->read(file, buf, count, pos);else if (file->f_op->read_iter)/** 6b. 现代文件系统(如 ext4, xfs)通常只实现 read_iter。* new_sync_read 会在栈上构建 struct kiocb(Kernel I/O Control Block)* 和 struct iov_iter,将同步读请求包装成异步迭代读的形式传给底层。*/ret = new_sync_read(file, buf, count, pos);else/* 6c. 如果两者皆未实现,说明该文件不支持读取 */ret = -EINVAL;/** 7. 后置处理与事件通知:* 如果成功读取了数据(ret > 0):* a. fsnotify_access: 触发 inotify/fanotify 事件,通知用户空间监听者该文件已被读取。* b. add_rchar: 将读取的字节数累加到当前进程的 I/O 统计指标中(/proc/[pid]/io 中的 rchar)。*/if (ret > 0) {fsnotify_access(file);add_rchar(current, ret);}/** 8. 增加系统调用计数:* 无论读取成功与否,都增加当前进程的 syscr(system call read)计数。*/inc_syscr(current);return ret;}
🛠️ 核心设计哲学与模块职责体现
抽象与多态(Polymorphism):
file->f_op->read和file->f_op->read_iter是典型的 C 语言多态实现。VFS 模块不关心底层是磁盘文件、网络套接字还是内存文件系统,它只负责定义规范,具体的读取动作通过函数指针分发给具体模块。防御式编程与安全边界:
access_ok的使用体现了内核对用户空间数据的不信任。在 arm64 架构下,access_ok仅做简单的地址范围检查(检查地址是否小于TASK_SIZE_MAX),真正的安全保护依赖于硬件特性(如 arm64 的 PAN (Privileged Access Never) 机制),在内核态试图非法访问用户态数据时触发硬件异常。同步与异步的统一:
new_sync_read的存在是 VFS 演进的杰作。它将同步的read系统调用,在 VFS 层无缝转换为基于kiocb的异步 I/O 接口(read_iter),使得底层文件系统只需要实现一套read_iter即可同时支持同步 I/O(read)和异步 I/O(io_uring/aio)。
⚙️ 系统运行背景与上下文
vfs_read 它是 Linux 内核中多个子系统协同作战的交汇点。
1. 与内存管理子系统(Memory Management)的协同
当 vfs_read 调用 new_sync_read 并最终进入具体文件系统的 read_iter(例如 ext4_file_read_iter)时,它会深度依赖页缓存(Page Cache):
缓存命中(Cache Hit):
filemap_read会在 Page Cache 中查找对应的struct folio。如果页面存在且处于Uptodate状态,内核直接调用copy_to_user将数据从内核页缓存拷贝到用户空间的buf中。整个过程不发生物理 I/O。缓存未命中(Cache Miss)与同步阻塞:如果页面不存在,内核会触发同步预读(Readahead),分配新的内存页面,并构建
bio请求提交给块设备驱动。此时,当前进程会被调度器设置为TASK_UNINTERRUPTIBLE状态(即 D 状态),让出 CPU,直到磁盘控制器通过中断宣告数据传输完成,唤醒该进程。
2. 与进程调度器(Scheduler)的协同
在 I/O 密集型场景下,vfs_read 是进程状态切换的催化剂:
自愿调度:在读取大文件或发生 Page Cache 缺失时,底层驱动(如 NVMe 驱动)在等待硬件 DMA 传输时会调用
io_schedule()。这会暂时挂起当前任务,调度器将 CPU 资源分配给其他就绪任务,从而最大化 CPU 利用率。抢占与延迟:
vfs_read内部的access_ok和copy_to_user可能会触发用户态缺页异常(User Page Fault)。如果用户传入的buf尚未分配物理内存,内核会在vfs_read的上下文中挂起当前进程,优先处理缺页异常,分配物理页后再恢复读取。
3. 与安全子系统(LSM)的协同
在 rw_verify_area 内部,内核会调用 security_file_permission。这会触发注册的 LSM 模块(如 SELinux、AppArmor 或 Landlock):
动态策略检查:安全模块会根据当前进程的 Credential(证书/权限)和文件的安全上下文,判断该读取操作是否合规。如果违反策略,直接在 VFS 层拦截并返回
-EACCES,绝不干扰底层文件系统。
💡 10年老兵避坑指南/实战案例
🚨 生产案例:高并发下 new_sync_read 导致的线程暴涨与系统雪崩
1. 现象描述
在一个基于 Go 语言开发的高并发分布式存储服务中,当底层机械硬盘(HDD)或网络存储(NFS)出现抖动、I/O 延迟飙升时,监控显示系统 CPU 使用率没有明显变化,但系统线程数(OS Threads)呈指数级暴涨,最终导致文件描述符耗尽、内存溢出(OOM)以及服务彻底瘫痪。
2. 深度病因分析
Go 语言拥有强大的 M:N 协程调度器(Goroutine)。然而,当 Goroutine 发起同步读操作(如 os.File.Read)时,Go 运行时会将其转化为底层的 read 系统调用,进而进入内核的 vfs_read。在内核态中,执行路径如下: vfs_read() ➡️ new_sync_read() ➡️ ext4_file_read_iter() ➡️ filemap_read() ➡️ 触发磁盘 I/O ➡️ 进程进入 TASK_UNINTERRUPTIBLE 状态。
由于底层存储介质响应极慢,该内核线程被长时间阻塞在 D 状态。Go 运行时的监控线程(sysmon)检测到有 OS 线程被系统调用阻塞超过 10ms,为了保证其他 Goroutine 不被饿死,会立即释放当前的 P(Processor),并创建/唤醒一个新的物理线程(M)来接管剩余的协程。
在高并发读取场景下,这种“阻塞 ➡️ 新建线程 ➡️ 再阻塞 ➡️ 再新建线程”的恶性循环会被无限放大,导致成千上万的物理线程被创建,内核频繁进行上下文切换,最终压垮系统。
3. 性能调优与排查实战
A. 使用 bpftrace 实时定位阻塞在 vfs_read 的慢 I/O
我们可以编写一个简单的 eBPF 脚本,追踪 vfs_read 的耗时分布,找出是哪些文件、哪些进程在拖慢系统:
# vfs_read_latency.btkprobe:vfs_read{@start[tid] = nsecs;@filenames[tid] = parameter(0); // 暂存 file 结构体指针}kretprobe:vfs_read/@start[tid]/{duration_us > 50000) { // 只记录耗时超过 50ms 的读操作$file = (struct file *)@filenames[tid];$dentry = dentry->d_name.name), $duration_us);}delete(@start[tid]);delete(@filenames[tid]);}
运行该脚本,可以精准捕获导致内核线程阻塞的罪魁祸首。
B. 核心调优策略
1、拥抱异步 I/O (io_uring): 对于高并发 I/O 密集型应用,彻底废弃传统的同步 vfs_read。改用 Linux 5.1+ 引入的 io_uring。io_uring 在内核中维护提交队列和完成队列,读取操作完全异步化,不会阻塞用户态物理线程,从根本上解决了 Go 运行时线程暴涨的问题。
2、调整预读参数(Readahead): 如果是顺序大文件读取,可以通过增大块设备的预读大小来减少 Page Cache 未命中导致的阻塞:
# 查看当前预读大小(单位:512字节扇区,默认 256 即 128KB)blockdev --getra /dev/sda# 临时调整为 4096 (2MB),显著提升顺序读吞吐量,减少 I/O 阻塞次数blockdev --setra 4096 /dev/sda