ARTICLE · 1165169
AI 渗透最缺的不是工具,是经验资产化
正文
大多数 AI 渗透工具的痛点不是“不会打”,而是:
打完就忘。
这次知道 SQLi 怎么打,下次换个目标又从零侦察;这次绕过了模板注入,下次还是靠模型临场发挥。工具在跑,经验没有沉淀。
RedBee 的 RED-KB 解决的就是这个问题:
把每次带 PoC 和 Evidence 的渗透结果,蒸馏成下次可检索的通用经验
先看数据
当前 RED-KB 里:
这里最关键的数字不是总量,而是:
有 case evidence 绑定、经过治理、能被
kb_query命中的经验在持续增加。
不是把报告堆进数据库,而是把“下次还能用的方法”沉淀下来。
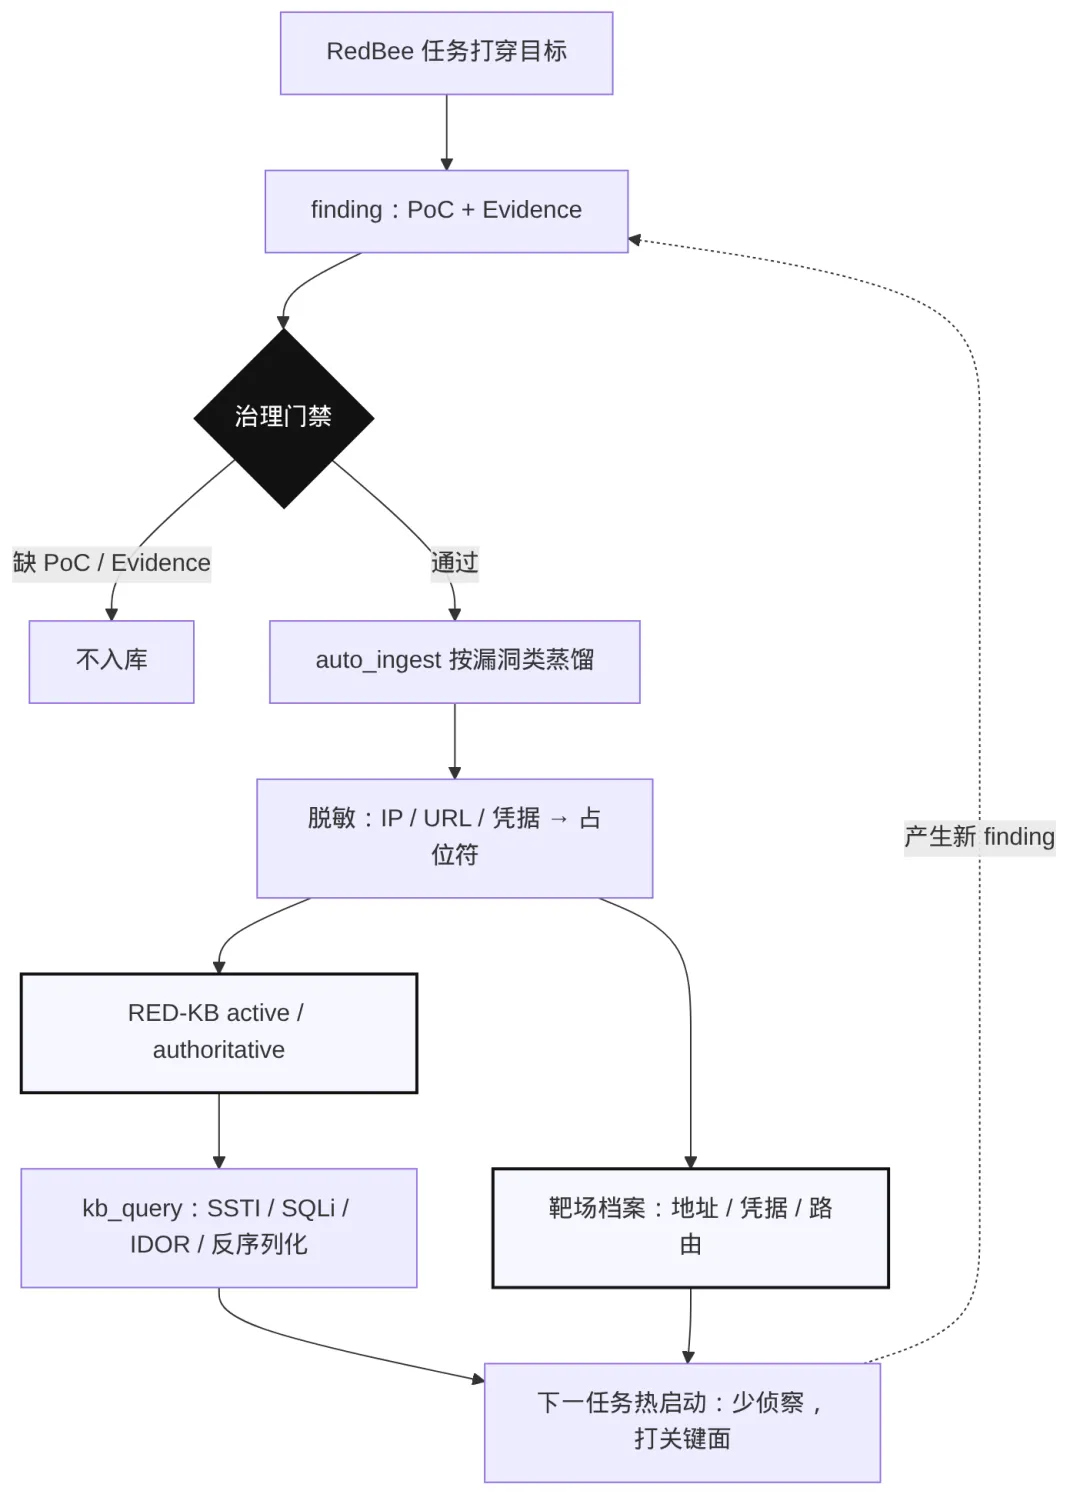
回流闭环长什么样
任务打穿目标
→ finding 带 PoC + Evidence
→ auto_ingest 按漏洞类蒸馏
→ governance 脱敏 + 门禁
→ RED-KB active / authoritative
→ 下次任务 kb_query 命中
→ 热启动,少侦察,直接打关键面
这个闭环里有四个关键点。
1. 空口漏洞不进库
不是 agent 说一句“这里疑似 SQLi”就入库。
入库要求很硬:
有 finding
有 PoC
有 Evidence
有 success signal
经过脱敏
通过治理门禁
换句话说:
没打穿的,不进经验库。
这和“把 LLM 输出全部存下来”完全不同。RED-KB 存的是被证据支持过的攻击经验,不是聊天记录。
2. 入库前要脱敏,避免变成靶场提词器
很多知识库看着很丰富,实际上只是“某靶场答案本”。换个目标就没用了。
RED-KB 的入库内容会做去标识化:
具体 IP      → <target>
具体 URL     → <url>
登录凭据     → 脱敏
靶场路径     → 抽象成方法/条件
比如一条 SSTI 经验,不是保存:
XBEN-080 的 /submit name 字段可以打
而是沉淀成:
当用户输入进入模板渲染上下文时,
优先测试模板语法、对象访问和命令执行边界。
这样下次遇到别的模板渲染入口,也能用上。
3. 通用知识进 KB,靶场情报进档案
这里有一个很重要的是分层:
data/targets/*.md |
这样做的好处是:
KB 保持可迁移; 靶场档案保持具体; 下次打同一靶场可以热启动; 打同类新靶场也可以复用通用方法。
如果全塞进一个 KB,最后往往变成一个又大又脏、检索不准的文本堆。
4. 检索命中才是真回流
入库不算完,能被下次任务检索到才算完。
RED-KB 支持:
POST /kb/query
例如:
查询:Jinja2 SSTI os.popen 模板注入
命中:ssti validation technique

查询:PHP phar insecure deserialization
命中:deserialization validation technique

查询:IDOR password change cross-user
命中:idor validation technique
这些命中的不是“某道题的答案”,而是可迁移的方法。
任务派发时,平台可以把命中方法注入到子 agent 的情报块里,让模型少做重复侦察,直接把火力放到关键攻击面。
一个真实闭环
以 XBEN 这批靶场为例:
XBEN-080:Jinja2 SSTI
XBEN-081:PHP 反序列化
XBEN-092:phar 上传 + 反序列化 RCE
这些任务打穿后,不是只留下 3 条 finding,而是补进了 RED-KB:
ssti validation technique
deserialization validation technique
rce validation technique
upload validation technique
下次再遇到模板渲染、cookie 对象反序列化、phar/上传触发链,平台可以先查 KB,再决定怎么打。
这就是“越打越快”的来源。
和 Skill 库的关系
RedBee 里其实有两层“经验”:
Skill 教模型“这类问题应该怎么想”,RED-KB 告诉模型“这种病人我们实际怎么治好了”。
两者叠加,才是完整的经验系统。
一句话总结
报告是结果,RED-KB 是资产。
RedBee 不只是把渗透任务跑完,而是把每一次有效打穿,变成下一次的热启动。