ARTICLE · 1165470
没碰剪辑软件!我让Claude自动剪出了一条视频【流程全公开】
先说结论:下面这条 77 秒的视频,我一次剪辑软件都没打开过。
文案、配音、字幕、画面、背景音乐,连封面和发布标题,都是 Claude 做的。
不是"AI 辅助剪辑",是压根没有剪辑这一步。
这条视频里,哪些是 AI 干的
全部。按出场顺序数一遍:
·文案:不到 400 字的口播稿,外加发布标题、简介、话题
·配音:豆包语音合成,一共 19 句
·字幕:按配音的逐字时间戳对齐,不是估出来的
·画面:19 个镜头。6 个是角色场景,小机器人会自己走进画面、换动作;13 个是黑底的动态图表
·背景音乐:从我的曲库里按文案的情绪挑了一首,人声一出来自动压低
·封面:一整张手绘海报,胶片格子里画的就是成片里的真实镜头
·剪辑:没有
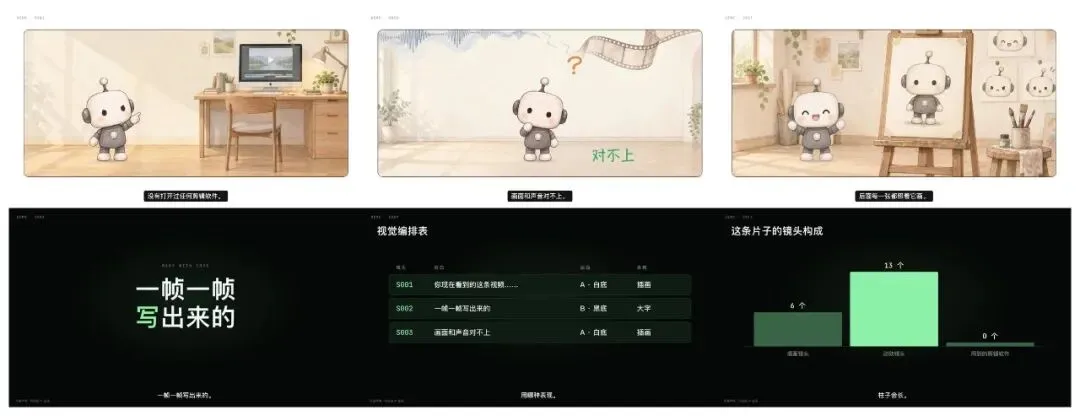
先看成片,再往下讲它是怎么来的。
不剪,那视频是哪来的
是写出来的。
网页本来就会动。把一个会动的网页一帧一帧截下来,再连起来,就是视频。
所以 Claude 写的不是剪辑工程,是一个网页:哪一秒出现什么、怎么动,全在代码里。然后用 HyperFrames(HeyGen 开源的工具)逐帧截图,合成 MP4。
这带来一个很爽的结果:改视频就是改一行字。想换一句文案、挪一个镜头、把角色调大一点,改完重新出片就行,不用在时间线上拖来拖去。
整套流程只有 3 步,顺序错一步就全乱
这也是这条视频本身在讲的事:
① 先配音。 声音有多长,镜头就有多长。先做画面再配音,就像先把布裁好,再去量身高。很多人第一次做,画面和声音对不上,就是栽在这里。
② 再做编排表。 每一行是一个镜头:说什么、放什么画面、用哪种表现。Claude 按表执行,不临场发挥,画面才稳。
③ 最后才生成画面。 角色和场景交给生图模型,图表和文字交给网页动效。
让角色自己走起来,是最折腾的一步
大多数 AI 讲解视频里,角色是一张不动的图。我想让它走进画面。
第一版很直接:让模型画两张走路的图,来回切换。结果像在地上滑行,头还一跳一跳的。
后来换了思路,学皮影戏:让模型把角色拆成三个零件画出来,身体、一条腿、一条手臂。再用代码把它们接上,腿绕着关节前后摆,手臂反着摆,每一步迈多远按腿长算,脚就不打滑了。
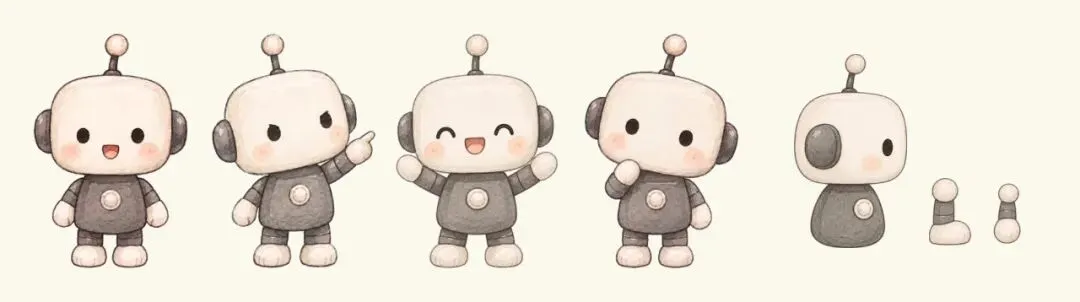
左边四个是到位之后的动作,右边三块就是走路用的零件。所有角色图都画在绿幕上,再抠成透明底,这样它才能站进任何一个场景里。
接起来之后,走进画面是这样的:
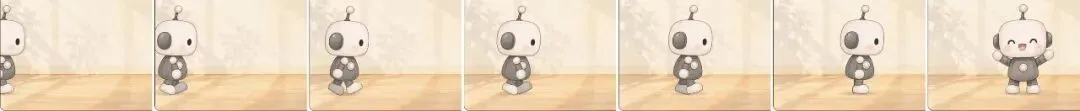
这套角色图只用生成一次。同一个角色做下一条视频,直接拿来用。
再说三个差点翻车的地方
字幕凭空消失。 渲染出来的成片,底部少了一截,黑底镜头的字幕整行不见了,可预览截图里一切正常。查到最后,是浏览器在后台运行时,可视区域比设定的矮了 90 个像素。
背景音乐小到听不见。 第一版太保守,人声一出来音乐被压得太狠。后来把整体音量提上去,压低的幅度减半。
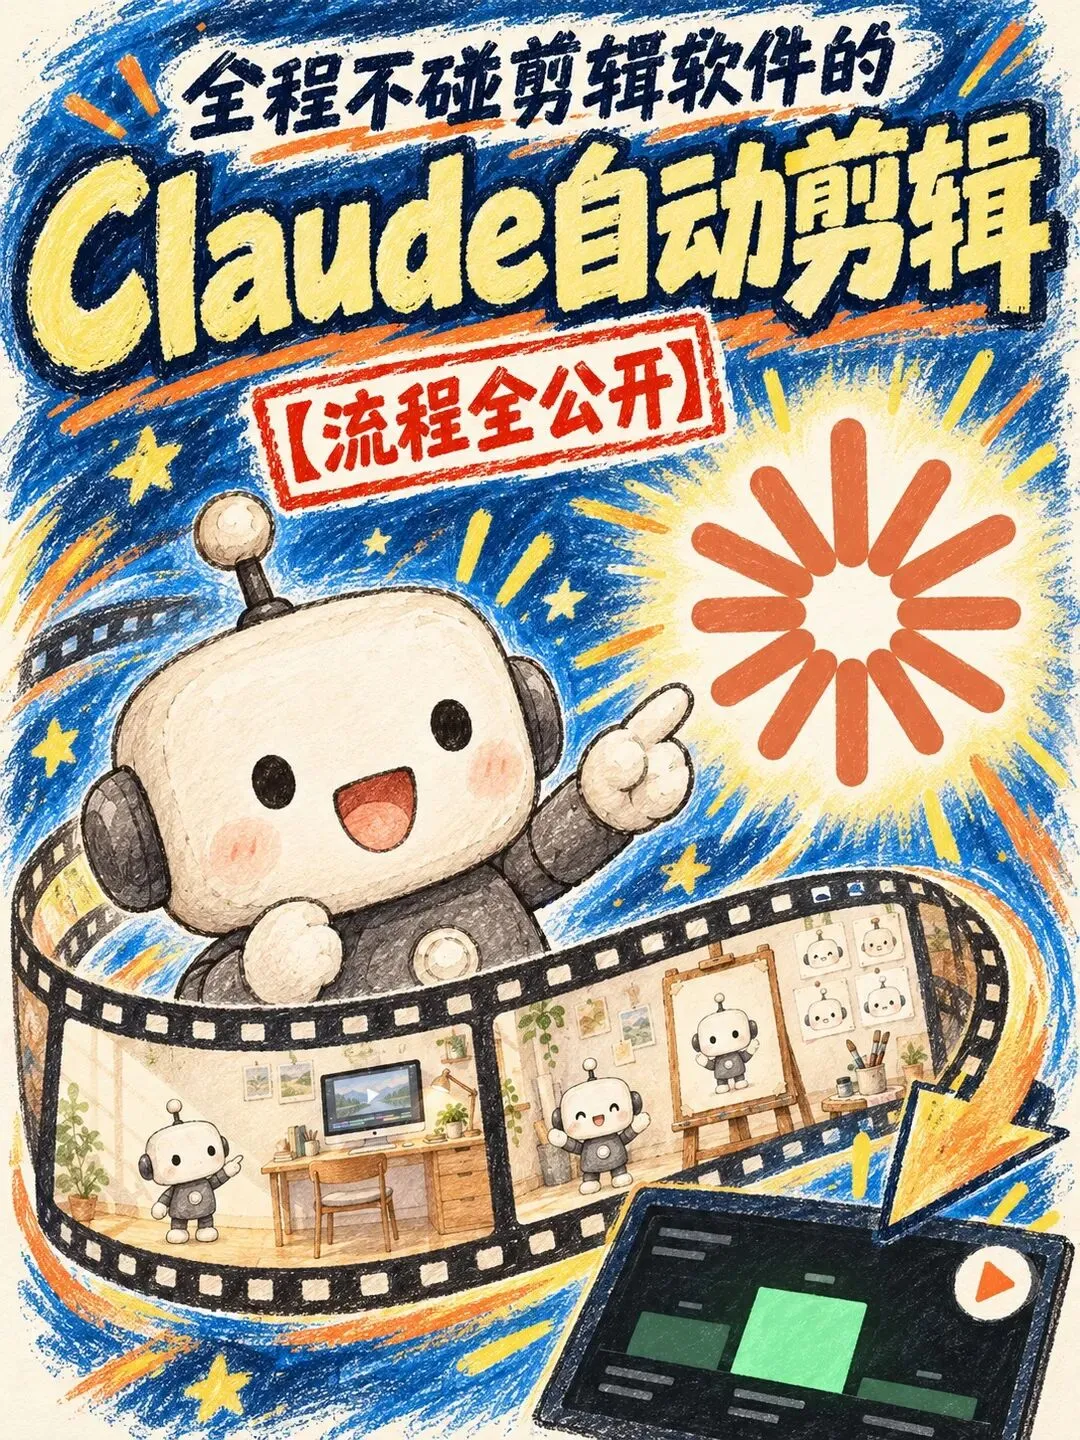
封面太平。 第一版是"一张图上压一行字"。后来改成整张海报一次画出来,胶片从角色身后绕到身前,层次才出来。而且封面里的画面必须取自成片的真实镜头,不能放无关的装饰图。
我把它做成了一个 skill
以上这些,现在打包成了一个 skill,Claude Code 和 Codex 都能装。(这条片子是用 Claude 跑的,所以封面上是 Claude 的图标;用 Codex 跑,就是 Codex 的。)
用法是一句话:
用 explainer-video 做一条讲解视频,主题是……
它只在两个地方停下来等你:
1开头问你要哪种风格,一共三种:角色场景配动态图表、黑白手绘白板、界面卡片配截图标注
2文案写完给你确认,连同标题、简介、封面文字一起
你点头之后,配音、配乐、生图、出片、封面、发布文案,它自己跑完。
交到你手上的是一整套:成片、竖版和横版封面、可以直接复制的标题和简介。
几个实际的数:
·这条 77 秒的片子,在我的 M1 Pro 上渲染大约 5 分钟
·同一个角色再做一条,大概要生成 6 张图:5 张场景背景,1 张封面
·配音改一句只重新合成那一句,其余不动
用到的东西也交代一下:写代码和统筹是 Claude Code,出片是 HyperFrames,配音是火山引擎的豆包语音,生图走的是我自己的 HRouter 画布。
最后
这条视频讲的是"AI 做视频的顺序",而它自己就是按这个顺序做出来的。
你最想让 AI 替你做哪种视频?评论区告诉我,下一条就做它。