ARTICLE · 1177319
Netty HTTP/1.1 编解码源码:请求如何在 Pipeline 中被拆装(源码系列第17篇)
Netty 不会天然把一个 HTTP 请求变成一个
FullHttpRequest。HttpServerCodec的入站 Decoder 按状态机产出HttpRequest、若干HttpContent和LastHttpContent,出站 Encoder 再把响应对象编码成字节;HttpObjectAggregator只是可选的聚合层,用内存换取完整消息接口,并且必须设置上限。
HTTP/1.1 建立在 TCP 字节流上,同样存在半包、粘包和一次 read 包含多条消息的问题。除此之外,它还有请求行、Header、固定长度 Body、Chunked Body、100-continue、keep-alive 和 pipelining 等协议状态。一个健壮的 HTTP Codec 必须把这些状态逐步解析,不能假设一次 Socket read 就是一条请求。
源码基线:
• 项目:Netty • 版本: netty-4.1.135.Final• Commit: f05f765d81460799c53123a207f665bf3b465171• 重点模块: codec-http• 重点类与方法: HttpServerCodec、HttpObjectDecoder.decode、readHeaders、HttpObjectEncoder.encode• 官方源码:https://github.com/netty/netty/tree/netty-4.1.135.Final/codec-http/src/main/java/io/netty/handler/codec/http
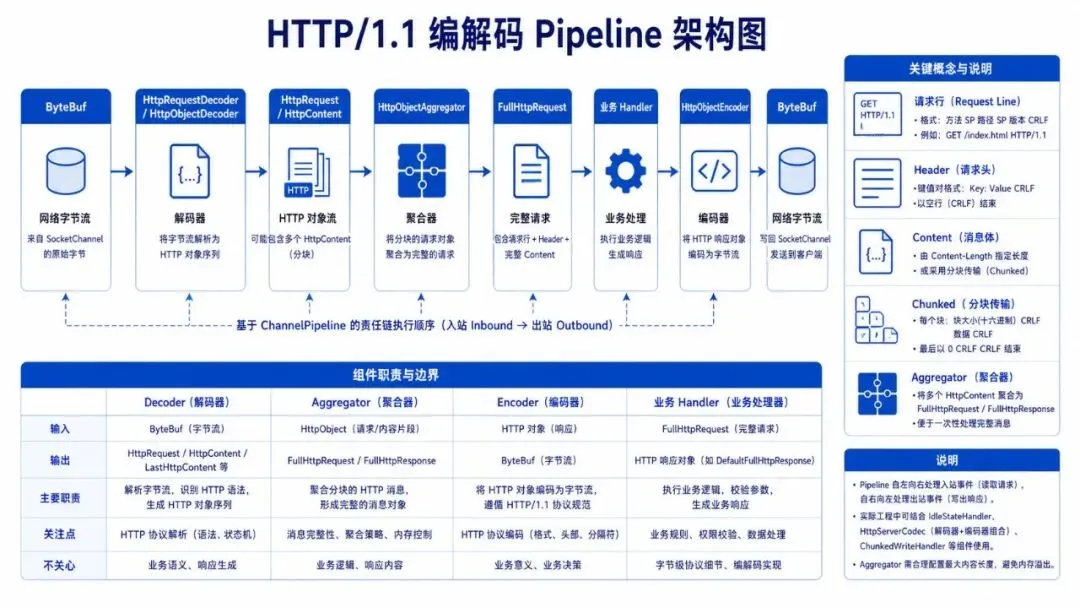
这张图展示了双向结构:入站字节先经过 HttpRequestDecoder,按对象流传播;可选 Aggregator 把多个对象聚成完整请求;业务返回 HttpResponse 和 Content,出站 HttpResponseEncoder 逆向编码。入站与出站共用一个 HttpServerCodec 外壳,但内部是两个 Handler。
1. HttpServerCodec 是入站 Decoder 与出站 Encoder 的组合
HttpServerCodec 继承 CombinedChannelDuplexHandler。构造时把请求解码器和响应编码器组合起来:
public HttpServerCodec(HttpDecoderConfig config) { init(new HttpServerRequestDecoder(config), new HttpServerResponseEncoder());}这说明服务端两个方向的职责不同:
• 入站: ByteBuf -> HttpRequest/HttpContent;• 出站: HttpResponse/HttpContent -> ByteBuf。
Pipeline 的方向规则仍与第 7 篇一致。请求从 Head 向 Tail 找入站 Handler,响应从当前 Context 向 Head 找出站 Handler。业务若在 Codec 之前调用 ctx.write,可能跳过响应 Encoder;初始化时应让协议 Codec 位于业务 Handler 前面。
2. Decoder 首先解析 initial line,再进入 Header 状态
HttpObjectDecoder 继承 ByteToMessageDecoder,内部状态机大致包括:
SKIP_CONTROL_CHARS -> READ_INITIAL -> READ_HEADER -> READ_FIXED_LENGTH_CONTENT -> READ_VARIABLE_LENGTH_CONTENT -> READ_CHUNK_SIZE -> READ_CHUNKED_CONTENT -> READ_CHUNK_DELIMITER -> READ_CHUNK_FOOTERdecode() 在 READ_INITIAL 阶段解析请求行:
METHOD SP URI SP VERSION CRLF例如:
POST /orders HTTP/1.1输入不足时状态机保留当前进度,等待下次 ByteBuf 累积。解析成功后创建 HttpMessage,再调用 readHeaders(buffer) 读取 Header。它不是对整段字符串做一次 split,而是受长度上限约束地增量解析。
3. Header 结束后,消息体边界由协议字段决定
Header 解析完成后,Decoder 根据状态和字段选择 Body 读取方式:
HttpRequestLastHttpContent | ||
Content-Length: N | HttpContent | |
Transfer-Encoding: chunked | ||
Content-Length 与 Transfer-Encoding 的组合必须严格校验,否则容易形成请求走私:前置代理和后端若对边界理解不同,同一串字节会被切成不同请求。实际部署必须保持 Netty 版本和代理安全策略更新,并避免在业务 Handler 中自行“修复”模糊报文。
4. Decoder 产出的是对象流,不保证完整请求
默认情况下,一次带 Body 的请求在 Pipeline 中类似:
HttpRequestHttpContentHttpContentLastHttpContent这样设计能流式处理大 Body,避免等待整条消息进入内存。文件上传、代理转发和大模型流式输入都更适合逐块消费。
业务 Handler 必须管理对象生命周期:HttpContent 持有引用计数 ByteBuf,消费后需要释放,转交下游则由下一层接管。使用 SimpleChannelInboundHandler<HttpObject> 可以在约定范围内自动释放,但若 retain 后异步使用,仍要确保最终 release。
5. HttpObjectAggregator 用便利换内存
加入:
pipeline.addLast(new HttpServerCodec());pipeline.addLast(new HttpObjectAggregator(1024 * 1024));pipeline.addLast(new BusinessHandler());业务将收到 FullHttpRequest,Header 和完整 Body 在一个对象中,普通 JSON API 编程更简单。但聚合意味着:在完整 Body 到达之前,连接持有累积内存。
maxContentLength 是安全边界,不是随手写个很大数字。估算总风险:
峰值聚合内存 ≈ 并发上传连接数 × 单连接允许 Body 上限如果 1 万连接都允许聚合 10MB,理论风险远超常规堆和直接内存容量。大文件应流式落盘或转发,不应进 Aggregator。
6. 解码限制是协议防线,不只是性能参数
HttpDecoderConfig 可以配置请求行、Header、Chunk 等限制。至少关注:
• maxInitialLineLength:限制 URI 和请求行;• maxHeaderSize:限制全部 Header;• maxChunkSize:控制单次产出的 Content 大小;• Header 校验与重复 Content-Length 策略; • Chunk 扩展与 Trailer 限制。
限制过小会拒绝合法请求,过大则给慢速攻击和内存消耗留下空间。应根据网关规范、业务最大 Cookie/JWT、追踪 Header 和上传协议设定,并在边缘代理与 Netty 服务保持一致。
7. Encoder 需要知道响应是否包含 Body
出站通常写:
FullHttpResponse response = new DefaultFullHttpResponse( HTTP_1_1, OK, content);response.headers().set(CONTENT_LENGTH, content.readableBytes());ctx.writeAndFlush(response);HttpResponseEncoder 根据状态码、方法语义和 Header 决定是否编码 Body,以及采用固定长度还是 chunked。HEAD、204、304 等响应不能简单按普通 Body 处理。
HttpServerCodec 的 request decoder 还会记录请求方法队列,响应 encoder 可据此正确处理 HEAD 等语义。HTTP/1.1 同一连接上的请求和响应顺序不能随意打乱,否则方法与响应边界会错配。
8. Keep-Alive 依赖消息边界与连接策略共同成立
HTTP/1.1 默认倾向持久连接,但前提是双方能准确知道一条消息何时结束。若响应既没有 Content-Length,也没有 chunked,往往只能靠关闭连接界定 Body,连接就无法继续复用。
服务端通常:
boolean keepAlive = HttpUtil.isKeepAlive(request);if (keepAlive) { response.headers().set(CONNECTION, KEEP_ALIVE); ctx.writeAndFlush(response);} else { ctx.writeAndFlush(response).addListener(ChannelFutureListener.CLOSE);}关闭动作绑定写 Future,确保响应有机会先发出。若直接 ctx.close(),缓冲中的最后响应可能被截断。
9. HTTP Pipelining 仍要求响应顺序
客户端可以在前一个响应返回前发送后续请求。Decoder 能连续产出多个请求,但业务若把请求并发分发到线程池,完成顺序可能改变。
HTTP/1.1 同连接响应必须保持请求顺序。解决方式包括:
• 同连接串行处理; • 为请求编号,完成后按序写回; • 限制或禁用 pipelining; • 使用 Netty 对应的 pipelining Handler; • 在协议层升级到支持多路复用的 HTTP/2。
只保证 EventLoop 上 write 串行,不代表业务异步结果按请求顺序回来。顺序控制必须显式设计。
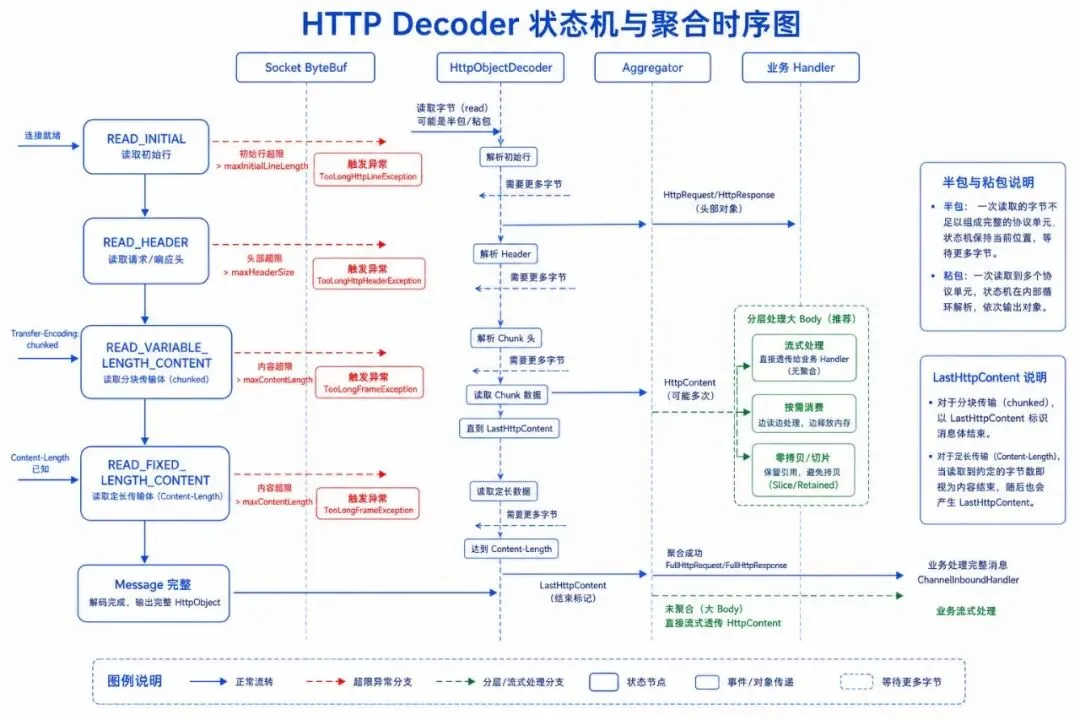
图中第一次 read 可能只有半条请求行,Decoder 不产出对象;后续字节补齐 Header 后先产出 HttpRequest,再逐块产出 Content,LastHttpContent 标记消息边界。响应对象沿出站方向经过 Encoder,最终才成为 Socket 字节。
10. 慢请求会同时占连接、定时器与累积内存
攻击者可以非常慢地发送请求行、Header 或 Body,让连接长期占用资源。仅设置最大长度不够,因为对方可以永远不达到上限。
Pipeline 通常还需要:
• 读超时/请求头超时; • Header 和 Body 长度上限; • 单 IP 连接和并发请求限制; • Aggregator 上限或流式处理; • 写侧背压; • 全局有界业务队列。
IdleStateHandler 可以提供底层读空闲信号,但“请求头必须在 5 秒内完整到达”是更具体的协议 deadline,应由 HTTP 层定时器或网关策略实现。
11. HTTP 排障应沿对象边界定位
抓包能证明线上字节,Pipeline 日志能证明对象传播,两者结合才能判断问题在网络边界、Codec 还是业务 Handler。
12. HTTP Codec 的核心是把字节流变成受约束的对象流
主链如下:
Socket ByteBuf -> HttpRequestDecoder state machine -> HttpRequest -> HttpContent... -> LastHttpContent -> optional HttpObjectAggregator -> BusinessHandler -> HttpResponse / HttpContent -> HttpResponseEncoder -> ByteBuf完整请求接口很方便,但流式对象才是 Netty 默认模型。选择是否聚合,本质是在代码简单度、内存上限与大消息能力之间取舍。
下一篇在 HTTP Pipeline 上继续前进:WebSocket 握手成功后,Netty 会动态替换 HTTP Codec,把同一条 TCP 连接从 HTTP 对象流切换成 WebSocket Frame 流。协议升级真正改变的是 Pipeline 状态,而不是创建一条“特殊网络连接”。
参考资料
1. Netty HttpServerCodec.java:https://github.com/netty/netty/blob/netty-4.1.135.Final/codec-http/src/main/java/io/netty/handler/codec/http/HttpServerCodec.java2. Netty HttpObjectDecoder.java:https://github.com/netty/netty/blob/netty-4.1.135.Final/codec-http/src/main/java/io/netty/handler/codec/http/HttpObjectDecoder.java3. Netty HttpObjectAggregator.java:https://github.com/netty/netty/blob/netty-4.1.135.Final/codec-http/src/main/java/io/netty/handler/codec/http/HttpObjectAggregator.java4. RFC 9112 HTTP/1.1:https://www.rfc-editor.org/rfc/rfc9112