ARTICLE · 1191534
护理科研AI编程助手实战手册以Codex为例:搭建研究框架、分析期刊与写作标准、量性 / 质性 / 干预研究实操
AI不是替你写论文,
而是替你核对论文
护理科研AI编程助手实战手册
以Codex为例:搭建研究框架、分析期刊与写作标准、量性 / 质性 / 干预研究实操
目录
导读:这本手册教什么
第1章 AI在科研中能做什么、不能做什么
1.1 证据:各类任务的实测表现
1.2 真实事件:编造引用的代价
1.3 人机分工原则
第2章 准备工作:安装、安全设置与项目文件夹
2.1 选入口
2.2 安装CLI
2.3 开工前的四项安全设置
2.4 标准科研项目文件夹
2.5 写好AGENTS.md
2.6 常用命令
第3章 任务卡与核验:把一句话需求变成可检查的任务
3.1 任务卡五要素
3.2 计划—执行—核验—记录
3.3 五种核验方法
3.4 一条铁律:不要在提示里写出你期望的结果
第4章 量性研究:从理论到“概念表”和“变量表”
4.1 第一步:从理论原文抽取要素
4.2 概念界定表
4.3 变量操作化表
4.4 假设—分析对照表
4.5 完整演练一:拆解一篇结构方程模型研究
4.6 完整演练二:拆解一篇多元回归研究
4.7 报告规范与常见坑
第5章 质性研究:设计、分析方法与案例
5.1 先定方法学(这一步不交给AI)
5.2 访谈提纲自检
5.3 分析全流程:AI可以做什么、不应该做什么
5.4 两种分析方法的实操要点
5.5 完整演练三:拆解一篇Colaizzi现象学研究
5.6 完整演练四:一项人机对照的主题分析研究
5.7 其他可练习的案例与报告规范
第6章 干预研究:文献、证据与可执行性
6.1 证据表:AI提取,人抽检
6.2 成分—证据对照表
6.3 可执行性表:先定标准,再看数据
6.4 完整演练五:一项护士主导干预的开发与预试验
6.5 完整演练六:交通灯进展标准怎么写
6.6 报告规范
第7章 分析期刊与写作标准
7.1 投稿须知对比表
7.2 期刊画像
7.3 报告规范逐条核对
7.4 范文结构分析:学结构,不学句子
第8章 数据分析与稿件质检
8.1 模拟数据先行
8.2 数字一致性检查
8.3 参考文献核验
8.4 术语与缩写一致性
第9章 规范、伦理与披露
9.1 三色表:哪些能用,哪些不能用
9.2 政策要点(截至2026年10月15日)
9.3 披露写哪些内容:GAMER清单
9.4 声明模板
附录
附录A 任务卡库(复制后替换方括号)
附录B AI使用记录表(对应GAMER条目)
主要参考文献
导读:这本手册教什么
Codex这类AI编程助手和聊天机器人最大的区别是:它能直接读写你电脑里的文件、运行代码、连续完成多步骤任务。 这让它特别适合科研中那些耗时、重复、容易出错的工作,比如整理期刊投稿要求、逐条核对报告规范、核对全文数字、核实参考文献、编写可重复的分析代码。
但它不能替你判断研究问题是否有价值,也不能替你诠释质性资料。近两年的研究证据比较一致:在已有研究的几类科研任务中,AI单干的可靠性不足,人机协作的表现与人工相当甚至更好(见第1章)。所以本手册的原则只有一句话:
AI做初稿、对照和计算;人做判断、诠释和核验。
读完并做完练习,你应能独立完成6件事:
能力 | 产出物 | 章节 |
安全地安装和配置Codex | 一个带规则文件的科研项目文件夹 | 第2章 |
用任务卡布置任务并核验结果 | 任务卡+核验记录 | 第3章 |
按研究设计搭建研究框架 | 量性:概念表、变量表;质性:方法论决策表;干预:证据表、可行性表 | 第4–6章 |
分析目标期刊和写作标准 | 期刊对比表、发文画像、规范核查表 | 第7章 |
投稿前质检 | 数字一致性报告、参考文献核对报告 | 第8章 |
合规地披露AI使用 | 符合GAMER的AI使用记录和披露声明 | 第9章 |
写在前面的三点说明:
•工具功能、命令和期刊政策都会变化。本手册信息核对至2026年10月15日,操作前请以官方文档为准(Codex官方文档目前位于 learn.chatgpt.com/codex)。
•方法通用。Claude Code、Gemini CLI、Cursor等同类工具都能照做,它们也都支持或可配置项目规则文件。
•文中引用的文献都在文末列出了卷期或DOI,可自行查证;证据等级已标注:预印本标“预印本”,新闻报道标“据某某报道”。
第1章 AI在科研中能做什么、不能做什么
1.1 证据:各类任务的实测表现
先看数据,再谈用法。下表是2023–2026年的实证研究,覆盖科研中最常见的几类任务。
任务 | 关键发现 | 结论 |
系统综述数据提取 | 6个系统综述、63项研究、9341个数据元素:AI辅助提取准确率91.0%,纯人工89.0%;每项研究提取时间的中位数减少41分钟;两组最常见的错误都是漏提[1] | 可以做“第一提取者”,必须有人复核 |
题目和摘要筛选 | 敏感度波动大:GPT-4在两项综述中为0.806和0.875(剔除它有理由排除的文献后为0.962和0.943)(Matsui等,J Med Internet Res 2024);GPT-4o mini的一种提示配置仅56.2%(López-Pineda等,Res Synth Methods 2025) | 不能替代人工筛选,会漏文献 |
报告规范核查 | 单用AI判断PRISMA,最好的准确率70%,单个人工89%;人机协作(25%–35%的条目交回人工判定)达89%–96%(Woelfle等,J Clin Epidemiol 2024)。另一项以CONSORT为例的预印本发现,AI识别“已报告”条目很准,但很难发现“未报告”的条目(He等,arXiv预印本2025) | 最好的模式是人机协作;重点人工复查“已报告” |
质性编码 | 在40条短信干预文本的主题分析中,AI与人工的编码百分比一致率仅36%–47%,但耗时大幅减少(最多约97%;Prescott等,JMIR AI 2024) | 只能做“第二编码者”,不能替代诠释 |
参考文献 | GPT-3.5编造的参考文献占55%,GPT-4占18%(Walters和Wilder,Sci Rep 2023) | 所有引用必须用DOI核实 |
编程智能体做数据分析 | 在54篇论文、221个复现任务中,智能体能复现大部分结果;但对本来无法复现的任务,当提示词要求选出“与原论文最接近的结果”时,Claude Code和Codex的准确率分别降至70.0%和60.0%,出现看似合理但错误的输出(Alizadeh等,arXiv预印本2026) | 分析代码必须用“已知答案”的数据测试;不要在提示词里透露期望结果 |
效率感受 | 一项随机对照研究(16名有经验的开源开发者、246个任务)中,使用AI后完成任务的时间增加了19%,但他们自己觉得快了20%(Becker等,arXiv预印本2025) | “感觉快”不等于“真的快”,重要任务要记录耗时 |
1.2 真实事件:编造引用的代价
•2025年10月,德勤澳大利亚为政府撰写的报告中出现编造的法官判词引文和不存在的学术文献,修订版披露使用了基于Azure OpenAI GPT-4o的工具,德勤退还了合同最后一期款项(据《澳大利亚金融评论报》报道)。
•2026年,Disability Studies Quarterly撤回一篇论文:117条脚注中6条为AI编造,而且是在首轮同行评审之后才加入的;作者称没有用AI生成内容,但在后期修改时曾尝试用生成式AI查找补充文献(据Retraction Watch报道)。
1.3 人机分工原则
交给AI | 必须由人完成 |
从你提供的文件中提取、整理、对照 | 判断研究问题的价值和创新性 |
编写和调试代码(用模拟数据) | 选定理论、设计、测量工具 |
逐条对照报告规范、核对数字 | 诠释质性资料、形成主题 |
起草表格、清单、方案骨架 | 评价偏倚风险、设定可行性阈值 |
提供“第二意见” | 运行正式分析、对结论负责 |
一个简单的判断标准:凡是需要对结果负责、且无法用原文或数据快速验证的判断,都不要交给AI。
第2章 准备工作:安装、安全设置与项目文件夹
2.1 选入口
Codex目前有几种使用方式:ChatGPT桌面应用(macOS、Windows、Linux)、命令行工具(CLI)、VS Code等编辑器的插件,以及网页版和iOS版。科研场景建议:
•刚入门:用桌面应用,界面最友好。
•批量处理文件:用CLI,可以用 codex exec 跑非交互任务。
•账号:Codex已包含在ChatGPT各档套餐中,免费版也能用,但额度按每5小时窗口限制,且因套餐和模型而异。也可以用API密钥登录本地工具,按API价格计费。
2.2 安装CLI
官方独立安装器不需要先装Node,最适合不写代码的读者:
# macOS / Linux
curl -fsSL https://chatgpt.com/codex/install.sh | sh
# Windows(PowerShell)
powershell -ExecutionPolicy ByPass -c "irm https://chatgpt.com/codex/install.ps1 | iex"
# 已有包管理器时也可以
npm install -g @openai/codex
brew install --cask codex
安装后输入 codex,按提示用ChatGPT账号登录。两点注意:
•Windows已原生支持,推荐Windows 11。网上旧资料说“Windows必须用WSL”,已经过时。
•Codex只能运行你电脑上已安装的工具。要让它跑R或Python统计,先自己装好R、Python,可以让Codex帮你检查是否安装成功。
2.3 开工前的四项安全设置
第一,关闭数据训练。 个人版(如Plus、Pro)的内容默认可能用于模型训练,需在ChatGPT的“数据控制”中关闭,这个设置对Codex同样生效。企业版和教育版默认不用于训练。
第二,选对权限档位。
沙箱档位 | 能做什么 | 建议 |
read-only(只读) | 只能查看文件;修改和运行命令需要你批准 | 初次使用、文件夹没有版本管理时 |
workspace-write(可写工作区) | 可在项目文件夹内修改文件、运行命令;默认不联网 | 日常使用,搭配“需要时询问”(on-request) |
danger-full-access(完全访问) | 不加任何限制 | 不建议 |
启动参数 --yolo 会同时关闭沙箱和所有审批,科研场景不要使用。会话中可以用 /permissions 调整档位。
第三,信任项目文件夹。 只有被你确认“信任”的文件夹,其中的项目规则文件(AGENTS.md)才会生效。很多新手觉得“规则不起作用”,原因就在这里。
第四,可识别的患者数据不进入AI处理。 医疗健康信息属于敏感个人信息,上传到境外服务还涉及数据出境规定(见第9章)。要注意,AGENTS.md里的“禁止读取”只是给AI的指令,不是技术上的强制隔离,沙箱主要限制的是写入和联网。最稳妥的做法是:可识别的原始数据存放在项目文件夹之外,项目内只放去标识化数据和模拟数据,调试代码只用模拟数据。
2.4 标准科研项目文件夹
project_mews/← 用英文和数字命名,避免中文路径报错
├── AGENTS.md← 项目规则
├── 00_admin/← 伦理批件编号等管理信息(不含个人信息)
├── 01_framework/← 理论摘录、概念表、变量表、方案骨架
├── 02_literature/← 检索式、题录、证据表
├── 03_journals/← 作者须知原文、期刊对比表
├── 04_guidelines/← 报告规范清单
├── 05_data/
│├── raw/← 去标识化数据(可识别原始数据放在项目外)
│└── simulated/← 模拟数据(用于调试)
├── 06_scripts/← R/Python脚本
├── 07_output/← 表、图、运行日志
├── 08_manuscript/← 稿件各版本
└── 09_checks/← 各类核查报告+ AI使用记录
建议在项目文件夹里执行一次 git init 做版本管理:改错了可以回退,/diff 和 /review 也依赖它。
2.5 写好AGENTS.md
AGENTS.md是Codex每次启动时读取的规则文件。先了解它的工作方式:
•两级:全局一份(用户目录下的 ~/.codex/AGENTS.md),项目一份;离当前工作目录越近的文件越优先。
•启动时读取一次:改完要重启Codex。
•有大小上限:默认32KiB,规则要精炼。
•快速生成:在会话中输入 /init 可生成初稿,再按下面的模板修改。
•确认是否生效:直接问Codex“总结一下你当前遵守的规则”。
护理科研版AGENTS.md模板:
# 项目规则
## 项目背景
本项目为[研究题目],设计为[横断面/质性/可行性试验],目标期刊为[期刊名]。
## 绝对规则
1. 不得编造文献、数据、数字或引文;不确定时写"待核实"。
2. 引用文献必须给出DOI或PMID;无法核实的标注 [UNVERIFIED]。
3. 不得读取或修改 00_admin/ 和 05_data/raw/ 中的任何文件。
4. 代码只用 05_data/simulated/ 中的数据调试;正式分析由研究者本人运行。
5. 修改任何文件前,先输出修改计划,经我确认后再执行。
6. 不要根据我对结果的期望去"凑"结果;结果与预期不符时,如实报告。
## 输出规范
- 每个判断都附原文证据:引用原句,并注明文件名和位置。
- 表格输出为CSV,同时生成Markdown预览。
- 产出保存到对应编号文件夹,文件名带日期。
- 每次任务完成后,在 09_checks/ai_log.md 追加一条AI使用记录。
## 语言
- 与我交流用中文;稿件内容按期刊要求用英文。
第6条专门针对第1章提到的“在暗示下凑结果”的风险。
2.6 常用命令
命令 | 用途 |
codex | 在当前文件夹启动交互会话 |
/init | 生成AGENTS.md初稿 |
/model | 查看和切换模型(模型更新很快,不必记名字) |
/status | 查看当前配置和状态 |
/diff、/review | 查看改动、让Codex审查未提交的改动 |
codex resume | 继续上一次的会话 |
codex exec "任务" | 非交互批量执行,默认只读;要写文件须加 --sandbox workspace-write |
codex --search | 开启实时联网搜索(默认只用缓存结果),查最新政策时使用 |
过关练习:建好项目文件夹,写入AGENTS.md,重启Codex,让它复述当前规则;再布置一个小任务(如列出各文件夹的用途),检查它是否先给出计划、是否把产出存到了指定文件夹。
第3章 任务卡与核验:把一句话需求变成可检查的任务
AI出错,多数时候不是模型不够强,而是任务没说清楚:读什么、产出什么、什么算完成,都留给了AI自己猜。本手册所有任务都用同一种格式写,叫“任务卡”。
3.1 任务卡五要素
要素 | 要回答的问题 | 反例 | 正例 |
目标 | 这一步只产出什么? | 帮我分析一下这本期刊 | 提取《J Adv Nurs》投稿须知中的8个字段 |
输入 | 只读哪些文件? | 看看我的资料 | 只读 03_journals/JAN_guide.txt |
输出 | 文件名、格式、列名? | 总结一下 | 输出 09_checks/jan_fields_2026-10-15.csv,列:字段、要求、原文引用、所在小节 |
约束 | 不许做什么? | 不写 | 原文没写的填“未提及”,不得推断;不改动输入文件 |
验收标准 | 怎样才算完成? | 不写 | 每行都有原文引用;我随机抽5行,全部能在原文中找到 |
一张完整的任务卡如下,可以直接复制到Codex的输入框:
【目标】提取投稿须知中的8个字段:字数上限、摘要结构、报告规范要求、
参考文献格式、数据共享声明、AI使用声明、预注册要求、开放获取费用
【输入】只读 03_journals/JAN_guide.txt
【输出】09_checks/jan_fields_2026-10-15.csv
列:字段| 要求 | 原文引用(逐字) | 所在小节标题
【约束】原文没写的填“未提及”,不推断、不补充常识;不修改任何输入文件
【验收】每行有逐字引用;完成后列出你不确定的行
【流程】先给我计划(读哪些文件、输出什么),等我回复“执行”再开始
最后一行很重要:先计划、后执行。看计划时如果发现AI理解错了,改一句话就行;等它改完一堆文件再发现,就要回滚。
3.2 计划—执行—核验—记录
每个任务都走四步,不跳步:
1.计划:AI列出要读的文件、要产出的文件和步骤,不动任何文件。你检查范围是否正确。
2.执行:确认后执行,输出只写到约定的文件夹(如 09_checks)。用 /diff 查看改了什么。
3.核验:人按验收标准检查(方法见3.3)。不通过就修改任务卡,而不是在对话里反复追问“你再看看”。
4.记录:在 ai_log.md 里记一行:日期、工具与模型(/status 可看)、任务卡、输出文件、核验方法与结果。这一行就是将来写AI使用声明的原始材料(见第9章)。
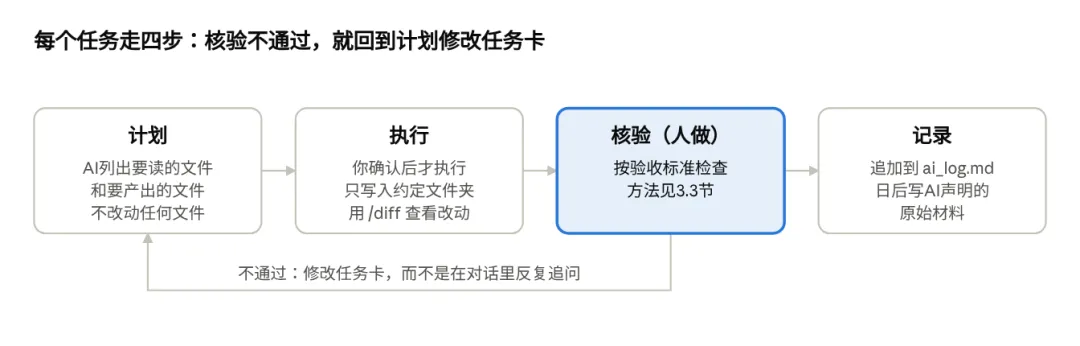
图1任务的四步循环:核验由人完成
四步里AI能独立完成的只有执行,计划要你确认,核验和记录要你来做。
3.3 五种核验方法
方法 | 怎么做 | 适合的任务 |
证据定位 | 要求每条结论附逐字引用和位置,人按位置回原文查 | 提取、对照、总结 |
抽样复核 | 随机抽10%~20%(至少5条)人工重做,算一致率;低于团队事先定的标准(如90%)就全部人工复核 | 批量提取、批量编码 |
已知答案测试 | 先用一份你已人工做完的材料让AI做,比对差异,再上新材料 | 新任务第一次使用时 |
双跑对比 | 新开会话把同一任务卡再跑一次,两次输出不一致的地方人工裁定 | 判断类任务(如“是否报告”) |
外部核对 | DOI、PMID到Crossref、PubMed逐条查;统计结果用另一软件复算 | 参考文献、数字、统计 |
抽样复核的“90%”不是文献给出的标准,而是一个示例:标准应由团队在任务开始前定好并写进记录,不能看完结果再定。
3.4 一条铁律:不要在提示里写出你期望的结果
“请证明社会支持通过健康素养影响健康行为”和“请检验社会支持、健康素养与健康行为之间的关系”是两种完全不同的任务。前者等于告诉AI答案应该是什么。一项2026年的预印本研究发现,对于本来无法复现的分析任务,当提示词要求选出“与原论文最接近的结果”时,Claude Code和Codex都给出了看似合理但错误的输出(Alizadeh等,arXiv预印本2026)。正确写法是:只描述要做的分析,写明“结果不符合预期时如实报告,不得调整数据或模型去迎合”。这一条已经写在第2章的AGENTS.md模板里,任务卡里再写一遍也不多余。
过关练习:把“帮我看看这篇文章的方法部分有什么问题”改写成一张五要素齐全的任务卡。提示:“问题”要换成具体的检查清单,例如对照COREQ或STROBE的条目。
第4章 量性研究:从理论到“概念表”和“变量表”
量性研究最常见的退修意见是“理论框架与研究设计脱节”:引言写了一个理论,变量却不是从理论里来的,假设也找不到对应的理论命题。AI在这里的价值,是帮你把这条链条一环一环对齐:
理论 → 概念 → 变量 → 测量工具 → 假设 → 分析方法
每一环都用一张表固定下来。表由AI起草,由你逐格确认。
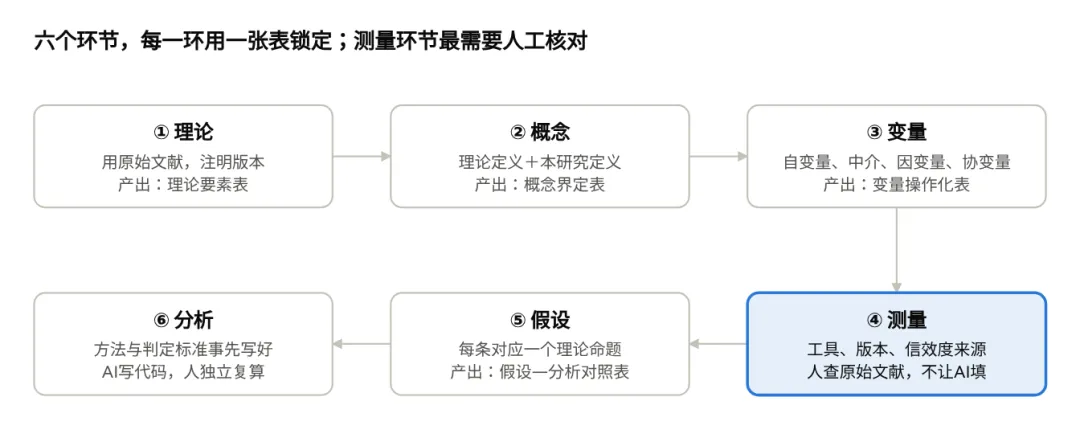
图2量性研究的六个环节:每环用一张表锁定
4.1到4.4节依次给出这几张表的模板和填写分工。
4.1 第一步:从理论原文抽取要素
一定要给AI理论的原始文献,而不是别人对理论的转述。以Riegel等的心衰自我护理情境特定理论(situation-specific theory of heart failure self-care)为例,它有三个版本:2008年原始版、2016年修订版和2022年更新版(三版均发表于J Cardiovasc Nurs)。2022版新增了7条命题,并把影响因素归入问题、个人、环境三类。引用哪一版,就必须用哪一版的概念和命题。
Codex没有官方的原生PDF阅读功能,先让它写一个Python脚本(如用pypdf)把PDF转成按页分隔的txt,你抽查两页确认文字和页码没错位。然后发任务卡:
【目标】从理论原文中抽取:核心概念及其定义、概念间关系(命题)、影响因素分类
【输入】只读 01_framework/riegel2022.txt
【输出】09_checks/theory_elements.csv
列:类型(概念/命题/因素)|名称 | 原文定义或表述(逐字)| 页码
【约束】只抽取原文明确写出的内容;不补充其他文献或常识;无法定位页码的标[UNVERIFIED]
【验收】命题数量与原文一致;我抽查5条引文全部可在对应页找到
4.2 概念界定表
这张表回答“理论里的抽象概念,在本研究里具体指什么”。
理论概念 | 理论中的定义(逐字+页码) | 本研究的操作定义 | 对应变量 | 不纳入的理由 |
(从theory_elements.csv导入) | AI填,人核对 | 人写,AI润色 | 人定 | 人写 |
最后一列很关键。一个理论的概念不必全部纳入,但没纳入的要说明理由,审稿人最常问的就是“为什么只用了理论的一部分”。
4.3 变量操作化表
概念是抽象的(如“社会支持”),变量是可以测量的(如“领悟社会支持量表总分”)。变量操作化表把每个变量“怎么测、怎么算、在分析里扮演什么角色”写清楚,它同时是方法部分“研究工具”一节的提纲。
列 | 填什么 | 谁来填 |
变量与角色 | 自变量、中介变量、因变量、协变量 | 人定 |
测量工具与版本 | 量表全称、原作者、中文版作者、版本号 | AI从你给的文献提取,人核对 |
条目、维度、计分 | 条目数、各维度条目数、等级、总分范围、反向计分条目、分数方向 | AI提取,人对照量表原文核对 |
信效度 | 中文版已发表的信效度;本研究样本的α | 只能人查原文后填,没查到就标[UNVERIFIED] |
分析中的处理 | 总分或潜变量;是否打包(用维度分作指标);缺失处理 | 人定 |
量表的中文版来源和信效度数值,是AI最容易编造的地方。另一个坑是量表版本:例如心衰自我护理指数SCHFI的v7.2为29条目、3个分量表(Riegel等,J Cardiovasc Nurs 2019),而量表官网已发布v8.0,用哪版就要引哪版的心理测量学文献。
4.4 假设—分析对照表
列 | 填什么 |
假设 | 一句话,写清变量和关系方向 |
理论依据 | 对应的理论命题或概念关系,附页码 |
分析方法 | 如多元回归、结构方程模型(SEM)、Bootstrap中介检验 |
判定标准 | 事先写好,如“间接效应95%CI不含0”“模型拟合指标的取值标准” |
中介假设要先理解它的算法:间接效应等于路径上各标准化系数的乘积。“社会支持→健康素养→健康行为”的间接效应,就是“社会支持→健康素养”的系数乘以“健康素养→健康行为”的系数;链式中介就是三个系数相乘。间接效应加上直接效应等于总效应。这个关系很有用:可以让AI写脚本用论文报告的系数复算间接效应和占比,这就是第3章说的“已知答案测试”。
写完这张表再做两件事。一是让AI用DAGitty语法把变量关系写成因果图(DAG),箭头由你按理论和临床知识决定,用它来检查哪些变量应作为协变量。二是样本量:AI可以写semPower或pwr代码,但必须用G*Power等另一工具独立复算,参数(效应量、α、把握度、预测变量数)的来源要写进方法。
4.5 完整演练一:拆解一篇结构方程模型研究
下面用Yang等2026年发表在Front Public Health的研究[2],完整走一遍“让AI反向抽取三张表→人工核对→找出问题”的流程。这也是写自己论文前拆范文的标准做法。以下数字均取自论文原文。
第1步:研究概况。
项目 | 内容 |
设计 | 横断面调查,按STROBE报告 |
对象与场所 | 河南省3所综合医院的18~59岁肺癌手术患者,便利抽样,2024年12月至2025年8月 |
样本 | 发放450份,有效436份(有效率96.9%);女性61.9%,年龄47.35±9.73岁 |
样本量计算 | semPower,基于RMSEA;19个观测指标、51个自由参数、139个自由度,α=0.05、把握度0.80、目标RMSEA=0.05,最少136人 |
分析 | SPSS 27.0 + AMOS 28.0;两步法SEM(先测量模型、后结构模型);偏差校正Bootstrap 5000次 |
第2步:发任务卡。 把论文PDF转成txt放进 02_literature/,然后:
【目标】从论文中反向抽取三张表:概念界定表、变量操作化表、假设—结果表
【输入】只读 02_literature/yang2026.txt
【输出】09_checks/yang2026_tables.md(三张表,每个单元格后附原文引用和小节号)
【约束】只写原文明确写出的内容;作者没有把某变量对应到理论概念的,填“未对应”,
不得自行推断;数字逐字照抄
【验收】另写脚本用路径系数复算每条间接效应及占总效应比例,与论文报告值对比
第3步:核对后的概念界定表。 Pender健康促进模式把影响因素分为三大类:个体特征与经验、行为特异性认知与情感、行为结果。抽取结果如下:
本研究概念 | 作者对应的模式成分 | 对应程度 |
社会支持 | “人际与情境影响” | 明确归类 |
健康素养 | 与“行动的益处”“行动的障碍”一致 | 只说概念一致,未归入具体类别 |
知觉控制(癌症经历、控制效能) | 未对应;作者引用的是自我效能理论、压力与应对理论 | 未对应 |
健康促进行为 | 正文未明确写为模式的“行为结果” | 未明确说明 |
既往相关行为、活动相关情感、行动计划承诺等 | 未纳入模型 | 未说明理由 |
这张表一排出来,“理论映射不完整”就一目了然。注意最后一行:哪些成分未纳入是你对照模式原文得出的判断,论文本身没有写,所以这一列只能由人填。
第4步:核对后的变量操作化表。
变量 | 角色 | 工具 | 条目与维度 | 计分 | 本研究总α |
社会支持 | 自变量 | 领悟社会支持量表PSSS(Zimet原版,Zhong等中文版) | 12条;家庭、朋友、其他支持各4条 | 7级;越高越好 | 0.937 |
健康素养 | 中介 | 健康素养管理量表HeLMS中文版 | 24条;信息获取9、经济支持意愿2、交流互动9、改善健康意愿4 | 见注①;越高越好 | 0.945 |
癌症经历 | 中介 | 癌症经历与效能量表CEES的经历分量表 | 16条;个人、情绪、社会经济负担 | 5级,16~80;越高越负面 | 0.964 |
控制效能 | 中介 | CEES的效能分量表 | 13条;个人、集体、代理效能 | 5级,13~65;越高越好 | 0.968 |
健康促进行为 | 因变量 | 健康促进生活方式量表HPLP-II中文版(Cao等) | 40条;6个维度 | 4级,40~160;越高越健康 | 0.965 |
注①:论文正文称HeLMS为“五级评分”,但给出的锚点是1分至4分,前后不一致,写自己的论文时应查量表原始文献确认。五个潜变量都用“维度总分”作指标(打包策略),共19个观测指标,这也是样本量计算中“19个指标”的来源。
第5步:核对后的假设—结果表。 四条假设都是“社会支持→健康促进行为”这条主线上的不同路径:
假设 | 路径 | 标准化效应 | 95%CI | 占总效应 |
H1 直接关联 | 社会支持→行为 | 0.200 | 文中未报告 | — |
H2 健康素养中介 | 社会支持→健康素养→行为 | 0.148 | 0.100~0.215 | 27.56% |
H3 癌症经历中介 | 社会支持→癌症经历→行为 | 0.070 | 0.030~0.121 | 13.03% |
H3 控制效能中介 | 社会支持→控制效能→行为 | 0.073 | 0.016~0.141 | 13.59% |
H4 链式中介 | 社会支持→健康素养→癌症经历→行为 | 0.033 | 0.015~0.063 | 6.15% |
H4 链式中介 | 社会支持→健康素养→控制效能→行为 | 0.013 | 0.003~0.028 | 2.42% |
验收脚本的复算结果:社会支持→健康素养的系数为0.417,健康素养→行为为0.354,0.417×0.354≈0.148,与报告值一致;五条间接效应之和为0.337,加上直接效应0.200等于总效应0.537,0.148÷0.537≈27.56%。数字自洽,说明提取没有出错。
第6步:人工核对发现的问题。 这些问题论文里都写着,但只有把表格和正文对照着看才会发现:
•拟合标准前后不一:方法部分写GFI、AGFI等应大于0.90,表格的参考标准却写“>0.8为良好”;修正后的AGFI为0.882,按方法部分自己的标准并未达标。
•模型修正:初始模型CMIN/DF为3.099、RMSEA为0.069;作者按修正指数在HPLP-II的4对维度间加入残差相关后,CMIN/DF降至2.733、RMSEA降至0.063、CFI由0.957升至0.965。作者的理由是“这些维度在概念上是健康行为互相关联的组成部分”。是否充分由你判断,但至少它做到了如实报告修正前后的全部指标。
•场所描述不一:方法写“河南省3所医院”,讨论却写“在中原地区的单一城市开展”。
•样本代表性:女性占61.9%,作者在局限中指出源人群中该比例为43.17%,存在选择偏倚的可能。
•因果表述:横断面设计只能说“关联”,作者在讨论中也强调路径代表统计关联而非因果关系。自己写时,摘要和结论里不要用“影响”“导致”。
给自己论文的启示:理论中每个概念是否纳入都要交代;拟合标准只写一套并始终用它;量表计分方式对照原始文献写。
4.6 完整演练二:拆解一篇多元回归研究
第二个案例是Kim等2026年发表在Int J Nurs Pract的研究[3],它用的是4.1节提到的Riegel 2022版心衰自我护理情境特定理论。
研究概况:韩国一所大学附属医院,2023年6至9月,便利抽样,纳入NYHAⅡ级或Ⅲ级的成人心衰患者134人(年龄63.54±12.58岁,男性79.1%),按STROBE报告。G*Power按“10个预测变量、f²=0.15、把握度0.80、α=0.05”算得最少118人,考虑约10%脱落后调查134人。
理论的用法与一个术语细节:Riegel 2022版论文标题里的三类因素是“问题、个人、环境”,而Kim等在正文中用的是“个人因素、疾病相关因素、环境因素”。让AI提取时如果不要求逐字引用,它很可能把两套叫法混在一起。自己写论文时,应采用所引版本的原始术语。
作者的归类 | 变量 | 工具(韩文版) | 范围与方向 | 本研究信度 |
疾病相关因素 | 症状 | ESAS,10条 | 0~100,越高越重 | α=0.88 |
个人因素 | 心衰知识 | 荷兰心衰知识量表,15条 | 0~15 | KR-20=0.74 |
个人因素 | 心衰相关健康素养 | 心衰特异性健康素养量表,12条 | 12~48 | α=0.72 |
个人因素 | 自我效能 | SCHFI v7.2自我效能量表,10条 | 0~100 | α=0.89 |
环境因素 | 社会支持 | MSPSS,12条 | 12~60 | α=0.91 |
结局 | 自我护理 | SCHFI v7.2:维持10条、症状感知9条、管理7条 | 各量表换算为0~100,≥70为充分 | α=0.89/0.85/0.73 |
分析策略与结果:作者先做单因素分析,把p<0.05的变量用强制进入法放入三个回归模型。心衰知识与三个结局的相关都不显著,因此没有进入任何模型。三个分量表均分分别为59.37、50.75、55.12,达到70分的只有25.4%、19.4%、29.9%。
模型 | 显著的预测因素(标准化β) | R²(调整R²) |
自我护理维持 | 社会支持0.28、症状−0.23、年龄0.22、就业−0.22、自我效能0.21 | 0.394(0.360) |
症状感知 | 自我效能0.30、健康素养0.27 | 0.310(0.288) |
自我护理管理 | 自我效能0.34、年龄0.26、社会支持0.20、健康素养0.19、宗教信仰0.17 | 0.441(0.419) |
自我效能是唯一在三个模型中都显著的预测因素。摘要中的“解释力39.4%、31.0%、44.1%”是未调整的R²。
人工核对发现的问题与可以讨论的地方:
•正文与表格不一:结果正文写症状感知为“50.75(±16.12)”,表格为±21.86;16.12恰好是维持分量表的标准差,很可能是复制时的错误。这类问题正是第8章数字一致性检查要抓的。
•样本量参数:G*Power按10个预测变量计算,实际进入模型的最多7个,样本量是充足的,但参数与实际分析不对应。
•预测因素的筛选方式:理论驱动的研究,也可以按理论预先确定全部变量一次进入,而不是先做单因素筛选。否则,理论里的“知识”就因为筛选而消失在模型中。这是可以在讨论中交代的方法选择,不是错误。
•未报告的诊断指标:未报告方差膨胀因子(VIF)等共线性诊断。自己做回归时应一并报告。
练习:让AI把每个自变量归入作者使用的三类因素并附原文引用,再让它用R²、n=134和预测变量数复算每个模型的调整R²,对照表格检查。
4.7 报告规范与常见坑
观察性研究按STROBE(22条);建立或验证预测模型(包括机器学习模型)按TRIPOD+AI(27条)。常见坑:
•引了理论的新版,却用了旧版的概念名称;
•变量表里的“中文版Cronbach’s α”由AI填写且未核对;
•模型修正为了拟合而修正,没有理由;
•让AI“找出显著的变量组合”,等于数据挖掘后再写假设。
第5章 质性研究:设计、分析方法与案例
质性研究用AI,风险比量性研究大得多:资料是参与者的原话,隐私风险高;分析的核心是研究者的诠释,不能外包。一项研究用40条短信干预文本比较了人工与生成式AI的主题分析,两者的编码百分比一致率只有36%~47%,尽管AI大幅缩短了耗时(Prescott等,JMIR AI 2024)。所以本章的原则是:AI做整理、对照和检查,人做编码、诠释和判断。
5.1 先定方法学(这一步不交给AI)
方法学 | 适合的研究问题 | 常用分析方法 | 样本量的论证思路 |
描述性质性研究 | 某群体对某事的经历和看法是什么 | 内容分析、主题分析 | 与所选分析方法一致 |
现象学 | 某种生活体验的本质是什么 | Colaizzi七步法、IPA | 小样本、重深度 |
扎根理论 | 某个过程如何发生,生成解释性理论 | 持续比较、分级编码、理论抽样 | 理论饱和 |
民族志 | 某群体的文化和实践 | 田野笔记与访谈的综合分析 | 田野时间与情境深度 |
AI在这一步只做一件事:把你已选的方法学和分析方法的原始文献转成txt,抽取出它的步骤和关键术语(带页码),用来检查你的方法部分描述是否与原文一致。
5.2 访谈提纲自检
把研究问题和访谈提纲交给AI,让它输出一张表:每个问题对应哪个研究问题;是否封闭式、诱导性、一问多义或预设立场;有无研究问题没有被任何访谈问题覆盖。例如“您是不是觉得照顾压力很大?”会被标为封闭且诱导,建议改为“能说说您平时照顾他的一天是怎么过的吗?”。改不改由你定。
5.3 分析全流程:AI可以做什么、不应该做什么
环节 | AI可以做 | AI不应该做 |
转录与去标识化 | 对已去标识化的文本再扫一遍遗漏的姓名、医院、日期 | 接触原始录音和未去标识化的转录(这一步在本地、由人完成) |
编码 | 作为第二编码者提供对照编码,分歧处记入审计轨迹 | 替代研究者做唯一编码者 |
形成主题 | 列出每个主题下的支持原文及来源参与者,找出反例 | 判断主题是否“好”、是否成立 |
引文 | 用脚本核对每条引文是否与转录逐字一致 | 润色、压缩或“优化”参与者的原话 |
写作 | 对照COREQ逐条检查是否报告 | 根据报告规范“补写”并未做过的程序 |
引文核对是最实用的一条。让Codex写一个Python脚本:读入稿件中所有引号内的参与者原话和转录文件夹,逐条判断是否能在对应参与者的转录中找到完全匹配的文字,输出不匹配的清单。这个脚本不需要大模型“理解”任何东西,结果是确定的。
脚本大致如下(由AI编写、由你在本地运行,因为转录文件不应让AI读取)。这里假定稿件中引文的写法是“引文”(P05),转录文件名为P05.txt:
import re, pathlib
def norm(s):# 去掉空格和换行再比较
returnre.sub(r"\s+", "", s)
manuscript = pathlib.Path("08_manuscript/results.md").read_text(encoding="utf-8")
transcripts = {p.stem: norm(p.read_text(encoding="utf-8"))
forp in pathlib.Path("transcripts").glob("P*.txt")}
for quote, pid in re.findall(r"“([^”]+)”((P\d+))", manuscript):
ifnorm(quote) not in transcripts.get(pid, ""):
print("未匹配:",pid, quote[:30])
5.4 两种分析方法的实操要点
Colaizzi七步法(步骤按Morrow等2015年发表于The Psychologist的概括):
步骤 | 内容 | AI的角色 |
1 熟悉资料 | 反复阅读全部转录 | 无,必须人读 |
2 提取有意义的陈述 | 标出与现象相关的陈述 | 独立提取一份作对照,差异由人裁定 |
3 构建意义 | 从陈述中提炼意义 | 不建议使用 |
4 聚类为主题簇 | 意义归类成主题 | 整理“主题—意义—原文—参与者”追溯表 |
5 详尽描述 | 写出现象的完整描述 | 语言润色,不增删内容 |
6 提炼基本结构 | 压缩成现象的本质结构 | 无 |
7 参与者验证 | 返回参与者确认 | 汇总反馈意见 |
Braun和Clarke的反思性主题分析(六阶段)。这里有一个常见的方法学错配:反思性主题分析强调研究者的主观性是资源,不以编码一致性为质量标准,也不建议用“数据饱和”论证样本量(Braun和Clarke,2021)。因此,如果你用的是反思性主题分析,就不要报告“人与AI的编码一致率”,AI的输出只能作为促进反思的参照,并在方法里如实说明。
5.5 完整演练三:拆解一篇Colaizzi现象学研究
案例是Subraja等2026年发表在BMC Nurs的卒中照顾者负担研究[4]。它结构完整、篇幅不长,很适合用来练习“让AI提取、人核对”;它的几处小问题,也正好是自己写质性论文时最容易犯的。
第1步:研究概况。
项目 | 内容 |
目的 | 探索卒中幸存者非正式照顾者的生活体验 |
方法学 | 描述性现象学,Colaizzi七步法,按COREQ报告 |
场所与时间 | 印度泰米尔纳德邦一所医学院附属医院,2024年11月至2025年1月 |
抽样 | 目的抽样,直至数据饱和;16名主要照顾者(女性15人,配偶9人、子女7人) |
访谈 | 由第一作者(护理学硕士,受过质性研究培训)进行面对面半结构访谈,用泰米尔语;每次20~30分钟,每人1~2次;提纲经2名质性研究专家预试和审定 |
分析 | 2名研究者在Excel中独立手工编码,分歧讨论解决;与3名参与者做成员核查 |
结果 | 4个主题、11个亚主题 |
第2步:用AI自检访谈提纲。 论文给出的提纲共6条(中文为本手册转译):①照顾卒中幸存者时主要的心理和情绪体验;②他们在照顾角色中遇到哪些挑战,这些挑战如何影响他们;③照顾如何影响了他们生活的各个方面,包括个人、社会和职业领域;④他们用哪些应对策略来管理照顾带来的情绪和身体负担;⑤成为照顾者后,他们对生活或人际关系的看法有何改变;⑥他们认为哪些支持或资源有助于减轻照顾负担。按5.2节的任务卡自检,应该能标出四点:
•第①条是短语,不是问题,访谈时需要改写成开放式提问;
•第②、③条一问多义(挑战加影响;三个领域),实际访谈中容易只答一半;
•全部用第三人称“他们”,是研究者视角的提纲,不是可以直接念给参与者的问句;
•第④、⑥条直接使用“负担”一词,而研究目的是“生活体验”。问题里预设了“照顾是负担”,可能引导参与者只谈负面体验。
这些是否要改由研究者决定,但提前发现,就能在访谈中有意识地补问正面或中性的经历。
第3步:对照Colaizzi七步检查方法部分。 让AI把方法部分对照七步逐条定位,结果如下:
步骤 | 论文中的呈现 | 完整报告应该写什么 |
1 熟悉资料 | 只列了步骤名称 | 谁读、读几遍、是否结合录音 |
2 提取有意义的陈述 | 只列名称;另有“2人独立编码” | 提取了多少条,给出示例 |
3 构建意义 | 只列名称 | 至少一个“陈述→意义”的示例 |
4 聚类为主题簇 | 4个主题、11个亚主题 | 意义如何归入主题簇 |
5 详尽描述 | 未呈现 | 结果部分应有一段完整描述 |
6 基本结构 | 未呈现 | 一段对现象本质的浓缩陈述 |
7 参与者验证 | “与3名参与者做了成员核查” | 返还了什么、怎样反馈、是否修改 |
结论:这篇论文“声明”了七步,但只“报告”了第4步和第7步的结果。审稿人要的是后者。
第4步:结果提取。 主题、亚主题和示例引文如下(引文原为英文,中文为本手册转译):
主题 | 亚主题 | 示例引文 |
情绪负担 | 焦虑和抑郁;无助与绝望感;情绪耗竭 | “有些日子我连床都不想起,但我别无选择。”(参与者12) |
身体与健康相关负担 | 疲劳与睡眠剥夺;慢性病风险增加;忽视自我照护 | “我吃的是喂完家人后剩下的东西。”(参与者5) |
经济负担 | 医疗费用增加;失业或工作时间减少;经济支持不足 | “医疗费已经成了巨大的负担,有些月份我们连基本开销都不够。”(参与者2) |
社会与关系影响 | 家庭关系变化;社会隔离与孤独 | “我的孩子们不得不过早地长大。”(参与者11) |
可信度策略按Lincoln和Guba的四个标准组织:可信性(长时间接触、双人独立编码、同伴审议、丰富的逐字引文)、可迁移性(详细描述场所和参与者)、可依赖性(记录提纲制定、编码和主题形成决策的审计轨迹)、可确认性(反思日志和备忘录)。这部分可以直接作为写作模板。
第5步:人工核对发现的问题。 让AI做一遍“正文—表格”数字对照,会得到下面的清单,每条都经过人回原文确认:
•女性比例三处不一:表1为94%(16人中15人,实为93.75%),讨论写“超过90%”,局限写“约95%”。
•卒中类型与表格矛盾:结果写“多数卒中幸存者为出血性卒中”,表2却是缺血性10例(62.5%)、出血性6例(37.5%)。
•照顾时长与表格矛盾:结果写“有些人每天照顾超过6小时”,表1中超过6小时的为0人。
•翻译过程未报告:访谈用泰米尔语,引文用英文呈现,但没有说明谁转录、如何翻译、是否回译。中文访谈写英文论文时,这一步同样必须写。
•引文覆盖不全:16名参与者中,正文只引用了参与者1至13。
•方法术语混用:Colaizzi法的描述里又出现了“通过主题分析解决分歧”。
给自己论文的启示:写Colaizzi法要写每一步做了什么、产出了什么;参与者特征的数字全文只用一个版本;非英语访谈必须报告转录和翻译程序。
5.6 完整演练四:一项人机对照的主题分析研究
Wu M等2026年发表在BMC Nurs的研究[5],用同一批护理访谈资料分别做了人工和ChatGPT辅助的主题分析。它既回答了“AI分析质性资料到底怎么样”,又示范了“AI使用怎么报告”。
研究概况:二次质性分析。资料来自深圳一所三级中西医结合医院的19名护理人员(包括临床护士、护理管理者、科研护士、护理教师和护理研究生),2026年5月11日至29日半结构访谈,每次约30~60分钟。人工分析采用Braun和Clarke的反思性主题分析。
AI是怎么用的(按论文原文整理):
环节 | 做法 |
工具 | ChatGPT Plus网页版,界面显示模型为GPT-5.5;2026年5月30日至6月5日 |
语言 | 中文转录、中文分析;主题形成后才翻译代表性引文 |
去标识化 | 去除直接标识,并把可能导致间接识别的情境细节做泛化处理,然后才输入 |
输入方式 | 按转录长度分批,每批一般1~2份完整转录;各批用同一提示结构;同一批不故意重复提交 |
分析轮次 | 两轮:第一轮初步编码和主题组织;第二轮用追问澄清、整理、完善 |
顺序与比较 | 先完成人工分析,再做AI分析;AI提示只基于转录文本;在初始编码、初步主题、主题描述和片段诠释四个层面比较;人工结果不作为“金标准” |
最终结果 | AI输出由团队审阅,不直接作为最终发现 |
核心发现:AI输出“语义上连贯,但情境被简化”。论文表格里的对照示例最能说明问题(中文为本手册转译):
参与者的话 | 人工诠释 | AI的概括 |
不同护士可能用不同方式记录同一项干预,数据很难统一 | 护理知识标准化的困难,以及如何保留临床情境 | 护理记录不一致 |
很多护理细节在系统记录里体现不出来 | “看不见的护理工作”与数字化表达的局限 | 记录不完整 |
有些科研数据看起来完整,但不一定反映实际发生了什么 | 记录数据与真实临床经验之间的差距 | 数据质量问题 |
临床决策常常依赖沟通、观察和经验积累 | 隐性护理知识与关系性的临床判断 | 个体化护理实践 |
AI的概括都不算“错”,但都把参与者话里的情境和深层含义压扁成了一个管理术语。作者还发现不同提示词有时会产生不同的编码结构。注意:这项研究没有测量耗时、成本或工作量,也没有用百分比或κ量化人机重叠程度,引用时不要说它“证明了AI节省时间”。
从披露角度看这篇论文:
•做得好的:工具和界面显示的模型、使用日期、语言、去标识化方法、分批方式、分析轮次、人机分析的先后顺序,并在补充材料中提供了分析方案和代表性提示词示例。
•可以更好的:会话次数没有前瞻性记录;开启了聊天记录和记忆(Memory)功能,但没有说明是否关闭了“用于改进模型”的数据设置;补充材料给的是“代表性”提示词而不是全部。
对比一下,Hara等2025年发表于BMC Nurs的研究用ChatGPT-4o辅助分析10名手术室护士的访谈,却没有报告提示词和AI的使用日期,也没有说明输入AI之前如何去标识化;论文写的研究期间为2023年2月至2024年2月,而GPT-4o在2024年5月才发布,读者只能推断AI分析是之后进行的。Wu M等的披露就是你要达到的水平,第3章的ai_log.md就是为此准备的。
5.7 其他可练习的案例与报告规范
•Magnussen等,2026,SAGE Open Nurs:研究ICU中照护接受无创通气的危重患儿的护士经历,用反思性主题分析(六阶段)分析13名护士的访谈,按COREQ报告,可作主题分析的对照范文。
•Wu Y等,2025,BMC Nurs:研究安宁疗护护士的替代性创伤,声明采用反思性主题分析,却以“直至数据饱和”论证样本量,就是5.4节说的错配。
•Xu DD等,2025,BMC Nurs:成人ICU临终护理的描述性现象学研究,13名护士,Colaizzi法分析。文中写“第11次访谈时达到主题饱和”,但没有说明如何判断饱和,也没有说明饱和后为何继续访谈。
报告规范:访谈和焦点小组研究用COREQ(32条),其他质性研究用SRQR(21条)。
第6章 干预研究:文献、证据与可执行性
干预研究要回答三个问题:干预里的每个成分有没有证据?这个干预在我的科室做不做得下去?做完之后别人能不能照着重复?本章用四张表对应这三个问题,框架依据MRC/NIHR 2021复杂干预框架(Skivington等,BMJ 2021):它把研究分为开发、可行性、评价、实施四个阶段,每个阶段都要考虑情境、项目理论、利益相关者、关键不确定性、干预完善和经济学六个核心要素。
6.1 证据表:AI提取,人抽检
研究 | 设计 | 人群与场所 | 干预成分 | 对照 | 结局与时点 | 效应值 | 偏倚风险 | 原文引用与页码 |
AI填 | AI填 | AI填 | AI按TIDieR要素填 | AI填 | AI填 | AI填,人核对 | 人评(如RoB 2) | AI填 |
做法三条:第一,每个单元格都要有原文引用,原文没写的填“未报告”。第二,随机抽取20%的研究由人独立重新提取,重点查“漏提”:Gartlehner等2025年的研究中,AI辅助提取的准确率为91.0%,与纯人工的89.0%相近,两组最常见的错误都是遗漏[1]。第三,偏倚风险评价由两名研究者独立完成,AI最多把每个信号问题对应的原文位置找出来,不给判断。
6.2 成分—证据对照表
拿到证据表之后,把你设想的干预拆成成分,逐个问“凭什么要有这一项”:
干预成分 | 作用机制(对应理论概念) | 证据来源(证据表编号) | 证据是否一致 | 本地可行吗 | 决定(保留/修改/删除) |
如:出院前一对一健康教育 | 人填 | AI匹配,人核对 | AI列出矛盾的研究 | 人和临床团队定 | 人定 |
AI在这张表里最有价值的工作,是反向检查:哪些成分在证据表里找不到任何支持。这些成分不一定要删,但引言和方法里必须给出其他理由。
接着让AI按TIDieR的12个条目起草干预描述:名称、为什么、材料、程序、实施者、方式、地点、时间与剂量、个体化调整、修改、计划的保真度、实际的保真度。输入是你的方案草稿,约束是“草稿里没有的信息标为缺失,不要编”。产出的缺失清单,就是你方案还没想清楚的地方。
6.3 可执行性表:先定标准,再看数据
可行性研究的核心不是“效果好不好”,而是“正式试验做不做得下去”。每个指标都要先写清分子分母,再事先定下进展标准(交通灯)。
指标 | 分子/分母 | 数据来源 | 绿(继续) | 黄(修改后继续) | 红(停止或重新设计) |
合格率 | 合格人数/筛查人数 | 筛查日志 | 团队定 | 团队定 | 团队定 |
招募率 | 同意参加/合格人数 | 筛查日志 | 同上 | 同上 | 同上 |
保留率 | 完成随访/随机化人数 | 随访记录 | 同上 | 同上 | 同上 |
依从性 | 完成规定剂量人数/干预组人数 | 干预记录 | 同上 | 同上 | 同上 |
保真度 | 按清单完成的核心步骤/应完成步骤 | 保真度清单 | 同上 | 同上 | 同上 |
可接受性 | 评价“可接受”人数/应答人数 | 问卷或访谈 | 同上 | 同上 | 同上 |
资源 | 每例干预的护士工时与材料成本 | 工时记录 | 同上 | 同上 | 同上 |
阈值没有统一标准,必须由团队结合文献和本地情况事先写进方案并注册。AI在这里做两件事:用模拟的筛查日志写好计算脚本,正式数据到了直接跑;检查交通灯区间是否有缺口或重叠。
6.4 完整演练五:一项护士主导干预的开发与预试验
案例是Huang和Chair 2025年发表在BMC Nurs的研究[6]:香港中文大学团队开发了一项护士主导、基于常识模型(Common-Sense Model,CSM)的心衰自我护理方案,并在中国一所大学附属医院做了预试验。它完整覆盖了本章的三个问题:证据、干预描述和可执行性。
第1步:从证据到干预成分。 作者之前做过护士主导自我护理干预的系统评价,得出有效干预的核心成分通常包括:评估、自我护理知识与技能、问题解决、决策、目标设定、行动计划、提醒、监测、反馈和社会支持;最佳干预时长一般为1~3个月,作者参考已有研究选定6周。理论上,用常识模型和自我效能解释干预为什么有效,用Riegel的情境特定理论确定自我护理的三个结局维度。手册和日志经心血管专家和非专业人员审阅,I-CVI、S-CVI/UA和S-CVI/Ave均为1(专家人数未报告)。这一步对应6.2节的“成分—证据对照表”。
第2步:用TIDieR重构干预描述。 论文没有使用TIDieR,让AI从正文中按TIDieR成12条提取,核对后如下:
TIDieR条目 | 论文中的信息 |
1 名称 | 护士主导、基于常识模型自我调节的心衰自我护理方案 |
2 为什么 | 中国心衰患者自我护理不足;常识模型加自我效能 |
3 材料 | 教育手册(疾病管理信息、自我护理知识与技能、行为改变技术三部分);自我护理日志(目标与行动计划表、问题解决练习表、用药清单、健康记录表、运动记录表、液体摄入记录表) |
4 程序 | 住院期间一对一教育,出院后电话强化;各次具体内容在补充材料中 |
5 实施者 | 研究负责人一人统一实施;资质未报告 |
6 方式 | 面对面个体指导加电话随访 |
7 地点 | 医院内(出院前);出院后电话 |
8 时间与剂量 | 共6周:第1周面对面60分钟;第2、4、6周各一次20分钟电话 |
9 个体化 | 讨论中称“根据参与者需求调整”,未给细节 |
10 修改 | 根据参与者建议,在手册中增加了推荐食物的例子 |
11 计划的保真度 | 仅“由研究负责人统一实施以保证一致” |
12 实际的保真度 | 面对面时长中位数60分钟(IQR 47.5~60);三次电话中位数依次为20、15、15分钟(计划各20分钟) |
提取结果本身就是一份“缺失清单”:实施者资质、个体化规则、保真度监测方法,写正式试验方案时都要补上。
第3步:预试验设计。 单盲、两组平行随机对照预试验;独立研究者生成1:1区组随机序列,用顺序编号的不透明密封信封分配;不知分组的研究护士收集后测;对照组只接受常规护理。样本量按“预试验每组10~15人”的建议定为每组13人、26人。已在中国临床试验注册中心注册(ChiCTR2300068156),按CONSORT试点与可行性试验扩展版报告。
第4步:用可执行性表整理结果。
指标 | 分子/分母 | 结果 | 是否有预设标准 |
合格率 | 27/34 | 79.4%(排除7人:慢性肾病4期3人、无法沟通2人、近期参加其他研究1人、行动不便1人) | 否 |
招募率 | 26/27 | 96.3%(1人拒绝) | 否 |
保留率 | 24/26 | 92.3%(干预组1人因心衰急性加重住院退出,对照组1人失访) | 否 |
依从性 | 12/13 | 92.3%的干预组参与者完成全部干预 | 否 |
可接受性 | 10/12 | 83.3%的应答者对全部条目“同意”或“非常同意” | 是(>80%) |
数据收集 | — | 基线问卷中位数40分钟、后测20分钟;未报告缺失率 | 否 |
初步效果方面,广义估计方程显示组别×时间交互在疾病感知(β=−11.837)、自我护理自我效能(9.838)、自我护理维持(10.969)、症状感知(17.422)和自我护理管理(17.231)上均有统计学意义,生活质量、抑郁、焦虑、症状负担和睡眠无显著差异。预试验的主要目的是检验可行性,样本量不是按检验效果计算的,这些效果只能作为正式试验的参考,不能当作干预有效的证据。
第5步:人工核对发现的问题。
•六个可行性指标中只有可接受性有预设标准,其余只有结果没有标准,无法判断“是否可以进入正式试验”。
•文中写“认知感知有八个维度”,却只列出了七个(身份识别、后果、原因、时间线、个人控制、治疗控制、疾病连贯性)。这类“数字与列举不符”正是第8章脚本最容易抓到的问题。
•干预实施者同时收集基线数据,且未报告保真度监测方法。
•作者建议下一步开展包含过程评价的完整随机对照试验,并加入质性访谈了解参与者体验。
6.5 完整演练六:交通灯进展标准怎么写
Lyndon等2023年发表在J Adv Nurs的研究[7]是英国的一项整群随机可行性试验:6个全科诊所由临床试验中心计算机随机分为干预组和对照组各3个;用电子虚弱指数筛出65岁及以上的中重度虚弱者,再用PRISMA-7确认。干预由具备高级评估和非医疗处方能力的社区专科护士入户实施:综合老年评估,并与患者共同制定个性化照护计划,最多1次评估加6次照护计划访视,12周内完成;对照组接受常规初级保健。招募目标60人,实际招募56人(干预组30人、对照组26人)。
论文的交通灯标准表(原样转录,单位为%):
可行性标准 | 绿 | 黄 | 红 | 结果 |
初步接洽并最终参与的全科诊所比例 | ≥50 | 41~49 | ≤40 | 75.0 |
43周内完成招募目标(60人)的比例 | ≥50 | 41~49 | ≤40 | 93.3 |
完成3个月随访的比例 | ≥80 | 51~79 | ≤50 | 92.85 |
完成5个月随访的比例 | ≥70 | 51~59 | ≤50 | 87.5 |
干预组中达到最低干预“剂量”的比例 | ≥75 | 51~74 | ≤50 | 85.5 |
表注的含义是:绿色为达标;黄色为未达标但小幅修改方案后可以推进;红色为未达标且不大可能支持推进。这张表的结构值得照搬:指标、三档阈值、实际结果一目了然。
用AI逐行核对,发现的问题:
•时点叫法不一:表中写“3个月”和“5个月”,正文和摘要写“13周”和“26周”,另一处又写“6个月”,指的是同一时点。
•区间有缺口:第4行绿≥70、黄51~59、红≤50,60~69不属于任何颜色。
•数字不一:表中3个月随访完成率为92.85%,正文为94.6%(53/56);表中最低剂量比例为85.5%,正文为84.6%,而且“最低剂量”在全文中没有定义。
•分母与指标描述不符:诊所比例75.0%是6/8,分母是“表示有兴趣的”8个诊所;如果按指标描述的“初步接洽的”14个诊所算,是6/14=42.9%,会落在黄色区。
作者的结论是试验达到了预定的可行性标准,建议开展评价临床效果和成本效果的正式试验,并以EQ-5D-5L测量的健康相关生活质量作为主要结局。上述问题不一定改变这个结论,但说明:进展标准写得再清楚,也需要逐行核对。
写自己的进展标准时的四条规则:①指标描述里写明分子分母;②三档区间首尾相连,不重叠、不留空;③时点全文只用一种叫法;④“最低剂量”等关键概念在方案里事先定义。这四条也可以写进任务卡的验收标准,让AI在你写完方案后自动检查。
6.6 报告规范
文件 | 规范 | 条目数 |
试验方案 | SPIRIT 2025 | 34 |
随机对照试验论文 | CONSORT 2025 | 30 |
试点与可行性试验 | CONSORT 2010试点扩展版(尚无对应CONSORT 2025的更新版,可与CONSORT 2025配合使用) | 26 |
干预描述 | TIDieR | 12 |
偏倚风险评价(随机对照试验) | RoB 2 | — |
第7章 分析期刊与写作标准
7.1 投稿须知对比表
把3~5本目标期刊的投稿须知网页内容复制保存为txt(期刊网站常拦截自动抓取,手工保存最稳),文件名带上保存日期。用第3章的任务卡提取统一字段:收稿范围、文章类型、字数上限、摘要格式、要求的报告规范、预注册、数据共享、AI使用政策、版面费、参考文献格式。每个单元格都附逐字引用,没写的填“未提及”。
这张表要每季度重跑一次,用git比较新旧版本。理由很现实:仅在2026年,ICMJE(1月)、RCNi(1月版)、Elsevier(6月)都更新了AI相关政策,去年保存的结论今年可能已经过时。
7.2 期刊画像
从PubMed(Save→格式选PubMed或CSV)或Web of Science导出目标期刊近2~3年的全部记录,让Codex写Python脚本统计:各文章类型的数量、研究设计分布、作者国家、高频主题词。其中“按标题和摘要判断研究设计”是AI的判断,必须抽检:随机抽30条人工归类,计算一致率,达不到事先定的标准就修改归类规则重跑。画像的用处是回答“这本刊近两年发过多少篇与我同设计、同主题的文章”,比看影响因子更能判断匹配度。
7.3 报告规范逐条核对
把报告规范清单(官网下载)和你的稿件交给AI,输出:条目编号 | 是否报告(是/否/部分)| 稿件中的逐字引用 | 所在小节。关键在于怎么用这张表:
•证据显示,在PRISMA核对中单用AI最好的准确率约70%,单个人工约89%,人机协作可达89%~96%(其中25%~35%的条目交回人工判定)(Woelfle等,J Clin Epidemiol 2024);另一项以CONSORT为例的预印本研究中,表现最好的模型与专家的一致性κ也仅约0.28,模型识别已报告条目较准,却很难识别未报告的条目(He等,arXiv预印本2025)。
•因此,AI判为“否”的条目,直接拿去补;AI判为“是”的条目,反而要人逐条看它给的引用是否真正满足条目要求,因为这是它最容易出错的方向。
7.4 范文结构分析:学结构,不学句子
从目标期刊选取5~10篇与你同设计的近期文章,让AI用Swales的CARS模型标注引言每一段的“语步”:确立研究领域、指出研究空白、占据空白(本研究目的)。输出每篇引言的段落数、每段语步和每段引用数。你得到的是这本刊引言的“骨架”。不要让AI改写范文的句子放进你的稿件,换了说法的抄袭仍然是抄袭。
第8章 数据分析与稿件质检
8.1 模拟数据先行
真实数据不进项目文件夹时,分析代码怎么写?答案是先造一份模拟数据:让Codex按第4章的变量操作化表生成同样结构的数据(变量名、取值范围、缺失编码都一致),并人为设定一个已知效应,比如两变量相关系数为0.30。分析脚本跑完如果估计出来接近0.30,说明脚本没写错;这就是第3章的“已知答案测试”。然后由你在本地用同一脚本跑真实数据,AI全程不接触真实数据。
脚本要求写进AGENTS.md:固定随机种子;输出软件与包版本(R用sessionInfo(),Python用pip freeze);每次运行生成带日期的日志。主要结果再用另一种软件(如SPSS与R)复算一次。
8.2 数字一致性检查
这是投稿前最值得做的一项检查。任务卡要点:提取摘要、正文、表格中所有样本量、百分比和关键统计量,输出三类问题:同一指标在不同位置数值不同;用n/N复算后与报告百分比不符(保留一位小数);分组人数之和不等于总数。第5章Subraja等论文中“超过90%”与“约95%”的并存,第6章Lyndon等论文中“5个月”与“26周”的并存,都是这类检查能发现的问题。复算部分让AI写脚本计算,而不是让它“看一眼判断”。
复算百分比的脚本只需要几行。下面用第6章Lyndon等论文的两个数字演示:
# 指标, 分子, 分母, 报告值(%)
rows = [("13周随访完成率(正文)", 53, 56, 94.6),
("13周随访完成率(表格)",53, 56, 92.85)]
for name, n, N, reported in rows:
calc= n / N * 100
flag= "" if abs(calc - reported) < 0.1 else "<- 不一致"
print(f"{name}:复算 {calc:.2f}%,报告 {reported}%{flag}")
运行结果是53/56=94.64%,正文的94.6%通过,表格的92.85%被标出。实际使用时,让AI先把稿件中所有“n/N(%)”提取成这样的列表,你抽查提取是否完整,再运行脚本。
8.3 参考文献核验
语言模型编造参考文献是反复被证实的:一项研究中GPT-3.5和GPT-4生成的引文分别有55%和18%是编造的(Walters和Wilder,Sci Rep 2023);另一项在系统综述场景下测得的幻觉率为GPT-3.5 39.6%、GPT-4 28.6%、Bard 91.4%(Chelli等,J Med Internet Res 2024)。核验做法:
1.让Codex写脚本,按DOI查询Crossref、按PMID查询PubMed,比对题名、第一作者、年份、期刊。注意沙箱默认断网,这一步要在你自己的终端运行脚本,或仅为这一步临时允许联网。
2.输出三类:完全匹配、部分不符(如年份、卷期错)、查无此文。
3.“查无此文”的一律删除或人工找到原文后重新录入。引用的每一篇文献你都必须至少读过摘要,并确认它支持你引用处的说法。脚本只能证明文献存在,不能证明引得对。
第1步的脚本骨架如下(Crossref提供免费的公开接口)。输出的第一作者、年份和题名由你与稿件中的写法逐条比对:
import csv, requests
with open("08_manuscript/references.csv", encoding="utf-8") as f:
refs= list(csv.DictReader(f))# 列:id, doi
for r in refs:
resp= requests.get("https://api.crossref.org/works/" + r["doi"].strip(), timeout=30)
ifresp.status_code != 200:
print(r["id"],"查无此DOI")
continue
m= resp.json()["message"]
title= (m.get("title") or [""])[0]
year= m.get("issued", {}).get("date-parts", [[None]])[0][0]
first= (m.get("author") or [{}])[0].get("family", "")
print(r["id"],first, year, title[:60], sep=" | ")
8.4 术语与缩写一致性
先建一个术语表(中文术语 | 英文术语 | 缩写 | 首次出现处是否定义),再让AI扫描全文,找出同一概念的多种叫法(如“自我照护”与“自我管理”混用)和未定义就使用的缩写。改不改由你定,因为有些术语在理论里本来就不同义。
第9章 规范、伦理与披露
9.1 三色表:哪些能用,哪些不能用
颜色 | 用途 | 要求 |
绿 | 语言润色、代码编写与调试(模拟数据)、格式与报告规范核对、参考文献存在性核验 | 按期刊要求披露(写作协助一般写在致谢) |
黄 | 文献筛选与数据提取辅助、质性编码对照、用于真实数据的分析代码、数据图表 | 必须在方法中披露工具、用途和核验方式,全部人工核验 |
红 | AI署名;编造或“优化”数据与引文;用AI生成或修改代表原始观察或实验数据的图像;把可识别患者信息上传到未经批准的工具;审稿时把他人稿件上传AI;用AI直接生成基金申报书 | 不做 |
9.2 政策要点(截至2026年10月15日)
来源 | 要点 |
ICMJE(2026年1月更新) | AI不能作为作者;在投稿信和稿件中都要披露,写作协助写在致谢,用于数据、分析或图表的写在方法;AI生成的内容不能作为一次文献引用;不披露在某些情况下可能被视为不端;无法确保保密时,编辑和审稿人不应把投稿上传到AI系统 |
COPE(2023) | AI不能作为作者,作者对全部内容负责 |
WAME(2023) | 把AI用于分析时,报告完整的提示词、查询时间以及工具和版本 |
Elsevier(2026年6月) | 给出固定声明句式(见9.4);仅做语法拼写检查无需声明;不得用AI生成或修改代表原始观察或实验数据的图像;示意图等只在特定条件下允许,并须在图注中说明 |
Wiley、Taylor & Francis、LWW | 审稿人不得把稿件(包括图表)上传到生成式AI工具;Taylor & Francis和LWW对编辑也有同样要求 |
护理期刊调查 | 前50本护理期刊中70%有LLM政策;其中94%禁止LLM署名,97%允许用LLM辅助生成内容;另有52%禁止AI生成图像,49%禁止在同行评议中使用LLM。注意也有更严格的,如RCNi 2026年1月版政策规定,不得使用LLM和生成式AI工具撰写投给RCNi的文章 |
科技部监督司《负责任研究行为规范指引(2023)》 | 不得使用生成式AI直接生成申报材料;使用生成式AI生成的内容,特别是涉及事实和观点的关键内容,应明确标注并说明生成过程;不得直接使用未经核实的AI参考文献;生成式AI不得列为成果共同完成人;在研究方法或附录等位置披露使用的主要方式和细节;评议中使用须事先征得评议活动组织者同意 |
国家自然科学基金委员会(2026年1月14日通告) | 不得使用由生成式AI直接生成的申请书、进展报告或结题/成果报告;AI生成的信息和参考文献须人工核实;应全面如实声明使用情况,并按国家有关规定对相关内容进行标识,方式包括但不限于在文本起始和末尾适当位置添加文字提示 |
《个人信息保护法》 | 第28条:医疗健康信息属于敏感个人信息;第29条:处理敏感个人信息应取得单独同意;第38条:向境外提供个人信息应具备安全评估、认证或标准合同等条件之一;第39条:须告知境外接收方等事项并取得单独同意。把参与者资料上传境外AI服务就可能涉及这些条款 |
这张表不是法律意见。涉及真实患者数据时,以所在单位伦理委员会和数据合规部门的意见为准;投稿前以目标期刊当时的投稿须知为准。
9.3 披露写哪些内容:GAMER清单
GAMER是2025年发表的医学研究中生成式AI使用报告指南[8],共9条:总体声明、生成式AI工具的规格(名称、版本、使用日期等)、提示技术、工具在研究中的作用、新开发模型的声明、稿件中AI辅助的部分、内容核验、数据隐私、对结论的影响。做证据合成(系统综述等)时,Cochrane、Campbell、JBI和CEE于2025年发布的联合立场声明(Flemyng等,JBI Evid Synth 2025)支持RAISE(证据合成中负责任地使用AI)建议的目标,要求报告AI工具的名称、版本和使用日期、使用目的及影响了哪些环节,以及如何验证。附录B的记录表就是按GAMER的条目设计的,平时记全了,写声明时只是抽取。
9.4 声明模板
英文(Elsevier句式,方括号内替换):
During the preparation of this work, the author(s) used [Codex (OpenAI),
CLI version x.x, model as reported by the tool, accessed 1-15 October 2026]
in order to [check the manuscript against the STROBE checklist and write
Python scripts for reference verification]. After using this tool/service,
the author(s) reviewed and edited the content as needed and take(s) full
responsibility for the content of the published article.
中文:
本研究在[环节]中使用了[工具名称、版本或模型,使用日期],用于[具体用途]。
全部AI输出均由[作者姓名缩写]按[核验方法]逐项核验;未向该工具上传任何可识别个人信息。
AI未参与研究结论的形成,作者对全文内容负全部责任。
注意:Elsevier的句式针对的是写作过程中的AI使用;AI用于数据分析等研究方法时,应在方法部分单独描述。放在哪里:只用于写作协助的放致谢,用于数据、分析或图表的放方法(ICMJE),同时在投稿信里说明;期刊另有规定的从其规定。
附录
附录A 任务卡库(复制后替换方括号)
① 报告规范核对
【目标】逐条判断稿件是否报告了[STROBE/COREQ/CONSORT 2025]的每一条
【输入】04_guidelines/[清单].txt;08_manuscript/[稿件].md
【输出】09_checks/guideline_check_[日期].csv:条目|是/否/部分|逐字引用|小节
【约束】没有逐字引用的不得判“是”;不修改稿件
【验收】判“是”的条目由我逐条复核引用是否真正满足要求
② 数字一致性
【目标】找出摘要、正文、表格间不一致的数字和算错的百分比
【输入】08_manuscript/[稿件].md
【输出】09_checks/numbers_[日期].csv:指标|位置1数值|位置2数值|复算值|问题类型
【约束】复算必须用脚本完成,脚本保存到 06_scripts/
【验收】我抽查5处,脚本结果与手算一致
③ 参考文献核验
【目标】核对参考文献的DOI/PMID是否存在且与题名、作者、年份、期刊一致
【输入】08_manuscript/references.txt
【输出】06_scripts/check_refs.py;09_checks/refs_[日期].csv:编号|匹配/部分不符/查无|差异
【约束】只写脚本,由我在可联网环境运行;不得自行补全或改写文献
【验收】“查无”的文献全部由我人工处理
④ 证据提取
【目标】按第6章证据表的列提取[N]篇研究
【输入】02_literature/txt/
【输出】09_checks/evidence_[日期].csv(每个单元格附引用与页码)
【约束】未报告的填“未报告”;不做偏倚风险判断
【验收】我随机抽20%的研究独立提取,重点查遗漏
⑤ 期刊投稿须知对比
【目标】提取7.1节的字段,并与上季度版本比较
【输入】03_journals/[本季度文件];09_checks/[上季度CSV]
【输出】本季度CSV + 变更清单(字段|旧要求|新要求|原文引用)
【约束】只报告原文中有证据的变化
【验收】每条变更我都在期刊官网确认
附录B AI使用记录表(对应GAMER条目)
字段 | 填写示例 | 对应GAMER条目(简称) |
日期 | 2026-10-15 | 工具规格 |
工具、版本、模型 | Codex CLI x.x;模型以/status显示为准 | 工具规格 |
任务卡或提示词 | 文件名或全文 | 提示词 |
用途与角色 | 对照STROBE核对稿件 | 工具的角色 |
涉及的稿件部分 | 方法、结果 | AI辅助的章节 |
输入数据类型 | 稿件文本,无个人信息 | 数据隐私 |
核验方法与结果 | “是”的18条人工逐条复核,纠正2条 | 核验 |
对结论的影响 | 无,仅影响报告完整性 | 对结论的影响 |
是否微调或自建模型 | 否 | 新模型 |
主要参考文献
下面只列出本手册最主要的8篇文献(Vancouver格式,按正文首次引用顺序编号)。其余研究、报告规范和政策文件在正文中随文注明作者、期刊或发布机构和年份,可据此检索原文。
[1]Gartlehner G, Kugley S, Crotty K, et al. Artificial intelligence-assisted data extraction with a large language model: a study within reviews. Ann Intern Med. 2025;178(12):1763-1771. doi:10.7326/ANNALS-25-00739
[2]Yang H, Qiao Y, Liu S, Zhang Y, Wang K, Chen J, et al. Social support, health literacy, perceived control, and health-promoting behaviors in young and middle-aged lung cancer surgical patients: a structural equation model analysis. Front Public Health. 2026;14:1767727. doi:10.3389/fpubh.2026.1767727
[3]Kim KH, Kim CJ, Seo EJ, Park JS, Seo KW, Ahn JA. Factors influencing self-care among patients with heart failure based on the situation-specific theory: a cross-sectional study. Int J Nurs Pract. 2026;32(2):e70132. doi:10.1111/ijn.70132
[4]Subraja R, Helen Shaji JC, Bamini Devi N. Unveiling the hidden struggles: a qualitative study on caregiver burden among stroke survivors. BMC Nurs. 2026;25:41. doi:10.1186/s12912-025-04124-3
[5]Wu M, Guo X, Yang S, Li Y, Yu T, Liu H. Advantages, limitations, and ethical concerns of AI-assisted qualitative research in nursing: insights from a human-AI comparative thematic analysis. BMC Nurs. 2026;25:763. doi:10.1186/s12912-026-05085-x
[6]Huang Z, Chair SY. Development and pilot testing of a nurse-led common-sense model of self-regulation-based heart failure self-care program. BMC Nurs. 2025;24:85. doi:10.1186/s12912-025-02722-9
[7]Lyndon H, Latour JM, Marsden J, Kent B. A nurse-led comprehensive geriatric assessment intervention in primary care: a feasibility cluster randomized controlled trial. J Adv Nurs. 2023;79(9):3473-3486. doi:10.1111/jan.15652
[8]Luo X, Tham YC, Giuffrè M, et al. Reporting guideline for the use of Generative Artificial intelligence tools in MEdical Research: the GAMER statement. BMJ Evid Based Med. 2025;30(6):390-400. doi:10.1136/bmjebm-2025-113825
工具文档:OpenAI Codex官方文档,learn.chatgpt.com/codex(访问于2026-10-15)。