ARTICLE · 1193678
本地部署AI大模型门槛越来越低,企业先别急着把云搬回机房
大家好,我是兰彻,一个擅长 AI 技术、也专注帮助小微企业把 AI 落进真实业务的创业者。
最近,Meta 发布了开放权重多模态模型 Muse Spark Open。按照 Meta 的介绍,它总参数 8160 亿、每个 token 激活 420 亿参数,支持 100 万 token 上下文,并可在两台配备 M5 Ultra 的 Mac Studio 上本地运行。
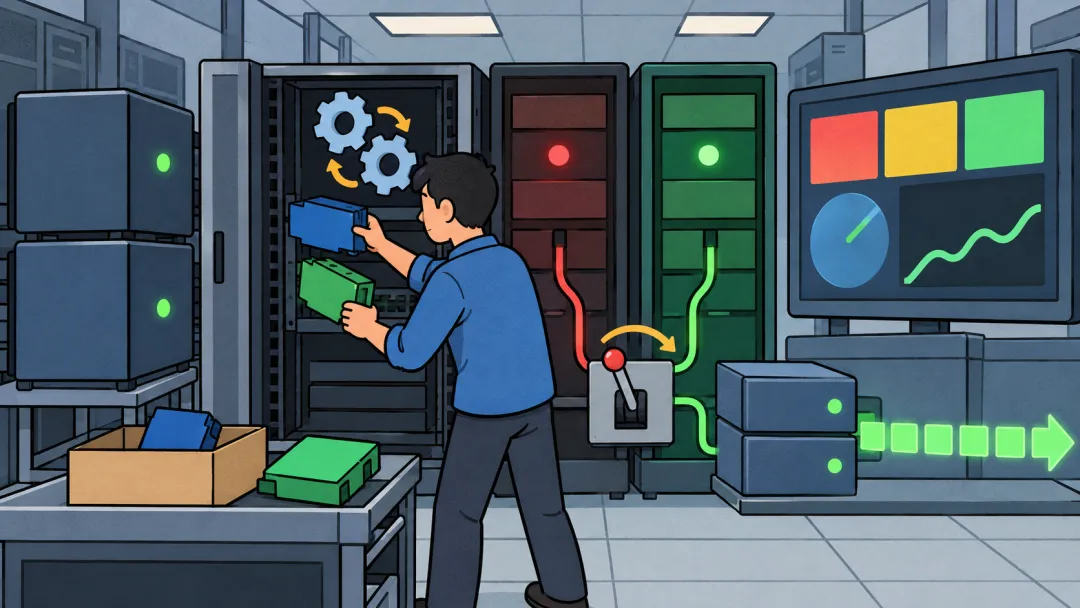 同一天,NVIDIA 发布了可定制的多模态模型,Intel 则推出针对 Xeon 的推理微服务,试图把模型、vLLM 配置、硬件识别和监控封装起来。NVIDIA 提到的吞吐提升是官方测试口径,真实效果仍需企业在自己的任务和硬件上验证。
这些消息放在一起,说明一个趋势:企业获得模型、在自有设备上运行模型,正在比以前容易。
但“能在本地跑”和“适合放进生产”之间,还隔着很长一段路。
开放权重降低的是模型进入门槛,不会自动消除部署、运维和责任成本。
本地部署重新成为一个真实选项
过去,小团队讨论本地大模型,常常先被硬件、适配和推理框架劝退。模型太大,配置太复杂,买完设备还要投入不少工程时间。
现在,开放权重模型越来越多,硬件厂商开始提供经验证的配置,接口也逐渐兼容常见标准。企业不再只能在“调用一家云 API”和“从零搭一套系统”之间二选一。
对数据敏感、网络条件特殊、需要固定延迟,或者有大量稳定任务的企业来说,本地部署因此更值得纳入评估。
 注意,是纳入评估,不是自动成为答案。
两台设备可以把模型启动起来,只能证明技术路径可行。它没有直接回答同时多少人使用、峰值是否排队、模型更新谁负责、故障多久恢复,也没有算出三年总成本。
隐私不是“放在公司里”五个字
很多企业想本地部署,第一理由是数据安全。
这个方向没错,但数据留在办公室或机房,并不等于安全问题已经解决。
谁能上传文件,日志记录什么,向量库是否包含个人信息,管理员能否看到全部对话,备份放在哪里,员工离职后权限何时收回,这些问题仍然存在。
 如果权限混乱、设备不打补丁、日志长期裸放,本地系统照样可能出问题。反过来,边界清楚、合同明确、权限可审计的云服务,也不该仅因为“在云上”就被一概判定不安全。
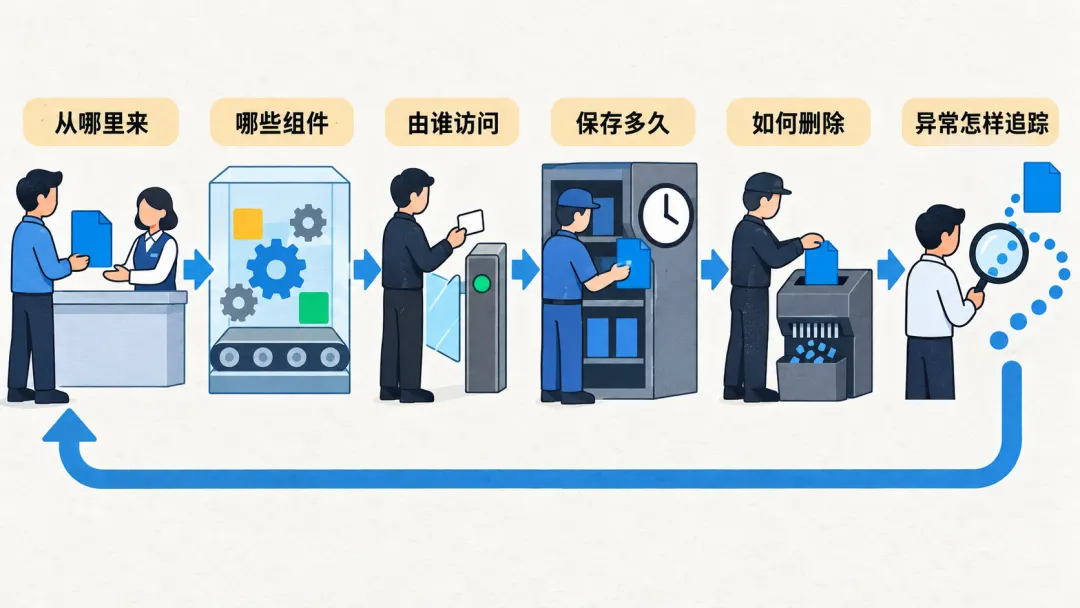
真正要比较的是完整数据链:数据从哪里来,经过哪些组件,由谁访问,保存多久,如何删除,出现异常怎样追踪。
部署位置只是其中一格,不是整张答卷。
硬件价格之外,还有一笔“有人管”的账
本地部署容易被算成一次性采购:买机器,装模型,完成。
 生产系统的账却是持续发生的。
模型和推理框架需要升级,驱动和依赖可能冲突,监控要有人看,容量不够要扩,设备坏了要恢复。遇到输出质量下降,还要分清是模型版本、提示词、数据还是运行环境出了变化。
云端方案把其中一部分工作交给供应商,价格通常随调用量变化;本地方案把更多控制权拿回来,也把更多日常责任拿回来。
小团队最稀缺的往往不是一台机器,而是能够长期负责这套机器的人。
因此,采购前别只比每百万 token 的单价和设备售价。还要把实施、测试、监控、备份、升级、故障恢复和人员时间放进同一张总成本表。
长上下文和大参数,不等于你的任务更好
100 万 token 上下文、数千亿参数很吸引眼球,但企业真正购买的是任务结果。
合同抽取是否漏关键条款?产品图片识别能否稳定输出字段?客服知识问答是否引用正确版本?代码智能体能不能在权限范围内完成修改?
这些问题不能靠参数规模直接回答。
 模型能装进设备,也不代表业务数据能直接塞进上下文。资料需要清洗,权限需要隔离,答案需要验收,错误需要有人接管。
企业评测时,应准备一组来自真实流程、经过脱敏的样本,同时记录准确性、延迟、并发、失败类型和人工复核成本。厂商基准用于初筛,自家任务才决定是否上线。
混合方案往往比站队更实用
很多企业最终不必在“全部本地”和“全部上云”之间站队。
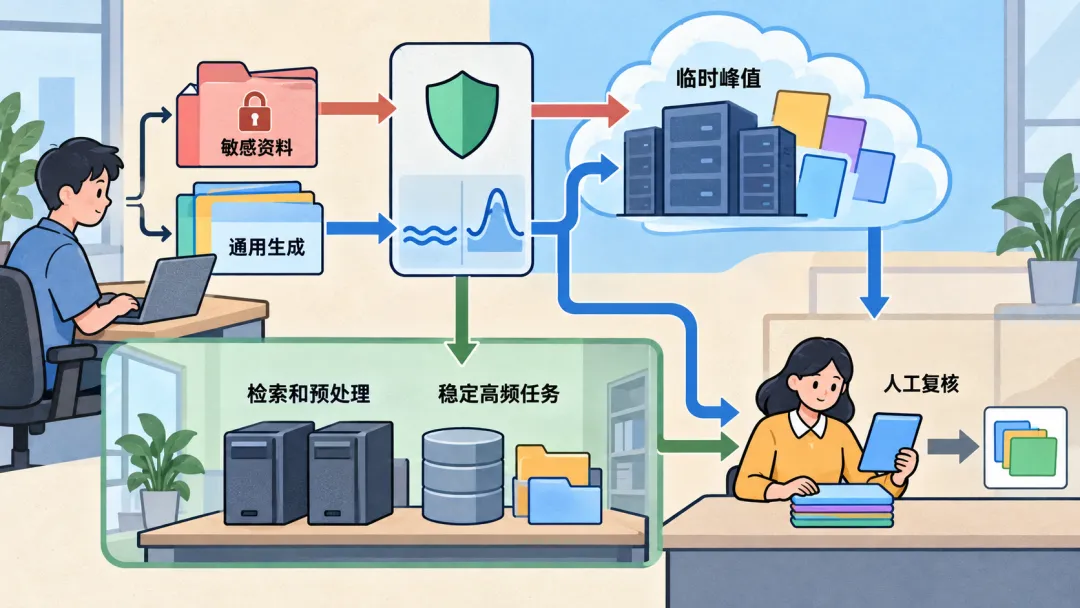
敏感资料的检索和预处理可以放在本地,通用生成走云端;稳定高频任务放在自有设备,临时峰值交给云资源;核心流程保留一个可替换模型,低风险创意任务使用更新更快的外部服务。
混合方案也会增加架构和管理复杂度,所以不能为了显得先进而硬拆。判断标准仍然是:它是否降低了明确风险,是否改善了成本或连续性,团队是否管得住。
如果一个任务数据并不敏感、调用量很小、变化很快,本地部署可能只会多养一套系统。如果任务长期稳定、数据边界严格、调用量可预测,本地方案才更有机会体现价值。
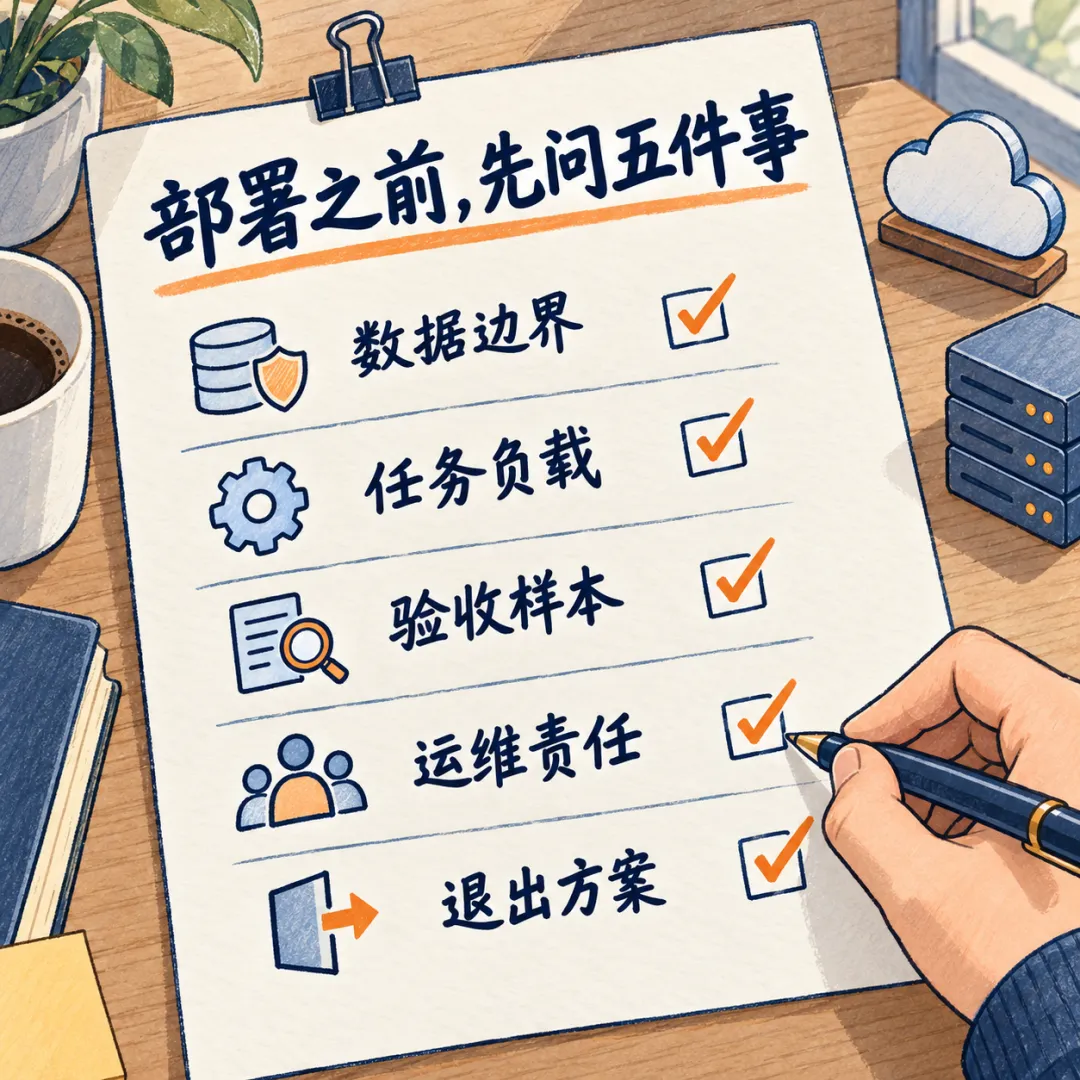 小企业做决定,先回答五个问题
第一,哪些数据确实不能离开指定环境?不要用一句“都敏感”代替分类。
第二,任务负载是稳定还是波动?平均调用量之外,也要看高峰和增长。
第三,结果怎样验收?没有真实样本,就无法比较本地模型和云端模型。
第四,谁负责运行?要明确升级、监控、故障和安全责任,而不是默认交给“懂电脑的人”。
第五,如何退出?模型、数据、提示词、评测集和接口最好不要全部绑死在一个供应商或一种硬件上。
先选一条边界清楚的流程做小规模验证。能稳定运行、能看懂成本、能处理失败,再决定是否扩大。
结尾
开放模型和推理工具的成熟,是一件好事。它让企业有机会把更多选择权握在自己手里,也让本地部署从少数技术团队的项目,逐渐变成普通企业可以认真比较的采购选项。
但选择权越多,越需要把账算完整。
本地部署的价值不是“服务器在我这里”,而是数据、成本、运行和退出都真正可控。
我是兰彻,长期关注 AI 和企业服务怎样进入小微经营。如果你的团队正在比较本地模型、云 API 或混合方案,欢迎来聊一条具体流程。我们可以先把数据边界、任务负载、验收样本和运维责任摆到桌面上,再决定模型该放在哪里。