ARTICLE · 1203002
为人类造的工具,接不住 AI 的产量
为人类造的工具,接不住 AI 的产量
日均代码合并四个月涨了 12 倍,最先倒下的不是模型,是 Git。
一、Git 先撑不住了
Anthropic 最近做了一件在工程师圈子里有点炸的事:把内部单体仓库从 Git 迁到了自研的版本控制系统 Scion。
Git 不是什么小众工具。过去二十年,它是整个软件世界的协作底座。但在 Anthropic,它的极限来得很具体:2026 年 5 月公司平均每天合并约 2500 次代码变更,到 9 月这个数字超过 3 万次,四个月涨了 12 倍。
撑不住的地方不在功能,在物理。Anthropic 的单体仓库主分支历史接近 100GB,压缩后的工作副本也超过 25GB。Git 的设计是「每个人手上都有一份完整副本」,这在人写代码的年代很优雅,到了智能体时代就变成浪费:仅 CI 环境每天就要执行约 2500 万次代码检出,不加优化的话,每天会产生超过 600PB 的内部流量。
Anthropic 曾经维护数百台内部 Git 镜像来分流。但快照每次更新后和主线的差距越拉越大,镜像同步的速度,赶不上 Claude 写代码的速度。
一个为「断网人类」设计的系统,被一群「永远在线」的智能体压垮了。
二、不是 Git 不行,是它为人造的
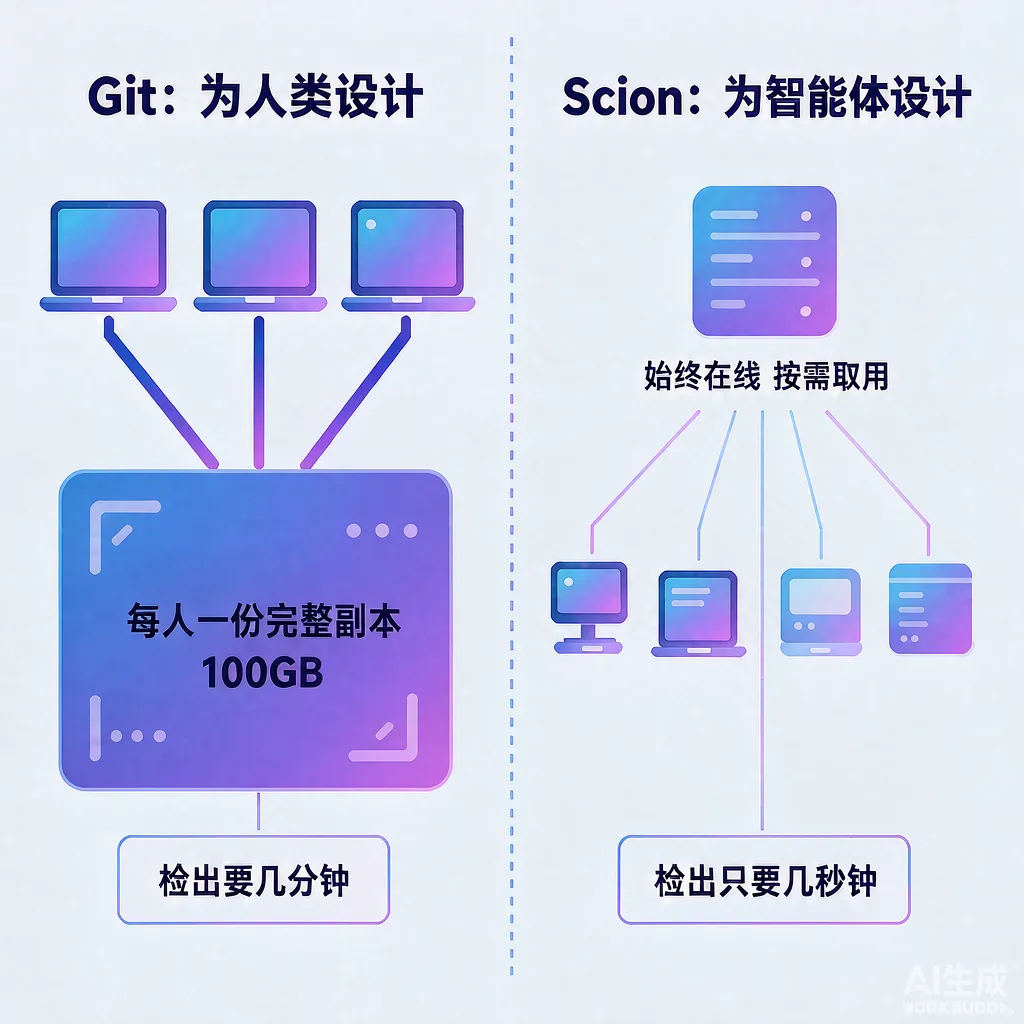
Anthropic 的反思很直接:既然绝大多数访问方都是一直在线的智能体和自动化任务,那 Git 那些适合分布式离线工作的特性,反倒成了仓库扩容的阻碍。
Scion 把这个前提反了过来。既然客户端始终在线,那就没必要把 100GB 的历史下载到本地——谁最后改了这一行、两个版本差在哪,Agent 发一个 API 请求问服务器就行。Scion 支持虚拟化检出:改哪个文件夹就只拉哪个文件夹,甚至只有程序真正去读某一行文件时,数据才从缓存里流式传过去。它还砍掉了本地打包和全局锁,一次提交的耗时只跟改了多少行有关,跟整个仓库有几千个 G 毫无关系。
结果很硬:Scion 的 CPU 和内存占用是原来 Git 镜像集群的 1/200,各级缓存命中率超过 99%,代码检出从几分钟缩短到几秒钟,仅 CI 一项就省下了 25% 的算力。
这个数字值得停一下。25% 的算力不是靠更好的芯片、更强的模型省出来的,是靠换掉一个大家已经用了二十年、默认不会去动的基础工具省出来的。
三、整条研发链路一起换:审查、搜索、CI
更值得注意的不是 Scion 本身,而是它不是一个人上场的。
一个 7 人团队用 5 个月,完成了 Scion、代码审查平台 Antique、代码搜索、身份与访问管理系统,以及六个相关系统的构建和全量迁移。版本控制只是被顶到极限的第一块砖,后面跟着的是审查、检索、权限和构建。
同一时间,Anthropic 也在重做代码审查流程:6 月到 9 月,团队合并的 PR 数量翻了一倍,而被回退的变更占比反而下降 40% 以上。目前 Claude 编写了 Claude Code 自身约 90% 的代码。
这里有一层递归的味道。在 Scion 的开发过程中,Claude 的早期内部版本重写了 Git 到 Scion 的数据导入管道,在没有额外指示的情况下,产出了一个内存占用降到 1/20、速度提升 4 倍的版本。
把这套系统写爆的,和帮忙把它重建起来的,是同一个东西。
四、同一道坎,机器人也走到了
几乎同一周,具身智能在另一个层面撞上了同一道坎。
上海本月启动「加快发展新一代智能制造行动」,明确到 2028 年推动 8000 台人形机器人进工厂、工业机器人密度达 600 台/万人。配套的动作更有意思:10 月 23 日至 25 日的国际具身智能技能大赛,主打的不是比谁跑得快,而是把机器人一身的本事拆成一个个独立可复用的技能包——抓取物体、视觉识别零件、拧紧螺丝、避障行走各自成包,按场景组合调用。
过去行业怎么做?程序是写死的。专门干装配的机器人,要换去做巡检,只能从头开发一套代码。现在本体被当成一台「苹果」,技能包就是 App,按需组合调用:工厂做精密装配,调用「视觉识别+抓取+拧紧螺丝」;换到仓库分拣,调用「行走避障+物品识别+搬运码放」。
这次大赛设 9 大赛道、23 个赛项,覆盖生产制造、检测分析、维修维护、仓储物流、餐饮、零售、医疗康养等场景,延锋汽车、申通快递、百联集团等场景方把真实岗位需求直接搬进赛场。也就是说,技能包不是摆在看台上的概念,是要拿真实产线的活来验的。
这和 Scion 是同一件事:当产量和场景数同时涨上去,为一整条流程写死的做法就先到极限,必须把能力拆成可组合的单元。
五、2.2 万台里,只有 13% 真的在干活
但拆开不等于跑通。
《具身智能发展报告(2026 年)》给出的数字很实在:2026 年上半年全球人形机器人出货量超过 2.2 万台,同比增长近 300%。可拆开结构看,文娱商演和科教数采合计占比超过 60%,导览导购约 19%,真正落在智能制造的只有约 13%,仓储物流约 5%。
热度另一头是冷意。报告同时指出,2026 年上半年国内融资约 935 亿元,同比提升约 5 倍,百亿估值企业增至 20 家;但未来两至三年将完成首轮行业出清,可持续商业闭环尚未形成。
也有真跑起来的。乐聚智能与兆丰机电联合发布的方案里,15 台人形机器人已经在汽车零部件产线上常态化运行,在多工位交错的狭窄环境里完成 10 余个动作序列,稳定抓取内径 80 至 120 毫米的零件,打通「预备—取料—转运—上料」全流程。
从试点验证到常态化作业,这一步比多卖几万台更关键。
六、评测也失准:同一个模型差 47.7 分
如果连度量工具都开始摇晃,问题就不再是「工具慢」这么简单。
Gemini 4 Argon 在 ARC-AGI-3 上拿到 97.5%,Google 成为继 OpenAI 之后第二家突破 95% 的实验室。但这个分数来自使用厂商特性的 Provider Adapter Harness;换成只允许简单笔记的 Standard Harness,同一个模型只有 49.8%。
同一个模型,两套框架,相差 47.7 分。
在 Epoch AI 的综合指数上,Argon 是 165 分,Fable 5.1 也是 165,GPT-6 Astra 是 166,Opus 5.5 是 167——差距不到两分。前沿模型之间的真实距离,已经小到能被评测框架的选择彻底盖过。
后果比一次争论更严重:当分数可以由配置决定,benchmark 就从尺子变成了可调参数。所以 Anthropic 让 METR 的 6 名研究员进驻公司,配备与内部风险团队相当的访问权限,并且可以不被否决地发布评估结论——因为自家的尺子已经不够用了。
七、反例压轴:换工具不等于提效
走到这里,很容易得出一个乐观结论:工具换掉就好了。
Scion 自己就把这个结论否掉了一半。Anthropic 明确说明,Scion 不是 Git 的通用替代品。它只在超大单体仓库、或者有海量智能体写代码的场景里成立,而且必须依赖配套的定制代码审查、搜索和 CI 工具才能运转。原话是:其他公司很难采用这种操作。
技能包同理。8000 台进工厂的目标立在那儿,可智能制造在出货结构里只占 13%;每个技能包到了具体产线,仍然要为物料偏差、光照变化、零件位置波动重新调。把能力拆成 App 降低了组合成本,没有降低适配成本。
换工具解决的是「能不能扛住量」,解决不了「量里有多少是真活」。 3 万次日均合并反映的是仓库吞吐,不等于 3 万个独立功能。
八、能力是普及的,配套是私有的
把这几件事放在一起,会看到一个不太舒服的结构。
模型是买得到的,智能体是装得上的,开源权重是能下载的。但 Scion 不对外提供通用版,Antique 是内部的,METR 的访问权限是谈出来的,8000 台进工厂的场景清单是地方产业政策和供应链配套堆出来的,那 15 台常态化运行的机器人是在真实产线上磨出来的。
规则层面也在收紧。中国计划限制 23 项 AI 技术出口,覆盖模型权重、源代码,以及算力超过 10 的 26 次方 FLOPs 或参数超过 2 万亿的系统的训练方法,开源发布另走快速登记通道。模型能下载,不代表能带走、能带去哪里,那是另一套规则在管。
AI 的能力正在变成公共品,承接这套能力的配套设施却越来越私有。
这意味着产能红利不会均匀分布。同样用上最强的模型,有配套改造能力的公司能把 CI 算力省下 25%、把合并量拉到 12 倍;没有的那一家,可能在几千次合并时就先撞上自己那套为人类造的工具链。
判断一家公司的 AI 落地到了哪一步,也许不该再问它用了什么模型,该问它为了接住这个模型,重造了几件工具。
结语
二十年前 Git 取代更老的版本控制系统,因为它适配了分布式协作的人类。今天 Scion 出现在 Anthropic 内部,因为它适配了永远在线的智能体。
工具从来不决定方向,但它决定上限。
你所在的团队,为了接住 AI 的产量,已经重造了哪一件工具?欢迎在评论区聊聊。觉得有启发,点个在看。