ARTICLE · 1205669
让 AI 把选题说具体?我让模型找了 117 个研究空白,至少 15 个早就有人做了
导读开题找方向时,很多人会问 AI:「这个领域还有哪些没人做的问题?」它通常立刻给出五条,措辞笃定。但一个不联网、不能检索的模型,凭什么知道「什么还没人做」?
我让本地模型对 12 个硕博常见方向各写了 5 条「尚未解决的研究空白」,共 117 条,然后逐条去 arXiv 和 Crossref 检索。至少 15 条早就有论文在做;而当我要求它把话说具体之后,被证伪的比例从 22% 降到了 3.4%——但这不代表它变准了。
章节一、为什么测这个
参考文献编错了,审稿人一查就知道。但「这个方向还没人做」这句话不一样:它看起来是判断,实际上是事实陈述,而且是一个很难查的否定事实。
要确认「某篇论文存在」,查一次就行。要确认「某个方向没人做过」,你得证明全局不存在——这本来就是人类研究者都要花几周做文献调研才能勉强回答的问题。模型没有任何检索能力,它说这句话时唯一的依据是训练时记住的东西。
更麻烦的是,这句话的语气通常非常肯定,而且和真正的领域洞察长得一模一样。所以我做了这次实测——测的不是模型「编不编文献」(上一篇测过),而是它「知不知道什么不存在」。
章节二、怎么测的
用的是一台 Mac 上的本地模型 qwen3:8b(80 亿参数,通过 ollama 跑,全程没有联网、不能检索)。选它的理由正是这一点:它说「还没人做」时,除了训练时记住的东西,没有任何别的依据可依。
输入是这样设计的:
●12 个方向,AI/CS、理工、社科交叉各 4 个,都是硕博常见选题区;
●每个方向要 5 条「尚未解决的研究空白」,共 117 条(有 3 条模型没按格式输出,丢弃了);
●temperature 0.2、随机种子固定、一次生成不重采样——不给它第二次机会。
- 两档提示
,用来对比「换个问法能不能改善」: ●
P1朴素问法,和大多数人问 ChatGPT 找选题时差不多:「列出这个领域尚未解决的 5 个研究空白」;●
P2加强问法,把要求写成硬约束:必须点名方法或场景、禁止「需要更多研究」这类空话、只有确信没人做过才说;
然后是核查。判定一条「空白」到底是不是空白,比判定一条文献存不存在更难,因为没有 DOI 可以直接查。我的做法是三步:
1从这条空白里挑出最能代表它的 4 个词,组检索式。不能按出现顺序取词——空白句几乎都以「Few methods address...」这种元话语开头,照顺序取会得到 methods / issue 这类词,检索式宽泛到能命中上万篇无关论文。所以按专有名词和长词优先来挑(FedProx、non-iid、perovskite 这类)。
2拿这组检索式同时查 arXiv 和 Crossref 两个数据源,各取前 10 条结果的标题。
3判断命中的论文是不是真的在做这件事,而不是只看命中多少篇。具体是算「这条空白的内容词被论文标题覆盖了多少」,比例越高说明越可能是同一件事。
最后一步我一开始想定一个阈值,但试完发现不能这么干:拿 30 条「一定已被研究过」的真实论文标题跑同一套流程,它们的相似度最低 0.83、中位 1.00(因为是用标题查自己);而模型给的空白,相似度中位只有 0.36。两者根本不在同一个量级,用前者去校准后者,会得到 0.8 这种对空白几乎不可能达到的值——等于什么都没证伪,纯属自欺。
所以改成分三档,不再纠结单一阈值:
分档的依据是:那 30 条真实论文标题 100% 落在强证据档。也就是说,强证据档的标准是「真实存在的研究方向一定不会漏」的级别——落在这一档的空白,就是确定被证伪的。所以我给出的被证伪比例是保守下限,不是某个阈值下的数字。
全程 arXiv 请求 192 次、Crossref 请求 159 次,两个接口都不需要 API key。
章节三、结果
117 条「研究空白」逐条查完,分成三档:
| 强证据 | 12.8% | ||
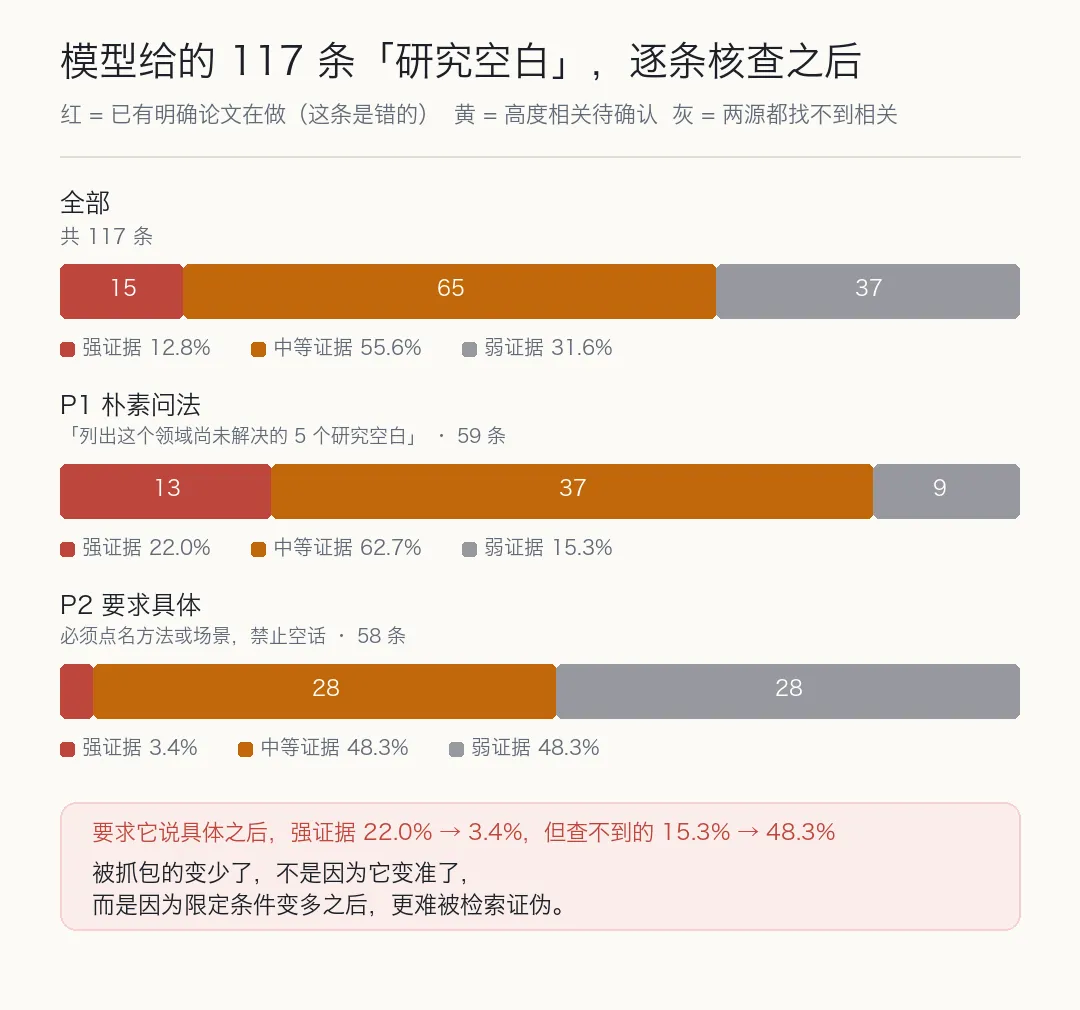
由于强证据档的标准是「真实存在的研究方向 100% 不会漏」,所以 12.8% 是下限:确定错的至少有这 15 条,实际更多。
真正让我意外的是换个问法之后的变化。我把同样 12 个方向问了两遍,一遍是朴素问法(P1),一遍是加了硬约束的问法(P2:必须点名方法或场景、禁止空话):
| 22.0% | |||
| 3.4% | 48.3% |
看起来像是「提示工程起效了」——被抓包的从 22% 掉到 3.4%。但同一时间,「查不到任何相关」的比例从 15.3% 涨到了 48.3%。
这两件事必须一起看:变化的不只是「错了多少」,还有**「能被查证多少」**。要求它把话说具体之后,每条空白都挂上了更窄的限定条件,检索式自然更严,能命中的论文就更少。它没有变得更可靠,它只是变得更难被验证。
分学科看也藏着同样的陷阱:
| 47.4% | ||
理工方向「查不到」的比例接近一半,但这不能读成「理工的空白更可信」——CRISPR、钙钛矿、单细胞测序这些方向,arXiv 和 Crossref 的覆盖本来就不如 CS。查不到,很多时候只是没收录。
章节四、被抓包的几条长什么样
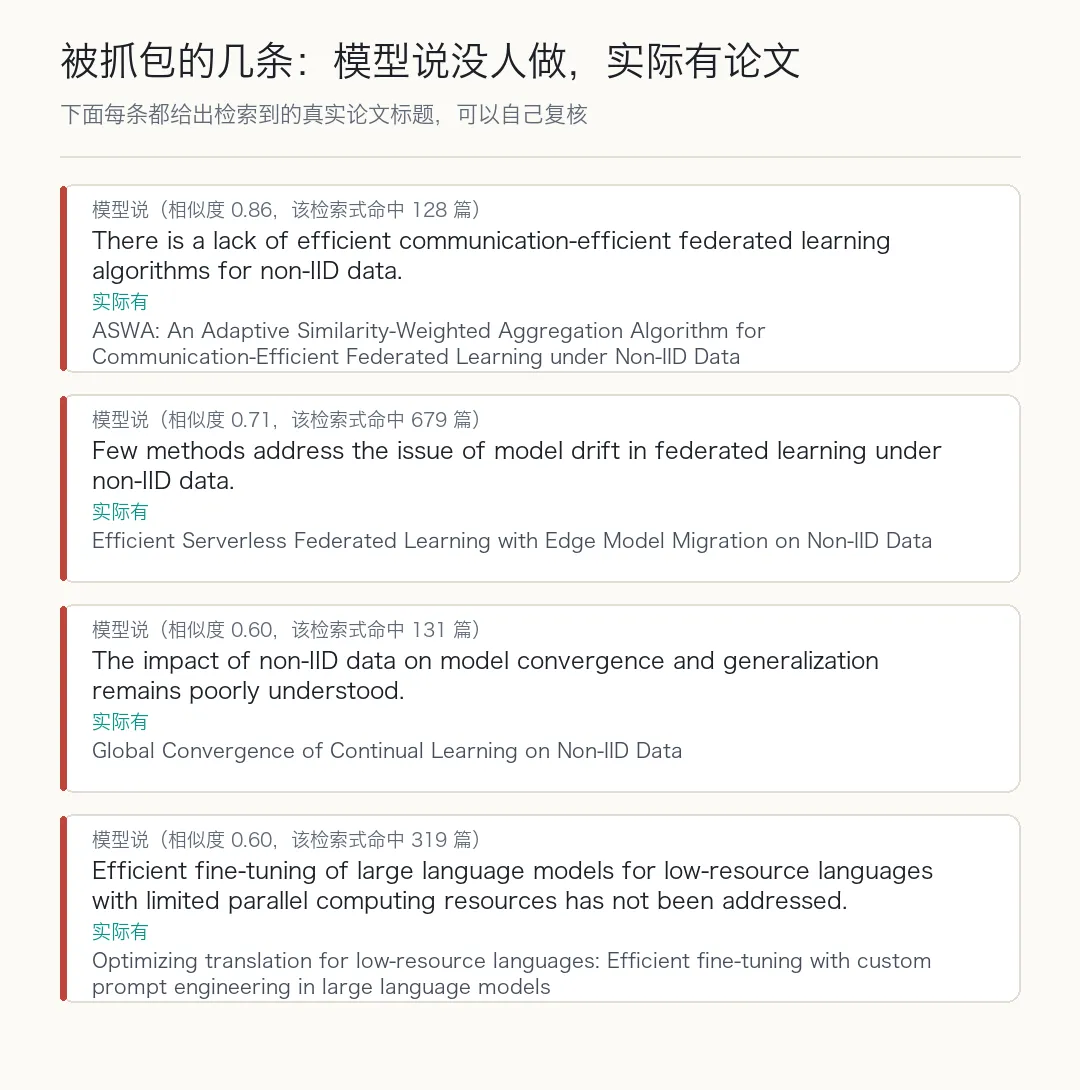
下面每条都给出了检索到的真实论文标题,可以自己复核。
第 1 条(相似度 0.86,全场最高)
模型说:非独立同分布数据下,缺乏通信高效的联邦学习算法。 实际有:ASWA: An Adaptive Similarity-Weighted Aggregation Algorithm for Communication-Efficient Federated Learning under Non-IID Data(该检索式命中 128 篇)
标题里的「communication-efficient」「federated learning」「non-IID data」,和模型的说法逐字对应。
第 2 条(相似度 0.71,命中 679 篇)
模型说:少有方法解决非独立同分布数据下的联邦学习模型漂移问题。 实际有:Efficient Serverless Federated Learning with Edge Model Migration on Non-IID Data
第 3 条(相似度 0.60,命中 131 篇)
模型说:非独立同分布数据对模型收敛和泛化的影响仍不清楚。 实际有:Global Convergence of Continual Learning on Non-IID Data
这条最能说明问题:模型说的是「还不清楚」,而对面那篇论文的标题就叫「非独立同分布数据上的全局收敛性」——不是没研究,是研究得很直接。
第 4 条来自 P2(要求具体)那一组(相似度 0.60,命中 319 篇)
模型说:低资源语言、并行算力受限场景下的大语言模型高效微调尚未被解决。 实际有:Optimizing translation for low-resource languages: Efficient fine-tuning with custom prompt engineering in large language models
这条值得单独看:它已经把条件叠到了「低资源语言 + 算力受限」,仍然被检索命中。把限定条件写细,也没能躲开。
另外社科方向还有一条(相似度 0.63,命中 223 篇):模型说「把数字孪生接入现有供应链系统缺乏标准化框架」,而检索到的是 Reference Network Design For Integrating Digital Twins With Existing Manufacturing Systems。这类错误最有代表性——它不是编造,是把真实存在的工程问题,安在了一个已经有大量论文的场景上。
章节五、为什么会这样
不是模型想骗人,是它结构上做不到这件事。
它的训练目标是「预测下一个最可能的词」。在「研究空白」这个语境下,最可能出现的词序列,就是综述论文里反复出现的那些句式:There is a lack of...、The impact of X remains poorly understood、Few methods address...。它是在复现「研究空白」这个体裁的语言模式,不是在检索文献库后给出判断。
这也解释了为什么它错的那些往往错得很整齐——上面被抓包的几条,句式几乎一模一样。
关于「要求具体反而更难证伪」,我的理解是:具体性来自条件叠加,而不是来自知识。 让它说具体,它会往句子里加限定词("低资源语言"+"并行算力受限"),句子变窄了,检索更难命中,但它对"这个组合有没有人做过"并没有多知道一分。
一个更实际的推论是:这类输出的价值不在结论,而在词汇。 它能在几秒内把一个方向拆成若干可检索的子问题,这确实有用;但哪个子问题真的空着,只能靠你自己去查。
章节六、边界:这篇不能证明什么
这篇最容易被误读的地方,我按重要性排:
●测的是 8B 本地小模型,不是任何商用大模型。 本文不宣称「GPT-5 / Claude 找选题的准确率是 X%」。能支持的结论只有一句:一个不接检索、只靠参数记忆的模型,说「没人做过」时并不可靠。参数量更大的模型在这类任务上大概率更好,但好多少,本文没测。
●「检索不到」不等于「真的没人做」。 可能是检索式没命中、可能是数据源没收录、也可能是这条空白的表述太绕。所以 31.6% 的「弱证据」里有一部分其实是真空白,本文给不出比例。
●越具体的表述越难被证伪,这是方法本身的偏向。 一条写得很具体的空白,检索式必然更窄,命中自然更少。所以前面第三节里「要求具体」那一组的强证据比例明显更低——这部分差异里有多少是真的更可信,有多少只是更难查,本文区分不出来。这是我认为本次实验最该被记住的一条限制。
●两个数据源覆盖都不全。 arXiv 强在 CS、物理、数学的预印本,生物医学和社会科学覆盖很弱;Crossref 强在期刊论文,预印本和会议论文收录不全。分学科的数字要带着这个前提看。
●只查「有没有人做过」,不查「值不值得做」。 一条空白即使真的没人做过,也不代表它是好选题。
●分档的边界(0.60 / 0.30)是人工划的,依据是 30 条校准样本的相似度分布。校准样本量小,换一个领域应当重新校准;好在结论方向不依赖这条边界——无论怎么划,「要求具体」那一组的弱证据都接近一半。
●只查英文文献。 中文期刊、学位论文不在两个数据源的覆盖范围内。
章节七、拿到 AI 给的选题之后,可以照着做的 4 步
1要它同时给出「如果已经有相关工作,可能会叫什么」。 这等于逼它把核查锚点一起交出来。本次实验里最靠不住的那几条,恰恰是没有任何可核查锚点的。
2换 2~3 组不同的检索词自己查一遍。 同一条空白用不同的词去查,结果可能完全不同。只查一次就相信,和只问一次 AI 就相信,是同一个错误。
3对特定句式保持警惕。 本次实验里,「lack of」「few studies」「remains unclear」「has not been」这类元话语开头的句子占 56%,其中 18.2% 被明确证伪;而表述具体的句子只有 5.9% 被证伪——这类句式本身就是在回避可核查的断言。
4把 AI 的输出当检索词灵感,不要当结论。 它能很快帮你把一个方向拆成若干可搜索的子问题,这是它真正有用的地方;至于哪个子问题真的空着,得靠你自己查。
章节八、可复现清单
gen_gaps.py # 让本地模型生成研究空白(两档提示)
check_gaps.py # 关键词抽取 + arXiv/Crossref 检索 + 阈值校准
compute_gaps.py # 所有百分比在这里现算,图和文都读同一个结果文件
gaps.json # 117 条模型原始输出
probe_gaps.json # 逐条检索证据(命中数、标题、相似度)
results_gaps.json # 最终统计
改模型、换领域、加方向都只动 gen_gaps.py 里的 TOPICS 和 MODEL 两个常量。
选题是科研里最靠前的一个决定,一旦方向选错,后面几个月都会跟着错。查一条「空白」只要几分钟,但省下来的可能是半年。
AI 写完的东西,签字的是你。 对选题来说,这句话的分量比对引用更重——引用错了能改,方向错了要重来。
章节参考资料
01 Exploring the role of large language models in the scientific method: from hypothesis to discovery(Nature Reviews 综述,文中提到「部分人类评估显示 LLM 生成的想法新颖性偏低」):https://www.nature.com/articles/s44387-025-00019-5
02 arXiv API 使用说明(本文 192 次检索的接口):https://info.arxiv.org/help/api/index.html
03 Crossref REST API 文档(本文 159 次检索的接口):https://api.crossref.org
04 LLM hallucinations in the wild: Large-scale evidence from non-existent citations(arXiv:2605.07723,预印本,未经同行评议):https://arxiv.org/abs/2605.07723
05 本号 2026-10-15 推文《我让模型写了 460 条参考文献,只有 3 条对得上》——同一个模型、同一类问题,只是把「文献存不存在」换成了「方向有没有人做」