ARTICLE · 1211788
AI开始自己做实验:Google 正在把科学发现交给 Agent
从“会分析”到“会验证”:一次真正发生在湿实验室里的 Agent 闭环
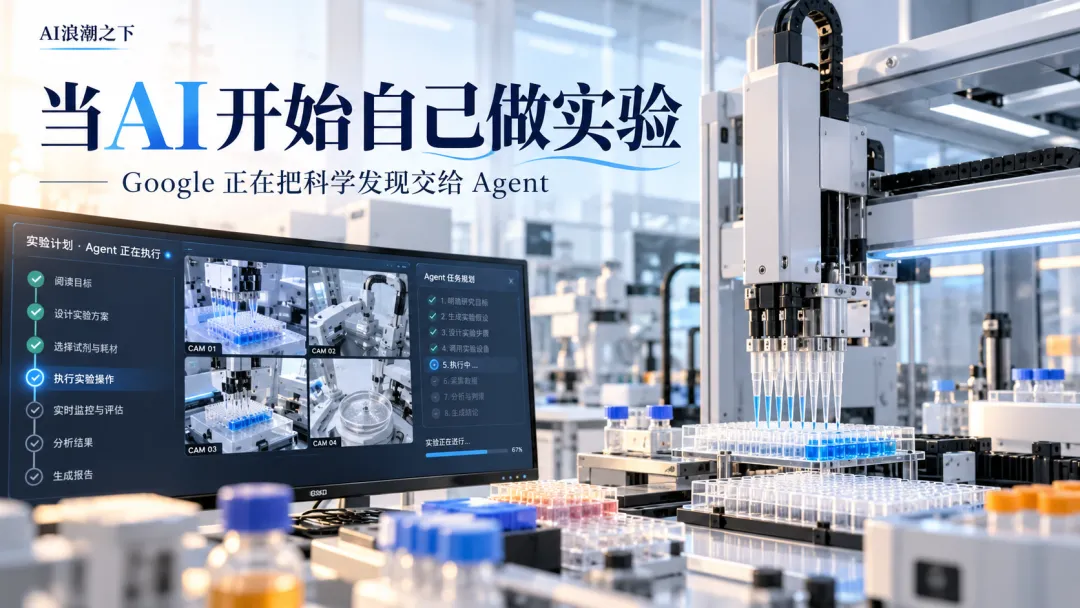
Google 这次展示的重点,不是让 AI 在屏幕上“想办法”,而是让它进入真实实验室,在设计、执行、读数和修正之间形成闭环。
过去两年,人们谈到 AI Agent,更多还是停留在数字世界:写代码、查资料、整理文档、调用工具。Google Research 最新公布的一组工作,向前迈了一步:它试图让 Agent 走进真实的生物实验室。
这件事听起来很像科幻,但真正值得注意的,不是“AI 会不会取代科学家”,而是 Google 正在搭一套更扎实的基础设施:让模型提出方案、由机器人去执行实验,再把真实读数反馈回来,驱动下一轮设计。换句话说,它不是在追求一句口号式的“AI 科学家”,而是在搭一个能验证、能纠错、能留痕的实验闭环。
这也是这次工作的价值所在。比起再做一个会聊天、会写报告的模型,更难也更重要的是:当 AI 的判断必须经受真实世界的检验时,系统应该怎样设计?
一、为什么让 Agent 进入实验室,比让它写代码难得多
在软件工程里,Agent 的结果可以很快验证:代码能不能编译、测试能不能通过、页面能不能跑起来,都有相对明确的反馈机制。生物实验不是这样。这里面对的是巨大得几乎无法穷尽的搜索空间,以及一整套不稳定的物理世界。
Google 在官方文章里举了一个直观的例子:一个只有 100 个氨基酸的蛋白质,理论上的可能序列数就有 20 的 100 次方。模型当然可以在这个空间里“想”出很多候选方案,但真正的瓶颈从来不只是想出来,而是怎么把候选方案变成真实实验,怎么知道结果是否可信,以及当结果不理想时,系统能不能找出原因并调整策略。
这就是湿实验室场景与一般 Agent 场景最大的不同。这里的反馈不是编译器或打分器给出的,而是液体有没有加对、孔板里还有没有足够试剂、机械臂会不会碰撞、实验读数里有多少是真信号、多少是实验噪声。只要其中任何一个环节没有被建模清楚,所谓的“自主实验”就会变成高成本的试错。
二、Google 这次真正搭出来的,是一条“设计—实验—反馈—再设计”的闭环
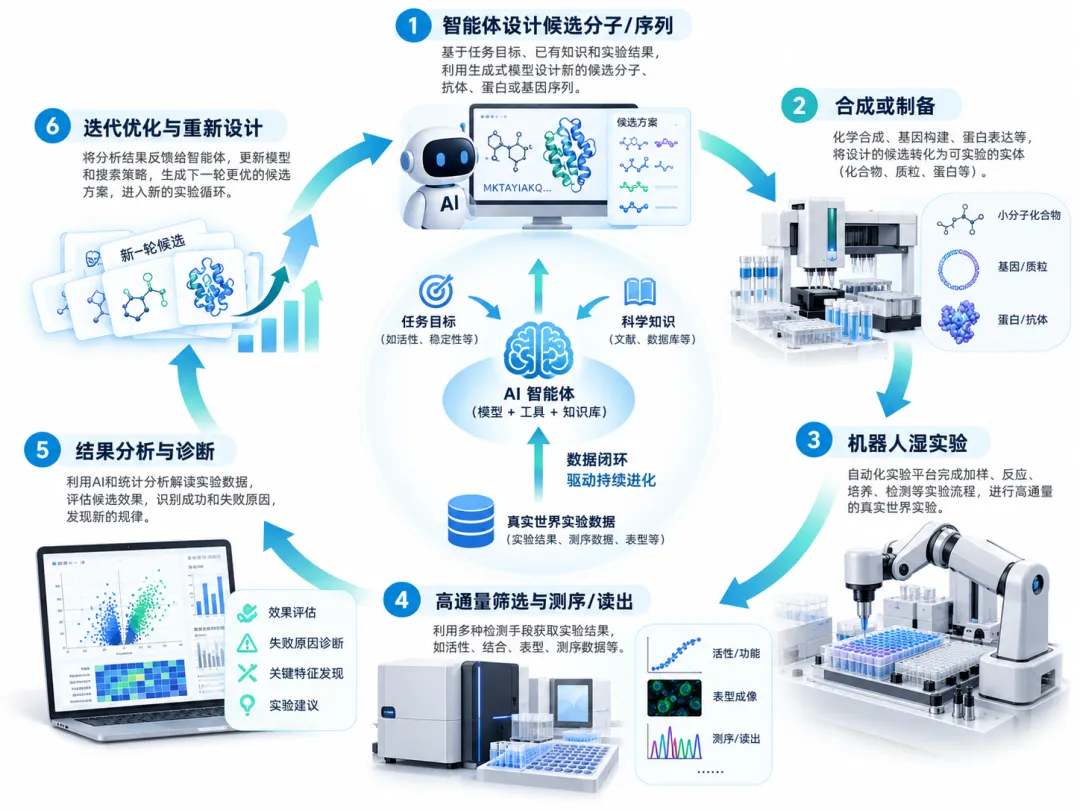
图 1:AI 驱动湿实验发现闭环示意图。文章配图根据 Google Research 公开信息整理重绘。
如果只看标题,这次工作很容易被理解成“Google 让 AI 去做实验了”。但认真看完官方博客和三篇论文,会发现它的核心不是单点突破,而是闭环系统。大体流程可以概括为六步:先由 Agent 根据目标和已有知识生成候选分子或序列,再完成合成或制备,然后交给自动化实验平台执行,接着通过筛选、测序或成像等方式得到真实读数,最后由 Agent 分析结果、识别问题,并把这些反馈带入下一轮设计。
真正的难点,在于这条链路里有两个世界要被连起来:一边是模型的高层推理,另一边是实验设备的底层现实。模型喜欢抽象的目标和策略,实验室只接受非常具体的动作:哪一个容器、多少体积、什么顺序、什么温度、哪些耗材、还剩多少液体。中间任何一层表达不清,最终都会出问题。
因此,这次工作的看点不是“某个模型能力又提升了多少”,而是 Google 把自主实验理解为一套系统工程:上层是 Agent 和知识工具链,中间是可验证、可执行的语义表示,底层才是真正的机器人与实验设备。
三、VERID:把实验室变成一个可推理、可模拟、可回放的数字对象
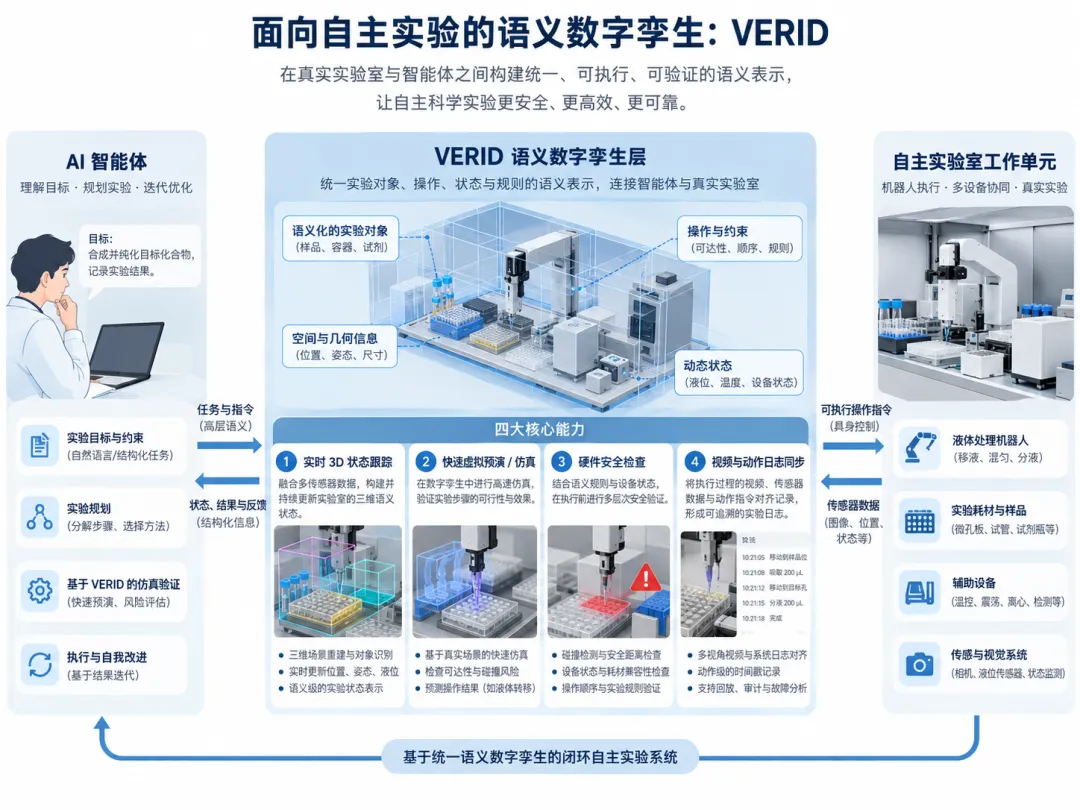
图 2:VERID 语义数字孪生架构。它不是简单做一个实验室 3D 模型,而是要把对象、状态、约束和日志都语义化。
在这几项工作里,最关键的基础设施叫 VERID,全称是 Verified Infrastructure for Discovery Laboratories。直译过来有点长,简单理解就是:它给真实实验室做了一个持续更新的“语义数字孪生”。
这个概念听上去并不新鲜,但 Google 做的不是一个静态 3D 场景,而是把实验对象、空间几何、设备状态、规则约束都统一纳入一个可以查询、可以模拟、可以验证的语义层。官方文章里提到,VERID 会持续跟踪从机械臂几何、孔板液体体积,到试剂身份、吸头库存等状态信息。这样,Agent 在生成操作之前,不只是“写出一段可执行代码”,而是能够先知道这段代码在真实环境里是否可行。
Google 总结了 VERID 的四个核心能力:实时 3D 状态跟踪、快速虚拟预演、硬件安全检查,以及视频与动作日志同步。前两项决定了 Agent 能不能在执行之前发现问题,后两项决定了系统出错以后能不能回头查清楚原因。
这类系统的价值,在论文的案例里体现得很明显。比如,Agent 可以通过同步视频和执行日志,识别因为加样位置过低导致染料分层不均;又比如,当模拟器判断 8 通道移液器根本无法伸进一个过窄的槽体时,系统会直接否决该方案,而不是等到机器人撞上去以后再说。这背后传递出来的其实是一种工程哲学:在高成本、低容错的场景里,AI 不是先执行、再补救,而是先验证、再执行。
四、真正令人兴奋的,不是“做了一次实验”,而是 Agent 开始学会根据实验结果改策略
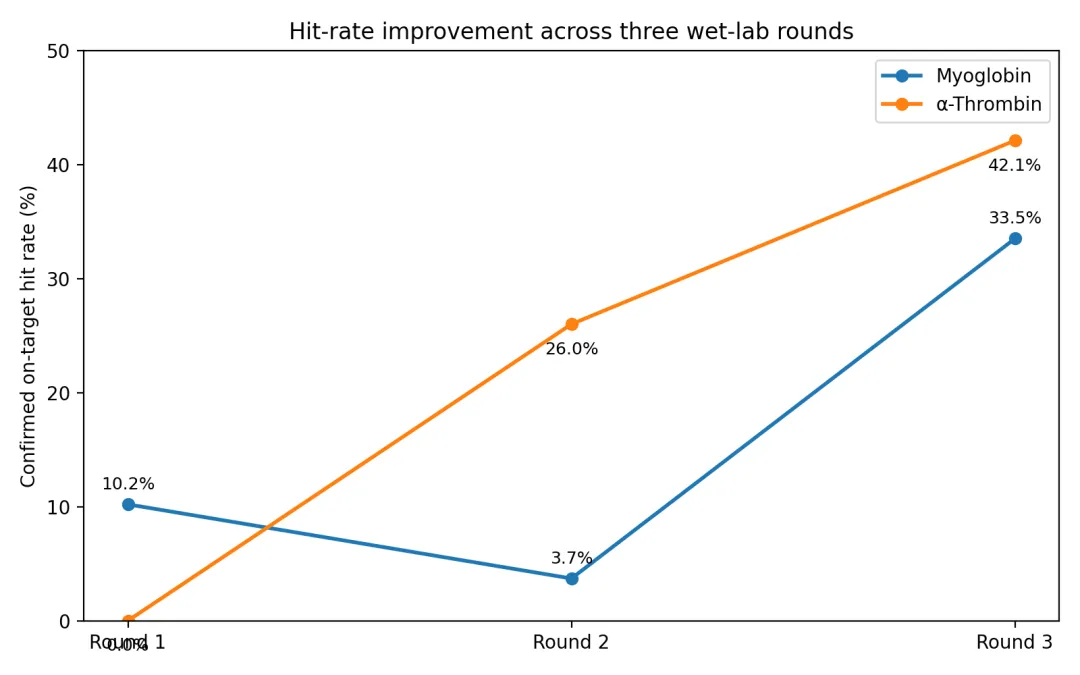
图 3:适配体三轮实验中的命中率变化。数据根据 Google Research 论文公开结果整理。
比 VERID 更能说明问题的,是适配体(aptamer)这组实验。适配体本身是一类与目标蛋白结合的 DNA 分子,验证周期相对短,适合做“实验室里的闭环练习”。Google 用两个目标蛋白做了三轮设计—测试—改进循环,观察 Agent 能否真正从读数中学东西。
结果并不只是“越做越好”这么简单。对 α-thrombin 这个目标,第一轮命中率是 0%,第二轮提升到 26.0%,第三轮进一步提升到 42.1%。但更有意思的是 myoglobin 这组。它在第一轮有 10.2% 的命中率,第二轮反而掉到 3.7%,第三轮才回升到 33.5%。
这组数据的意义,恰恰在于第二轮的失败。论文里解释得很具体:Agent 在第二轮过于追求表面上的高结合能力,结果大量富集了 G-quadruplex 结构。这些候选在实验上看起来“很会粘”,但很多其实是非特异性粘附,不是对目标蛋白真正有效的结合。换句话说,Agent 一度学会了一个“讨巧但错误”的策略。
如果系统只是一次性设计、一次性验证,这里就结束了。但在第三轮里,Agent 根据第二轮的实验反馈修正了规则:限制这类容易“乱粘”的结构,扣除对磁珠本身的粘附信号,转向新的结构骨架。结果,特异性又恢复了,命中率也显著提升。
这也是整件事最值得关注的地方。AI 在实验场景里的价值,不只是第一次能提出多少候选,而是它能不能从真实世界的反例里学会纠偏。真正的科研工作,本来就不是一路命中,而是不断碰壁、定位问题、再调整方向。Agent 只有在这个过程中表现出可解释的修正能力,才算真正跨过了“会生成”和“会发现”之间的那道坎。
五、从“算得动”到“做得出”:蛋白结合设计更像是一场关于算力与实验成本的硬仗
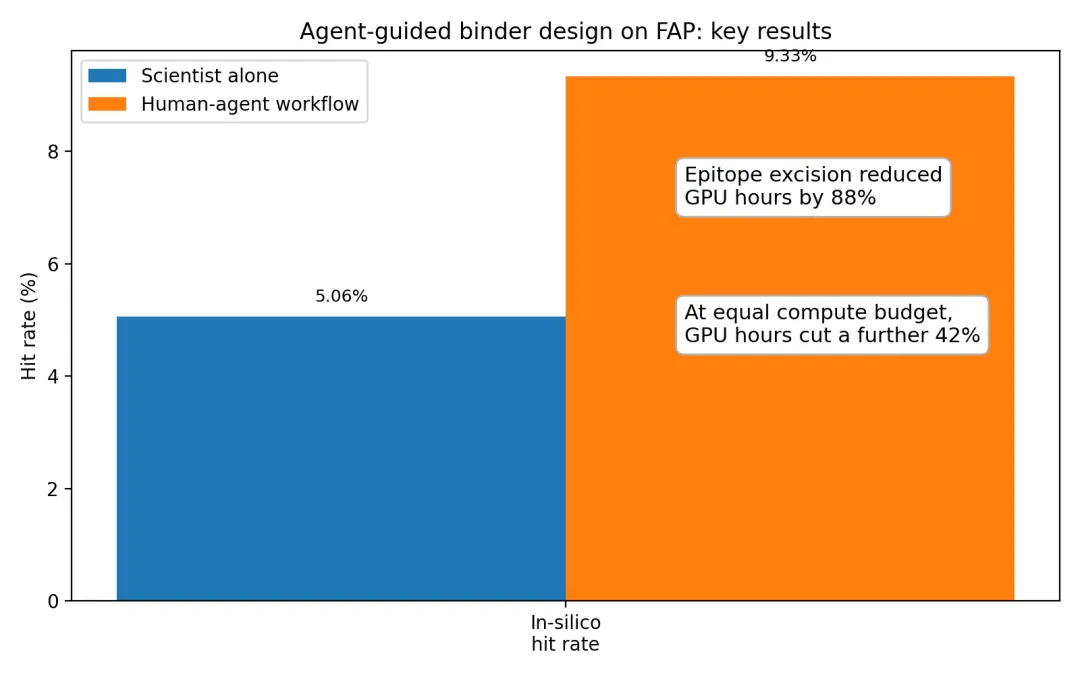
图 4:FAP 蛋白结合设计中的关键结果。数据根据 Google Research 论文公开结果整理。
适配体实验更多是在验证闭环机制能不能跑通;到了蛋白结合设计,Google 面对的是另一个更现实的问题:算力够不够、成本扛不扛得住。
在题为《Agent-guided epitope excision enables economical de novo binder design》的论文里,Google 选择了 FAP(fibroblast activation protein alpha)这个与实体瘤相关的大型靶标蛋白。难点在于:为每个候选分子做结构预测和复折叠,本身就非常耗算力,而目标蛋白越大,代价越高。
他们的办法是“epitope excision”,也就是不让模型每次都盯着整个大蛋白,而是把注意力切到局部结合位点附近的关键结构窗口。论文数据显示,这个做法在 15 个靶标、3666 个设计样本上的中位结构偏差仍可接受,同时把相关 GPU 小时数降低了 88%。在相同计算预算下,引入 Agent 参与的 human-in-the-loop 流程,又把计算命中率从 5.06% 提升到 9.33%,并进一步减少了 42% 的 GPU 开销。
这里同样有一个重要信号:不是 AI 单独赢了,而是“人给方向,Agent 做战术优化”的混合模式更有效。论文自己也没有把这件事包装成“AI 独立完成药物发现”,而是强调在人类设定高层策略的前提下,Agent 更擅长去尝试更多局部决策、更大范围地搜索可能的结合位点。
这其实更符合现实。越是靠近科学发现和药物研发的核心流程,越不可能靠一个模型独立搞定全部环节。真正有价值的,是如何把人的判断力、模型的搜索能力,以及实验系统的执行能力拼在一起。
六、别把它理解成“AI 科学家已经来了”,它首先是一个被严格约束的实验系统
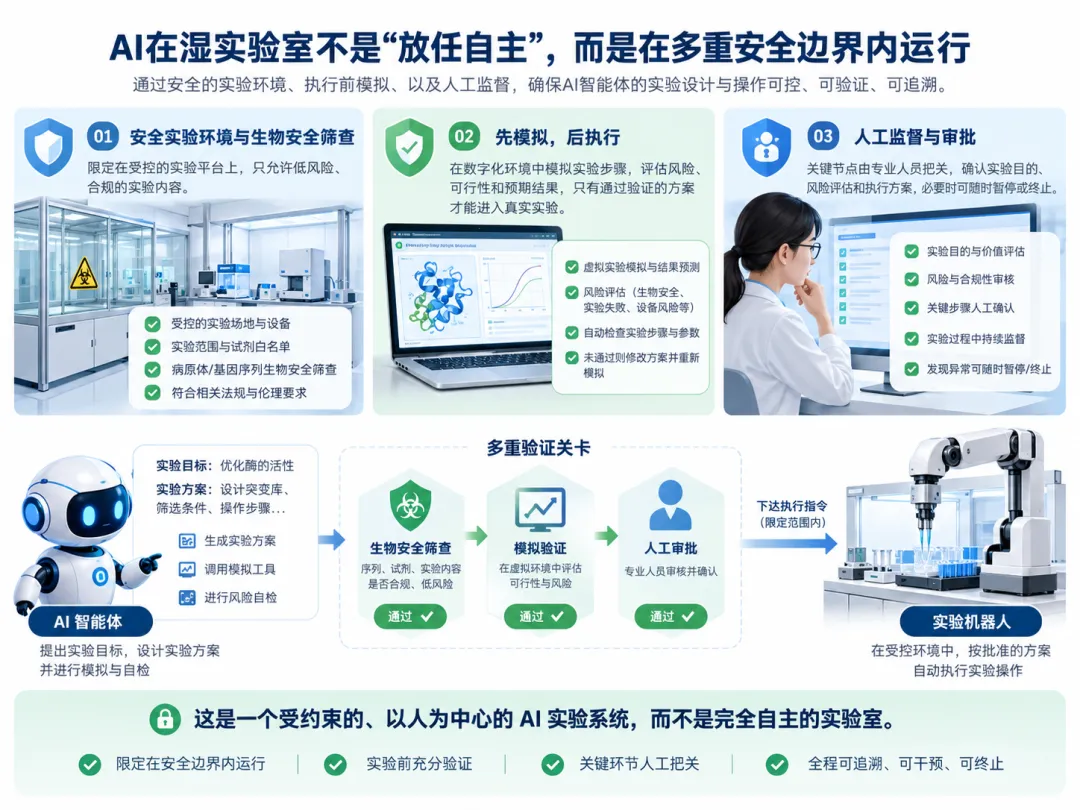
图 5:Google 公开表述中的安全边界。核心原则不是“完全自主”,而是“受控环境 + 先模拟后执行 + 人工监督”。
每次一提到“AI 做实验”,大家最担心的往往不是命中率,而是安全问题。这一点 Google 在官方文章里说得相当谨慎。其安全边界大致有三层。
第一层是实验范围本身。Google 这次选用的是可控、非感染性的生物系统,并且强调所有设计序列都经过生物安全筛查,不涉及 gain-of-function 风险。第二层是执行前验证:Agent 不能把未经验证的代码直接下发给实验机器人,每个协议都要先在 VERID 的模拟环境里预演,确认没有明显的物理和规则错误。第三层是人类监督:无论是设计出的序列、湿实验协议,还是机器人执行过程,都有人工审批和复核。
这意味着,所谓“自主湿实验室”离“完全放任自主”还很远。它更像一个受约束的、以人为中心的 AI 实验系统。这个判断非常重要,因为它决定了我们该如何评价今天的进展:这不是已经出现了一个可以自己发明新药的 AI,而是出现了一套开始具备真实世界闭环能力的实验基础设施。
七、这件事真正改变了什么?
如果把视线拉远一点,这组工作最重要的意义,也许不在生物学本身,而在于它给 AI Agent 的下一阶段发展提供了一个样板:AI 不再只在虚拟世界里迭代,而是开始接入真实世界反馈。
过去几年,很多 Agent 成功的场景都来自“验证器足够清晰”的领域:下棋有规则,写代码有编译器,做数学有答案,搜索网页可以回读结果。科学实验的难点在于,验证器不是现成的软件程序,而是昂贵、缓慢、充满噪声的现实世界。谁能把这层现实世界的反馈机制打通,谁就可能真正把 Agent 从“会生成”带到“会改进”。
对更广泛的 AI 产业来说,这也是一个信号:未来决定 Agent 上限的,不只是模型本身,而是模型外部的系统工程——工具链、状态表示、执行基础设施、日志与可观测性、安全约束,以及最关键的反馈闭环。没有这些,所谓的“自主”往往只是演示;有了这些,模型哪怕并不完美,也可能逐步长出真正可用的能力。
结语
Google 这次并没有证明“AI 已经成为科学家”。但它确实证明了一件更现实、也更有分量的事情:如果把数字孪生、实验自动化、真实读数和 Agent 推理组织成闭环,AI 可以开始在真实实验中形成“设计—验证—修正”的能力。
这比任何一句“AI 将颠覆科研”的口号都更值得重视。因为真正推动科学发现的,从来不是一次漂亮的演示,而是一套能够反复运行、不断纠错、逐步积累的系统。Google 正在尝试搭的,正是这样一套系统。
参考资料
1. Google Research Blog, “Grounding AI agents in biological reality: Building blocks for autonomous wet labs”, 2026-10-16。
2. Semantic Representation for Agentic Self-Play in Automated Laboratories (VERID paper), Google Research, 2026-10-16。
3. Aptamers as a sandbox for lab-in-the-loop agentic molecular discovery, Google Research, 2026-10-12。
4. Agent-guided epitope excision enables economical de novo binder design, Google Research, 2026-10-14。
5. 文中所有结构图和封面图为基于公开资料重新绘制的示意图;命中率、GPU 小时下降、计算命中率提升等数据均整理自上述原始资料。