ARTICLE · 1220573
AI 员工上岗 30 天,怎么判断它值不值:一份复盘清单
很多企业请的第一个 AI 员工,都是从一条嫌烦的活开始的:客户询盘进来,得有人判断是不是真需求、分给谁跟、三天没回再催一遍。这活不难,但耗人,而且总在有人请假的那几天断掉。
上线那几天通常很热闹。演示的时候,它三分钟读完一封长邮件,把联系人、预算、时间点理成表格,会议室里有人鼓掌。到第四周,鼓掌的人不再提这件事——它要么在默默干活,要么已经没人打开它的界面了。两种结局一样安静,价值却相反。
差别出在判断标准上。演示看的是峰值能力,经营看的是稳定产出,这中间隔着三十天。
第一周的热闹,和第四周的安静
演示之所以好看,是因为输入被挑过。真实的活不这么进来:格式不统一、信息缺一半、邮件没主题,客户在电话里说的和邮件里写的不是一件事。系统扛不扛得住这些,演示里看不出来。
Gartner 在 2025 年 6 月 25 日的一份预测中提到,到 2027 年底,超过 约40% 的 agentic AI 项目会被取消,原因是成本上升、业务价值不清、风险控制不足。三条原因里,"业务价值不清"容易被放过,因为它不是技术问题,而是立项那天就没有定义过什么叫"值"。
所以复盘要做的事,不是问它聪不聪明,而是换一组问题来问。
清单第一条:任务回流率
定义很简单:它交出去的东西,有多大比例被人退回重做,或者必须有人一直盯着才敢用。
这条专治幻觉。一个 AI 员工每天处理五十条询盘,其中三十条到头来还要人工重写,那企业得到的不是"省了一个人",而是"一个人,外加一个需要被检查的系统"。流程表面跑起来了,成本却是叠加的。
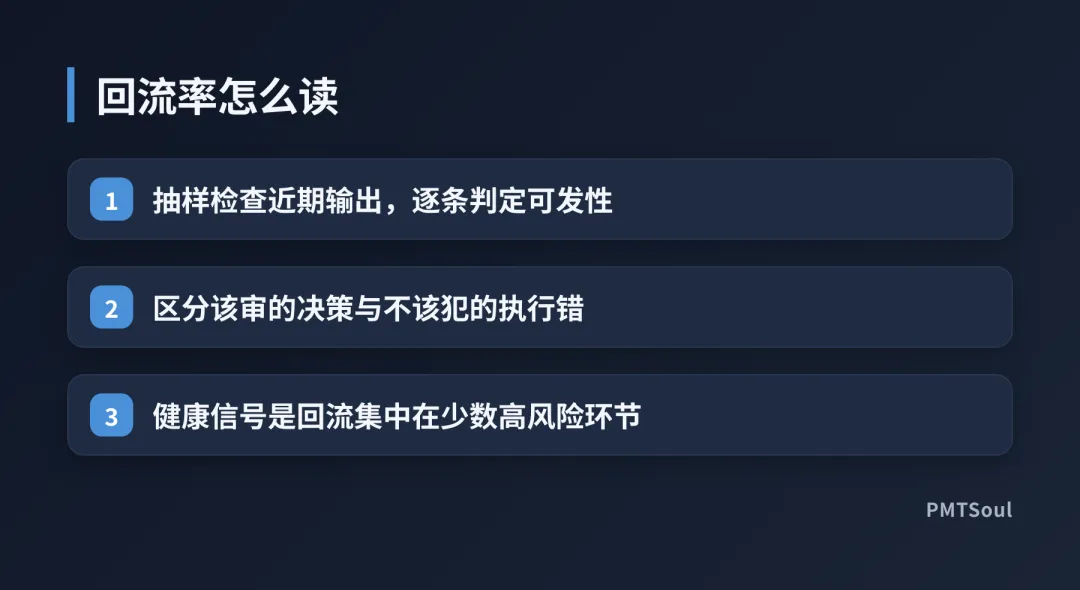
怎么看:抽二十到三十条输出,逐条判三件事——能不能直接对外发、需要小改还是要重写、退回的原因归哪一类。这里要分两种回流。一种是人本来就该审的决策,比如报价、账期、承诺交期;另一种是本不该发生的执行错误,比如字段填错、跟进漏掉、语气不对。前者是设计,后者是缺陷。两种混在一起统计,就永远看不清它到底行不行。
健康的样子是:回流集中在少数几类能明确界定的高风险动作上,而不是散落在所有环节。
清单第二条:无人值守的时段有多长
真正的分界线,不是它能不能干,而是没人在旁边的时候它还能不能干。
有的系统全程要人点确认,人一离开流程就停;有的系统能在下班后自己跑完一轮,第二天早上把结果放在那儿。这两种在演示里几乎没区别,在经营里是两回事——企业缺的往往不是"能干活的时刻",而是"没人盯着的那十几个小时"。
做法很土但有效:把它一周内完成任务的时间戳拉出来,看有多少落在晚上、周末和节假日。如果全都在工作时间内、紧跟在人的操作之后,说明它还是人的延长线,算不上独立产能。
这里有个取舍要说清:无人值守时段越长,风险敞口越大。所以这条得和第三条一起看,不能单独追高。
清单第三条:错一次有多贵,多久能发现
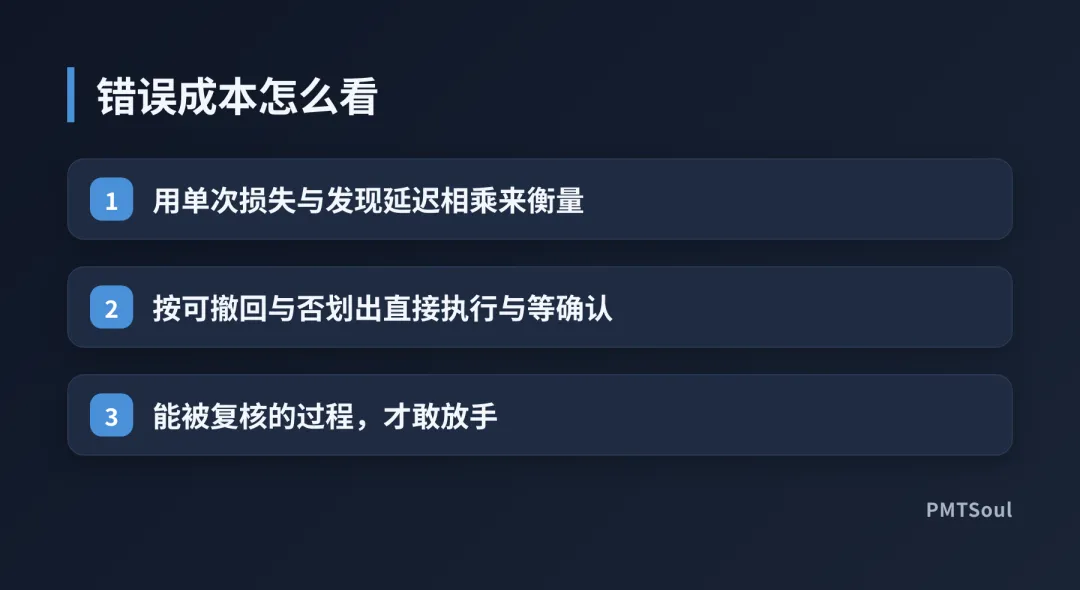
评估 AI 员工,错误成本比准确率有用。错误成本大致等于单次损失乘以发现延迟。写错一句客套话,损失接近零;发错一个价格,损失可能是一整单;把不该承诺的交付期承诺出去,损失是往后几个月的扯皮。
所以关键不在让它"不出错",而在把错误关进可控的区间:
哪些动作可以直接对外执行,出错也撤得回; 哪些动作必须停下来等人确认,因为撤不回; 出错之后多久能被发现,能不能追溯到是哪一步、依据什么做的。
第三点常被低估。过程能被复核,出错也敢放手;过程无法复核,准确率再高也只能当参考。这是系统工程的问题,换个更强的模型解决不了。企业的规则、审批口径、例外处理,得写进系统里,而不是留在某个人的经验里——写在人脑里的规则只能执行一次,写进系统的规则才能执行一千次,而且每次都一样。
清单第四条:知识有没有留在系统里
三十天过去,如果它的能力全靠一个人每天喂上下文、随时纠正,那这三十天没沉淀下任何资产。那个人休假,能力下线;那个人离职,能力清零。
判断方法:规则、话术、判断口径、例外处理,有没有被写成系统里的东西;新人接手时,要不要重新解释一遍背景;同一类问题第二次出现,它是不是还要人再教一遍。
这也是"可被 AI 执行的通用系统"和"某个场景的脚本"之间的分水岭。脚本解决一个任务,通用系统承接一类任务:规则写在系统里,AI 只是执行者,换模型、换员工,系统还在。PMTSoul 做的事就是这一件——把企业的经营规则变成这种可执行的形态,不是给每个场景单独写一套,而是让同一套系统接住接下来出现的新活。这件事在三十天里就看得出:第四周加进来的新任务,是配置一下就能跑,还是又要重新开一个项目。
清单第五条:加一个新任务要多久
这条容易被忽略,却挺能预测未来。第一个任务通常好做,它是被仔细挑过的,也天然配合演示。
Gartner 在 2025 年 10 月 29 日公布的一项调查中提到,约45% 的市场技术负责人认为,现有厂商提供的 AI agent 没能达到此前承诺的业务表现。该调查覆盖 413 位市场技术负责人,执行时间为 2025 年 6 月至 8 月。原因很多,其中一类很典型:为单个场景定制的 agent,场景一变就要重做,于是每增加一件事就多一次投入,价值始终算不平。
所以复盘时要问一句:这三十天里新增的任务,从提出到上线用了多久,中间要多少人参与。如果答案是"每次都要重新开发",那企业买的不是系统,是一串项目。
把它算成一个数:无人负责任务的覆盖率
不建议在三十天这个节点上算投资回报。变量太多,算出来也不可信,还容易演变成一场关于假设的争论——谁的假设乐观,结论就乐观。
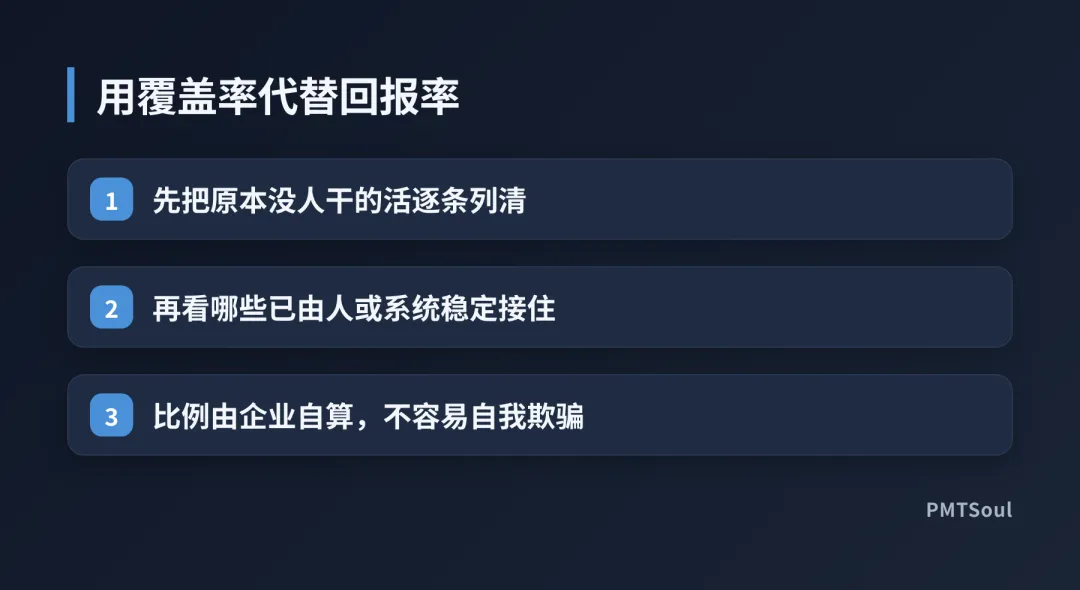
建议算另一个数:覆盖率。三十天前,把那些"没人干、拖着干、临时抓人干"的任务一条条写下来;三十天后,标出其中哪些已经有了稳定的出口——不是偶尔做完,而是固定有人(或系统)接住。这个比例不需要供应商提供数据,企业自己就能算,而且很难自我欺骗。
它还顺带解释了一个常见困惑:为什么有些 AI 项目演示一般,用起来却很值。因为它接住的本来就是没人愿干的活,只要稳定,就是从零到一;反过来,演示惊艳却只承接了本来就有人干得不错的活,那再多亮点也只是漂亮的重复。
第 约31 天该做的三件事
一,把上面五条落成一张表:任务、回流率、无人值守时段、错误成本、知识留痕、新增任务耗时。每条只填事实,不填评价。评价留到填完再看。
二,给每个 AI 员工写一个退出条件:什么情况下停掉它、降级它、换掉它。有退出条件的系统才敢放手用;没有退出条件的系统,早晚会变成没人敢动的黑箱。
三,定一个第 约60 天的复算日。三十天只能看出方向,六十天才能看出趋势,九十天才谈得上调整分工。
判断一个 AI 员工值不值,不是看它演示时多像人,而是看这三十天里,有多少原本没人干的活,现在有了一个稳定的、可复核的、不依赖某个具体的人的出口。这个答案不需要复杂的模型,纸和笔就能算出来。