ARTICLE · 1225821
扎克伯格酒后首曝AI天价账单:建座机房砸600亿!CFO警告:搞砸就全完了
作者 | 张宁· 编辑 | 彭毅
2025年底,夏威夷
海风吹拂着Meta高管闭门会的度假酒店,空气里却弥漫着一股令人窒息的焦灼。公司首席财务官(CFO)Susan Li一次又一次把年轻的首席AI官Alexandr Wang拉到僻静的角落,盯着他的眼睛,反复念叨着同一句警告:
“如果这件事成了,一切都好;但如果搞砸了,那就会真的、真的、真的很糟。”
就在那几天,马克·扎克伯格正准备在一张金额高达1000亿到2000亿美元的支票上签字。最令人心悸的是,当时倾注全公司资源研发的新一代大模型,连个影子都还没见到。签字前,扎克伯格转过头,神情格外凝重地问Wang:“Alex,你确定这能成吗?”
训练一款顶尖的AI大模型,到底要烧掉多少钱?在过去,这是硅谷各大实验室守口如瓶的最高机密。但就在2026年10月中旬,一张端上桌面的啤酒杯,彻底捅破了这层窗户纸。
01.第一级阶梯:从全网疯传的“四笔账”到小酒馆原声带
故事的导火索,是2026年10月中旬在X平台上疯传的一条长帖。
博主Ryker Stone将训练前沿大模型的开销拆成了四笔触目惊心的账单:运行一座算力集群一年要150亿美元;把这座集群建起来要先掏500亿到600亿美元;研发试错还要再烧掉同等规模的算力;最后还有深不见底的推理服务费
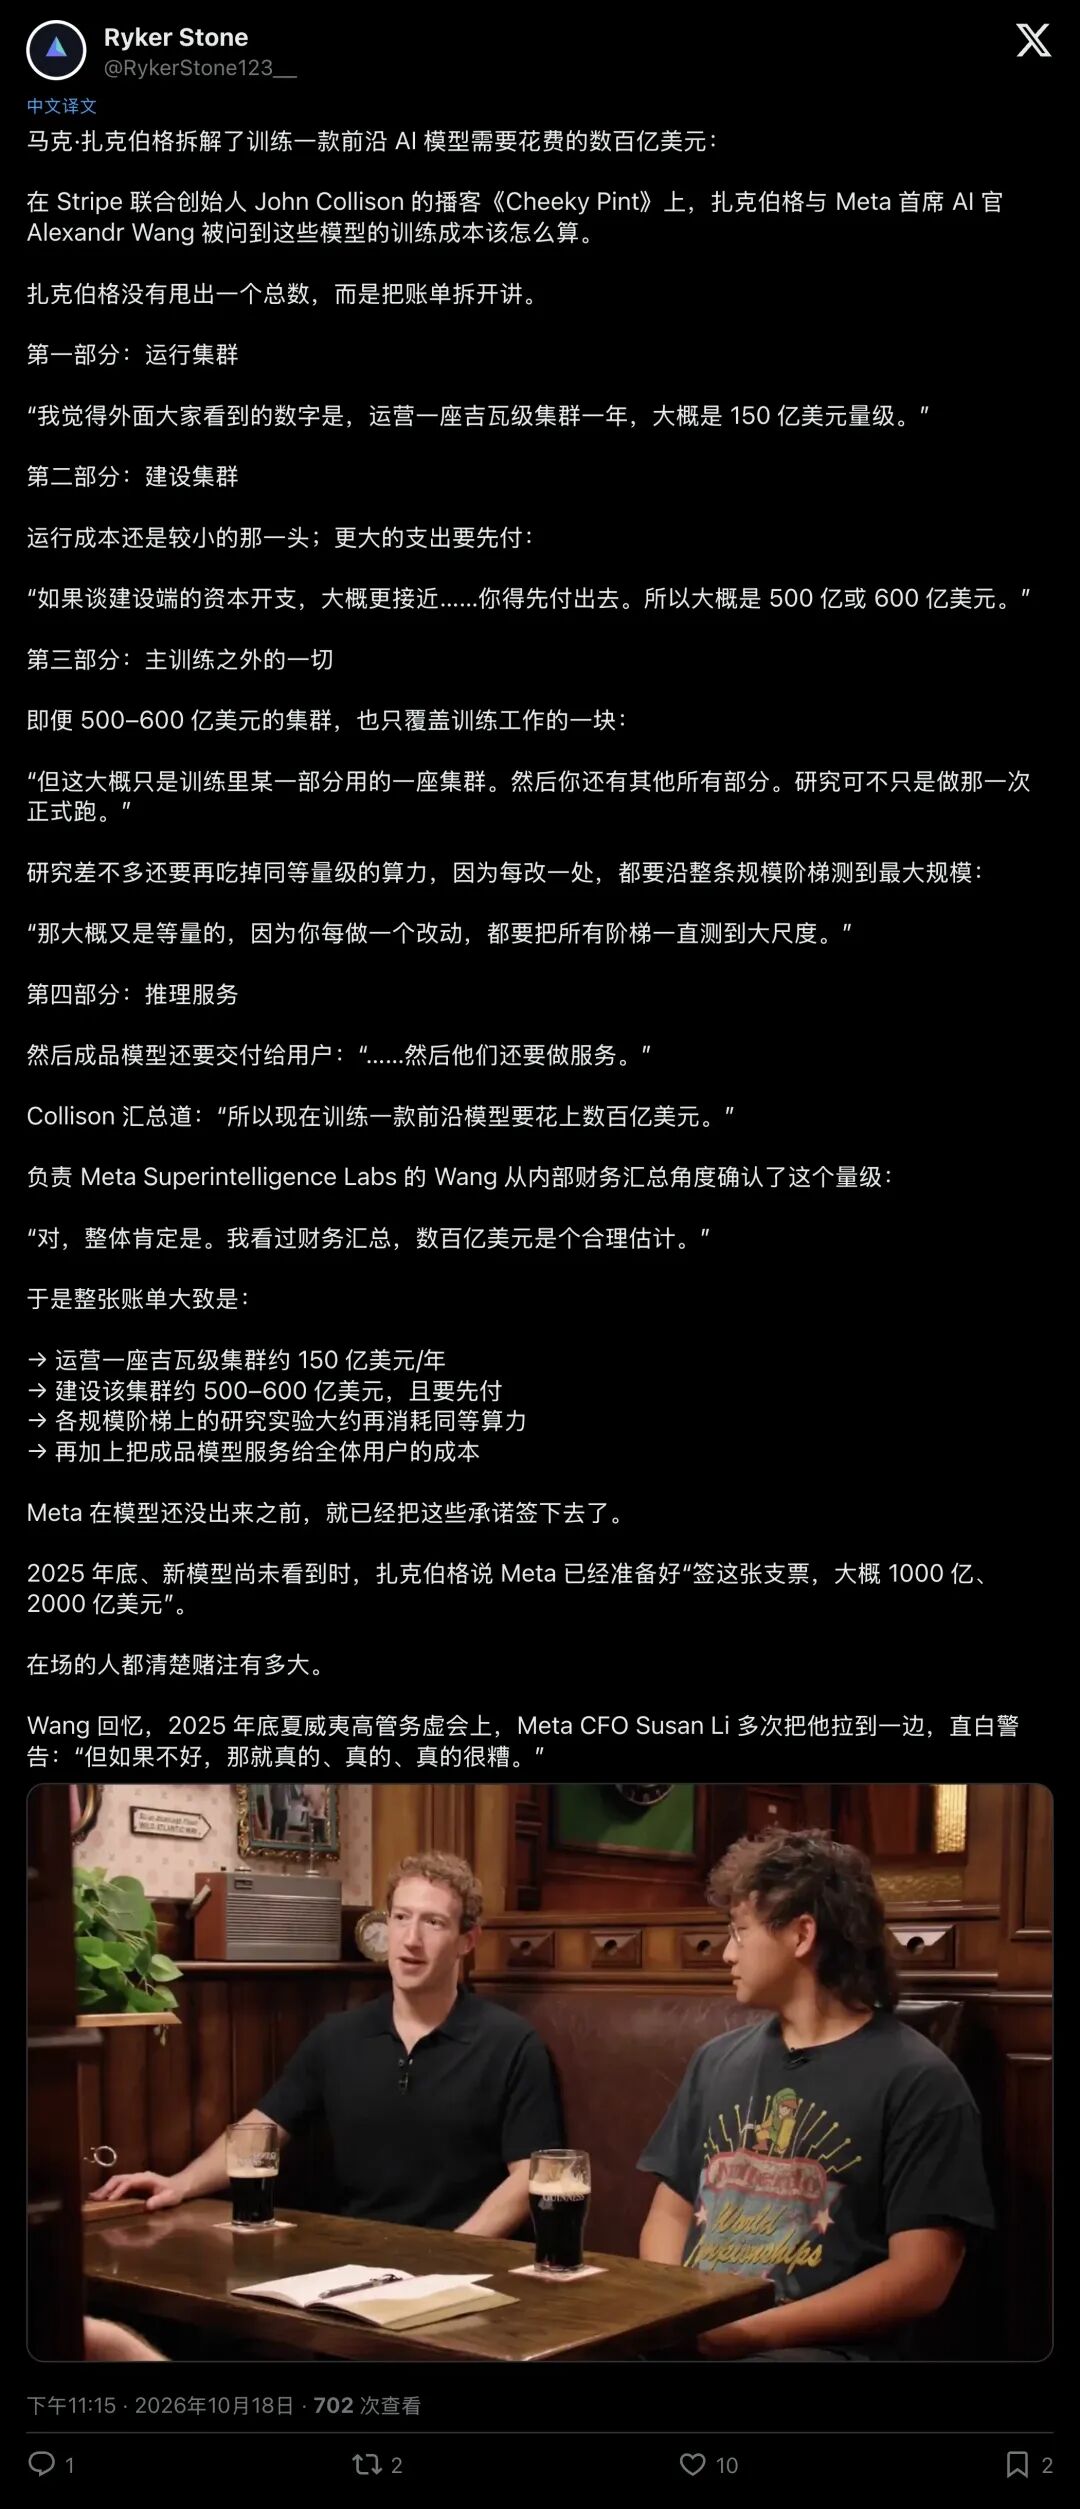
▲ 社交网络上疯传的“大模型四笔账”二次整理帖
网上的切片视频往往喜欢添油加醋要看清真相,我们必须顺着证据阶梯往上爬,回到真正的一手案发现场。
那是一间灯光昏暗的酒馆支付巨头Stripe的联合创始人John Collison坐在桌前,主持着他的播客节目《Cheeky Pint》。坐在他对面端着酒杯的,正是扎克伯格,以及执掌Meta超级智能实验室(MSL)、带队研发出前沿模型Muse Wonder的Alexandr Wang。
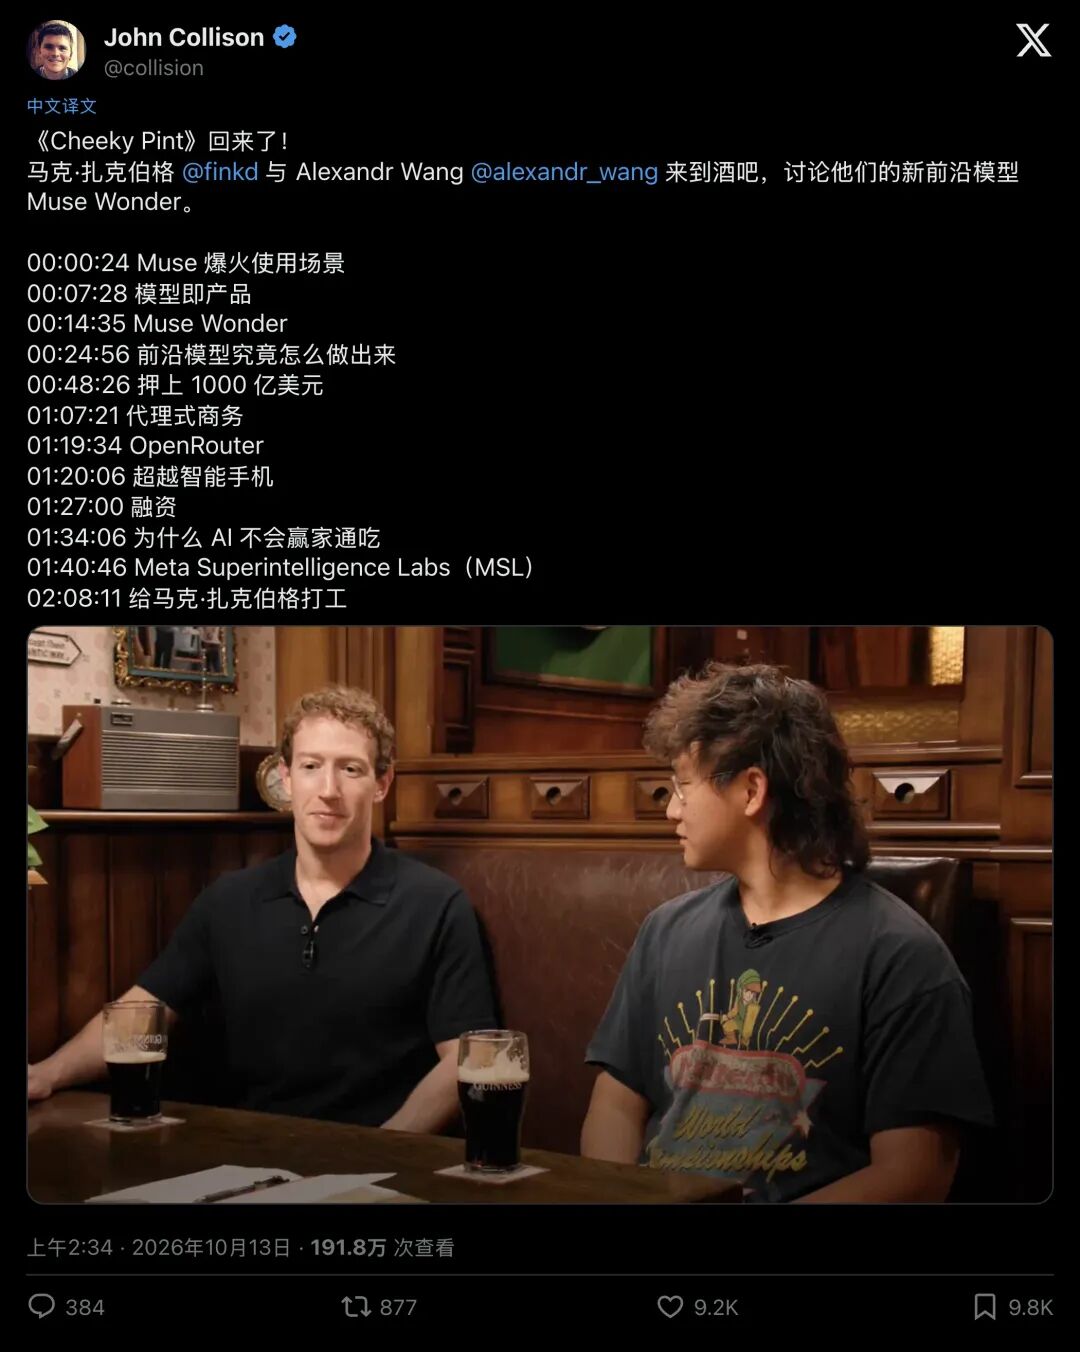
▲ 传播链的官方源头:John Collison发布的播客单集与完整时间轴
翻开节目组同步公开的两小时十四分钟完整英文逐字稿,一手原声披露的具体账单与细节,远比网上的二手摘要更加惊人。
当时,主持人Collison随口追问了一句训练成本的数量级。他原本以为会听到“十几亿美元”之类的数字。没想到,扎克伯格根本没有报总数,而是像个包工头一样,当场用手指敲着桌子,把账本掰成了四块。
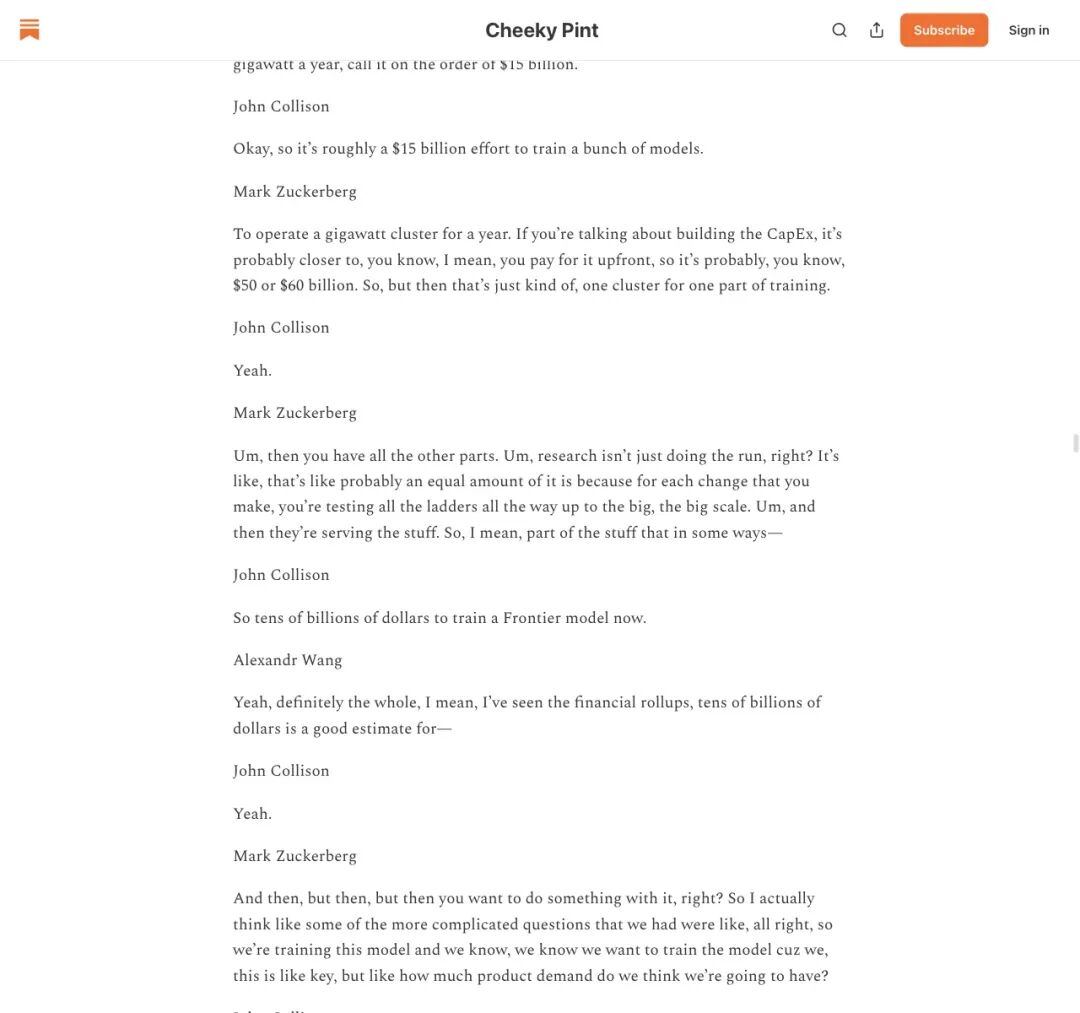
▲ 播客官方逐字稿截图:还原夏威夷警告与“数百亿美元”账单的一手对话
02.第二级阶梯:600亿买“炉子”,150亿交“年费”
扎克伯格算的第一笔账,叫“建与跑”
他对Collison说,现在外面的行情,运营一座“一吉瓦(1GW)”级别的算力集群,一年大概是150亿美元。Collison起初听岔了,以为训练一批模型要150亿。扎克伯格立刻纠正了他:不,150亿只是让这座机器运转一年的开销;如果你想把这座集群建起来,前期资本开支(CapEx)必须先把钱砸出去,大概是500亿到600亿美元。
什么是“一吉瓦”?
给不常看电力账单的读者翻译一下:一吉瓦等于10亿瓦。这差不多是一整座大型核电站或特大型火电厂的满负荷发电功率,足够同时点亮近百万个普通家庭。而在AI巨头眼里,这只是一座计算机房的胃口。
播客逐字稿进一步披露了Meta早在2023至2024年就埋下的基建布局:位于俄亥俄州的Prometheus(普罗米修斯)集群正在冲刺超过1吉瓦的规模;而位于路易斯安那州的Hyperion(许珀里翁)集群,终极目标竟然是5吉瓦,相当于把五座核电站的电力,全灌进一个数据中心里炼大模型。
这里引发了华尔街和硅谷极客的一场激烈争论:一年光交电费和运维,怎么可能花掉150亿美元?
数学家Eric Naslund在评论区一针见血地戳破了会计盲区:千万别把这150亿当成单纯的水电物业费,这里面真正的大头是“折旧”。
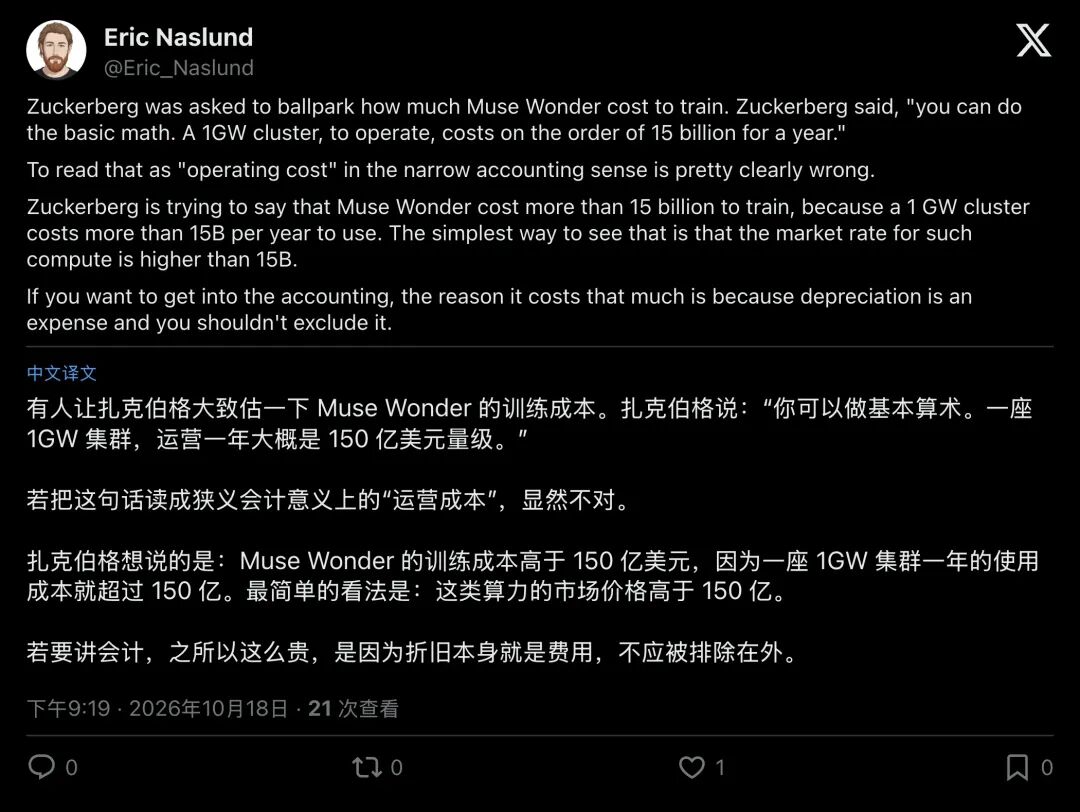
▲ 数学家Eric Naslund指出:150亿美元年化成本中包含了巨额硬件折旧
花600亿美元买回来的顶级AI芯片,生命周期极短。两三年后新一代芯片一出,老芯片就像过气的智能手机一样迅速贬值。把几百亿的硬件折旧摊到每一年,再加上吞金兽般的电费和运维,“使用一座1GW集群一年的综合真实成本,起步就是150亿美元”。
但这只是噩梦的一半扎克伯格紧接着抛出了第三块账本:“试”。
外行总以为,训练大模型就像发射火箭,把数据塞进那座600亿的机房里,按下点火键跑完一次就结束了。扎克伯格在酒桌上苦笑着摇了摇头:“那只是一座集群、负责训练中的一部分。研究绝不只是把最后那次运行跑对”
在真实的实验室里,科学家每修改一行架构代码、每调整一次数据配比,都不敢直接在最大规模上贸然硬试。他们必须像爬梯子一样,先在迷你模型上试,再去中型模型上验,一步步沿着“规模阶梯(Scaling Ladders)”往上测,直到确认无误才敢上主集群。扎克伯格直言,这部分试错实验吃掉的算力,和主训练集群几乎是1:1等量的。
也就是说,为了烤出一个完美的十层婚礼蛋糕,你得在后厨先用掉同样多的面粉和鸡蛋,去烤成千上万个试验品。
听到这里,主持人Collison倒吸一口凉气,替他算出了那个结论:“所以现在训练一款前沿模型,要花掉数百亿美元。”
坐在旁边的Alexandr Wang平静地点了点头,给出了来自内部财务总账的官方认证:“没错,我看过财务汇总表(financial roll ups),数百亿美元是个很合理的估计。” 事后Wang还在X上自嘲,节目里那段盘问,简直像扎克伯格在镜头前给他做了一场现场年度绩效考核。
03.第三级阶梯:为什么论文里说花10亿,扎克伯格却说几百亿?
顺着证据阶梯再往上走,一个尖锐的矛盾浮现了。
如果我们翻开知名独立研究机构Epoch AI发表在arXiv上的权威论文《训练前沿AI模型的成本攀升》,会看到另一套数字:自2016年以来,顶尖模型的训练成本以每年2.4倍的速度狂飙;即便如此,论文估算像GPT-4或Gemini这类大模型,单次最终训练的硬件与能源摊销成本也只是数千万到数亿美元,预计到2027年最大规模训练才会突破10亿美元大关。
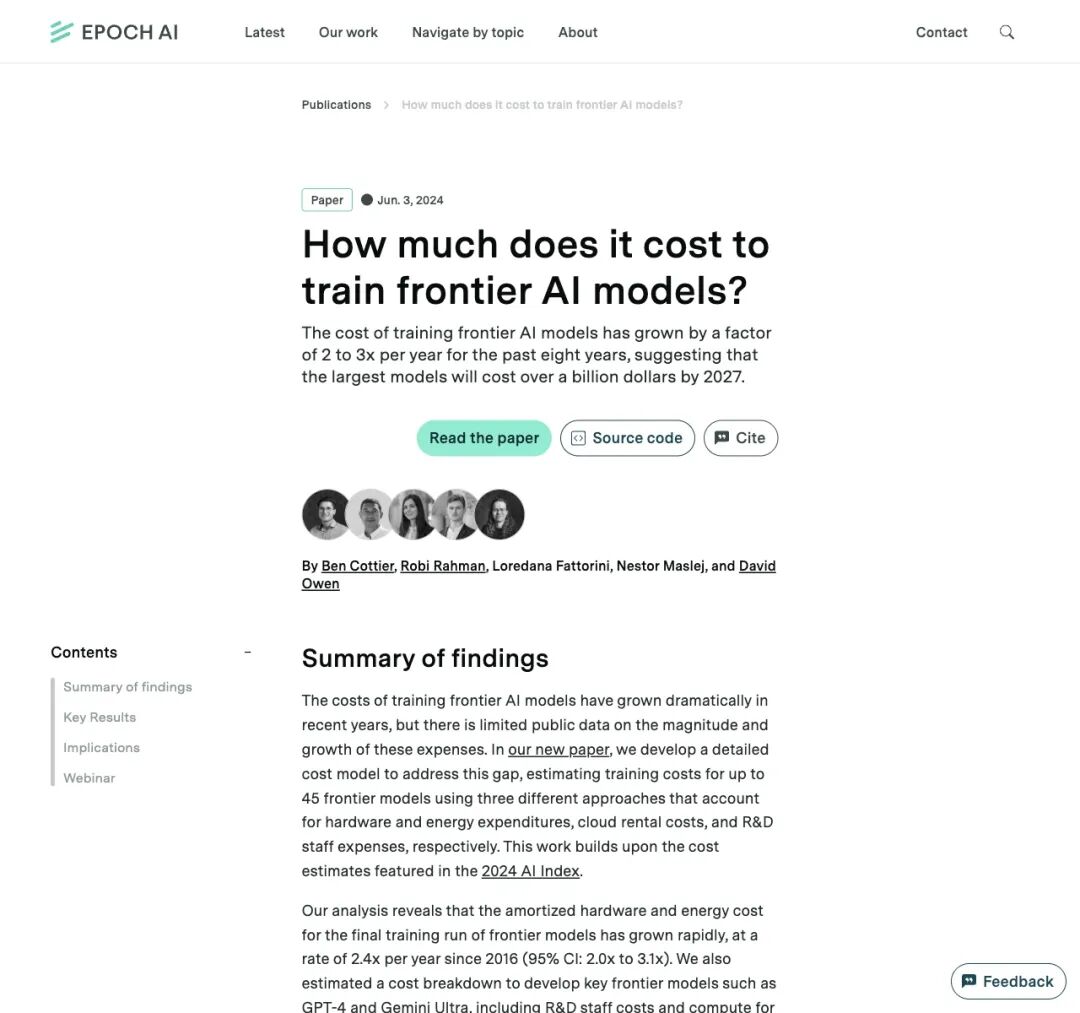
▲ Epoch AI研究显示:前沿模型最终训练跑的摊销成本正以每年2.4倍的速度飙升
一边是学术界算的“10亿美元”,一边是扎克伯格亲口认领的“数百亿美元”。到底谁在说谎?
答案是:谁都没说谎,但他们看的是完全不同维度的账单。
Epoch AI的学者们手里拿的是“秒表”。他们计算的是最后那一次成功交卷的正式训练跑(Final Training Run)租用显卡了多少个小时、烧了多少度电。
而扎克伯格手里拿的是整家公司的资产负债表。他必须为还没有诞生的模型,提前三四年买地、建变电站、抢购数十万张显卡。正如行业媒体《AI Frontier Post》在拆解“1000亿美元算力去哪儿了”时所揭示的:在一个千亿美元级的AI大基建包里,约450亿到500亿变成了芯片,200亿到250亿变成了钢筋水泥与冷却机房,50亿到80亿付了全生命周期电费,还有100亿到150亿用来发顶尖研究员的天价薪酬。
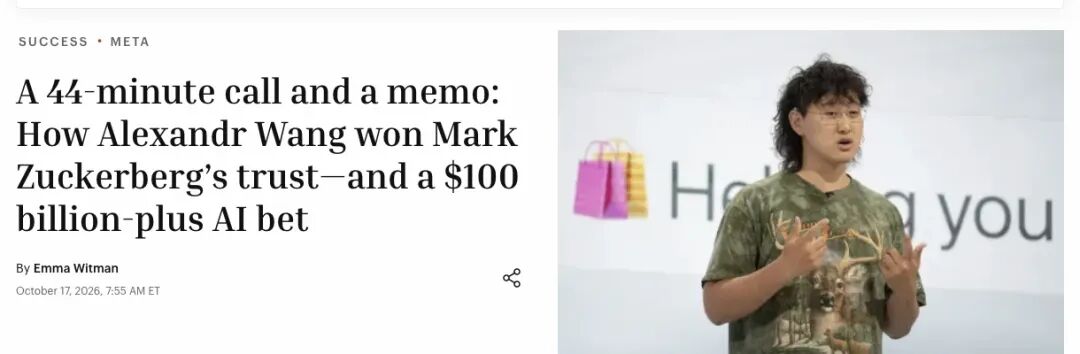
▲ 《财富》杂志报道:Alexandr Wang赢得扎克伯格信任与千亿美元级AI项目投入
财报数据是最好的测谎仪《财富》与彭博社的报道交叉印证了酒桌上的豪言:Meta对2026年全年的资本开支预期高达1300亿至1450亿美元,几乎是前一年722亿美元支出的整整两倍!
学术界算的是“煮熟一锅饭要多少电”,而扎克伯格付的是“买下整片农场、建起粮仓、外加厨师团队三年试菜”的总工程款。
04.第四级阶梯:真正的无底洞,藏在模型上线之后
你以为花掉几百亿美元把Muse Wonder训练出来,就能躺着数钱了吗?
在播客里,扎克伯格轻轻带过了第四块账本:“……然后,还得把这些东西服务出去(Serving)。” 就是这短短半句话,藏着让所有AI巨头夜不能寐的终极财务黑洞。
在逐字稿中,扎克伯格道出了一个极其残酷的“基建时间差悖论”:开发一款AI应用,从发布到涌入几亿用户,往往只需要几个月;但建设一座支撑这些用户聊天的高密度数据中心,从买地、审批电网到调试通电,硬周期是2到4年。
这就逼着扎克伯格做出了一个他称之为“破釜沉舟(Burn the boats)”的决定:在Muse这款个人代理应用还根本不存在、完全不知道会有多少人用的几年前,就必须拍板砸下几百亿,把推理机房提前建好。如果不建,万一模型火了,服务器当场排队崩溃;如果建了,万一没人用,满机房的显卡就会变成每秒钟都在亏钱的废铁。
为什么把模型“服务”给用户(即在线推理),会比训练模型还要昂贵?这背后有两道连高中物理都能解释的硬件死穴:
1. 算力饥饿:大厨等不到送菜员
外界常把在线推理看作缩减版的模型训练,但两者的物理瓶颈截然相反。
训练模型时,芯片的运算核心像火力全开的工厂流水线,计算强度极高;但在陪用户聊天的推理(解码)阶段,模型是一个词(Token)一个词往外蹦的。每蹦出一个字,芯片都必须把重达几百GB的整套模型参数,从显存(HBM)里完整搬运到计算核心(SRAM)里过一遍。
这就像一个刀工出神入化的顶级大厨,每切一片黄瓜,都得等跑腿小哥把整座图书馆那么大的菜谱从街对面搬过来翻一遍。结果就是,90%以上的时间里,昂贵的算力核心都在“饥饿干等”,显存读取带宽成了卡死脖子的物理天花板。
2. 显存刺客:吞噬80%空间的“键值缓存(KV Cache)”
另一项巨大的硬开销来自记忆成本当你和AI进行长文分析或多轮对话时,AI为了记住你前面说过的话,不能每说一个字就把前文重新算一遍,而是必须把历史对话的特征存成一张张“便签纸”留在显存里,这就是工程界闻之色变的KV Cache(键值缓存)。
根据加州大学伯克利分校vLLM团队发表的经典论文,随着对话变长、同时在线人数飙升,这些动态膨胀的“便签纸”会迅速吃掉40%到60%以上的显存,甚至比模型本身还要庞大。而且,由于系统无法预知用户下一秒会输入50个字还是5万个字,传统架构只能按最大长度提前圈地预留。实测显示,高达60%到80%的宝贵显存,居然全被这种空置的内存碎片白白浪费掉了!
这也是为什么硅谷工程师们要拼命发明像PagedAttention(借鉴操作系统虚拟内存分页,像玩俄罗斯方块一样把显存碎片严丝合缝拼起来)这样的底层算法,硬生生把吞吐量挤出2到4倍。因为对坐拥Instagram、WhatsApp数十亿日活用户的Meta来说,模型越受欢迎,每天燃烧的推理电费和显存成本就越恐怖。上线仅仅几个月,日常交互烧掉的钱就会轻松跨过最初的训练账单。
05.尾声:告别“零边际成本”的黄金时代
合上《Cheeky Pint》的播客账本,这一串令人眩晕的天文数字,清晰标出了整个科技史的分水岭。
在过去的移动互联网时代,硅谷信奉的是“零边际成本”神话:几个大学生在车库里写出几行社交软件代码,复制给十亿人使用,几乎不需要增加什么硬件成本。
但大模型彻底终结了这个温情脉脉的时代。AI早已脱离轻资产的软件魔法范畴,成为人类历史上最沉重、最庞大、最吞金的重工业。
它要求入局者先掏出600亿美元建起堪比核电站的机房,每年承担150亿美元的折旧与电费,在成百上千次实验阶梯上烧掉双倍的算力,最后还要在产品诞生前三年,倾注全部资源去铺设对抗显存黑洞的推理电网。
正如Epoch AI在报告中所预言的那样:当门票涨到数百亿乃至上千亿美元,全球角力场上终将只剩下屈指可数的超级巨头。而在夏威夷海风中让CFO吓出冷汗的那张支票,不过是这场残酷工业战争的第一声发令枪。