ARTICLE · 1226197
AI越主动,提示词越要谨慎!新版deepseek不太好驾驭啊
用了几天deepseek-v4.1-flash-1017,干活确实利索了很多,完全不拖泥带水。
但是我发现token消耗的速度比之前快了大概2-3倍吧,我这几天用了10亿+token,但是同样的工作量放在以前估计也就3-4亿吧。
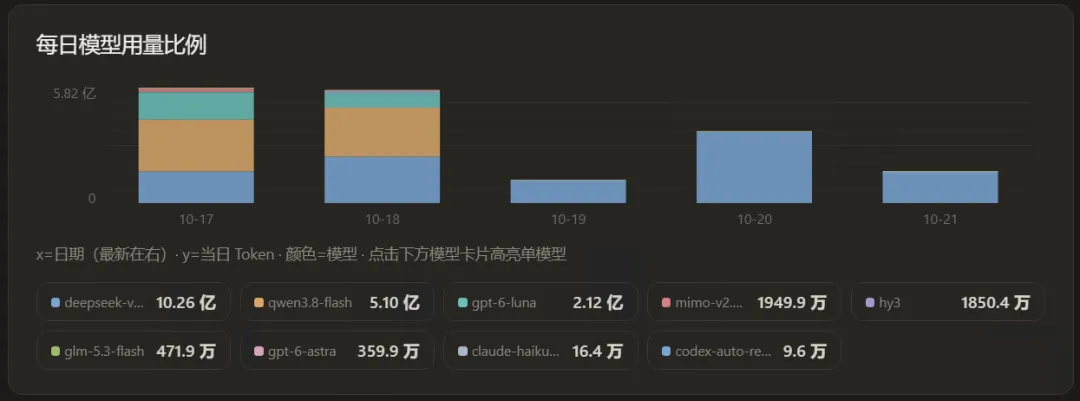
为什么新版的deepseek更费token了呢?
我仔细对比了一下deepseek-v4.1-flash的0910和1017两个版本,我使用下来的所有日志和产生的上下文,确实发现了一个很大的变化,客观上导致token用量增加。
先说一下,下面我说这些变化,来自其实没法严格归因给新版的deepseek,因为agent框架也可能会升级,我用的是workbuddy,所以我下面要说的这些变化,我其实分不清楚是模型本身的变化,还是模型+agent框架共同的变化,现在也没法做交叉验证了。
但是我更倾向于是模型本身的变化。
具体来说,新版deepseek最大的变化是:非常喜欢揣测我的意图,甚至有时候有点自作主张了。
这里我用案例来对比,这个是上一版0910版本思维链里面揣测意图的部分:
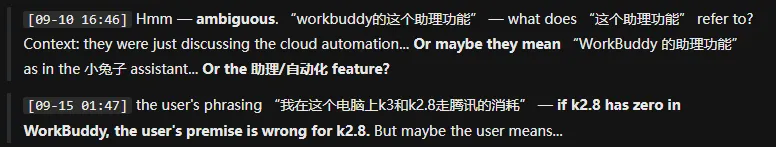
这两条思维链虽然也是在揣测我的意图,但其实都是明确需求的范畴。
但1017版本就不一样了,比如这条思维链最典型:
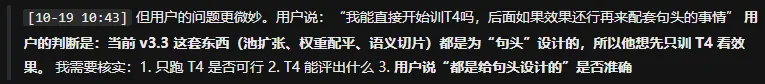
我只是问【能不能直接训T4】,他就把我的隐含判断提炼出来【v3.3 都是给句头设计的】,然后列了三条核实项,并且真的去核实了一遍,调用了很多工具,最后才回答我。
他总是倾向于觉得我是话里有话,很喜欢过度解读。
过度解读本身还不算什么大问题,很多模型都会多想一层。真正让人累的是他一旦解读出了一个结论,比如认定我真实需求是要X,这个X就从一个猜测变成一个它必须去证实的判断。
所以在使用的过程中经常出现这些情况:
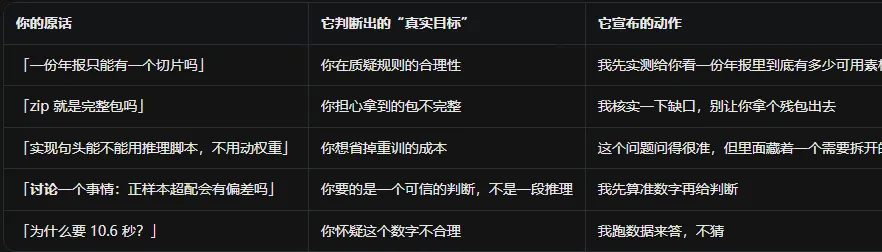
于是这种【过度解读】就变成了【急着动手】。
所以这就是为什么token消耗更快,因为动手更多了,调用工具更多了,那这个token消耗自然就上去了。
以前我为了避免模型着急动手,会习惯在提示词结尾说一句【先给方案,我确认后再执行】。
我发现对1017版,这个方法没用。
就算我说了先不执行,他表面上不执行,但会也会想办法调用各种方法去验证一下。
有时候我给他一个确定的结论,他也会说我要先验证。而他做验证这一步动作的上下文可能是不支持他得出正确结论的,所以经常他会说我一个已经得到过验证的结论是错误的,然后我就纠正他,告诉他来龙去脉,给他补充相关上下文,他说哦原来是这样啊,误会了误会了。
所以1017版本其实对使用者的要求变高了,至少需要更谨慎的写提示词了,只能说想要驾驭好这个模型,还需要更多的磨合。