ARTICLE · 1230521
被投企业动态 | 开源四天下载百万,MOSS-Image 登顶 Hugging Face 文生图模型趋势榜!
近日,上海国投旗下上海科创集团被投企业模思智能再迎里程碑:截至10月21日,开源短短四天,海内外全网下载量突破100万次,GitHub星标数破千星,登顶Hugging Face文生图模型趋势榜!
10月16日,模思智能与 OpenMOSS 团队正式开源图像生成模型 MOSS-Image,很快便在海内外开发者和 AI 创作者社区中引发了强烈反响。
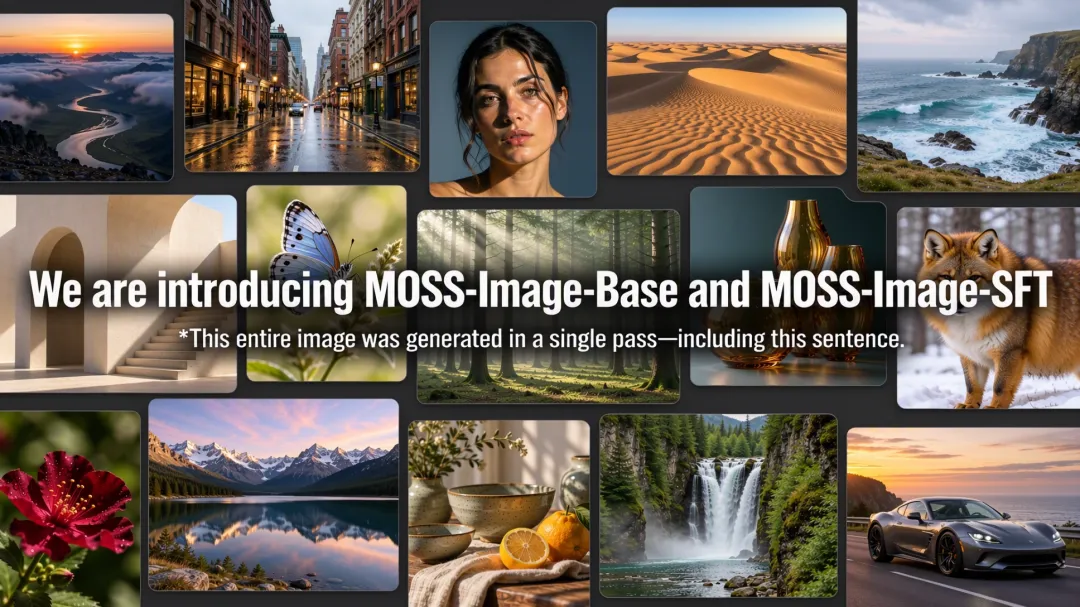
MOSS-Image 是一个基于 5B参数 DiT 主干网络的图像生成模型,主打更准确的文字渲染、更可控的Layout布局生成,同时支持最长4K tokens的提示词,覆盖动漫、插画、照片级写实等多种视觉风格。
截至10月21日,MOSS-Image 在 Hugging Face 的Comfy-Org 模型仓库下载量达 92.5 万次,并登上 Hugging Face 文生图 Trending 榜首。我们在 Reddit r/StableDiffusion 社区发布的 AMA 帖子也获得了社区置顶推荐。
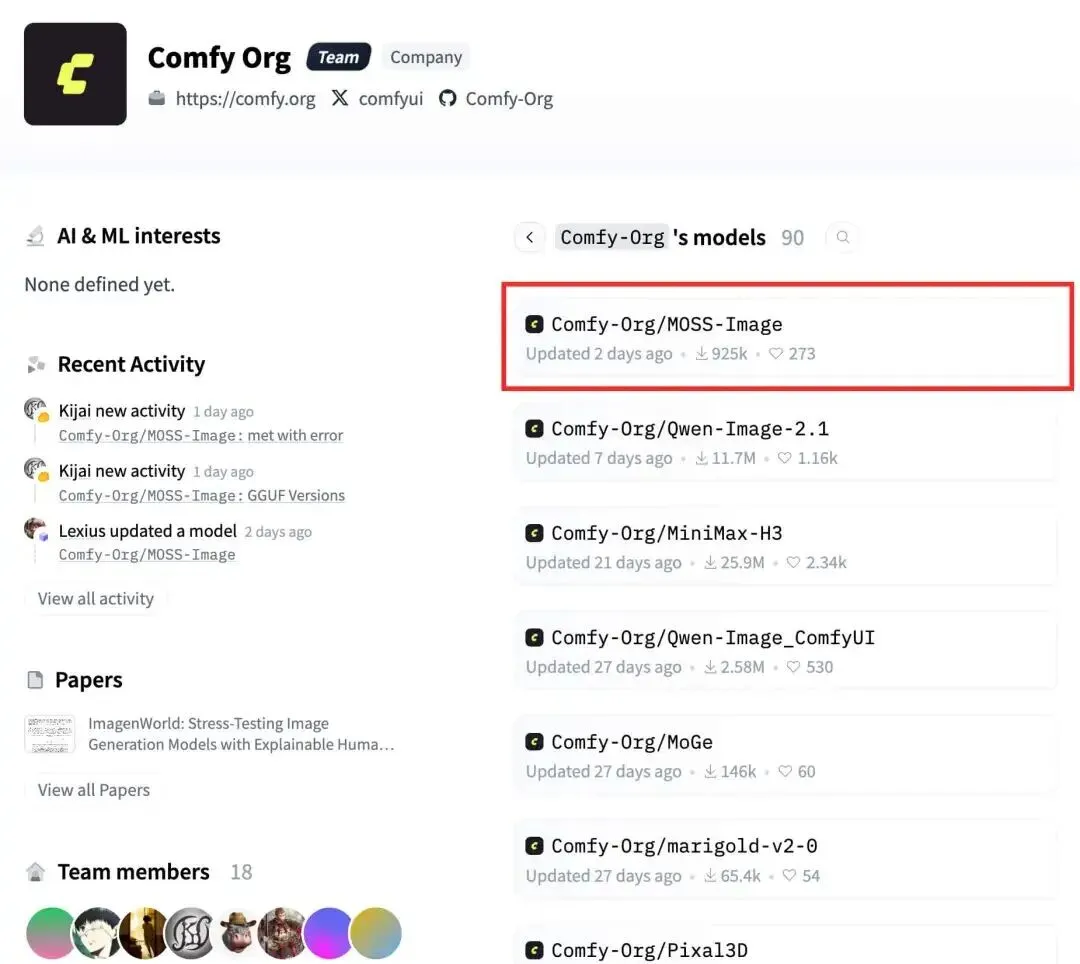
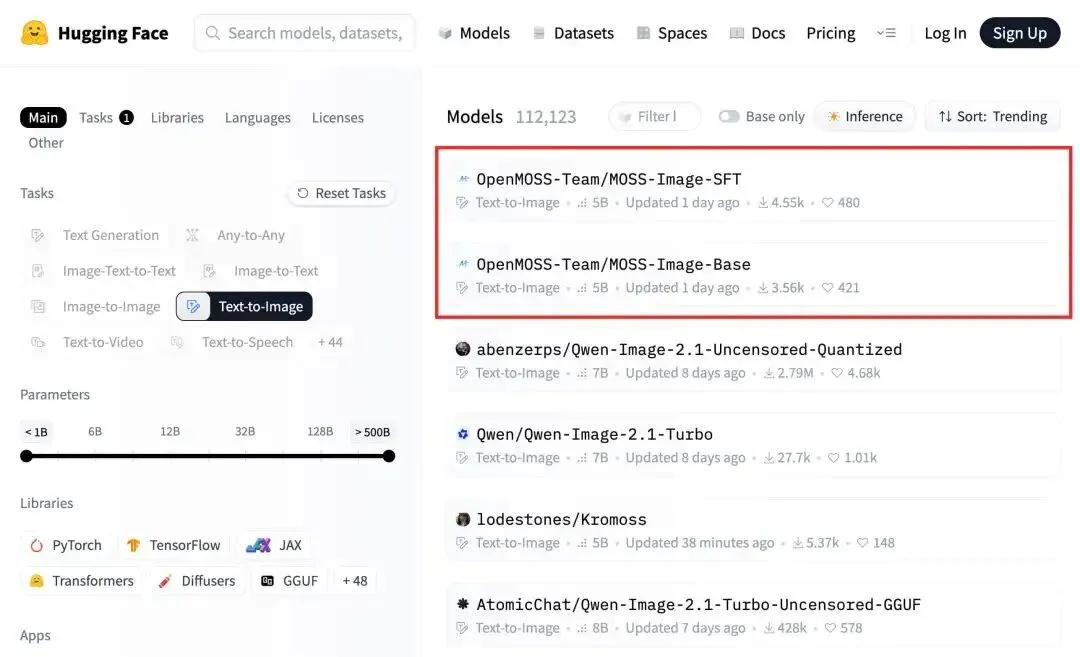
国内外不少开发者、创作者、ComfyUI 玩家自发上手实测,在 X、Reddit、B站、QQ 等社区分享生成作品和使用体验。从文字渲染准确性、Layout 布局控制到模型微调潜力,MOSS-Image 的表现收获了非常多积极评价!
目前 MOSS-Image-Base 和 MOSS-Image-SFT两个版本的模型权重、代码和使用指南均已公开。
除了下载模型进行本地部署和微调,开发者现在还可以通过 API 直接调用 MOSS-Image 的图像生成能力,更便捷地集成到自己的应用与开发工作流中。
MOSS-Image 的核心优势主要体现在三个方面:更准确的文字渲染、更可控的画面布局,以及对复杂提示词和多样化视觉风格的支持。
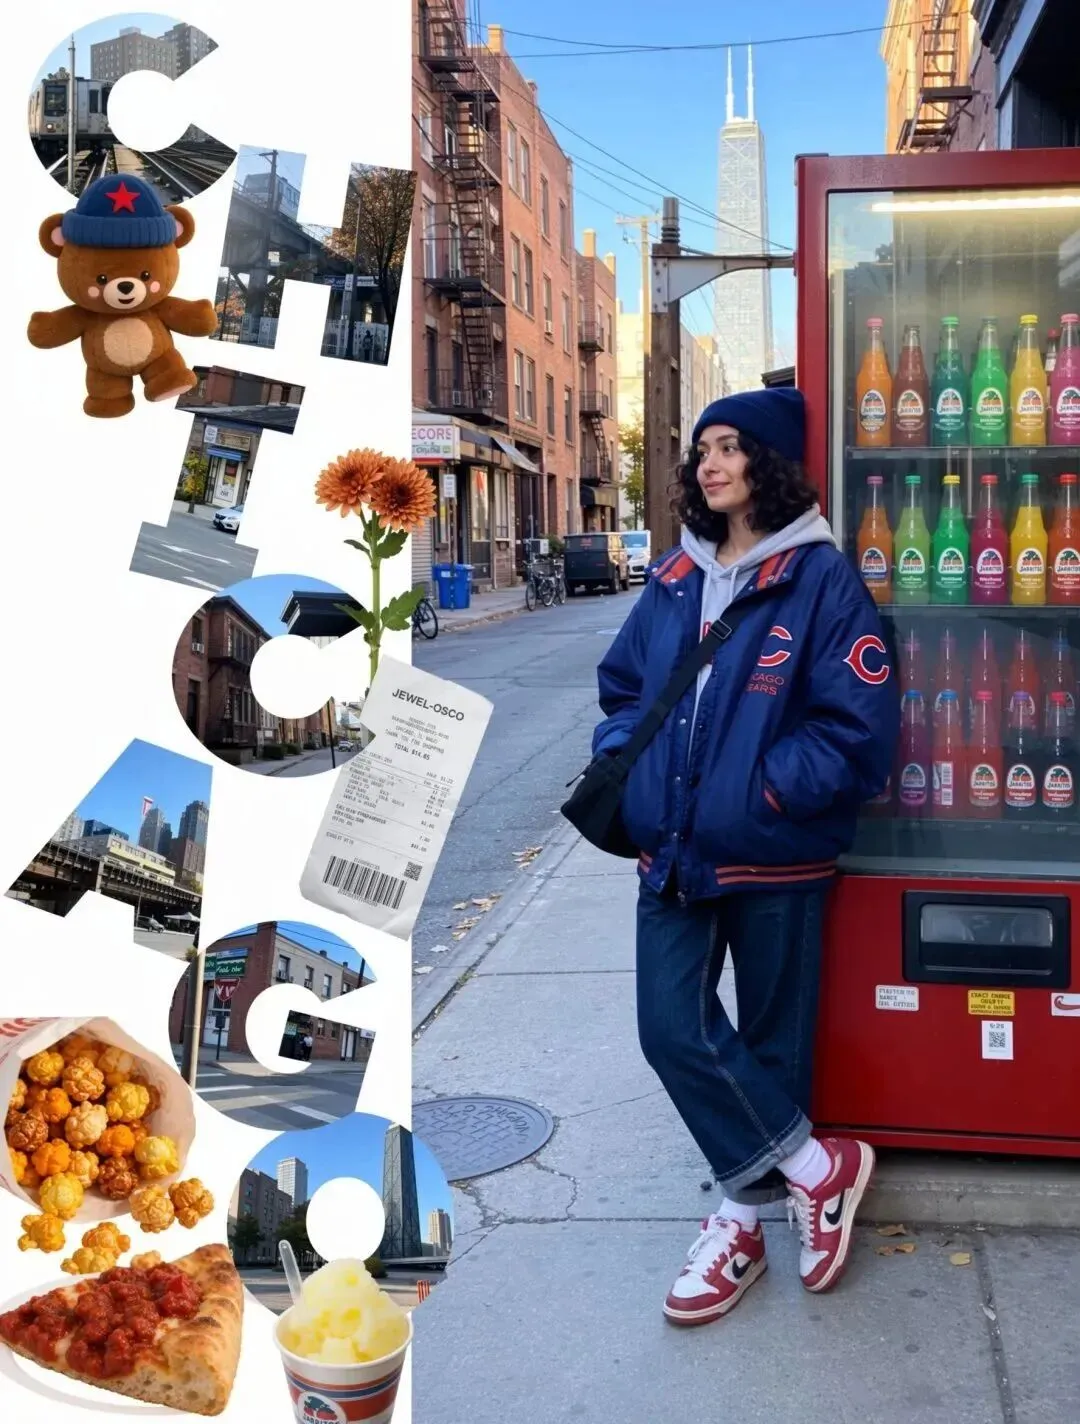
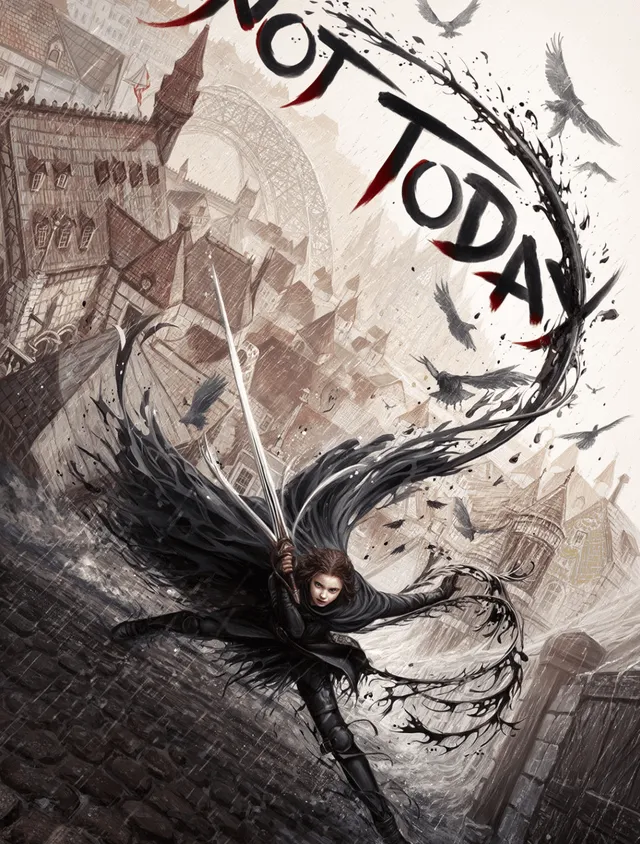
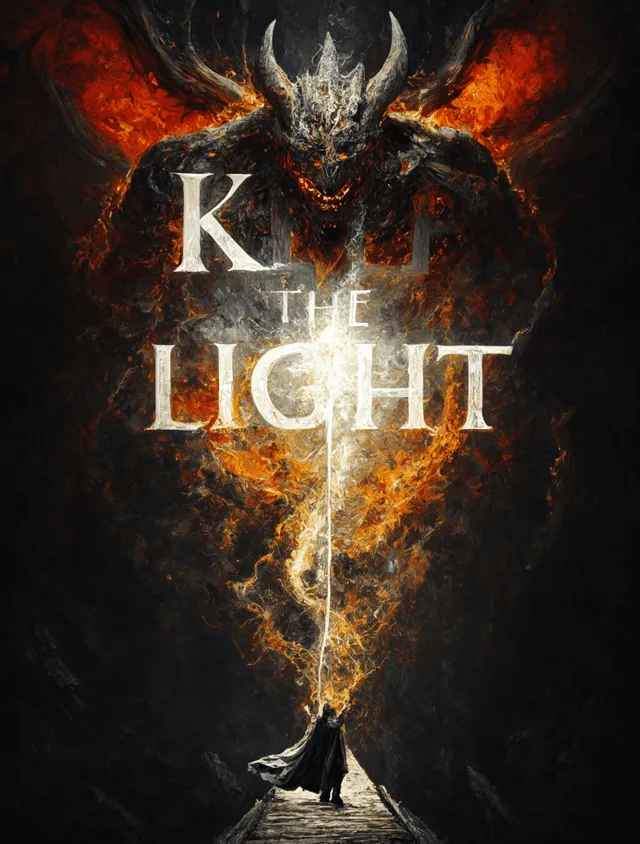
01 更准确的中英文文字渲染
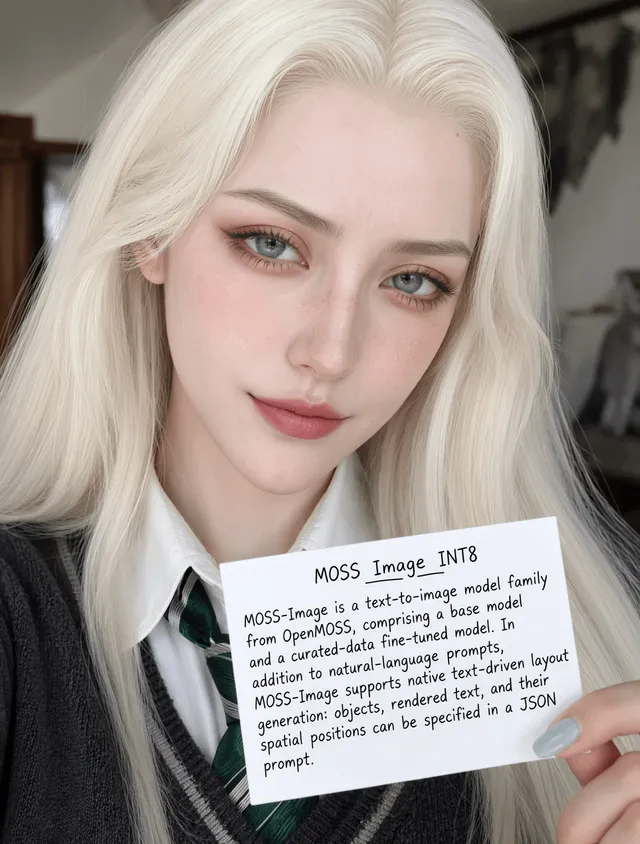
MOSS-Image 面向中英文密集文字生成进行了重点优化,能够在图像中呈现清晰、准确的文本,并保留换行等文字结构信息。
左右滑动查看更多
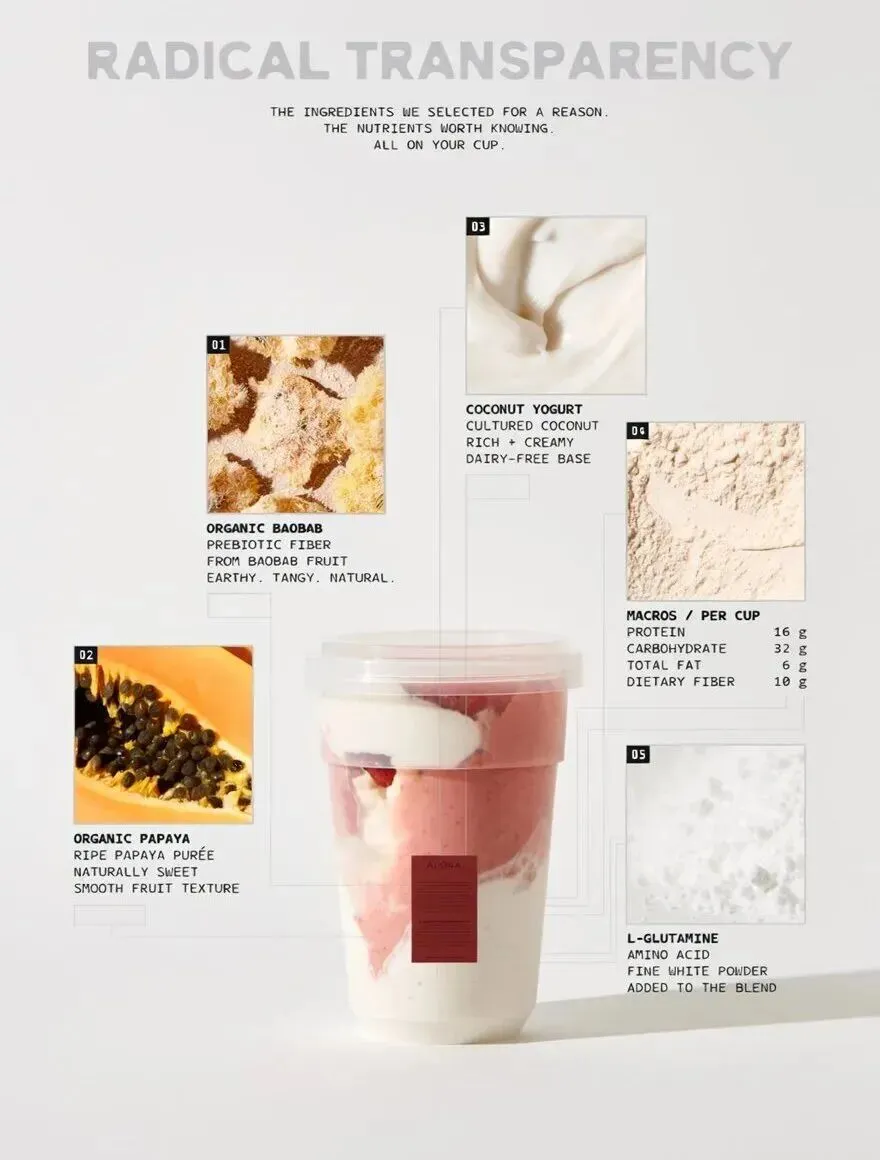
MOSS-Image 生成|来源:X@plasm0
MOSS-Image 生成|来源:Reddit@Bra--ket
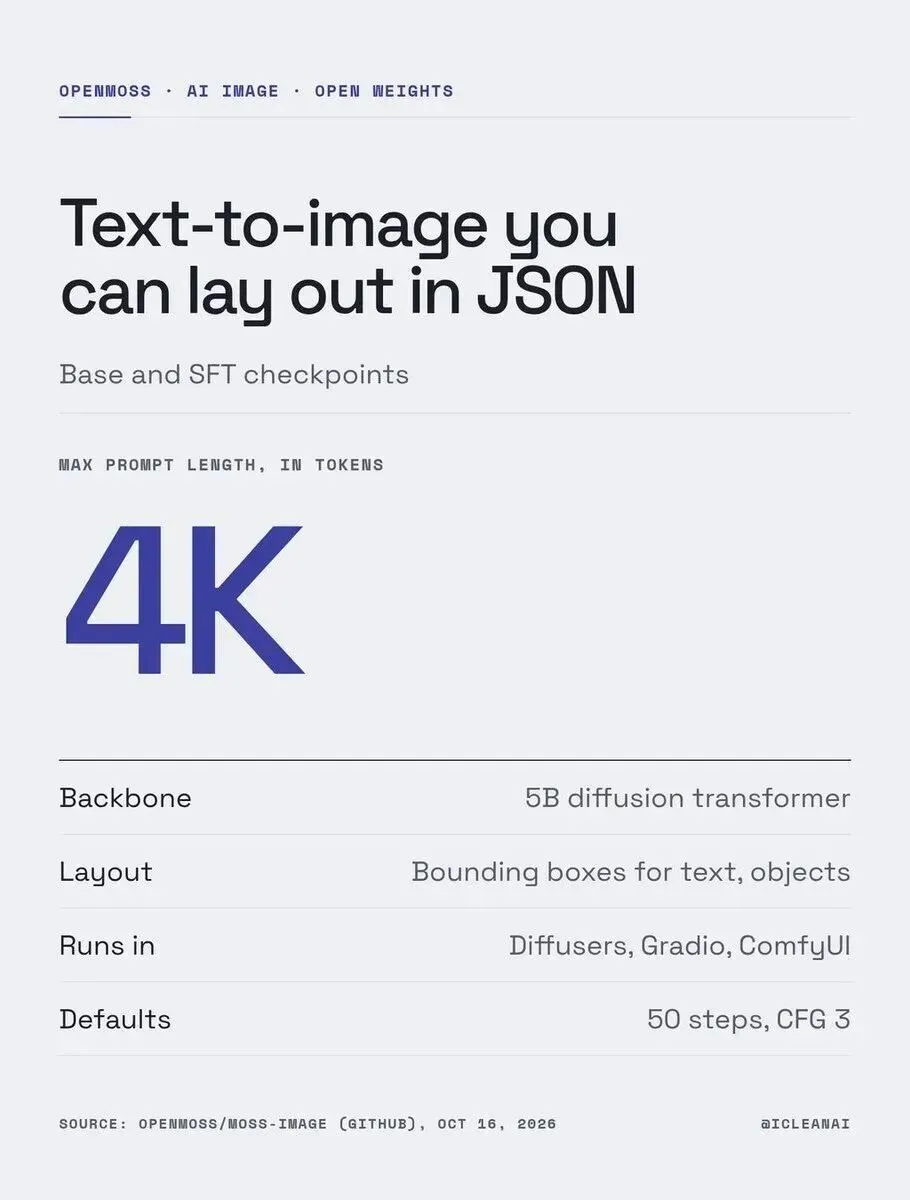
MOSS-Image 生成|来源:X@iCleanAI
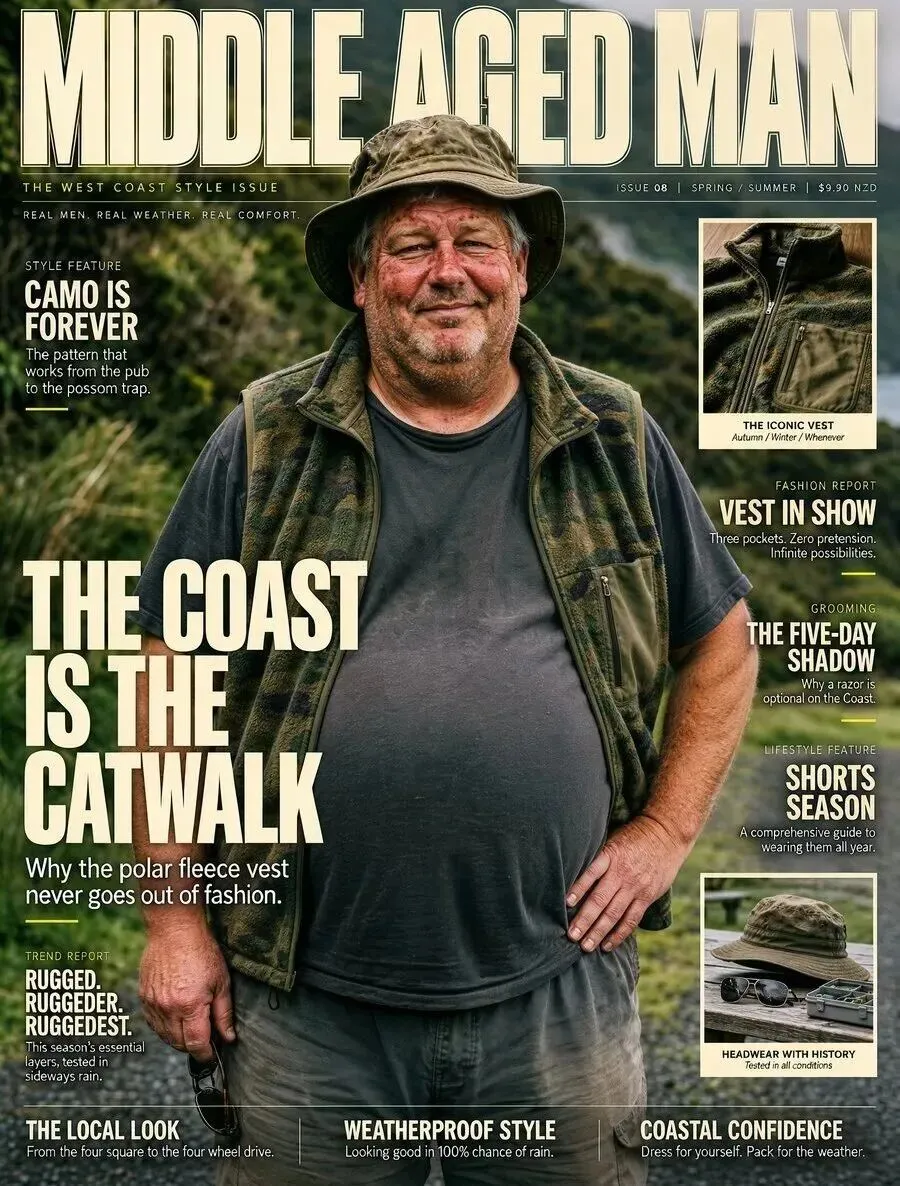
MOSS-Image 生成|来源:X@strongnstableai
02 更可控的 Layout 布局生成
在生成包含多元素、复杂排版的图片时,仅通过自然语言描述构图,很难满足精细的布局要求。为此,MOSS-Image 支持通过结构化 JSON Layout 控制文字和视觉元素的位置,为海报、图解等复杂排版场景提供更灵活的控制方式。
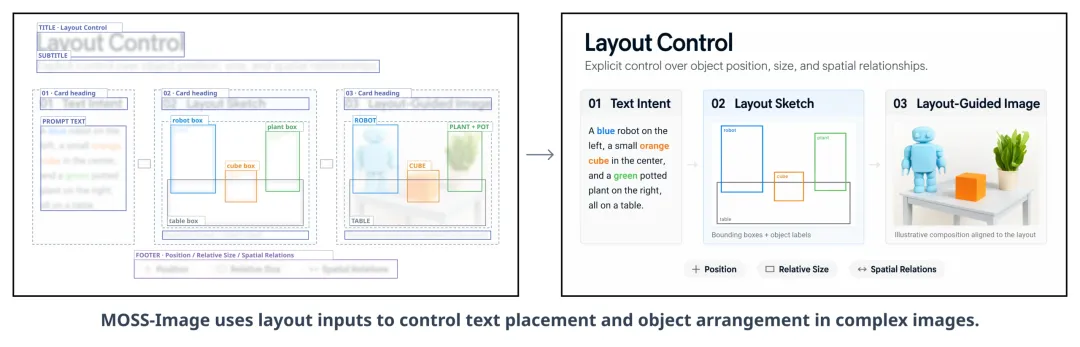
开发者可以通过 summary 描述整体场景,通过 items 指定文字、物体及其视觉特征,并使用 Bounding Box(边界框)定义不同元素在画布中的位置与范围。
左右滑动查看更多
MOSS-Image 生成|来源:X@plasm0
MOSS-Image 生成|来源:OpenMOSS
MOSS-Image 生成|来源:Reddit@tekprodfx16
MOSS-Image 生成|来源:Reddit@tekprodfx16
03 最长 4K tokens,支持复杂描述与多样化视觉风格
为了支持更复杂的创作任务,MOSS-Image 的文本条件长度最高可达 4096 tokens。对于包含多个主体、复杂空间关系、细致视觉要求的生成任务,开发者可以提供更充分的描述。
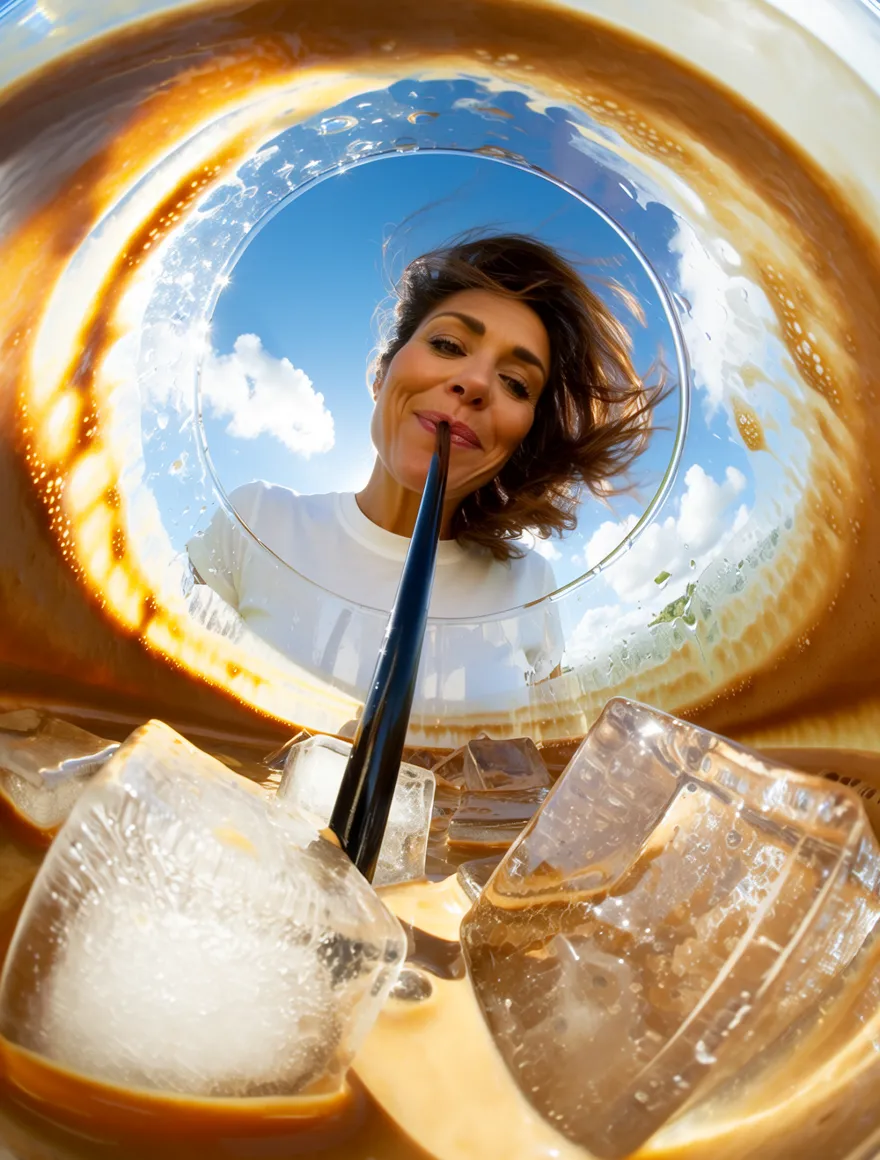
在视觉风格上,MOSS-Image 能够生成动漫、插画和照片级写实等不同类型的图像,适用于多样化的创作需求。
左右滑动查看更多
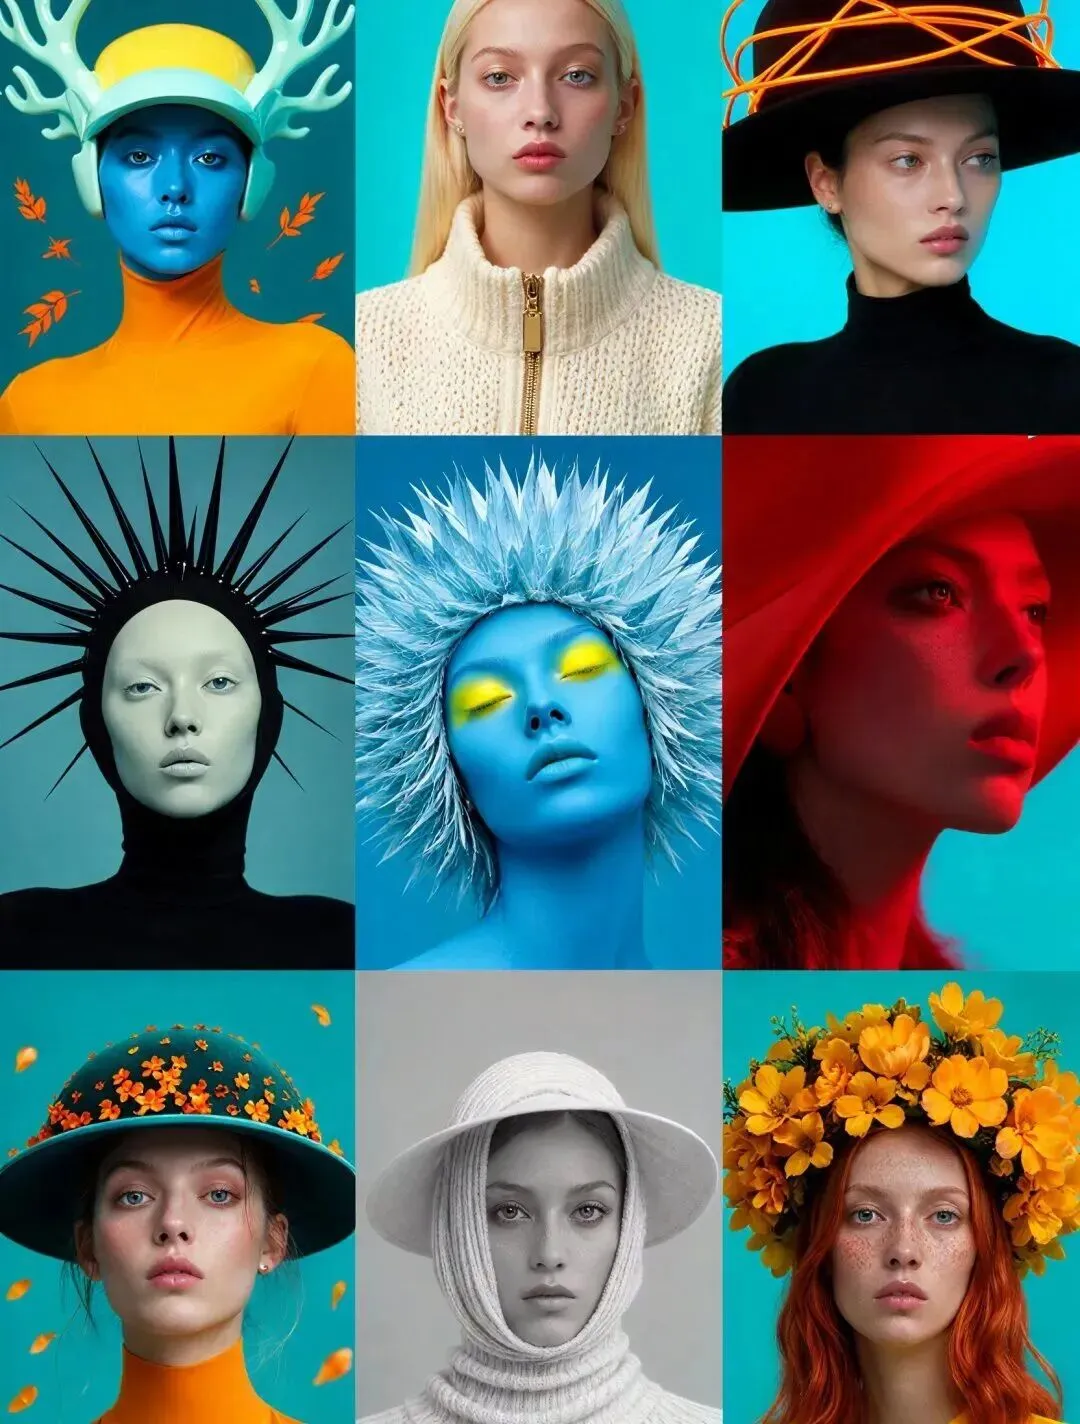
MOSS-Image 生成|来源:X@atomtanstudio
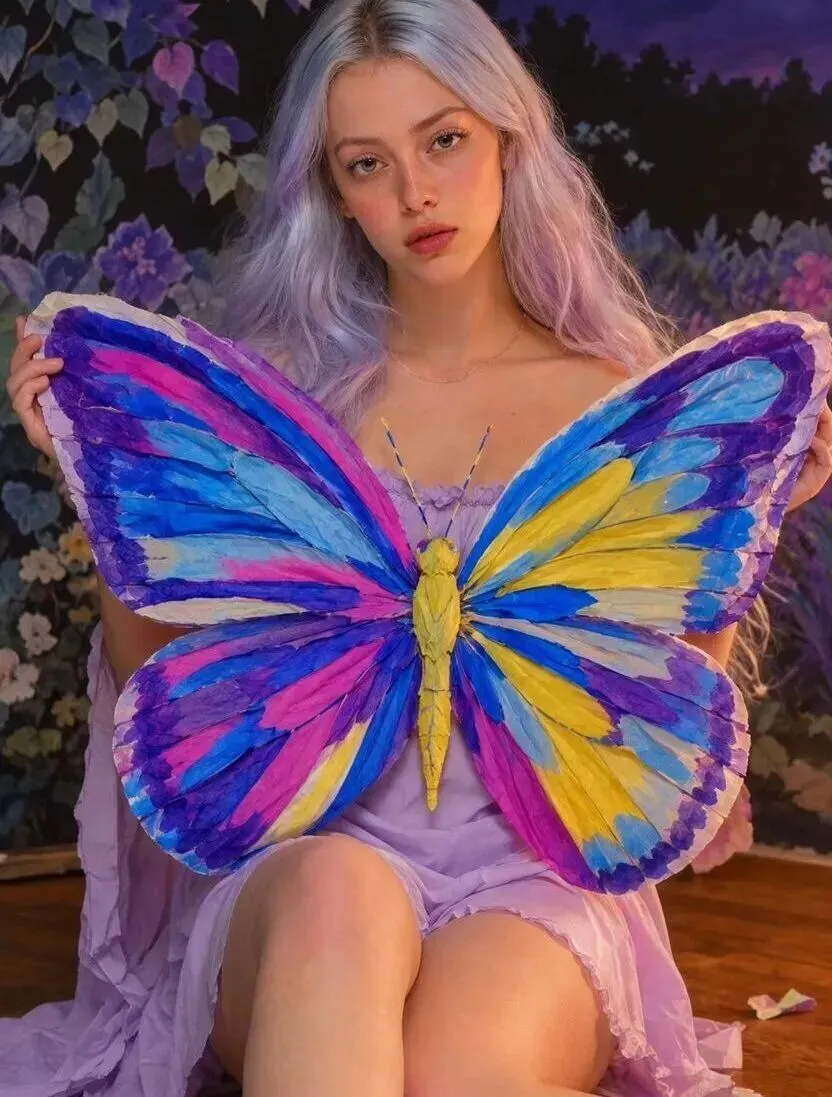
MOSS-Image 生成|来源:X@TraffAlex
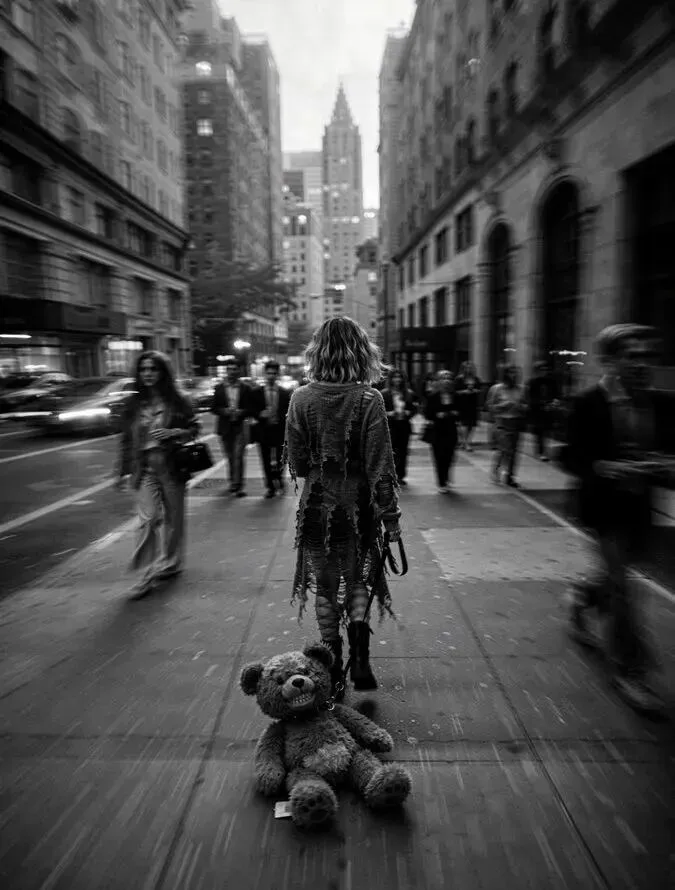
MOSS-Image 生成|来源:X@plasm0
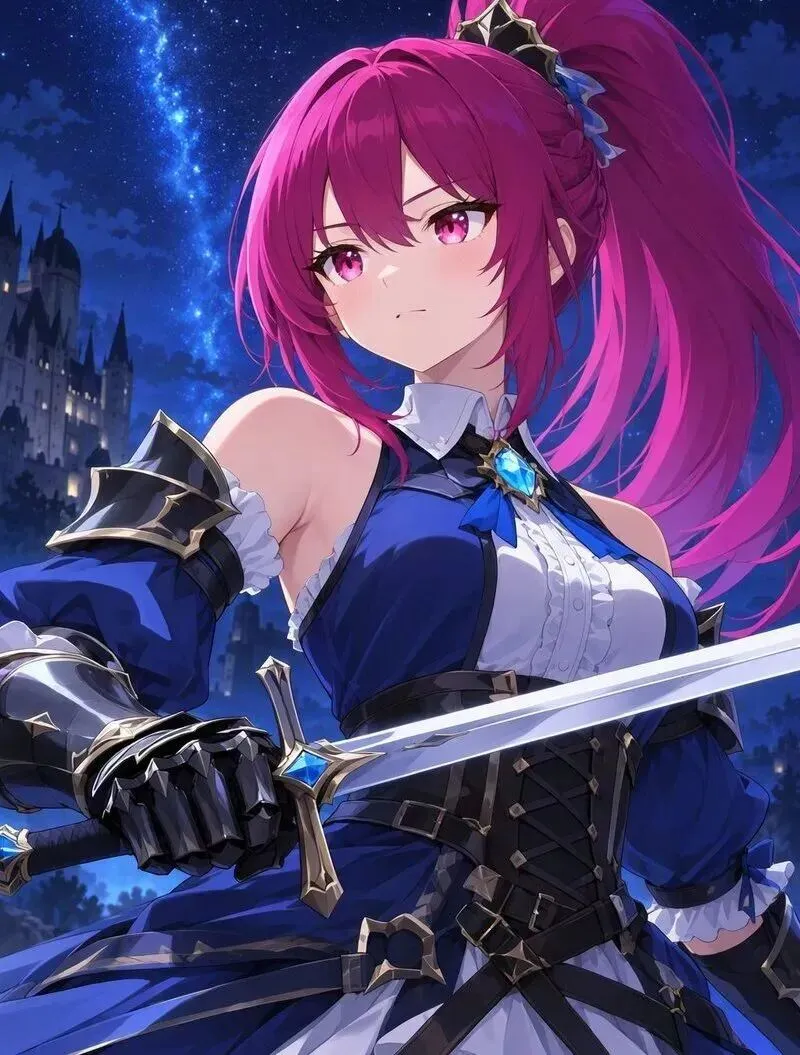
MOSS-Image 生成|X@YamataZen
统一文本与图像建模
MOSS-Image 的核心是一套从零预训练的单流扩散 Transformer 架构。
模型采用 42 个联合 Transformer Block,结合冻结的 Qwen3.5-9B 文本编码器与 FLUX.2 VAE,将文本条件与图像潜变量组织到统一的生成架构中。
其中,Qwen3.5-9B 负责提取文本特征,FLUX.2 VAE 负责处理图像潜变量,DiT 则承担扩散生成过程中的核心建模任务。
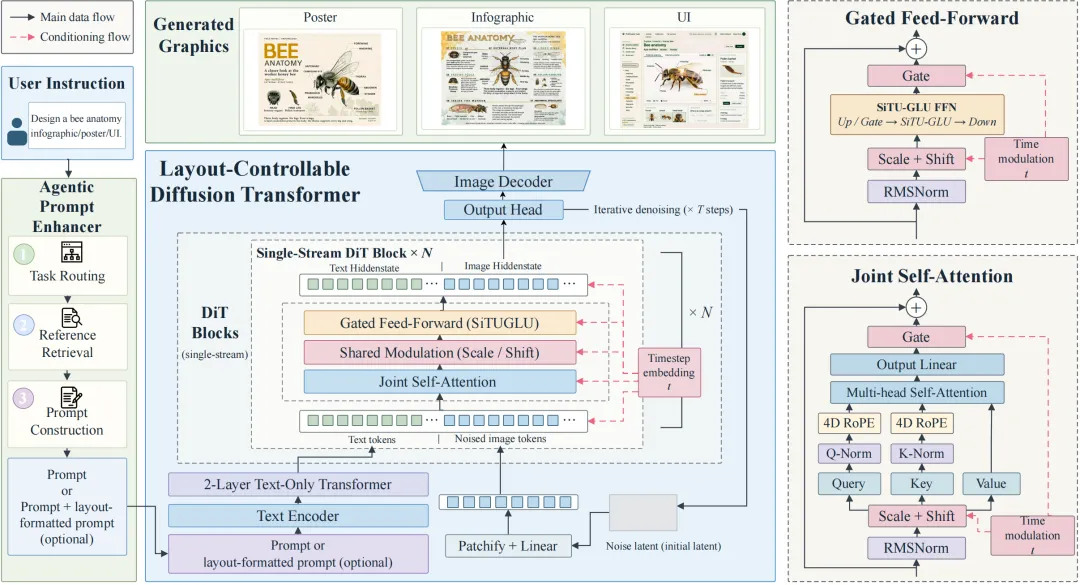
MOSS-Image System Architecture
MOSS-Image 在 Transformer Block 中采用了多项设计:
联合自注意力:用于文本与图像信息的联合建模。
共享调制:在模型内部组织和调制条件信息,大幅度减少调制层的冗余参数量。
SiTU-GLU 前馈层:作为 Transformer Block 中的前馈计算模块,提升长期训练的数值稳定性。
4D RoPE:参与模型的位置编码与时空信息表示,并为未来的参考图条件扩展保留相应维度。
数据与训练
除了模型架构,训练数据的组织方式同样影响着图像生成模型的表现。
在训练数据处理上,团队去除了重复样本和 AI 生成图像,同时尽可能保留真实图像的多样性,并对其中的水印、模糊等属性进行标注。
在算力基础设施方面,MOSS-Image 还采用国产 PPU 算力平台进行模型训练,积累了图像生成模型在不同算力架构上的训练与工程适配经验。
除了可视化生成案例,MOSS-Image 也通过多项基准测试,对模型在长文本渲染、布局控制和复杂设计任务中的表现进行了系统评估。
在 MOSS-Image 技术报告所列评测中,MOSS-Image 于三项基准均取得领先:
长文本渲染(LLTB):MOSS-Image 的 Mean-6 文本覆盖率 96.3%,在参评的开放权重模型中排名第一。
版面控制(7Bench):目标定位 mIoU 0.88、布局 AUC 0.70,均高于 Ideogram 4.0(0.44 / 0.20)。
真实设计盲评(RLA):仅给出简短设计请求时,Elo 点估计在参评模型中位列第二(1698.70),仅次于 GPT Image 2;在共享增强自然语言提示词的对照实验中,Elo 点估计为同组最高(1807.34),领先 ERNIE Image 与 SenseNova U1。
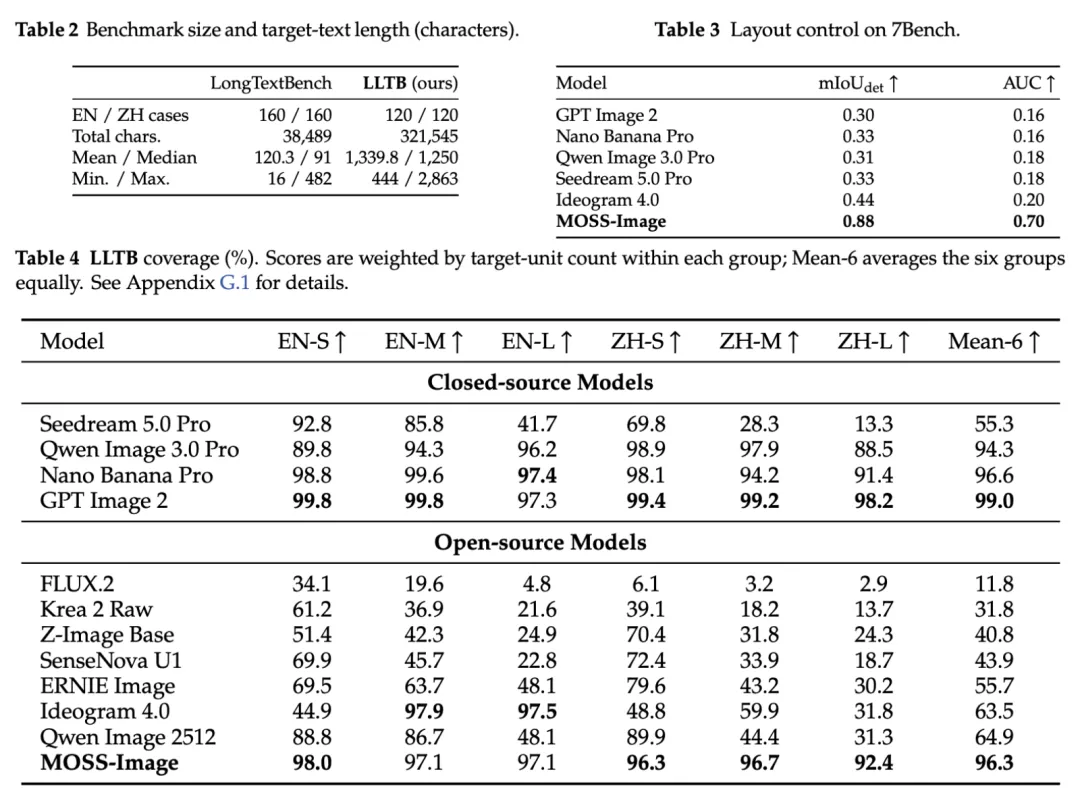
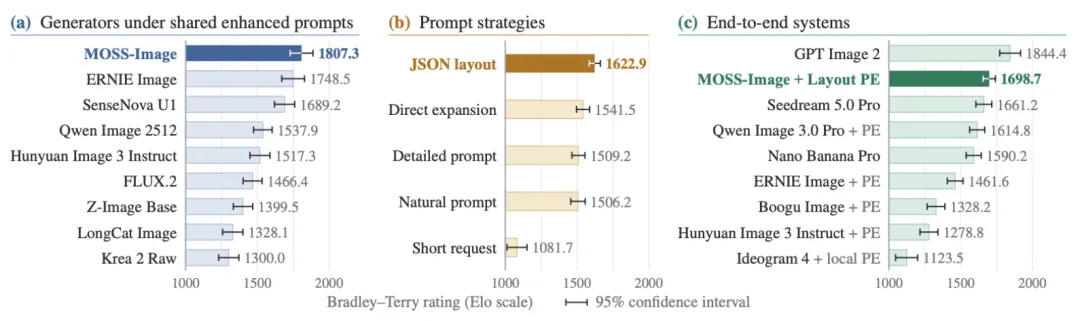
评测说明:LLTB 衡量的是文本覆盖率,并不等同于逐字无错率;7Bench 的目标定位 mIoU 仅统计已检测到的目标;RLA 的两个 Elo 结果对应不同测试条件,均为点估计,不应直接混为同一排名。完整评测设置及置信区间见技术报告。
以下为海内外社区对 MOSS-Image 的代表性评价与生成案例,我们持续欢迎更多开发者和创作者分享体验与二次开发成果!
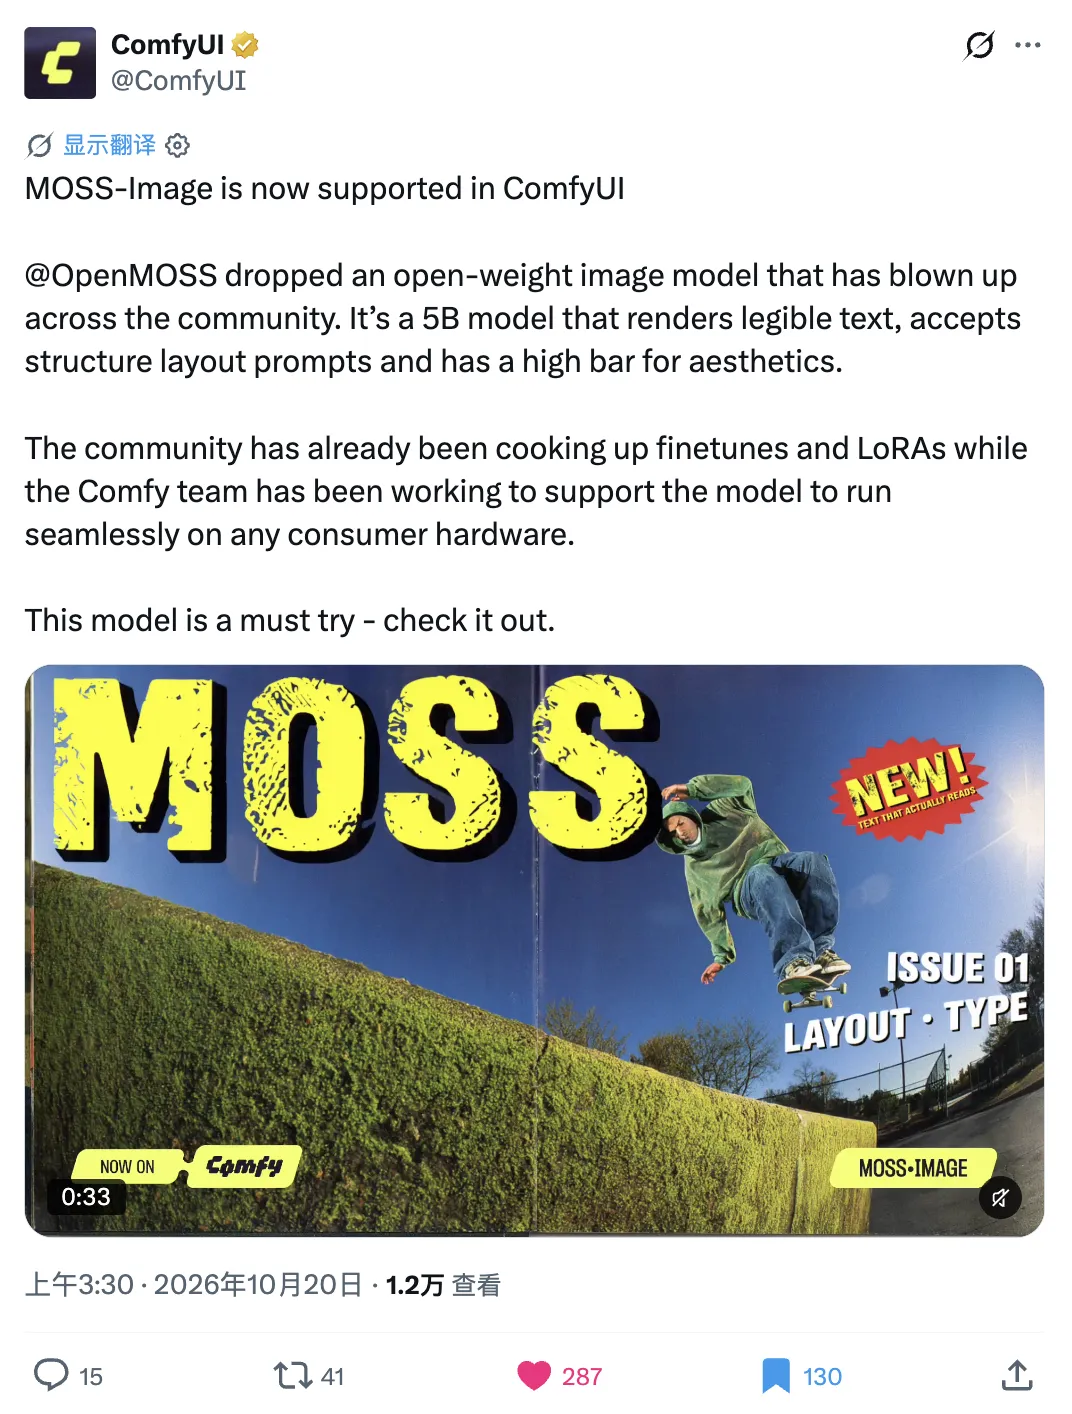
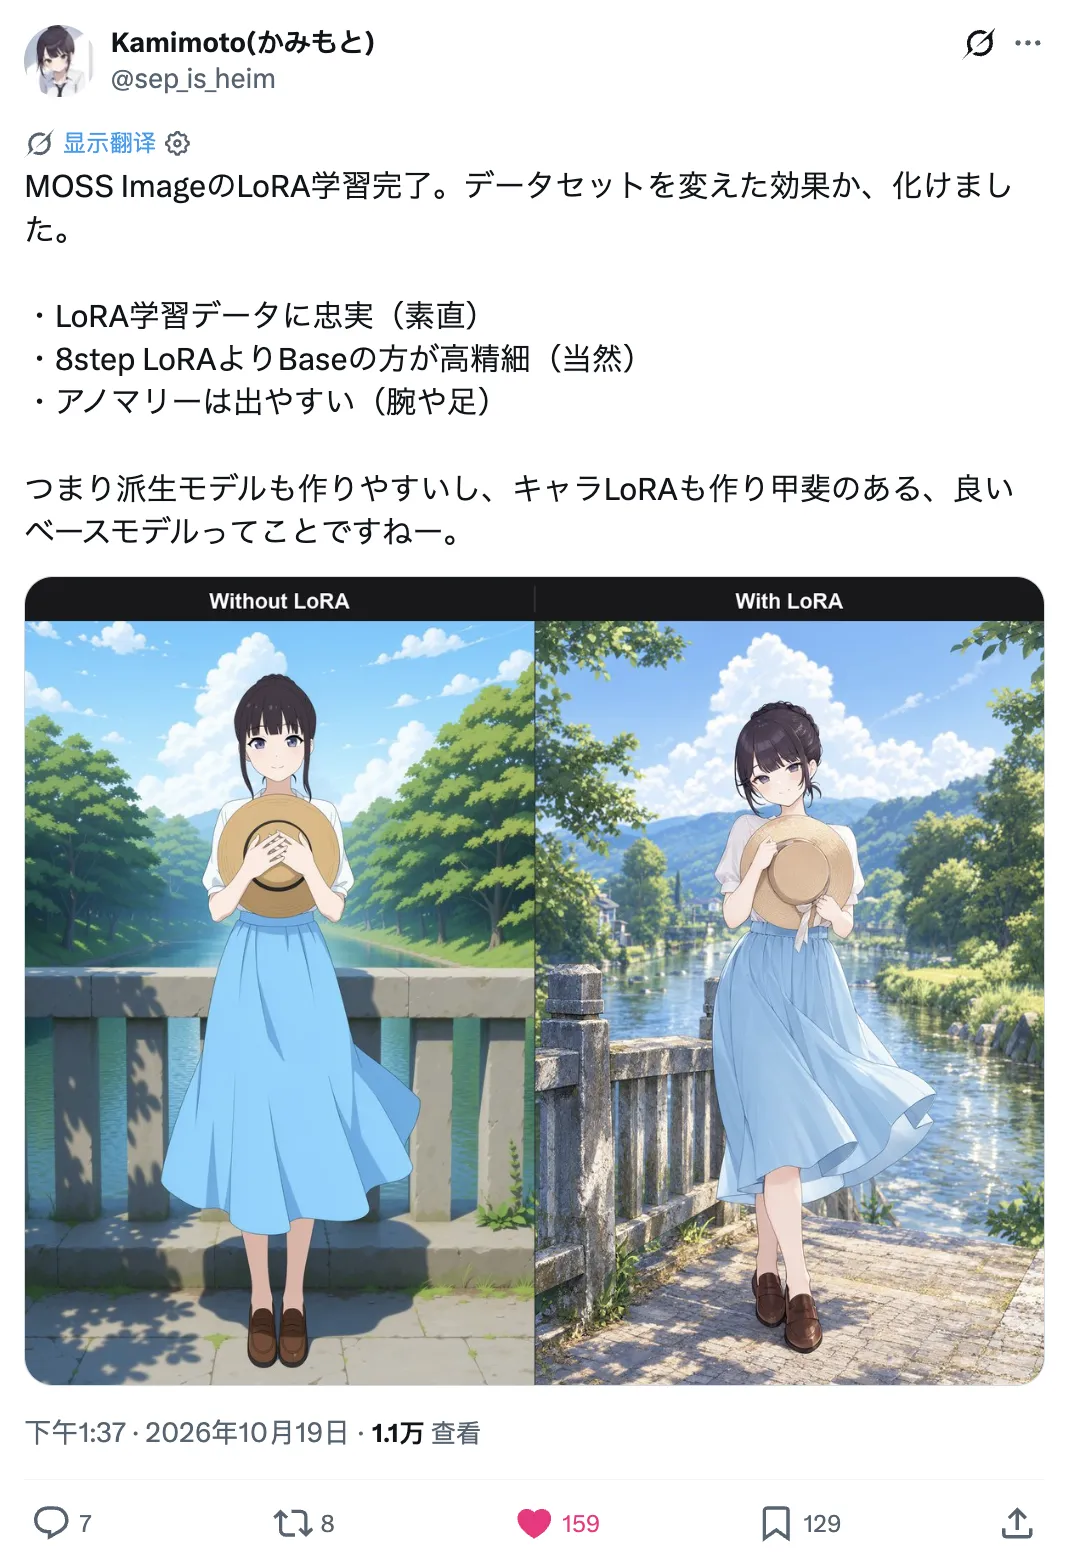
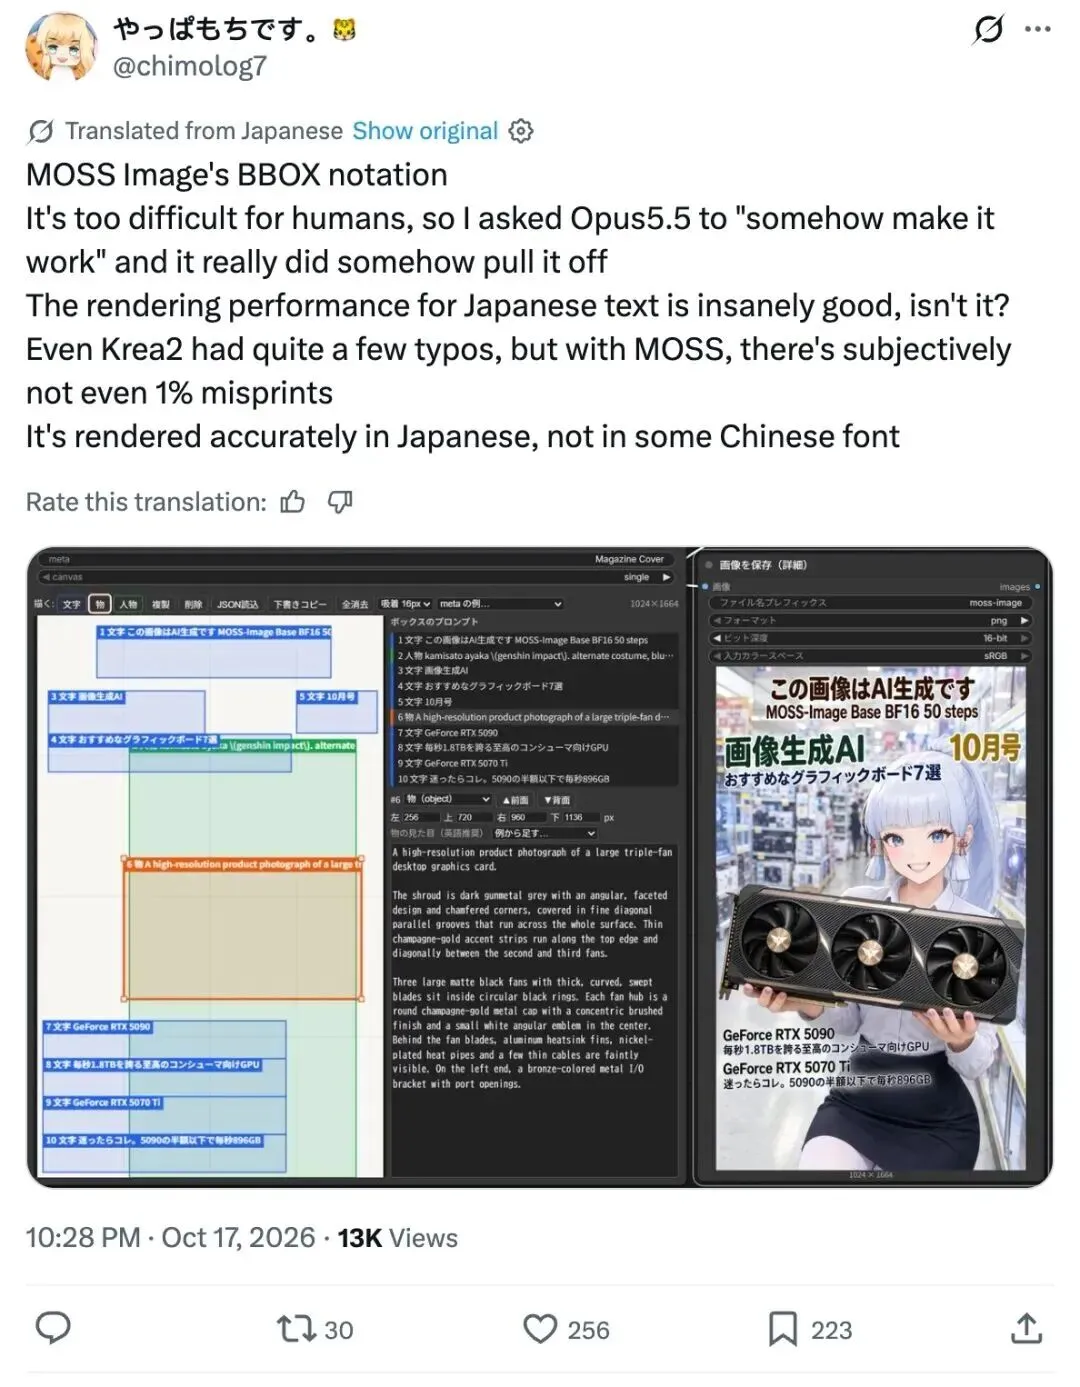
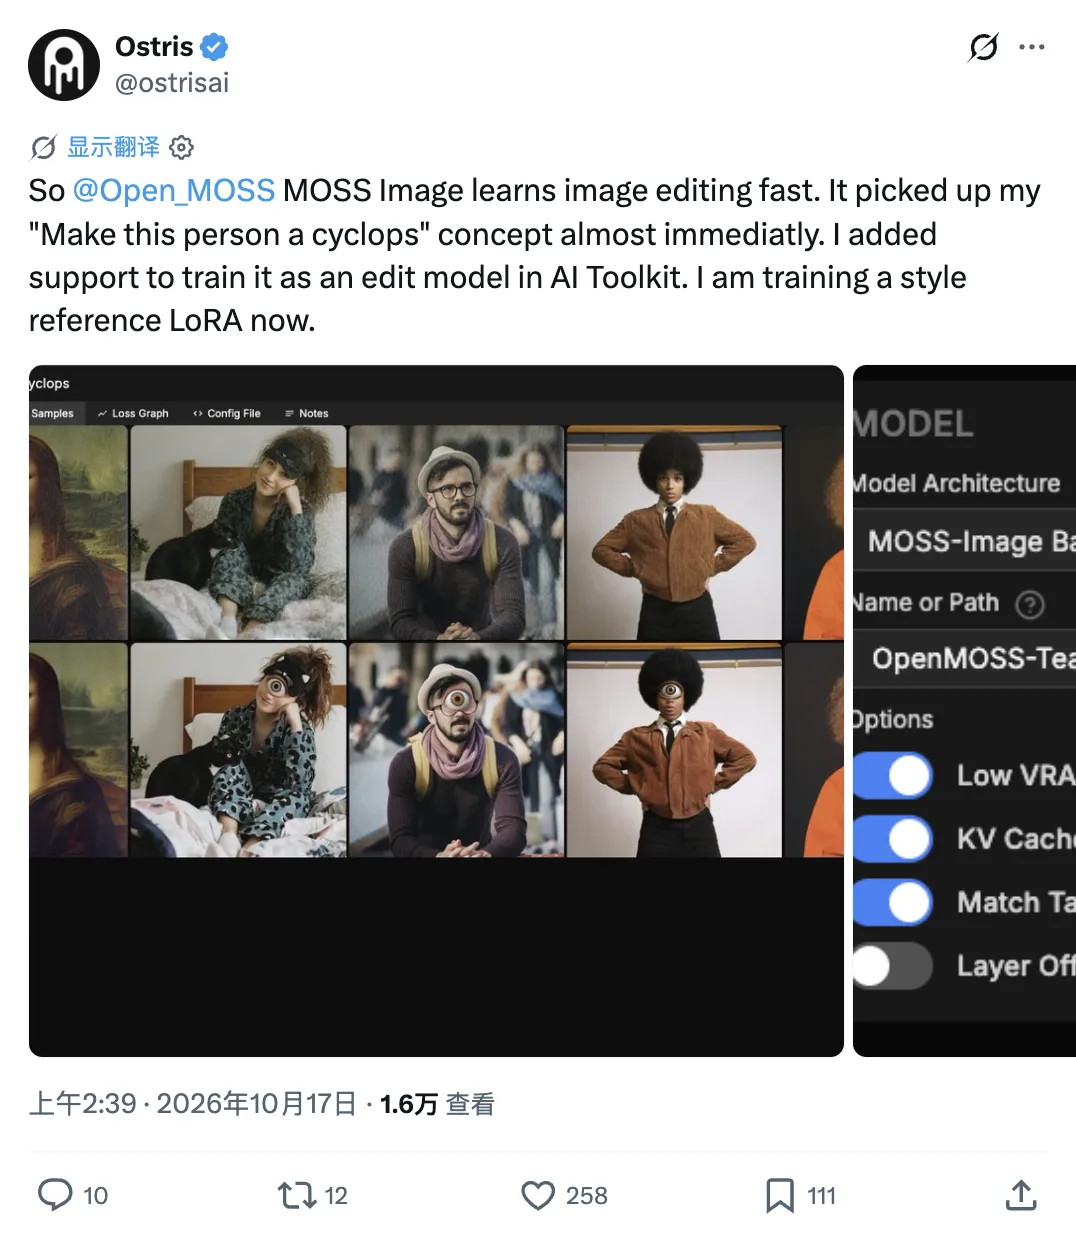
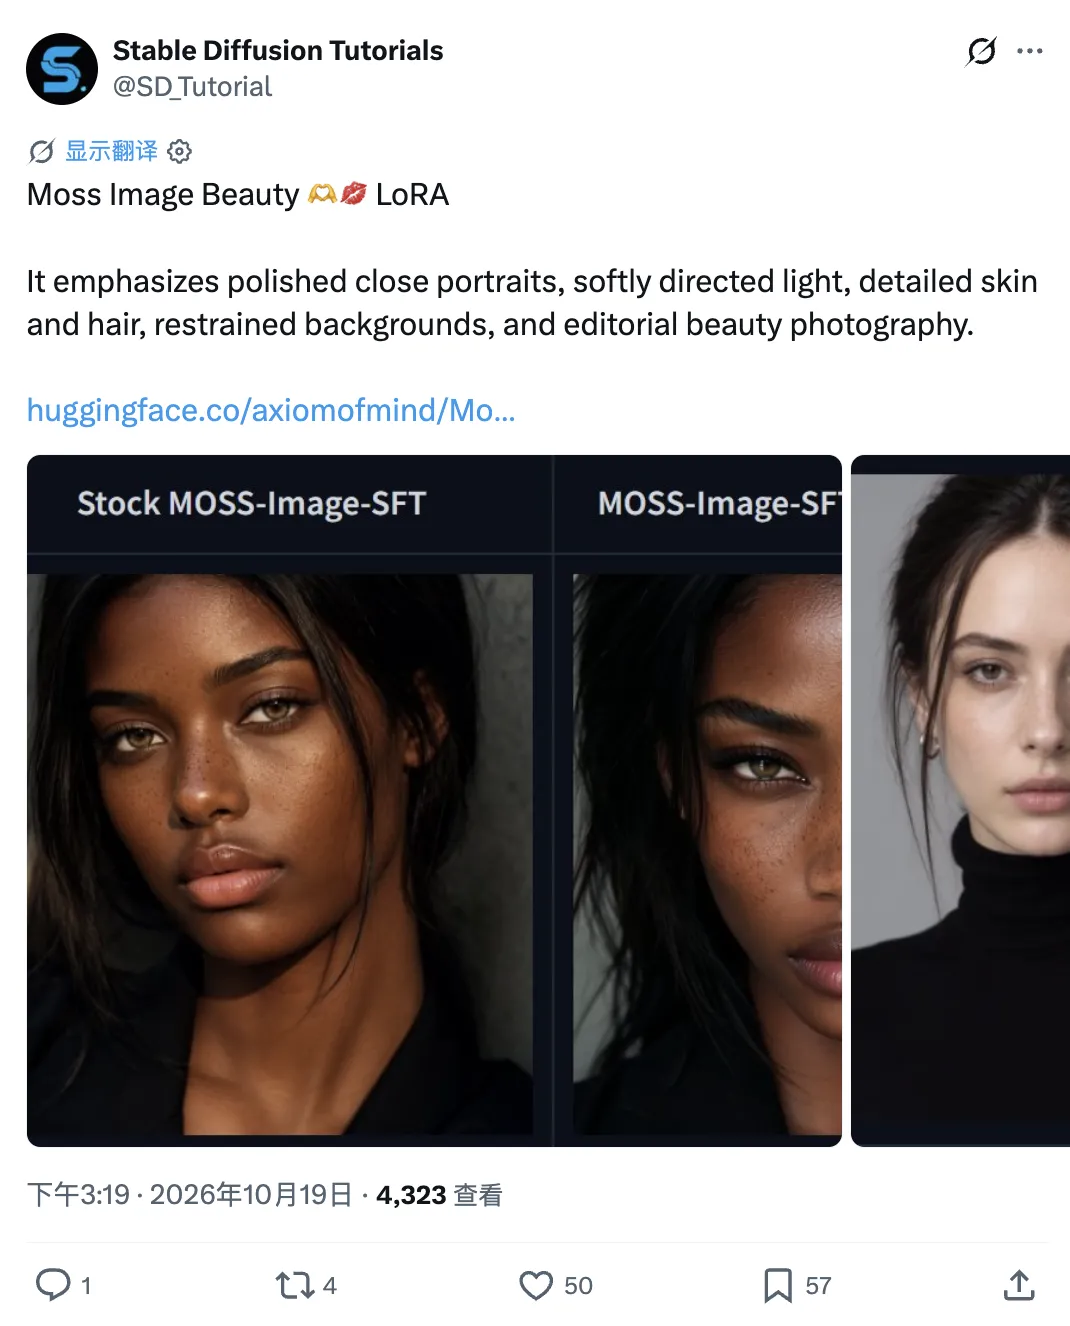
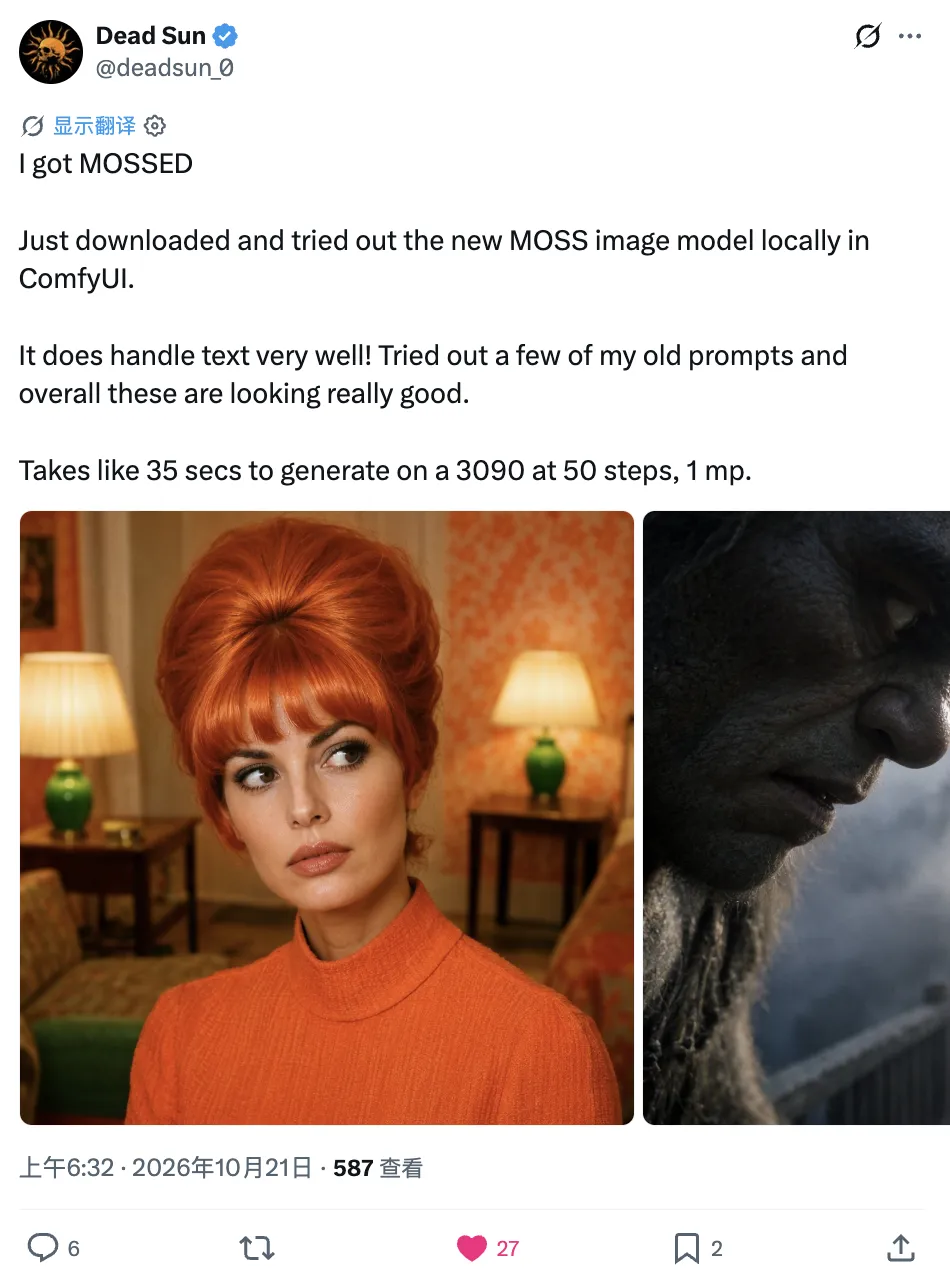
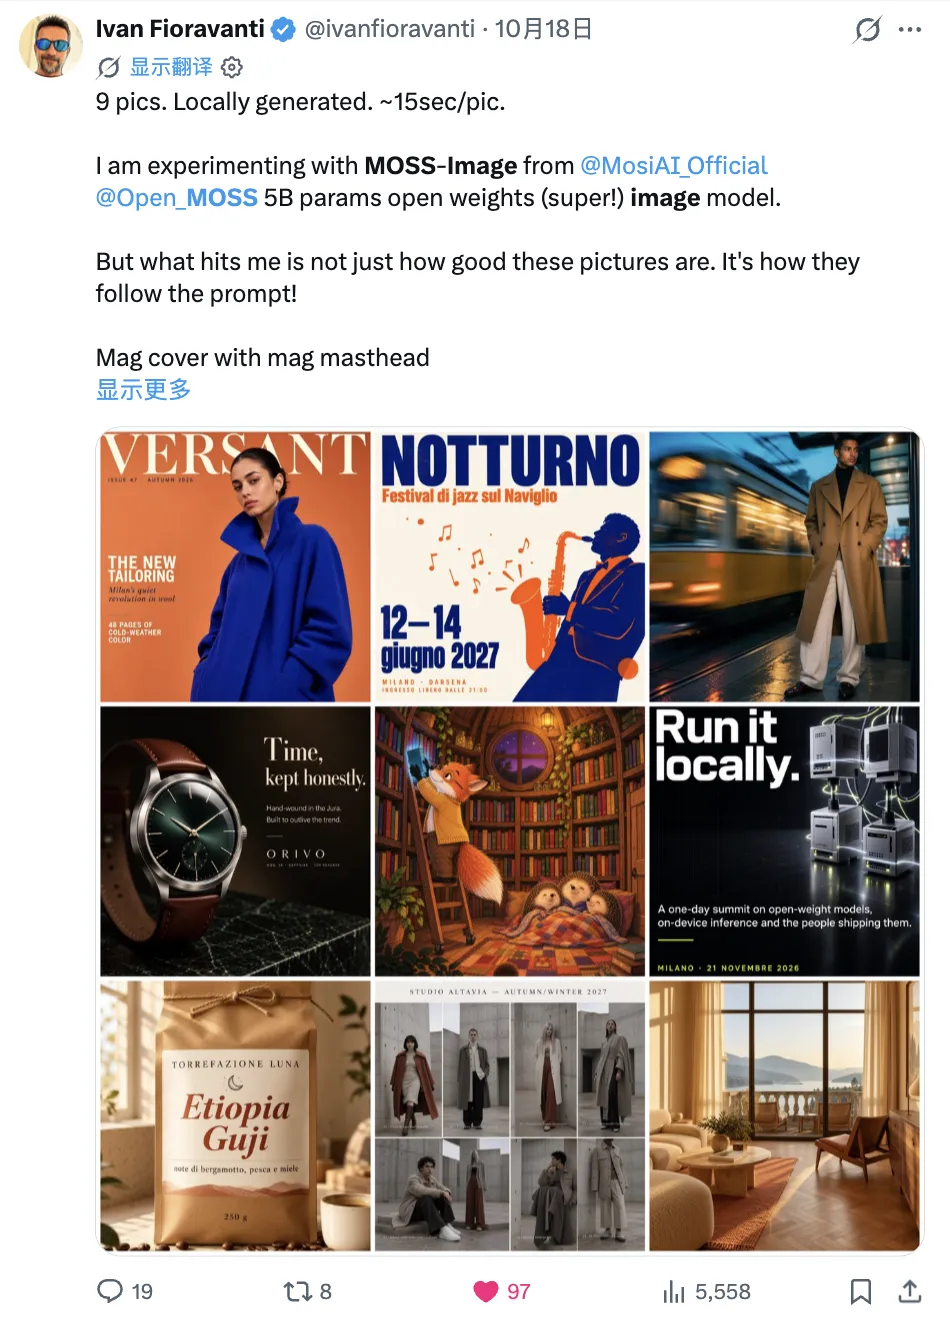
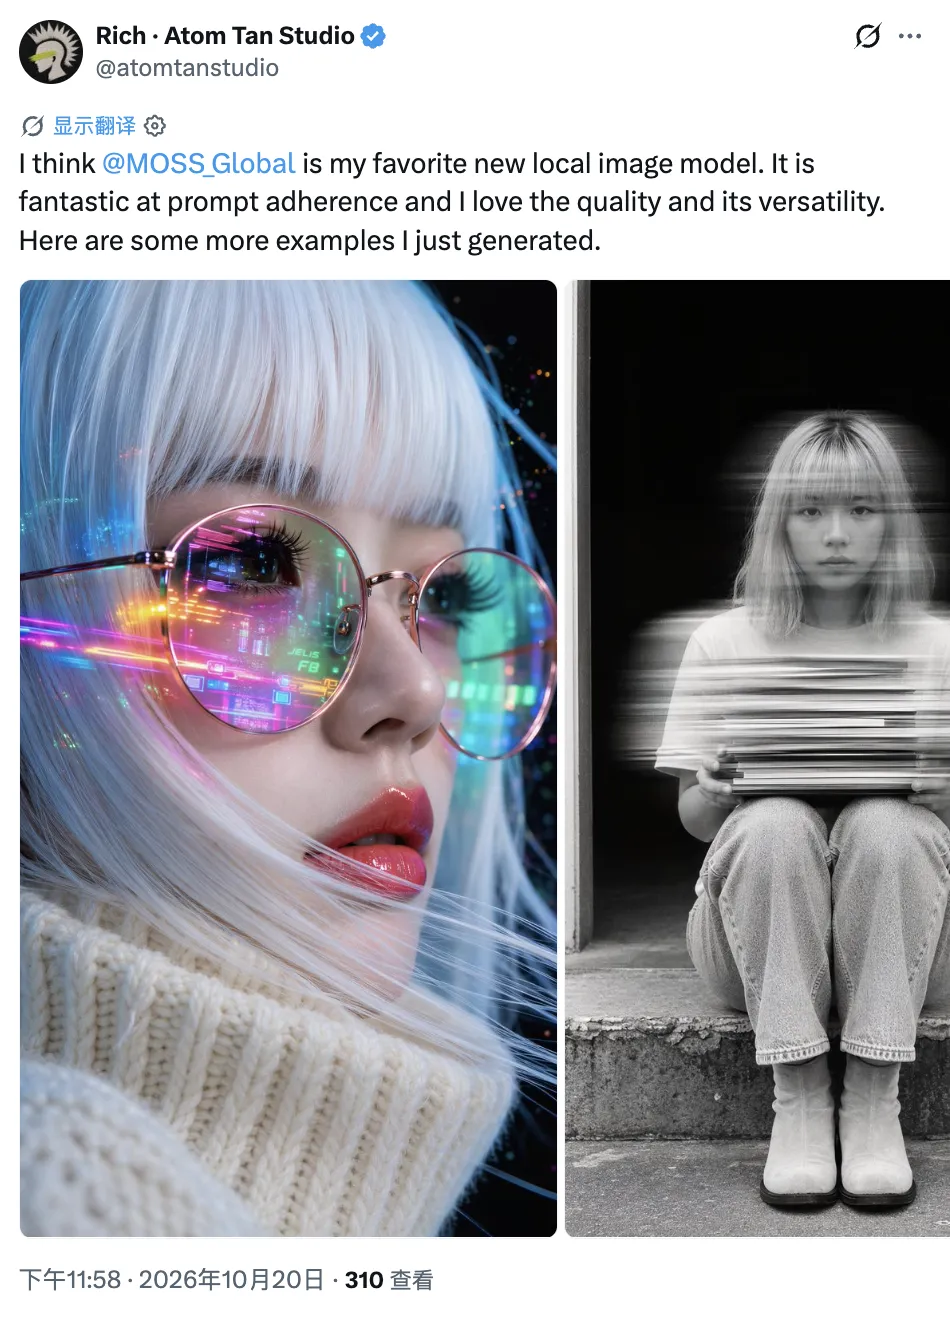
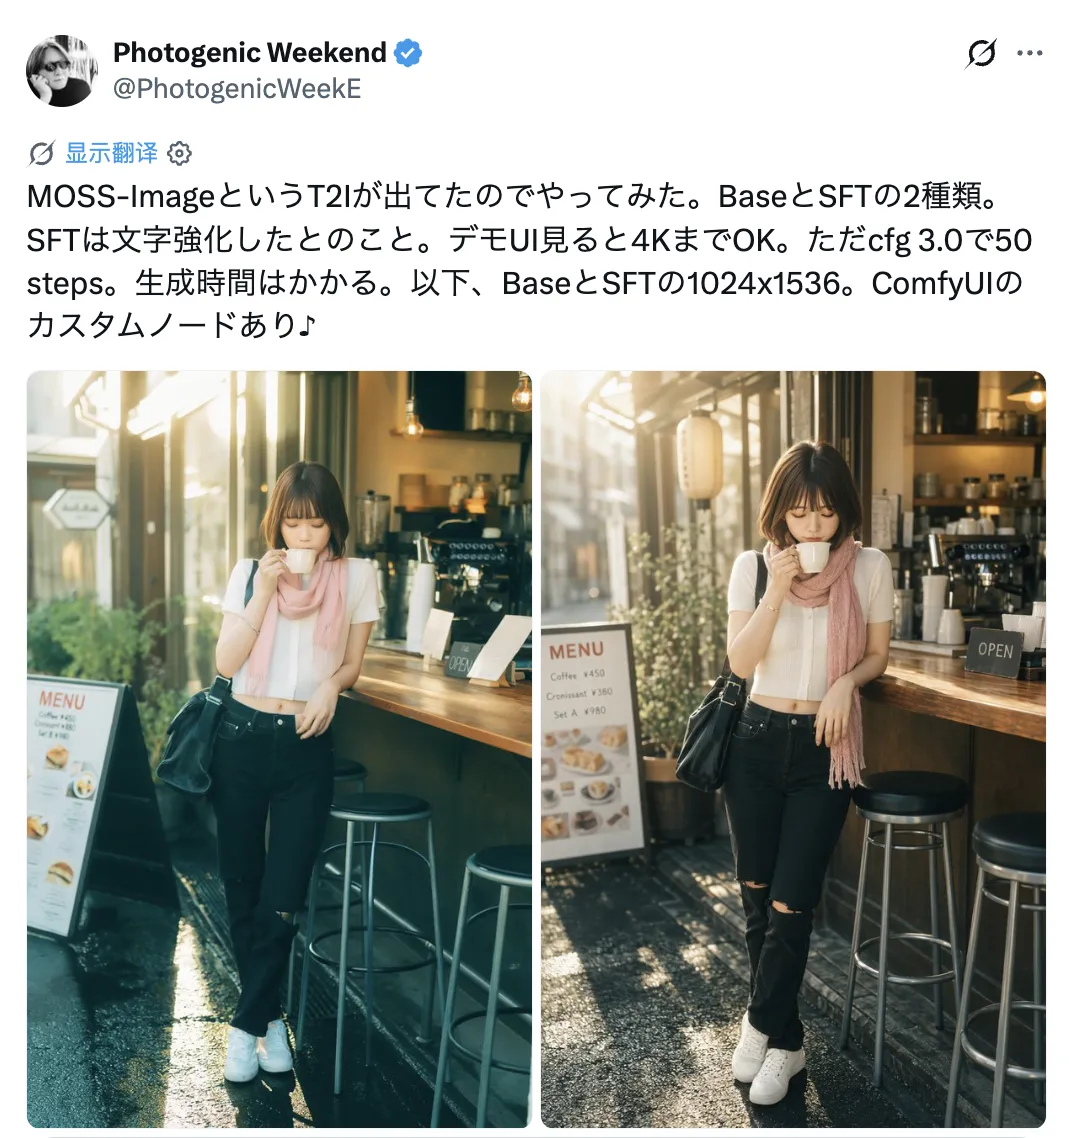
左右滑动查看更多(截图来源于网络)
上海科创集团作为耐心资本,秉持“投早、投小、投长期、投硬科技”核心理念,围绕新质生产力与国产自主可控双主线,聚焦算力底座、基模与Infra、具身智能和AI4S四大方向。算力底座领域重点布局云端算力、存储控制、网络交换与连接、端侧推理,优先投资具备核心自主IP和量产能力的AI芯片团队。基模与Infra领域重点布局全模态交互基座模型、Harness Engineering以及推理优化引擎,优先投资具备底层基础模型研发能力、形成规模化商业闭环的平台型团队。具身智能领域重点布局核心零部件、具身大脑模型,优先投资具身大脑新型研发机构和拥有真实场景订单的团队。AI4S领域重点布局AI蛋白酶设计、AI创新药设计、AI辅助芯片设计、AI材料研发、跨尺度AI物理场仿真等重塑基础科研范式的平台,优先投资具备自主底层算法研发与干湿闭环验证体系的团队。
来源:模思智能