ARTICLE · 1230617
VERL 源码精读 10:做一个总体的小结吧
VERL 源码精读 10:做一个总体的小结吧VERL 源码精读这块儿也有一段时间没写了,之后全部写完也不知得什么时候了。但是有一个问题在于,读源码的话,一次只能关注到很小的一部分内容,更多时候有可能会拘泥在一些实现的细节上。 那么,VERL这个框架他到底做了什么呢?他的优势是什么呢? 今天我们来好好梳理一下这件事情,希望能加深一些对VERL设计理念的理解。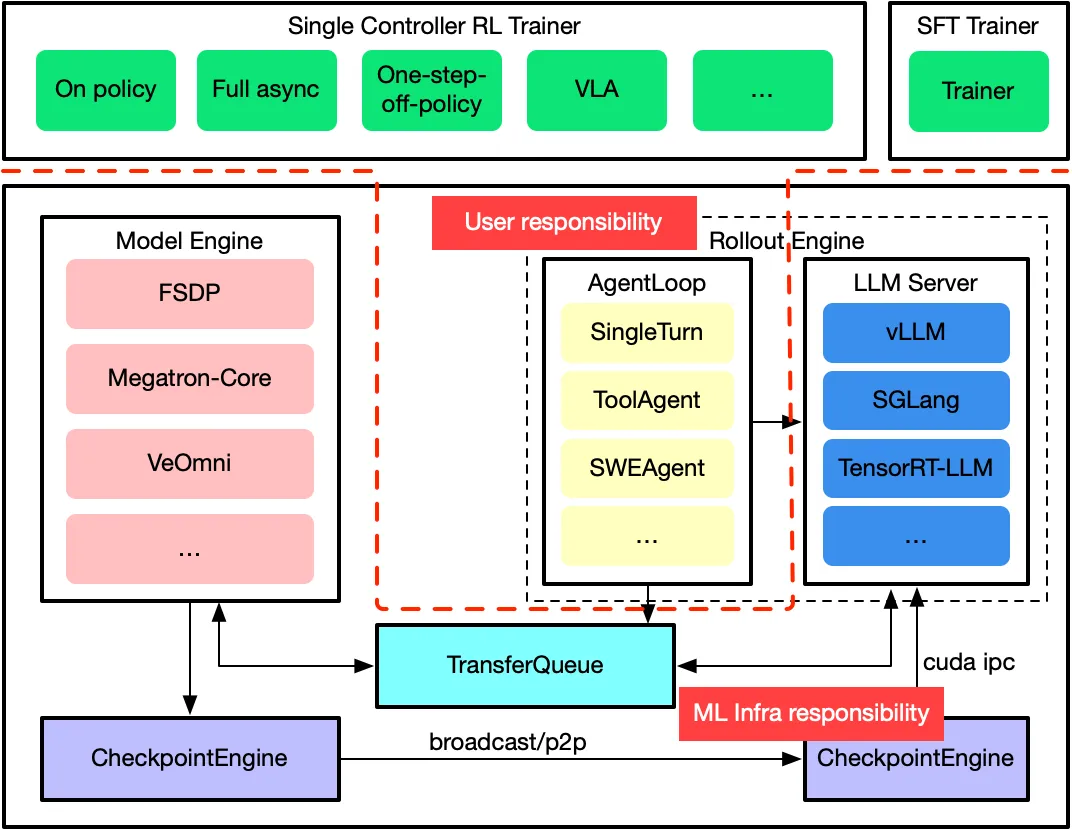
VERL到底解决了一个什么样的问题? LLM的RL训练不是普通的RL:同时要管理多个大模型(actor、ref、critic/reward、rollout 推理引擎),数据流很复杂 ——生成(rollout)→ 打分(reward)→ 更新(train)→ 同步。框架设计面临一对矛盾: 灵活这件事情其实就是对应着单控制器范式和多控制器范式的各自优缺点:
单控制器就是把RL训练的过程从选取数据、Rollout、得到Reward、计算优势、Loss回归这一串事情,排成顺序依次进行,全局只有一个中心控制进程,由他去下发任务、协调各个计算阶段的顺序。Worker只负责执行、返回结果,没有自己独立的循环调度逻辑。优点当然是流程直观,修改算法很轻松,调试也很清晰。可是缺点呢?所有阶段之间的调度、数据流转都需要经过这个中心进程,集群很大的时候,调度消息、来回传数据的开销直接爆炸,吞吐压根上不去。 多控制器则是让每个计算组件/每个WorkerGroup自带独立控制器。让每个组件的内部自己管理分布式并行(TP、DP、FSDP、collective通信)。组件之间通过硬编码的同步、队列、数据依赖来配合,是没有统一的全局调度的。优点自然是避免了单点调度的瓶颈,让大规模并行的吞吐变高。缺点则是:控制流和计算会会深度绑定,例如,如果想换一个RL算法(比如从PPO换成GRPO),需要修改多个组件之间的同步逻辑,改起来是非常麻烦,不同的后端(vLLM、FSDP、Megatron)之间很难无缝互换。 HybridFlow 的答案:控制流与计算流解耦 我们先区分一下控制流和计算流: 将控制流和计算流结构后,改算法就只需要修改控制流,而做性能优化就只需要动计算流,互相不干扰。 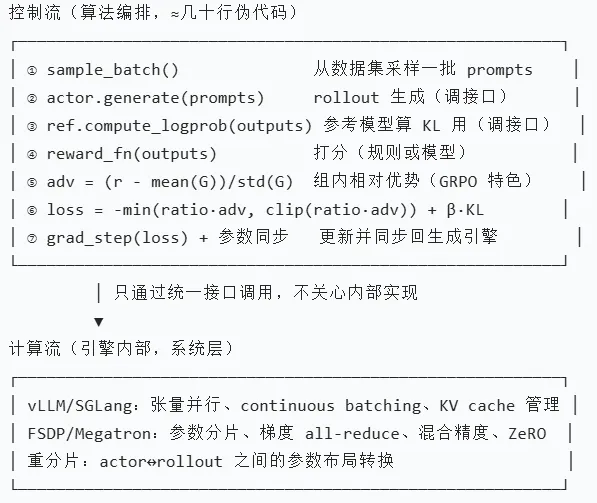
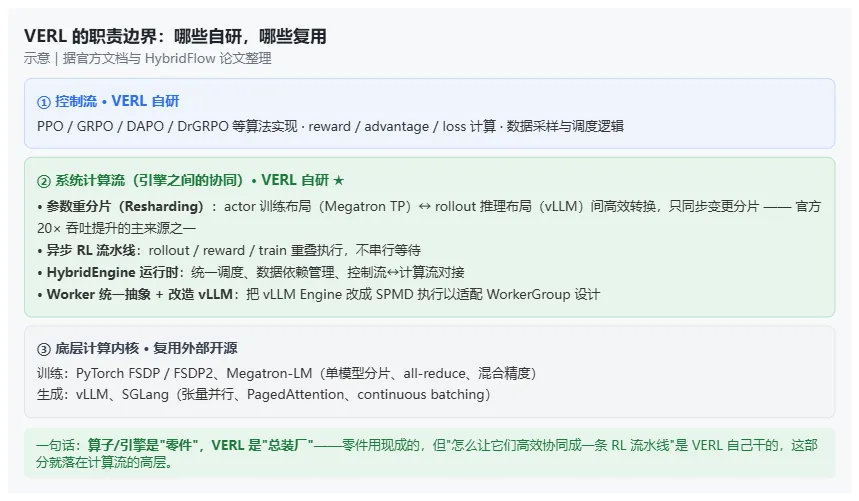
而后,在图中计算流中的参数重分片和异步RL流水线等则是VERL在高效上所做出的优化。 我们从核心抽象:Worker说起。每个 worker 封装一类模型计算,对外暴露统一接口(
数据流在多个Worker之间流转。以一个GRPO step的数据流为例: 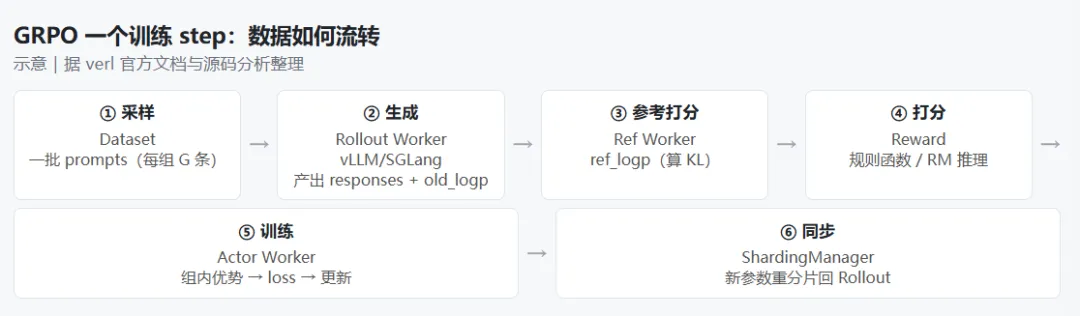
在这样的流程中,为什么需要参数的重分片?这是因为,actor 训练时的参数布局(FSDP 参数分片 / Megatron 张量并行切分)和 rollout 推理时的布局(vLLM 自己的并行布局)不一致,不能直接拷给生成引擎。 意思就是说,同一个模型参数,在训练时和推理时的“摆放方式”是完全不一样的: 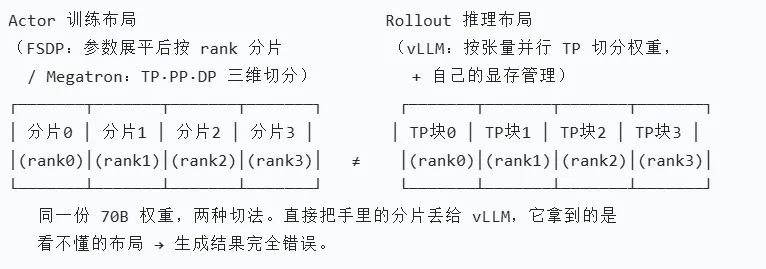
然后我们用一小段话简单把异步流水线也概括一下: 这里,VERL 最核心的设计脉络也就清晰了。它并没有去强行选择单控制器或者多控制器其中一条路,而是用 HybridFlow 做了一层优雅的折中:把算法编排的控制流抽出来交给单控制器,换取算法迭代的灵活性;把各个模型组件的分布式计算流留给自带并行能力的 Worker,保住大规模训练的吞吐上限。 所有 Worker 收敛到统一接口,上层控制流只关心 rollout、打分、训练的先后逻辑,不用被底层 FSDP、vLLM 的并行细节绑架;而参数重分片、分片增量同步、异步流水线这些能力,又是专门为 LLM RL 里训练 - 推理两套布局割裂、生成阶段容易出长尾气泡的痛点量身定做的。 换个角度看,VERL 的定位本质上不是又一套从零写的 RL 算法实现,而是一套适配大模型异构计算后端的 RL 编排底座。GRPO、DAPO、PPO 这些算法,只是跑在这个底座之上、由顶层控制流描述的业务流程。以后再读源码,就不必一头扎进某一处通信、某一段权重拷贝的细节里迷失方向了:先分清哪一部分属于控制流的调度逻辑,哪一部分属于 Worker 内部的计算流实现,再顺着这个分层框架往下追溯,很多细碎实现的用意一下子就能对上。 当然,这套设计也不是没有取舍:异步带来的 stale 权重、跨引擎重分片的额外通信开销、不同后端对齐时的适配成本,都是它需要去权衡的代价。但正是这套控制与计算解耦的思路,让它能同时接住两个很难兼顾的需求 —— 既能像轻量脚本一样快速上新 RL 变种,又能扛住几十 B 大模型集群训练的效率要求。 下面有几个简单的小巩固题,感兴趣的可以看看hhh: Q4(单选) 训练 70B 模型的 GRPO,关于训练后端选择,最合理的说法是? A. 只能选 Megatron,FSDP 撑不起 70B B. FSDP/FSDP2 适合研究和快速原型,Megatron-LM 更适合追求大规模可扩展性 C. vLLM 是最佳训练后端,因为生成吞吐最高 D. 训练后端的选择对最终吞吐没有任何影响
要灵活:算法迭代极快(GRPO、DAPO、PRIME 隔几个月就冒出来),改训练流程要像改伪代码一样容易; 要高效:模型动辄几十上百 B 参数,吞吐差一点,训练成本就爆炸。
- 控制流:
(算法逻辑:rollout → reward → train → sync 怎么编排)→ 用单控制器:基于 Ray 的一个进程,改算法像改脚本,只需要管算法控制,决定执行流程的顺序,什么时候要调用rollout、什么时候算reward、什么时候更新actor; - 计算流:
(每个模型的分布式计算、并行切分)→ 用多控制器:各引擎(FSDP/Megatron 训练、vLLM/SGLang 生成)独立高效并行。实际上就是我们之前在源码中看见的各种Worker,内部是分布式的执行:模型分片、tensor并行等等。与算法逻辑的控制流是解耦开来。
generate、compute_log_prob、update 等)。控制流只面向接口编程。| Rollout Worker | |||
| Ref Worker | |||
| Actor Worker | |||
| Critic Worker | |||
重分片就是在两种布局之间做一次 "布局感知的搬运",分为三步:
- 收集:把训练布局下散在各卡的分片聚合成完整权重(all-gather);
- 重切:按 vLLM 的 TP 布局重新切分;
- 推送:把新布局的权重送到 rollout 引擎。
两个关键优化(也是 VERL 关键价值的体现):
- 只同步变更的分片
训练一步只更新了一部分参数,就把这一部分转换推送,而不是整份 70B 拷来拷去 —— 通信量大幅下降; - 异步执行
推送在后台进行,训练不必等同步完成再跑下一步 ——这正好和 E(异步流水线重叠)是同一个机制:rollout 用旧参数跑的同时,新参数在后台到达,下一步无缝接上。
VERL 异步流水线是为了解决同步 RL 里 rollout 长尾带来的 GPU 空闲气泡,核心思路是把 rollout 生成和 actor 训练时间重叠。分两种:
1、one-step-off 保持只有一步权重滞后,稳定性接近 on-policy,改动小;
2、fully async 把 rollout 和 trainer 拆成独立资源池、队列流式传输,用 staleness 阈值约束权重滞后,适合长推理任务。
这一套异步调度是 HybridFlow 顶层单控制器提供的能力,底层 SPMD 计算 worker 完全不用改动。所以 VERL 可以同一个底层计算引擎,随时切换同步 /one-step/fully async 调度。
Q1(单选)
重分片(Resharding)主要解决什么问题?
A. 压缩模型体积以节省显存
B. 在训练布局和推理布局之间转换参数,并只同步变更的分片
C. 把训练好的模型导出成标准推理格式文件
D. 降低 reward 计算的延迟
Q2(单选)
以下说法正确的是?
A. 重分片属于控制流层面的算法修改
B. 异步参数同步意味着训练 step 不需要等参数完全同步完就可以继续
C. 重分片每次都需要把全部参数完整拷贝一遍
D. vLLM 和 FSDP 的参数布局天然一致,无需转换
Q3(多选)
以下属于 "计算流" 范畴的是?
A. advantage 的计算公式
B. 参数重分片
C. 异步流水线重叠
D. vLLM 内部的批处理调度
E. reward 函数的实现逻辑