ARTICLE · 1232590
Linux 6.12 源码深度剖析: tasklet_action
Linux 6.12 内核源码深度剖析:tasklet_action 与软中断延迟执行机制
1. 📌 技术点速览
在 Linux 内核中,tasklet_action 是软中断(Softirq)机制中负责处理 TASKLET_SOFTIRQ 类型的核心执行入口。它处于内核中断处理的下半部(Bottom Half, BH),属于 CoreKernel (内核核心服务) 模块。
tasklet_action 主要解决以下核心问题:
降低中断延迟:将硬中断(Top Half)中非即时、耗时的操作延迟到软中断(Bottom Half)中执行,确保硬中断能快速响应后续的硬件信号。
提供单 CPU 串行化保证:确保同一个 Tasklet 实例在同一时刻只能在一个 CPU 上运行,简化了驱动程序并发控制的复杂度。
现代内核的承前启后(Linux 6.12 特性):在 Linux 6.12 中,
tasklet_action不仅负责传统的 Tasklet 链表消费,还作为新型 BH 工作队列(Bottom Half Workqueues)的驱动引擎,承载了内核逐步淘汰传统 Tasklet、向工作队列统一化演进的历史使命。
2. 🗺️ 软件功能架构图
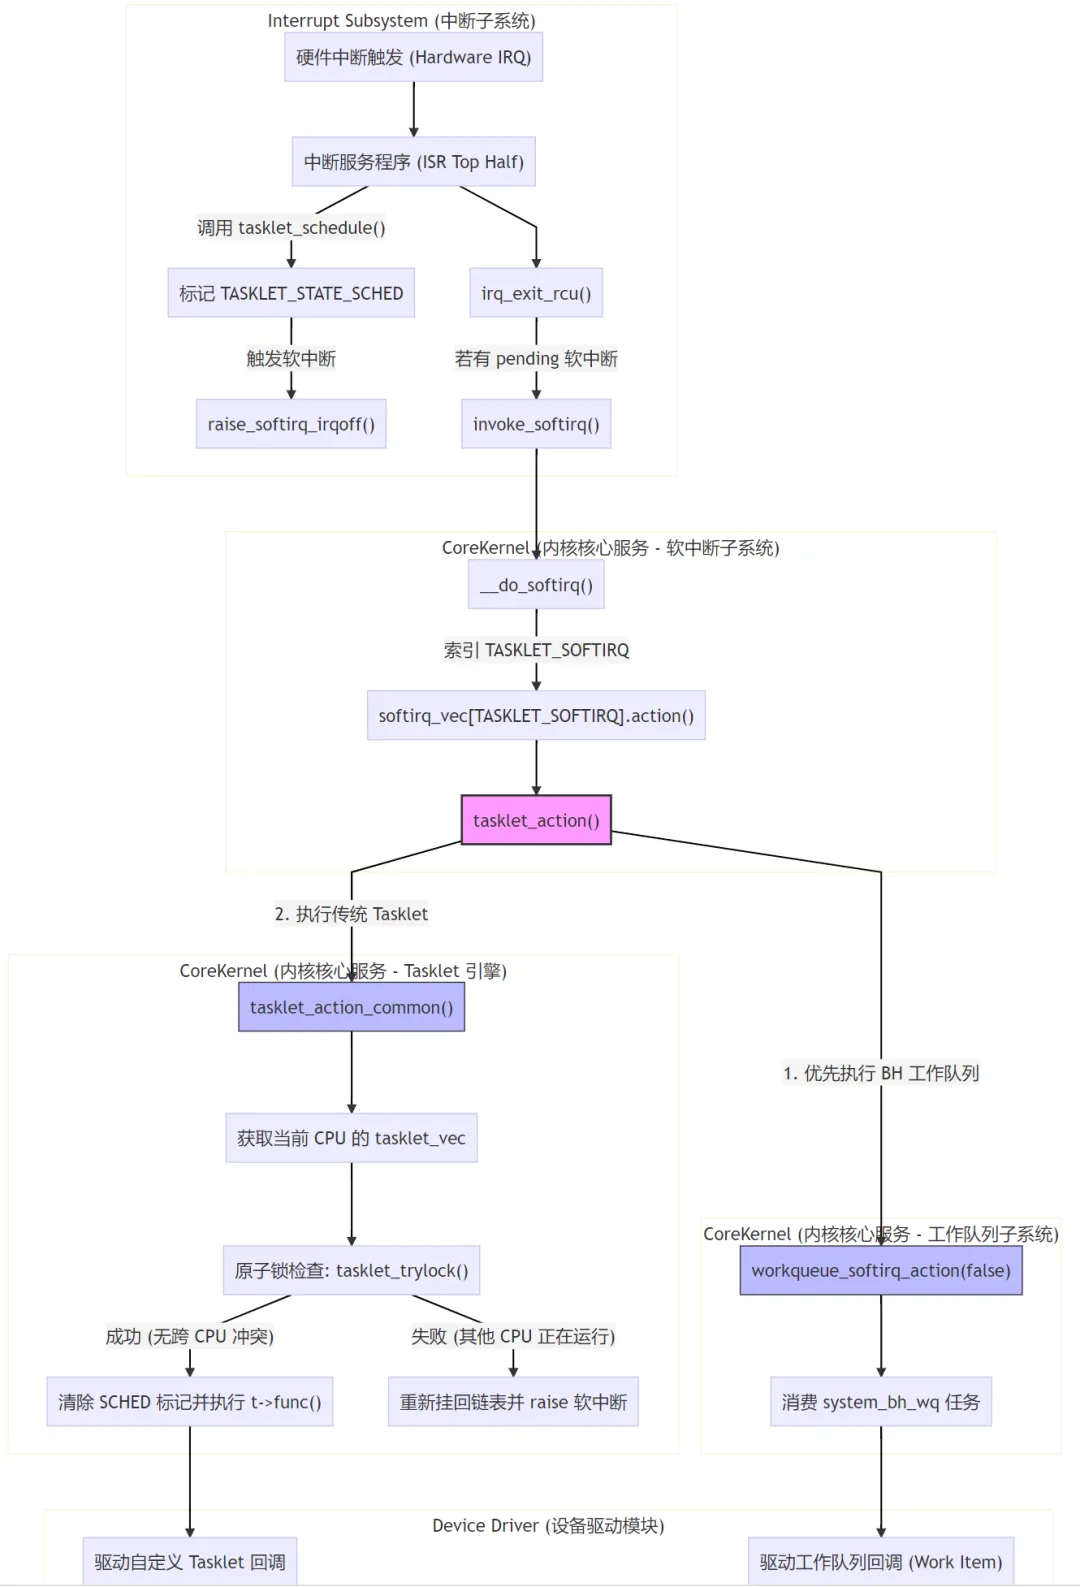
下图展示了从硬件中断触发,到 CoreKernel 软中断子系统分发,再到 tasklet_action 执行传统 Tasklet 与现代 BH 工作队列的完整架构与跨模块调用关系:
3. 🔍 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 源码中,tasklet_action 及其核心实现函数 tasklet_action_common 位于 kernel/softirq.c。以下是该机制的硬核源码剖析。
3.1 tasklet_action 入口函数
/* 源码路径: kernel/softirq.c */static __latent_entropy void tasklet_action(void){/** 1. [跨模块调用] 优先执行 Bottom Half (BH) 工作队列。* 这是 Linux 6.12 (以及近期内核) 的重大变革。* 为了逐步淘汰 tasklet,内核引入了基于工作队列的 BH 机制。* 参数 false 表示当前不是高优先级 (HI_SOFTIRQ) 路径。*/workqueue_softirq_action(false);/** 2. 执行传统的 Tasklet 链表。* this_cpu_ptr(&tasklet_vec) 获取当前 CPU 专属的 tasklet 链表头。* TASKLET_SOFTIRQ 表示当前处理的是普通优先级的 tasklet 软中断。*/tasklet_action_common(this_cpu_ptr(&tasklet_vec), TASKLET_SOFTIRQ);}
软件模块核心职责解析:
workqueue_softirq_action(false)的引入,体现了 CoreKernel 内部“工作队列子系统”对“软中断子系统”的寄生与融合。内核开发者希望通过这种方式,在不改变现有中断底半部响应延迟的前提下,提供统一的、可调试性更强的工作队列接口。
3.2 tasklet_action_common 核心循环体
tasklet_action_common 是 Tasklet 机制的灵魂所在。它通过精妙的无锁/原子操作设计,既保证了高性能,又实现了“同一 Tasklet 绝不跨 CPU 并发”的严格约束。
/* 源码路径: kernel/softirq.c */staticvoidtasklet_action_common(struct tasklet_head *list, unsignedint softirq_nr){struct tasklet_struct *list_head;/** 1. 临界区保护:关闭本地 CPU 中断。* 必须关闭中断以防止当前 CPU 的硬中断抢占,* 因为硬中断处理程序中可能会调用 tasklet_schedule() 往当前 list 中添加新节点。*/local_irq_disable();/* 将当前 CPU 的 tasklet 链表一次性整体取出,存入局部变量 list_head */list_head = list->head;/* 清空当前 CPU 的 tasklet 链表,以便后续硬中断可以继续往里添加新的 tasklet */list->head = NULL;list->tail = &list->head;/* 恢复本地 CPU 中断。Tasklet 的具体回调函数是在开中断状态下执行的,避免阻塞硬中断 */local_irq_enable();/* 2. 遍历并消费取出的 Tasklet 链表 */while (list_head) {struct tasklet_struct *t = list_head;list_head = list_head->next;/** 3. 核心并发控制:尝试获取 Tasklet 的运行锁。* tasklet_trylock(t) 内部通过 test_and_set_bit(TASKLET_STATE_RUN, &t->state) 实现。* 如果该 Tasklet 已经在其他 CPU 上运行,此处 trylock 将失败。*/if (tasklet_trylock(t)) {/** 4. 检查 Tasklet 是否被禁用。* t->count 为 0 表示启用状态;大于 0 表示被 disable_tasklet() 禁用了。*/if (!atomic_read(&t->count)) {/** 5. 清除 SCHED 状态位。* tasklet_clear_sched(t) 内部执行 test_and_clear_bit(TASKLET_STATE_SCHED, &t->state)。* 只有清除成功,才意味着该 Tasklet 真正进入执行阶段,后续才可以被重新 schedule。*/if (tasklet_clear_sched(t)) {/* 执行驱动注册的实际回调函数 */t->func(t);}/* 释放运行锁:clear_bit(TASKLET_STATE_RUN, &t->state) */tasklet_unlock(t);continue;}/* 如果被禁用,则释放运行锁,并准备将其重新挂回链表 */tasklet_unlock(t);}/** 6. 冲突处理与重新排队。* 走到这里只有两种情况:* a. tasklet_trylock(t) 失败:说明该 Tasklet 正在另一个 CPU 上运行。* b. t->count != 0:说明该 Tasklet 当前被禁用了。* 为了不丢失这次调度,必须将该 Tasklet 重新挂回当前 CPU 的 tasklet_vec 链表尾部。*/local_irq_disable();t->next = NULL;*list->tail = t;list->tail = &t->next;/* 重新触发软中断,确保下一次软中断循环中继续尝试执行该 Tasklet */__raise_softirq_irqoff(softirq_nr);local_irq_enable();}}
3.3 核心无锁状态机解析
Tasklet 的状态管理仅依赖 t->state 的两个 Bit 位:
TASKLET_STATE_SCHED(Bit 0):表示该 Tasklet 已被调度,正在等待执行。TASKLET_STATE_RUN(Bit 1):表示该 Tasklet 正在某个 CPU 上运行(仅在多核 SMP 系统下有效)。
/* 状态转换伪代码逻辑 */void tasklet_schedule(struct tasklet_struct *t) {if (!test_and_set_bit(TASKLET_STATE_SCHED, &t->state)) {// 只有之前未被 SCHED 时,才加入 per-CPU 链表并 raise 软中断__tasklet_schedule(t);}}
在 tasklet_action_common 中:
tasklet_trylock(t)确保了同一时刻只有一个 CPU 能执行该 Tasklet。如果 CPU_A 正在运行 Tasklet_X(此时
RUN位被置 1),此时硬件中断在 CPU_B 上触发并调度了同一个 Tasklet_X(SCHED位被置 1)。当 CPU_B 执行到
tasklet_action_common时,tasklet_trylock发现RUN位已被 CPU_A 占用,于是 trylock 失败,CPU_B 将 Tasklet_X 重新放回自己的本地链表,并再次触发软中断。这种设计避免了驱动开发者在 Tasklet 回调函数中编写复杂的重入锁逻辑,但同时也引入了严重的 CPU 间排队和软中断风暴隐患(见第 5 节)。
4. ⚙️ 系统运行背景与上下文
tasklet_action 并非孤立运行,它处于内核三大核心子系统(中断、调度、内存)的交汇处。
4.1 跨模块协同工作流
中断子系统 -> 核心内核 (CoreKernel): 当网卡或存储设备产生硬件中断,CPU 跳转到中断向量表,执行驱动的硬中断处理程序(Top Half)。驱动程序完成寄存器读写后,调用
tasklet_schedule(&my_tasklet)。该函数属于CoreKernel的软中断模块,它将my_tasklet挂入当前 CPU 的tasklet_vec,并向 CPU 的pending寄存器写入TASKLET_SOFTIRQ标志。核心内核 (CoreKernel) 内部演转: 硬中断退出时,
irq_exit_rcu()被调用。内核检查当前 CPU 是否有未处理的软中断。如果有,则调用invoke_softirq()。在非强制线程化(Threaded IRQ)的情况下,这会直接在当前中断上下文中调用__do_softirq()。软中断子系统 -> 调度器子系统 (Scheduler):
__do_softirq()循环遍历 pending 位,发现TASKLET_SOFTIRQ被置位,进而调用softirq_vec[TASKLET_SOFTIRQ].action(),即tasklet_action()。调度器介入:如果
__do_softirq()执行时间过长(默认超过 2ms)或者循环次数过多(超过 10 次),为了防止用户态任务饿死,软中断子系统会退出,并唤醒当前 CPU 的专属内核线程ksoftirqd/X(由调度器管理,优先级为 SCHED_OTHER)。剩余的 Tasklet 将在
ksoftirqd线程上下文中继续由tasklet_action()消费。软中断子系统 -> 工作队列子系统 (Workqueue): 在 Linux 6.12 中,
tasklet_action()内部首先调用workqueue_softirq_action(false)。这使得工作队列子系统能够借用软中断的上下文来执行底半部工作项(BH Work Items)。这种跨模块的调用,使得内核可以在不创建额外内核线程的情况下,获得工作队列的灵活性(如支持统一的destroy_workqueue、更优雅的并发控制)。
5. 💡 10年老兵避坑指南/实战案例
Tasklet 机制由于其历史悠久,设计上存在诸多“历史包袱”。在现代多核、高吞吐的生产环境中,不当使用 Tasklet 极易引发灾难性故障。
5.1 避坑 1:Tasklet 自循环死锁与 ksoftirqd CPU 100% 暴涨
💥 真实生产案例
某自研 PCIe 加速卡驱动,在 Tasklet 回调函数中,因为要等待硬件状态寄存器就绪,采用了“若未就绪则重新调用 tasklet_schedule() 挂起自身,等待下一次执行”的设计。 在高负载下,硬件状态更新变慢,导致该 Tasklet 在回调中频繁自调度。
🛑 灾难后果
由于 Tasklet 频繁自调度,当前 CPU 的 tasklet_vec 永远不为空。这导致 __do_softirq() 达到运行时间上限,将执行权移交给 ksoftirqd/X。 随后,ksoftirqd/X 线程 100% 占用该 CPU,导致绑定在该 CPU 上的用户态关键业务线程(如 Nginx 工作进程、数据库实例)出现严重的延迟抖动,甚至被系统判定为饥饿而触发 OOM 或 Watchdog 复位。
🛠️ 调优与排查方法
使用 ftrace 抓取软中断执行时长:
# 开启 trace 抓取echo 1 > /sys/kernel/debug/tracing/events/irq/softirq_entry/enableecho 1 > /sys/kernel/debug/tracing/events/irq/softirq_exit/enablecat /sys/kernel/debug/tracing/trace_pipe | grep TASKLET如果发现
TASKLET_SOFTIRQ的entry和exit之间的间隔极短,但频繁交替出现,且ksoftirqd占用率极高,即可断定存在 Tasklet 自调度风暴。重构代码(终极解决方案)
绝对不要在 Tasklet 回调函数内部无条件地重新调度自身。在 Linux 6.12 中,应当将此类逻辑迁移至 Threaded IRQ 或 BH Workqueue。
迁移至 Threaded IRQ 示例:
/* 传统做法 */// irqreturn_t my_handler(int irq, void *dev_id) {// tasklet_schedule(&my_tasklet);// return IRQ_HANDLED;// }/* Linux 6.12 推荐做法:线程化中断 */irqreturn_tmy_threaded_handler(int irq, void *dev_id){/* 在这里可以安全地睡眠、等待寄存器、使用 mutex 锁 */while (!hardware_ready()) {msleep(1); // 允许睡眠,绝不阻塞 CPU}return IRQ_HANDLED;}// 注册时使用 request_threaded_irqrequest_threaded_irq(irq, my_top_half, my_threaded_handler, IRQF_SHARED, "my_device", dev_id);
5.2 避坑 2:多核 SMP 下的“重排队风暴”(Re-queueing Storm)
💥 故障机制剖析
正如 3.3 节所述,Tasklet 保证单 CPU 串行化。 假设 Tasklet_A 绑定在某个全局结构体中。
CPU_0正在执行Tasklet_A的回调函数func,这需要消耗 500 微秒。在这 500 微秒期间,
CPU_1、CPU_2、CPU_3同时收到了硬件中断,并且都调用了tasklet_schedule(&Tasklet_A)。当
CPU_1进入tasklet_action_common时,tasklet_trylock失败(因为CPU_0还没释放锁)。CPU_1只能将Tasklet_A重新挂回自己的tasklet_vec尾部,并调用__raise_softirq_irqoff。CPU_2和CPU_3同样如此。结果:
CPU_1、CPU_2、CPU_3陷入了“触发软中断 -> 进入tasklet_action-> trylock 失败 -> 重新挂载 -> 再次触发软中断”的死循环风暴。
这会导致系统整体 CPU 利用率虚高,而实际有效吞吐量极低。
🛠️ 解决方案
避免全局单例 Tasklet: 如果设备支持多队列(如多队列网卡 RSS),应当为每个队列(每个 CPU)分配独立的
tasklet_struct,避免跨 CPU 竞争同一个 Tasklet 锁。向 Linux 6.12 的 BH Workqueue 靠拢: BH Workqueue 内部通过更精细的队列管理和工作项分发机制,避免了这种由于“锁冲突导致频繁重新排队”的低效设计。
使用 Linux 6.12 BH Workqueue 改造旧驱动:
#include<linux/workqueue.h>/* 定义 BH 工作项 */struct work_struct my_bh_work;voidmy_bh_work_handler(struct work_struct *work){/* 相当于原先的 tasklet 回调,但运行在更现代的 BH 工作队列上下文中 */}/* 初始化 */INIT_WORK(&my_bh_work, my_bh_work_handler);/* 在硬中断中调度 */irqreturn_tmy_hardware_irq(int irq, void *dev_id){/** queue_work() 将任务放入 system_bh_wq。* 在 Linux 6.12 中,它会直接映射到 workqueue_softirq_action 执行,* 拥有与 tasklet 完全一致的低延迟,但并发控制更优秀。*/queue_work(system_bh_wq, &my_bh_work);return IRQ_HANDLED;}
5.3 避坑 3:Tasklet 回调中的“隐式睡眠”引发系统崩溃
💥 致命错误
Tasklet 运行在中断上下文(Interrupt Context)中,这意味着它绝对不能睡眠。 很多开发者在将代码从用户态移植到内核态,或者从工作队列移植到 Tasklet 时,不小心在 Tasklet 回调中调用了可能导致睡眠的函数,例如:
mutex_lock()msleep()/ssleep()kmalloc(..., GFP_KERNEL)(GFP_KERNEL可能会导致进程休眠以等待内存释放)
🛑 灾难后果
一旦在 Tasklet 中发生睡眠,内核的调度器(Scheduler)会尝试进行上下文切换。由于中断上下文没有对应的 task_struct 进程实体,内核会直接触发 Bug: scheduling while atomic,导致系统 Panic(蓝屏/死机)。
🛠️ 避坑准则
严格代码审查:在 Tasklet 回调中,申请内存必须使用
GFP_ATOMIC标志。锁的选择:只能使用
spinlock_t,绝对不能使用mutex_t或semaphore。静态代码分析:使用内核提供的
sparse工具或coccinelle脚本进行静态检查。动态检测:在编译内核时,开启
CONFIG_DEBUG_ATOMIC_SLEEP。这样一旦在中断上下文中发生睡眠,内核会立即打印出详细的调用栈,帮助开发者在测试阶段定位问题。