ARTICLE · 1234414
Mask R-CNN 源码精读:去掉两次取整就多挣 7 个点,ICCV 2017 最佳论文怎么把实例分割做简单
2017 年 10 月威尼斯,ICCV 开幕式上把当年的 Marr Prize(最佳论文奖)颁给了 Facebook 人工智能研究院的 Mask R-CNN,作者四个人:何恺明、Georgia Gkioxari、Piotr Dollár、Ross Girshick。官方开幕幻灯片的下一页写着同届的最佳学生论文 Focal Loss,同样出自这个小组。九年后这篇论文仍是实例分割的默认起点,官方 Detectron 和 Detectron2 代码维护至今。我把论文第三版和 Detectron2 的实现读了一遍。
01 先看结论
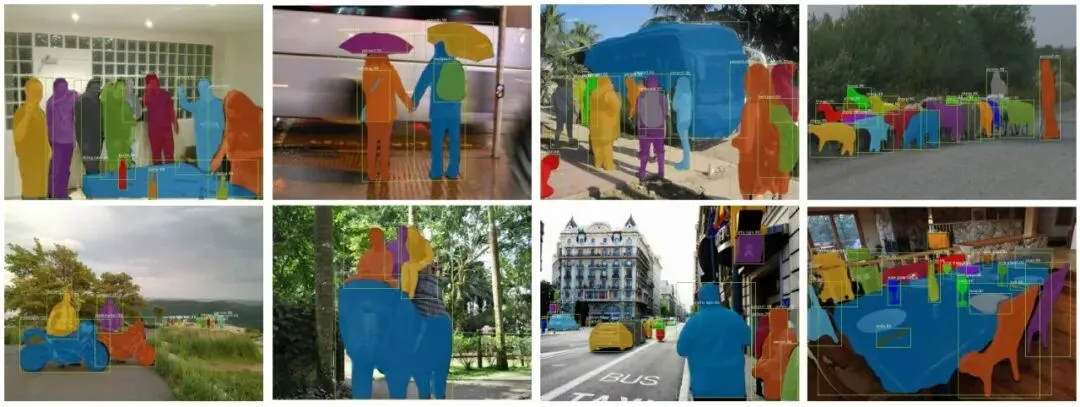
Mask R-CNN 解决实例分割的办法直白到不像获奖论文:在 Faster R-CNN 的每个 RoI 上并行加一条掩码分支,检测框和像素掩码共用一套特征。真正决定成败的是两处不起眼的修改——RoIAlign 把特征池化里的坐标取整去掉,掩码损失改成每类一个 sigmoid。
数字上,COCO test-dev 单模型掩码 AP 做到 37.1(ResNeXt-101-FPN),不加多尺度、不加 OHEM 就压过了 2016 年赛事冠军 FCIS+++ 的 33.6;消融里 ResNet-50-C5 的大步长特征上,把 RoIPool 换成 RoIAlign,掩码 AP 从 23.6 涨到 30.9,7.3 个点直接由对齐贡献。
停在哪:这是 2017 年的两阶段框架,锚框和 RPN 超参沿袭旧工作;掩码在 28×28 上生成再上采,边界粗是结构性的。想看代码只看一个函数:detectron2/modeling/roi_heads/mask_head.py 的 mask_rcnn_loss,论文 3.2 节的损失定义逐句落在这二十来行里。
02 问题背景
语义分割和目标检测在 2017 年前各走各路:FCN 一类逐像素分类,分得清类别分不开实例;检测器框得准画不出边。把两者拼起来的方案不少,SDS 从检测框出发抠掩码,DeepMask 走稠密打分,FCIS 把实例感知做成端到端并在 COCO 2016 拿了冠军——但论文给它的评价是带多尺度、加 OHEM 的重工程,赢在包装。
真正的坑藏在 RoIPool 里。这个操作把连续坐标的 RoI 映射到特征网格时做两次取整:RoI 边界取整一次,bin 划分再取整一次。在 stride 16 的特征图上,半格就是原图上的 8 个像素;步长拉到 32 时错半格等于原图错 16 个像素。框分类对这种偏差无感,因为分类靠的是整体特征;像素级的掩码预测被平移了这么多像素,边就描不齐了。
掩码损失也有个隐性问题。FCN 的惯例是逐像素 softmax 加多项交叉熵,类与类之间在竞争。检测分支已经把类别预测得很好了,掩码分支再竞争一次属于重复劳动,还会互相干扰。
03 方法拆解
主线一条:让 RoI 的特征对准像素,再让掩码和类别各管各的。
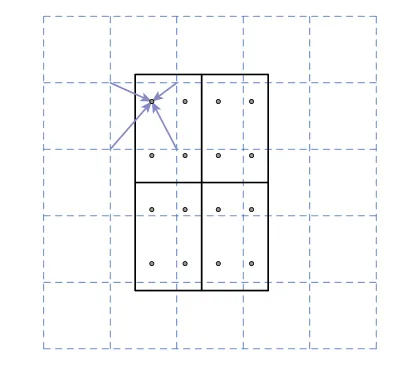
第一个设计是 RoIAlign。RoI、bin、采样点,所有涉及坐标的地方一律不取整;每个 bin 里取四个采样点,每个点从邻近网格点双线性插值出来,bin 内取最大或平均。位置准了,后面的小 FCN 才谈得上像素到像素。
第二个设计是掩码与类别解耦。掩码分支是每个 RoI 过一个小 FCN,输出 K 个类的二值掩码,每个 m×m,论文取 m=28。损失对每个像素过 sigmoid,定义成平均二元交叉熵;某个 RoI 的真值类别是 k,损失只在第 k 个掩码上算,其余 K−1 个输出不进损失。类别交给分类分支去判。
公式就是三块相加:L = Lcls + Lbox + Lmask。三个量:Lcls 和 Lbox 照搬 Fast R-CNN 的定义;Lmask 只在正样本 RoI 上定义,目标是 RoI 与真值掩码的交集区域。没有第四项,没有辅助损失。
04 源码对照
先走调用链。配置 configs/COCO-InstanceSegmentation/mask_rcnn_R_50_FPN_3x.yaml 继承 Base-RCNN-FPN,MASK_ON 打开;推理从 meta_arch/rcnn.py 进,StandardROIHeads 把 box 分支和 mask 分支并起来;掩码特征先由 modeling/poolers.py 的 ROIPooler 池化,池化算子在 layers/roi_align.py,底层调 torchvision 的 roi_align。
第一处对读:论文 3.2 节「Lmask 只定义在第 k 个掩码上,逐像素 sigmoid,平均二元交叉熵」,对应 mask_head.py 的 mask_rcnn_loss:
indices = torch.arange(total_num_masks)gt_classes = cat(gt_classes, dim=0)pred_mask_logits = pred_mask_logits[indices, gt_classes]...mask_loss = F.binary_cross_entropy_with_logits(pred_mask_logits, gt_masks, reduction="mean")
第三行是点睛之笔:用每条 RoI 的真值类别索引去挑对应类的 logit,其余 K−1 个类的输出根本不进损失张量——解耦在实现上就是这么一行动态索引。真值掩码由 crop_and_resize 从 polygon 光栅化到与预测同边长,二元交叉熵按均值归约,正好是论文那句话。训练正负样本的口径也照论文:IoU 达 0.5 的算正样本,掩码损失只在正样本上走。
推理侧是同一招的镜像。mask_rcnn_inference 里同样用预测类别去挑通道——pred_mask_logits[indices, class_pred] 过 sigmoid 后写进 pred_masks,放大回原尺寸和阈值二值化按注释留给后处理,对应论文「只用第 k 个掩码、放大到 RoI 尺寸、0.5 二值化」的推理流程。训练挑真值类,推理挑预测类,两个函数各一行索引,前后呼应。
第二处对读:论文 3.1 节的对齐修正,落在 layers/roi_align.py 的 ROIAlign 封装。构造函数默认 aligned=True,注释里写得比论文还细:连续坐标 c 的两个相邻像素索引按 floor(c−0.5) 和 ceil(c−0.5) 算,老实现不减这半个像素,双线性插值时整体偏了半格;aligned=True 先把 RoI 缩放再平移 0.5。再看 poolers.py 的分支:
if pooler_type == "ROIAlign":... aligned=False ...elif pooler_type == "ROIAlignV2":... aligned=True ...
注意这个坑:Detectron2 把论文里的对齐版叫 ROIAlignV2,名字里没有 V2 的 ROIAlign 是老的未对齐实现。论文里的「RoIAlign」,到代码里要找 V2。老一代 Detectron 的 2017 基线配置则直接写 ROI_XFORM_METHOD: RoIAlign,掩码分支 ROI_XFORM_RESOLUTION 14、输出 RESOLUTION 28、SAMPLING_RATIO 2——每 bin 2×2 共四个采样点,正是论文图 3 里的画法。
05 实验配置
论文 4.1 节的训练设置:图片短边缩到 800 像素,长边上限 1333;每 GPU 两张图乘 8 卡,有效 batch 16;FPN 下每图采 512 个 RoI,正负比 1 比 3;160k 次迭代,学习率 0.02,120k 处乘 0.1;权重衰减 0.0001,动量 0.9。RPN 锚点五种尺度三种长宽比,消融实验在 trainval35k 上训、minival 上测。
官方代码的 1x 基线配置(Detectron 的 e2e_mask_rcnn_R-50-FPN_1x.yaml)迭代次数是 90000,步长在 60000 和 80000,学习率与衰减一致;Detectron2 的 3x 配置拉到 270000 步、210000 与 250000 处衰减。论文消融段落里写的 160k 是比官方 1x 更长的一档,属于实验档位选择。
掩码头的结构照论文表 1b:FPN 的 stride-4 特征上 RoIAlign 出 14×14,四层 256 维卷积,反卷积上采到 28×28,再出 K 类掩码。训练一张单机八卡机器一到两天,推理约 200 毫秒一帧;掩码只算在前 100 个框上,比对应的 Faster R-CNN 慢约 20%。
06 结果怎么看
主榜在 COCO test-dev 上:MNC 24.6、FCIS 加 OHEM 29.2、FCIS+++ 33.6,Mask R-CNN 用 ResNet-101-C4 到 33.1,ResNet-101-FPN 到 35.7(同时 5 帧每秒),ResNeXt-101-FPN 到 37.1。同一张表里没开多尺度测试和 OHEM,对比就发生在这些工程手段缺席的前提下。
消融全部在 ResNet-50、minival、掩码 AP 口径下。RoI 层对比:RoIPool 26.9,RoIWarp 加对齐后 27.2,RoIAlign 30.2,聚合用 max 还是平均差 0.1——对齐是唯一大头,AP75 从 26.4 提到 31.8。步长换到 32 的 C5,差距放大:RoIPool 23.6 对 RoIAlign 30.9,掩码 AP 差 7.3,AP75 差 10.5,连检测框 AP 都从 28.2 涨到 34.0——步长越大,错位越狠,修掉之后收益也越大。
掩码头的比较:四层卷积的 FCN 33.6,两层全连接的 MLP 31.5,多一层 1024 维的全连接几乎不涨。逐类 softmax 的替代方案论文也测了,掉点,结论是解耦来自实验而非直觉。
我没有跑,以上数字全部照论文表格照抄。
07 论文与代码
官方代码有两代:Detectron 基于 Caffe2,存放 2017 年那批基线与配置;Detectron2 用 PyTorch 重写,维护至今。作者团队即两套代码的维护者,mask_rcnn_loss 的 docstring 第一句就是「Compute the mask prediction loss defined in the Mask R-CNN paper」,对读零障碍。
命名史值得单独记:Detectron2 里论文的对齐版叫 ROIAlignV2,aligned=False 留了个叫 ROIAlign 的老接口;roi_align.py 里还有一句注释——torchvision 的 RoIAlign 默认 aligned=False,Detectron2 封装时改成 True,并断言 torchvision 版本不低于 0.7。后来 torchvision 把对齐版收成了标准算子,坑才填平。
属于配置选择、不是缺陷的:官方 1x 用 90000 步,论文消融用 160000 步,档位不同;ResNeXt 训练时每 GPU 单图、起始学习率 0.01,是大模型下batch缩小的常规操作。
08 复现路线
最短路径是 Detectron2 的 3x 配置加 train_net.py,八卡两天量级;要贴近论文数字就盯 1x 配置。想跑 2017 年原版得回 Caffe2 环境,不推荐,MODEL_ZOO 里放着当年训好的权重,下来做对照即可。
成功标志以 minival 上的掩码 AP 对齐 MODEL_ZOO 榜单为准,训到中途先看 loss 曲线里 mask_rcnn/accuracy 这个指标,代码里每步都在记。
一个容易看错的地方:改配置时 POOLER_TYPE 选成 ROIAlign(不带 V2)或 ROIPool,训出来掩码 AP 低三到七个点,很容易被当成实现差异排查半天——先查池化算子,再查别的。
09 判断
有证据的价值:这篇论文赢在把两件被忽视的小事做对了。像素任务需要像素对齐,RoIAlign 后来的正名之作进了 torchvision 标准件;类别与掩码解耦让一条骨干同时服务分类和分割,全景分割、级联检测这些后续工作都叠在这套骨架上。
限制也明摆着:两阶段的锚框框架超参多,RPN 的五尺度三比例是沿袭而非设计;28×28 的掩码分辨率让边缘细节先天不足;2017 年的 COCO 数字放到今天的评测协议下不能直接对比,论文自己也没做这个主张。
我的推测,标明是推测:半个像素的对齐在后来的 query 式检测器里换了个形式回来——可学习参考点的特征采样本质上还是对齐问题的解法,这类结构相似性是推断,论文没有这一层论述。