ARTICLE · 1234408
MXCore RTL 源码解读:参数化 Microscaling 矩阵乘法加速器
Microscaling(MX)是 OCP 提出的一类窄位宽格式。
核心思想很直接:一组数据共享一个块缩放因子。
MX 把 32 个元素 编成一组,共享一个 8 位指数型缩放因子。元素只负责“相对精度”,绝对范围交给整组共享的缩放因子承担。
MXCore 是面向这类格式的 HWPE 矩阵乘法加速器。它是一个全参数化框架,围绕自研的 MXDOTP 点积单元构建,目标是把 PE 粒度、数据流、内存带宽 这三件事放进同一个设计空间里探索。
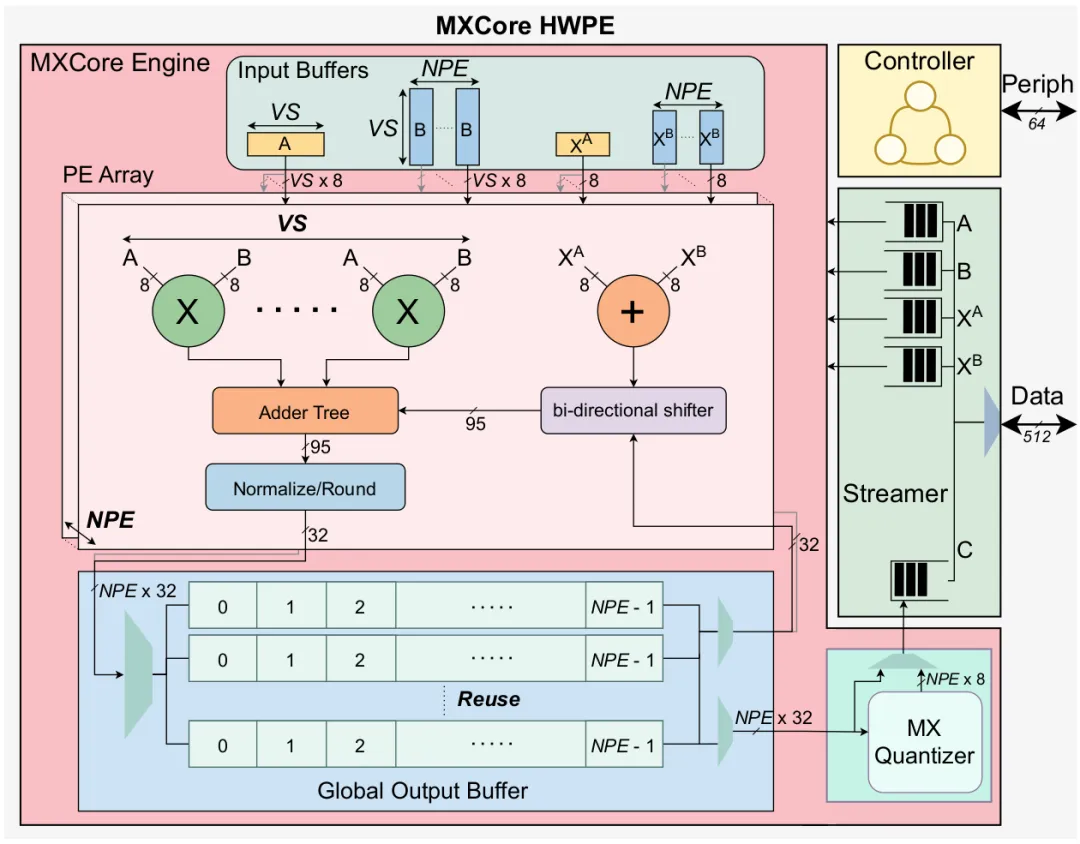
先看 MXCore 的硬件架构。这张图是后文所有模块讨论的落点:
再看一次 tile 计算的数据流。实线是操作数通路,虚线是控制与状态信号,粗线是可能并发的双通道:
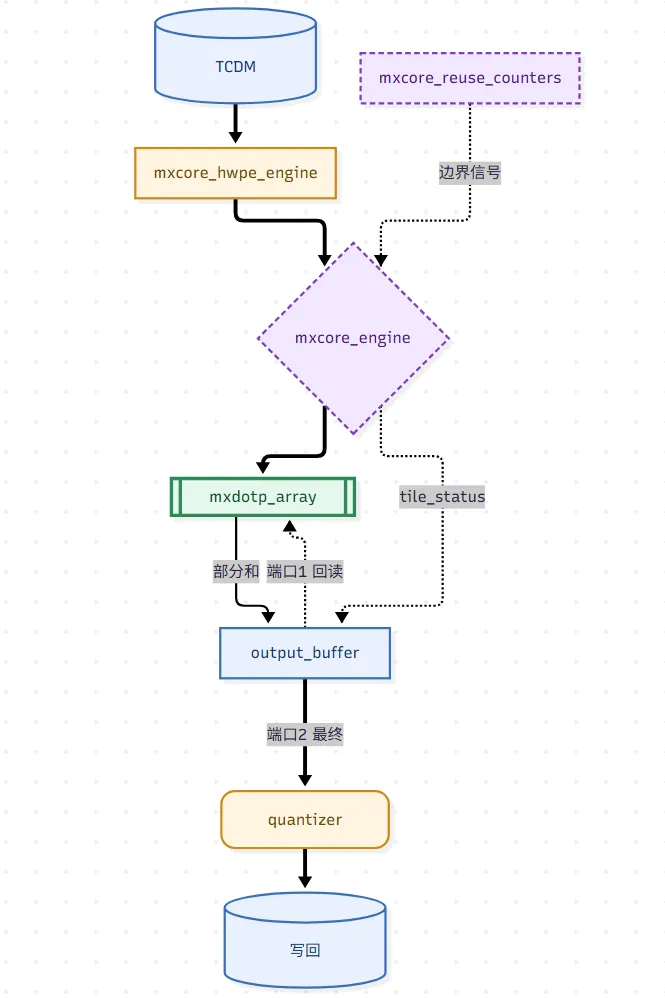
阵列与缓冲区之间的粗实线是部分和写入。
虚线回读是端口 1 的累加回路。
通往量化器的粗线是端口 2 的最终结果通道。
先记住主线:数据进来 → 阵列做外积 → 缓冲区攒部分和 → 边界信号决定何时最终化 → 量化器转格式 → 写出。下面逐层展开。🧭
📑 目录
一、源码分层
一·五、先认识三种源格式
二、参数化与吞吐公式
二·五、矩阵视角:从标量到分块
三、引擎顶层
四、点积阵列与核心公式
五、输出缓冲区
六、迭代计数
七、HWPE 包装层
八、在线量化公式
九、数据流全景
十、设计取舍
结语
一、源码分层:计算核心与外围包装 🗂️
README 把 MXCore 的硬件分成三层,源码目录正好对应这个划分。
三层分别对应:计算、控制、搬运。
这是 HWPE 模板的标准切分方式。
mxcore-rtl/src 的组织与这三层对应:
• 根目录下是 纯计算核心,对应 Engine 的算术部分。 • hwpe/子目录是 总线与流式接口,对应 Controller 与 Streamer。
目录不完全按三层切:
Engine 的包装层也在hwpe/。
但工程边界很清晰:计算核心看到的是“操作数向量”与“结果向量”,而不是 AXI 事务。它并不关心数据是从 TCDM 来的还是从别的总线来的。
这意味着计算核心可以脱离 HWPE 框架单独验证。
上表只列角色,不列文件名。
文件名较长,移动端阅读不便,下文按模块名引用。
仓库中除 mxcore-rtl/ 外,还有 PyGolden/(Python 黄金模型,位精确参考)与 testvectors/(生成的测试向量)。前者是软件侧的参考答案,后者是 RTL 仿真的输入。
RTL 与黄金模型逐位比对,才判定 PASS。
这是后文第十节仿真结果的前提。
这种分层带来两个直接好处:
• 计算核心不依赖总线协议,便于独立验证。测试平台只需要驱动操作数向量,不必模拟完整的 AXI 握手。 • 外围层可随 HWPE 模板演进替换,不触动算术通路。总线协议升级时,算术部分无需重新验证。
从工程角度看,这是“算术与集成分离”的组织策略。
也是 PULP 系加速器一贯的做法。
另有一个隐含好处:参数化实验的收敛范围更小。
• 改三个核心参数时,只需重验计算核心。外围层的协议逻辑不受参数影响,可以复用已有的验证环境。 • HWPE 层的握手与协议逻辑不受影响。这意味着面积与时序的实验可以集中在计算核心内部。 • 面积与时序的权衡实验可快速迭代。每换一组参数,回归范围是可预期的,而不是全芯片重跑。
分层的价值不只在“好看”,更在于把变化关进小盒子里。
参数一改,需要重验的范围被限制在计算核心内部。📦
一·五、先认识三种源格式 📐
MXCore 的源操作数只支持三种 MX 格式。README 给出的格式表如下:
量化遵循 OCP MX 规范。
按 32 元素共享指数块进行,目标编码为 E5M2 或 E4M3。
理解这三种格式的关键不在“8 位还是 4 位”,而在指数位与尾数位怎么分。
E 代表指数,M 代表尾数。
位宽固定时,指数多则范围宽,尾数多则精度高。
MXFP8 E5M2 把 8 位中的 5 位留给指数,2 位留给尾数。它的指数范围最宽,适合数值跨度大的场景,但尾数精度最粗。由于指数位多,它能表示非常大或非常小的数,代价是相邻可表示值之间的间隔更大。
MXFP8 E4M3 反过来,4 位指数、3 位尾数。它的动态范围比 E5M2 窄,但尾数多 1 位,量化误差更小。E4M3 能表示的最大值是 448,这也是 MXFP8 块缩放计算时常用的参考上界。精度更高意味着它更适合数值分布集中、但要求误差小的场景。
同一组 8 位,E5M2 和 E4M3 不能兼得。
选范围还是选精度,取决于数值分布。
MXFP4 E2M1 只有 4 位:2 位指数、1 位尾数。它的可表示值只有 16 个,正负各 8 个:
E2M1 的尾数只有 1 位,所以可表示值在相邻 2 的幂之间非常稀疏。它的优势不在精度,而在存储密度:每个元素 4 位,相比 FP32 压缩了 8 倍。对带宽受限的加速器来说,这个压缩比本身就是性能来源。
MXFP4 的数值瓶颈不靠元素位宽解决。
靠的是“每 32 元素共享一个 E8M0 缩放因子”。
三种格式共享同一个结构约定:元素之外,每 32 个值有一个块缩放因子。这个缩放因子是 E8M0,只有 8 位指数、没有尾数,只能表示 2 的幂。正因为它只能表示 2 的幂,硬件里缩放因子的融合才可以用指数加法完成。
• 共享缩放因子:每组 32 个元素共用一个 E8M0 指数。它只能表示 2 的幂,因此硬件中只需指数加法,不需要真正的乘法器。 • 窄位宽元素:每个元素只存尾数与短指数。元素越窄,存储与带宽压力越小,但越依赖共享缩放来撑住动态范围。 • 块对齐要求:K 维迭代必须按 32 元素对齐。否则同一个点积里会混入不同块的缩放因子,结果无法统一还原。 • 硬件含义:点积单元必须同时接收元素与缩放因子。缩放因子的分发路径与操作数路径必须同步,否则会错拍。 • 软件含义:量化与反量化以块为单位。软件侧看到的不是逐元素的独立浮点,而是“元素 + 块缩放”的组合。
元素位宽越窄,块缩放承担的责任越重。
这正是 MX 格式“窄存储、宽动态”的机制来源。
回到 MXCore 的代码命名:后文出现的 MXFP8 通常指 E5M2 路径,MXFP8ALT 指 E4M3 路径,MXFP4 指 E2M1。EnMxdotpSrcFpFmtConfig = 9'b000101001 恰好开启这三个格式位。理解了这三者的位分配,后面看到格式使能位时就不会困惑。
二、参数化与吞吐公式 ⚙️
mxcore_package.sv 是整个设计的配置中枢。
它用编译宏覆盖的方式,定义了三个决定硬件规模的核心参数:
parameter int unsigned VectorSize = `ifdef VECTOR_SIZE `VECTOR_SIZE `else 32 `endif;
parameter int unsigned NPE        = `ifdef NPE `NPE `else 32 `endif;
parameter int unsigned Reuse      = `ifdef REUSE `REUSE `else 64 `endif;
• VectorSize:每个 PE 一次点积覆盖的元素个数。它决定了单个 PE 内部加法树的深度,也决定了流水级数的下界。• NPE:并行处理单元个数。它决定了外积方向的并行度,也就是每周期能同时推进多少个输出元素的部分和。• Reuse:输出缓冲区深度。它决定了在写回之前能累积多少个部分和,等价于 K 维方向上一次能推进多深。• 格式裁剪:未使用的 MX 格式可在综合时被裁掉。综合工具会做常量传播,把不用的译码路径直接优化掉。
核心公式 1:峰值吞吐
理论峰值 MAC 吞吐可以写成:
• VectorSize对应内积方向展开长度。它越大,单个 PE 一次能消化的 K 维元素越多。• NPE对应外积方向并行度。它越大,一次能同时处理的输出元素越多。• 两者相乘,就是每周期能完成的乘累加次数。这是吞吐的上界,实际吞吐还要受数据供给和缓冲区回读限制。 • 若 VectorSize = 32、NPE = 32,则 。这是 README 中验证过的配置之一。• 若 VectorSize = 8、NPE = 128,则 。吞吐相同,但结构完全不同。
总吞吐固定时,内积长度与并行度可以互换。
README 的三组 1K-MAC 配置正是同一吞吐的三种分解。
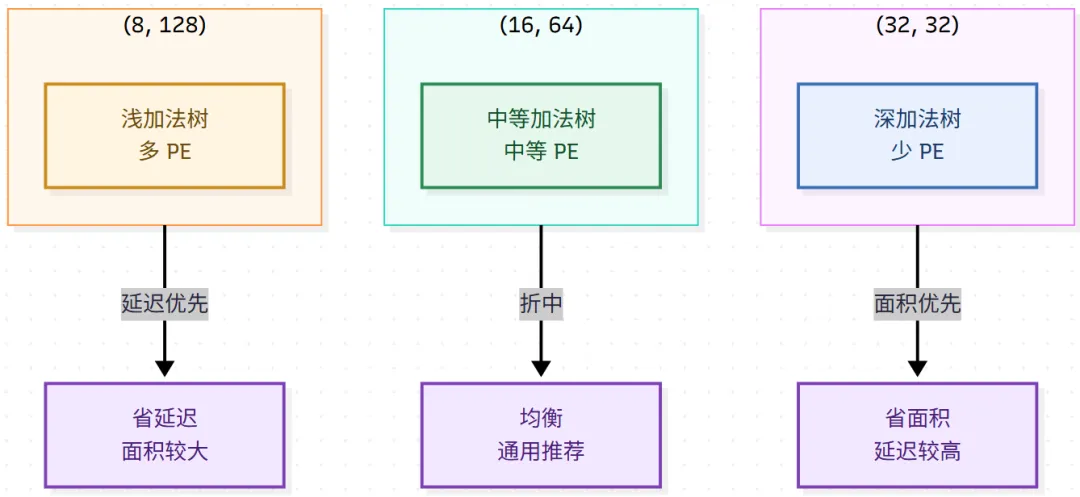
• (8,128):加法树浅,单 PE 内加法链短。关键路径更容易收敛到高频,但 PE 数量多,广播网络更宽。• (32,32):PE 数量少,面积更省。但单 PE 内加法树深,需要更多流水寄存器来打拍。• (16,64):折中形态,面积与频率平衡。通常是没有强约束时的默认选择。• Reuse独立可调:32、64、128 三档。它不改变 MAC 吞吐,只改变缓冲区深度和稳态阶段长度。
三者的乘积是吞吐,
Reuse是缓冲深度。
四者共同决定一个具体的设计点。
README 验证过的配置组合如下:
这三组配置构成同一个吞吐的三种分解。
后文第十节的仿真结果,正是在这些配置下跑出来的。
当前只支持规则 tile。GEMM 形状必须是硬件配置的整数倍,部分 tile 支持尚未合入。这条约束会贯穿后文的迭代计数与边界信号,也是仿真能全部通过的前提之一。
参数不是越多越好,而是越正交越好。
VectorSize管内积、NPE管外积、Reuse管缓冲,三者职责不重叠。
二·五、矩阵视角:从标量到分块 🧱
前面几个公式都在单个 PE 的标量层面。真实加速器处理的是矩阵,所以需要把标量视角提升到矩阵视角。
核心公式 M1:GEMM 的定义
矩阵乘法的基本形式是:
• 是 矩阵, 是 矩阵。 • 是 结果矩阵。 • 求和沿 K 维进行,K 维也叫内积维度。 • 这个公式是后面所有分块形式的起点。
核心公式 M2:MX 矩阵的嵌套表示
MX 格式下, 不是单一矩阵,而是元素矩阵 + 缩放向量的嵌套结构。把 K 维按 32 分块, 可以写成:
• 每个 是 的子矩阵。它是 在 K 维的第 个块。 • 是块的总数。K 必须是 32 的整数倍,否则需要补零或掩码。 • 每个子矩阵 共享一组缩放因子,按行分布。 • 这种“矩阵套子矩阵”的结构,就是 MX 的嵌套表示。
理解这个嵌套结构,就理解了 MXCore 为什么需要“块对齐”。
因为块是缩放因子的最小单位,也是硬件迭代的最小单位。
核心公式 M3:嵌套子矩阵的展开
每个 再展开成元素矩阵与缩放向量的乘积:
• 是 的窄位宽元素矩阵。 • 是长度为 的缩放向量,每个元素对应 的一行。 • 把向量变成对角矩阵。 • 这个式子对应硬件的“广播缩放”结构:一行的 32 个元素共用一个缩放。
从矩阵角度看,缩放不是逐元素的,而是逐行逐块的。
这就是“嵌套”的含义:外层块共享缩放,内层元素共享指数。
三、引擎顶层:把三块拼在一起 🔗
mxcore_engine.sv 是计算核心的集成点。
README 指出,Engine 内部由三块构成:参数化 PE 阵列、共享全局输出缓冲区、MX 量化器。引擎顶层做的,就是把这三块连起来。
// MXDOTP Array Signals
logic [NPE-1:0] mxdotp_in_valid, mxdotp_in_ready;
// Output Buffer Signals
logic obuff_result_valid, obuff_result_ready;
// Iteration Status Signals
logic first_iter, last_iter;
• mxdotp_in_valid/ready:逐 PE 握手向量。对应 PE 阵列。每个 PE 独立握手,意味着阵列内部允许 PE 级反压,而不是整阵列粗粒度阻塞。• obuff_result_valid/ready:输出侧单路握手。对应输出缓冲区。它把缓冲区与下游隔开,下游慢时缓冲先吸收,避免直接反压到阵列。• first_iter:是否需要从缓冲区读回历史部分和。为真时走“首次计算”路径,跳过回读。• last_iter:本次写入是否应被标记为最终结果。为真时槽位被标记为“可输出”。• ireuse_i:复用计数输入,告诉计数器总迭代数。它让计数器与具体 tile 尺寸解耦。• flush_i:清空流水或缓冲状态。典型用途是在一个 tile 序列结束时丢弃未完成的部分和。
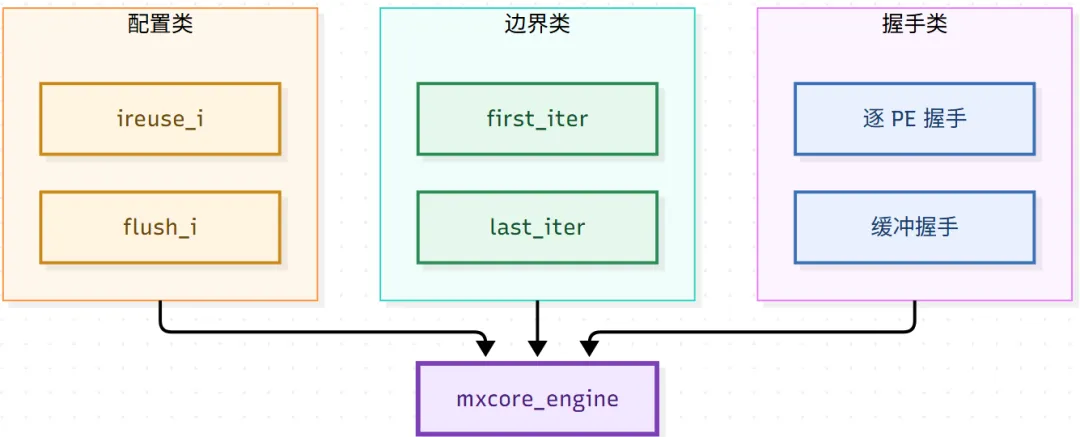
• 握手类:负责数据流动的节拍控制。它们决定“数据什么时候能走”,不决定“数据走去哪”。 • 边界类:回答“第一次 / 最后一次”。它们是流水线的节奏标记,告诉缓冲区何时切换读口。 • 配置类:决定 tile 序列长度与清理时机。它们来自上层,通常在一次 tile 序列内保持不变。 • 集成点角色:只做连线与少量状态维护。引擎不产生算术,也不存储数据,它是纯粹的“连接器”。
这三块的分工,正好对应后文三节:
点积阵列、输出缓冲区、在线量化器。
这些信号透露出引擎的控制哲学:
不维护集中式大状态机串行调度 PE。
first_iter/last_iter 在正确时间点触发缓冲区读端口切换。
• 好处一:参数变化时时序更容易收敛。边界信号只依赖计数比较,不随 NPE或VectorSize变复杂。• 好处二:不需要为每个 PE 维护调度表。调度信息由数据流自身携带,而不是由中央控制器逐 PE 下发。 • 好处三:控制逻辑面积小。少量比较器即可完成原本需要大状态机完成的工作。
这种“数据流驱动 + 少量边界信号”的方式,比集中式调度更轻。
中央调度器在参数变大时往往成为瓶颈。
把边界信息外置,相当于让流水线自己“知道走到哪了”。🧭
四、点积阵列与核心公式 🧮
mxcore_mxdotp_array.sv 的结构非常规整。
就是一个 generate for 循环,把 NPE 个相同的点积单元平铺开:
for (genvar i = 0; i < NPE; i++) begin : mxdotp_array
    fpnew_mxdotp_multi #(
        .VectorSize (VectorSize),
        .NumPipeRegs (NumPipeRegs),
        .PipeConfig (PipeConfig)
    ) i_fpnew_mxdotp_multi (
        .operands_a_i (operands_a_i[i]),
        .operands_b_i (operands_b_i[i]),
        ...
    );
end
• fpnew_mxdotp_multi:底层算术单元,来自 README 提到的 MXDOTP 系列。它承担一个VectorSize长度的 MX 点积,内部完成缩放融合、窄位宽乘累加与 FP32 累加。• 同构性:所有实例 VectorSize相同。计算延迟一致,握手与流水对齐因此变得简单,不需要为不同 PE 做延迟补偿。• NumPipeRegs:流水级数参数。它是调整关键路径的主要旋钮,增加级数可以缩短单级组合逻辑。• PipeConfig:流水配置参数。它允许在不改功能的前提下调整流水结构,例如是否在乘法与累加之间插入寄存器。• busy_o:所有 PE 的 busy 汇总。对外只呈现“阵列是否还有未完成计算”,而不是逐 PE 状态,便于上层粗粒度调度。• 逐 PE 握手:支持 PE 级不均匀反压。虽然当前规则 tile 下所有 PE 同步工作,但结构上为未来非规则场景留了空间。
这一层就是 README 所说“PE 粒度”的硬件落点。
改VectorSize或NPE,改的就是这里的实例数与内部结构。
核心公式 2:单 PE 点积
单个 PE 在 VectorSize 长度上的点积,可以写成:
• 、 是第 个 PE 的两个 MX 操作数元素。它们都是窄位宽数,单独看精度有限。 • VectorSize是求和长度,对应代码参数。它决定了这个求和式里有多少项。• 、 是 A/B 两侧的块缩放因子。它们负责把窄位宽元素恢复到真实数值量级。 • 乘积 在硬件中以指数相加实现。因为两者都是 2 的幂,乘法退化为指数加法。 • 累加在 FP32 中完成,保证长 K 维精度。窄位宽乘积不会在累加过程中丢失高位信息。 • 这个公式对应 fpnew_mxdotp_multi的核心算术行为。阵列里每个 PE 都在反复执行它。
这是整个加速器最核心的一条公式。
阵列里每个 PE 都在反复执行它。
核心公式 2b:矩阵级 MX 乘法
把公式 2 从单个 PE 提升到整个矩阵。对 MX 格式的 和 ,真实乘积是:
• 外层求和沿 32 元素块进行,共 个块。 • 内层求和是块内 32 个元素的点积。 • 、 是第 个块的缩放因子。 • 缩放因子在块级提出,避免逐元素乘法。 • 这个式子等价于公式 M1,只是把 MX 的嵌套结构展开了。
写成矩阵形式:
• 是 的第 个 K 维块,。 • 是 的第 个 K 维块,。 • 每个块内部乘积 是一个 的部分和。 • 所有块的部分和按缩放加权后累加,得到最终结果。
这个公式把“大 GEMM”拆成了“小 GEMM 的加权和”。
硬件每次迭代算一个 ,缓冲区负责累加。
核心公式 3:缩放因子融合
两个块缩放因子在进入乘法前可以先融合:
• 是 A 侧 E8M0 缩放因子。它只有指数,没有尾数。 • 是 B 侧 E8M0 缩放因子。同样只有指数。 • 融合后 ,硬件只需做指数加法。一个加法器替代了一个乘法器。 • 避免了逐元素反量化,也避免了额外乘法器。缩放只在块级做一次,不随元素数量增长。 • 这是 MX 格式能在窄位宽下保持动态范围的关键。范围由指数承担,精度由尾数承担,两者分工明确。
公式 2、2b、3 合起来,就是 MX 点积的全部数学。
其余都是围绕它们的数据搬运与控制。
单个 PE 内部的算术流程如下:
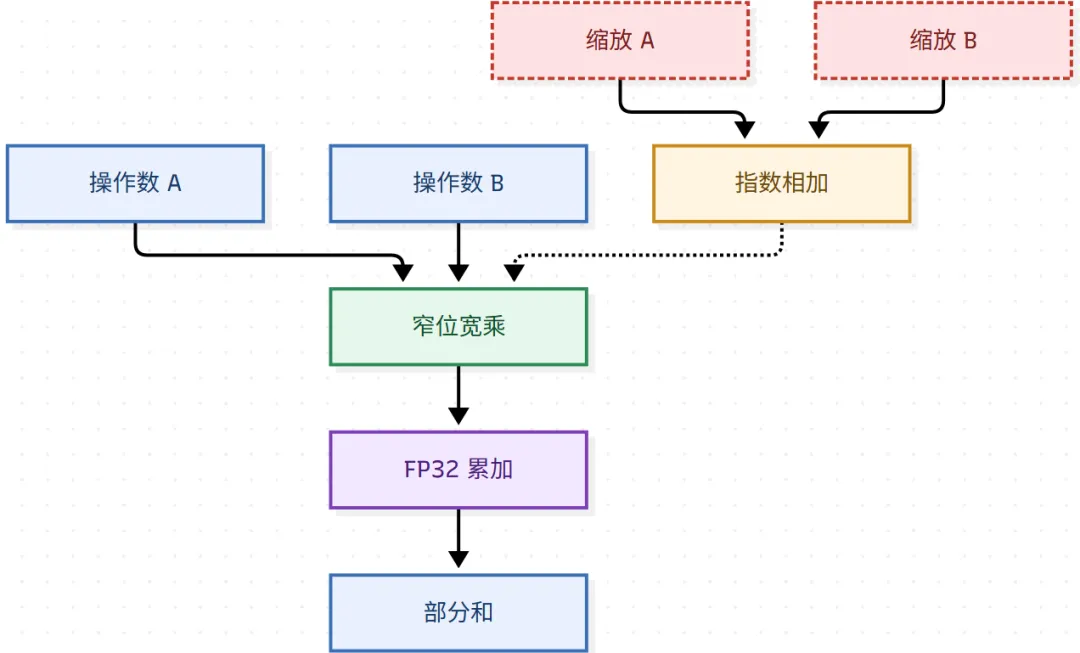
• 乘法前融合缩放:两个缩放因子先组合。这样乘法单元只需要处理窄位宽操作数,不必等待缩放。 • FP32 累加:窄位宽乘积进入 FP32 累加器。累加器位宽足够,长 K 维下不会溢出或丢精度。 • 部分和输出:结果可被回读累加。单次点积不是最终值,而是可与其他迭代结果合并的部分和。 • 参数影响: VectorSize越大,加法树越深。加法树变深意味着需要更多流水级来维持频率。
从数据流看,这个阵列实现的是 外积式并行。
A 侧在多个 PE 间复用,B 侧按 PE 切片并行。
这正是 GEMM 中 输出驻留 变体的典型形态。
• 每个 PE 负责输出矩阵的一列。它把自己的部分和留在缓冲区里,等待 K 维迭代补齐。 • K 维推进通过多次迭代累积到同一槽位。每次迭代都读回旧值、加上新乘积、再写回。 • 槽位生命周期由 Reuse深度决定。深度越大,同时驻留的输出列越多,K 维一次能推进越深。
输出驻留的好处是减少结果搬运。
部分和留在片上,只在最终化时才写出。💾
五、输出缓冲区:两个读端口的分工 🚪
mxcore_global_output_buffer.sv 是设计中最值得细看的部分。
README 称它为“共享全局输出缓冲区”。共享意味着所有 PE 的部分和都汇聚到这里;全局意味着它在阵列外部,不属于某个 PE。深度等于 Reuse,关键在两个独立读端口。深度只决定能存多少,双端口才决定能不能“边读边写”。
tile_status_d[write_addr_q] = last_iter_i;
obuff_result_valid_o = status_q[read_addr_q] && !tile_status_q[read_addr_q];
tile_result_valid_o  = tile_status_q[tile_addr_q];
• 写端口:写入时记录 last_iter_i为该槽位的tile_status。这相当于给每个槽位打上“是否已最终化”的标签。• 读端口 1:面向部分和回读。它只在槽位有效且尚未最终化时工作,把旧部分和送回阵列。 • 读端口 2:面向最终结果输出。它只在槽位已最终化时工作,把结果送往量化器或写回通路。 • 地址分离:两个端口用不同地址,可同周期并发。回读旧部分和与输出新结果互不阻塞。 • 双状态位:“有数据”与“已最终化”是两个独立维度。一个槽位可以有数据但尚未最终化,这正是部分和的状态。 • 语义清晰:避免单一状态位的歧义。用一位同时表达“有效”和“最终”会让状态机难以维护。
核心公式 M4:缓冲区的矩阵表示
输出缓冲区可以看成一个部分和矩阵集合。它有 Reuse 个槽位,每个槽位存一个 的向量:
• 是整个缓冲区的矩阵视图。 • 每个 是一个输出列的部分和向量。 • Reuse是槽位数,也是 的列数。• 这种表示让“部分和累加”变成矩阵的列更新。
第 次迭代对第 个槽位的更新是:
• 是第 次迭代 A 侧提供给第 个 PE 的列向量。 • 是第 次迭代 B 侧的行向量。 • 是外积,形状 。 • 每次迭代对部分和矩阵做一次外积累加。 • 这正是“输出驻留 + 外积”的矩阵表达。
硬件上,外积的每一列由一个 PE 完成。
所有 PE 合起来,就是一次完整的外积更新。
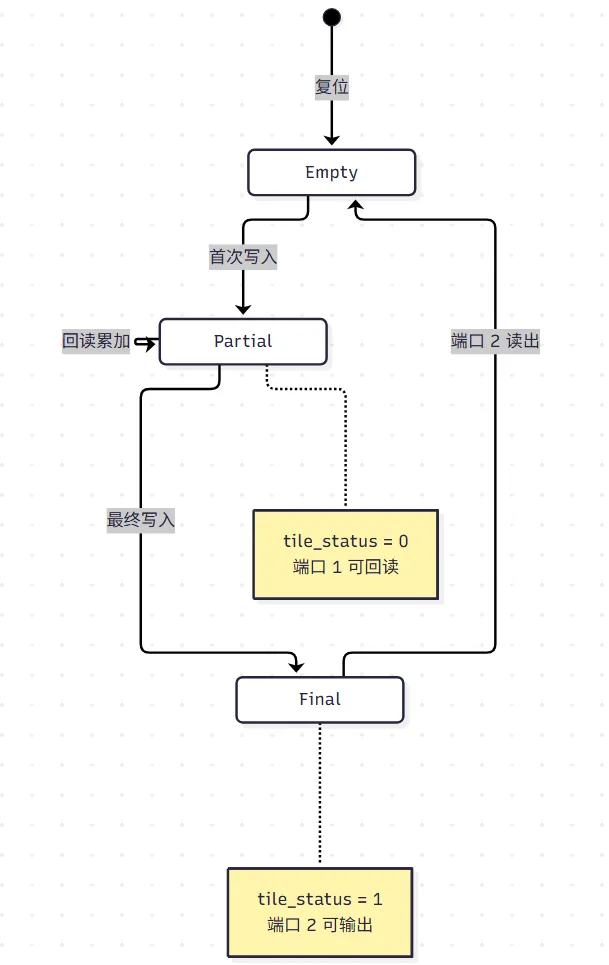
• Empty:槽位无有效数据。复位后或输出完成后回到此状态。 • Partial:存部分和,可被端口 1 回读。这是 K 维迭代过程中停留最久的状态。 • Final:存最终结果,等待端口 2 输出。此状态通常很短,只等下游接收。 • 自环:Partial 可多次回读与重写。每次 K 维迭代都会经过一次自环。 • 并发性:不同槽位可处于不同状态。端口 1 服务 Partial,端口 2 服务 Final,两者可同时工作。
这一设计的价值在于 消除结构性冒险。
如果没有双端口,部分和回读会与最终结果写出争用同一个读口。
• 后果:累加链在 tile 边界必然出现气泡。每次有结果要输出,累加就必须暂停。 • 有了双端口:累加链连续推进。输出侧按自己的节奏搬走结果,不打断累加。
代价是读口数量和地址译码逻辑增加。
但在
Reuse达到 64 或 128 时,这部分面积可以接受。
缓冲区面积随
Reuse线性增长,读口逻辑只是常数开销。
深度越大,双端口的相对成本越低。📈
六、迭代计数与迭代次数 🧭
mxcore_reuse_counters.sv 是一个小模块。
但它生成的两个信号,决定了整条流水线的节奏。模块虽小,却是“什么时候该回读、什么时候该输出”的唯一判断者。
assign first_iter_o = (in_count_q < Reuse);
assign last_iter_o  = (out_count_q + Reuse >= ireuse_i);
• first_iter_o:输入未填满一个窗口时为真。此时没有历史部分和可回读,引擎走首次计算路径。• last_iter_o:输出加窗口已达总迭代数时为真。此时当前写入就是最后一次累加,应被标记为最终。• 双侧计数器:输入填充与输出排空可有不同进度。缓冲区因此起到速率解耦作用,输入快时先攒着。 • ireuse_i:总迭代数,使计数器与 tile 尺寸解耦。计数器不需要知道矩阵多大,只需知道要走多少步。• 浅组合逻辑:不会成为关键路径。两个信号只依赖计数比较,组合深度很浅,适合直接驱动缓冲区。
核心公式 4:K 维迭代次数
若一次 tile 的 K 维长度为 ,则迭代次数为:
• 是矩阵乘法的内积维度。它决定一次输出需要累加多少项。 • VectorSize是单次点积覆盖的元素数。它决定每一步能消化多少项。• 非整数倍时向上取整。多出的部分需要掩码或补零,当前主分支尚未支持。 • 当前主分支要求规则 tile,实际为整数倍。这也是仿真验证能全部通过的前提之一。 • 这个值作为 ireuse_i的参考送入计数器。计数器据此判断何时到达最后一次迭代。
核心公式 M5:分块迭代的矩阵展开
把公式 2b 的块求和与迭代过程结合,第 次迭代的矩阵更新是:
• 是第 次迭代后的部分和矩阵。 • 是当前迭代取出的 A 子矩阵。 • 是当前迭代取出的 B 子矩阵。 • 、 是当前块的缩放因子。 • 初始 ,最终 。
对应到硬件结构, 就是输出缓冲区的部分和矩阵 。每次迭代读取 的部分列,加上新的外积贡献,再写回。
公式 M5 把“K 维迭代”写成了矩阵递推。
硬件里每一步都是“读回 — 累加 — 写回”。
一段典型 K 维迭代的时序关系如下:
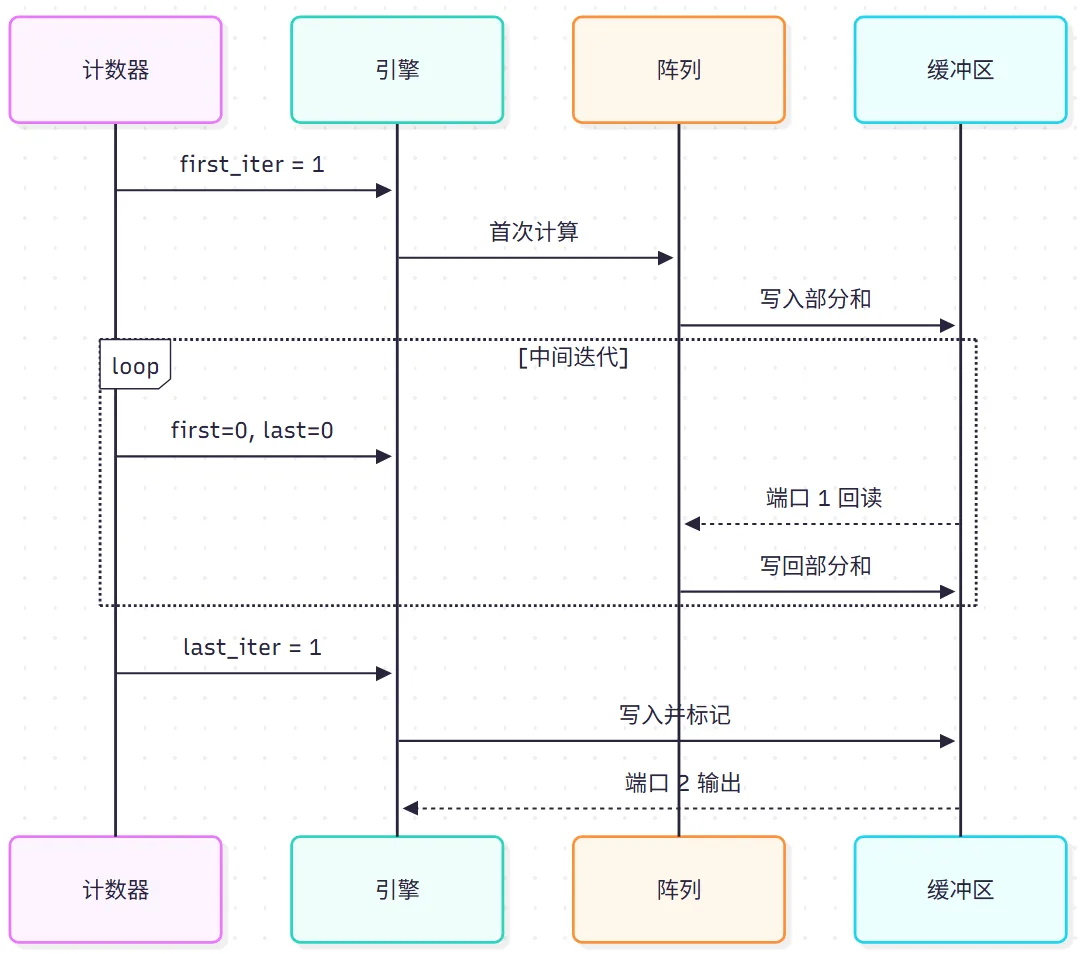
• 首次迭代:跳过回读,直接写入首个部分和。此时缓冲区里还没有可读的历史值。 • 中间迭代:读写交替,流水线吞吐最高。端口 1 回读与写端口写入形成稳定循环。 • 最后一次:写入被标记为最终结果。 last_iter拉高,tile_status置 1。• 速率解耦:输入与输出计数独立推进。输入可以先填满窗口,输出再慢慢排空。 • 验证要点: ireuse_i必须与 K 维长度一致。不一致会导致last_iter在错误时机拉高,结果被提前标记。
把边界判断从数据通路中剥离出来,是这类加速器的常见做法。
各模块分工因此变得很纯粹:
• 算术单元只关心“算”。它不需要知道自己是第几次迭代。 • 缓冲区只关心“存”。它不需要知道总共有多少次迭代。 • 计数器统一回答“什么时候算完了”。它是唯一的节奏来源。
这种“单一职责”的划分,让每个模块的验证用例都更容易构造。
计数器只需验证比较逻辑,缓冲区只需验证状态转换。🧪
七、HWPE 包装层:从流到并行向量 🔀
hwpe/mxcore_hwpe_engine.sv 负责把流式数据重排成并行操作数。
它对应 README 里的 Streamer 与 Controller:前者负责搬运,后者负责节拍。二者一起把“协议世界”的数据翻译成“算术世界”的向量。
assign operands_a = vectors_b_i.data;
assign operands_b = {NPE{vector_a_i.data}};
assign operands_c[i][0] = scale_b_i.data[i*SCALE_WIDTH+:SCALE_WIDTH];
assign operands_c[i][1] = scale_a_i.data;
• operands_b广播:A 侧数据被复制NPE份。每个 PE 拿到相同的 A 侧操作数,对应外积中复用的那一维。• operands_a切片:B 侧数据按 PE 切分。每个 PE 拿到不同的 B 侧片段,对应外积中并行的那一维。• scale_b逐 PE 截取:与 B 侧切片模式一致。缩放因子的分发必须与操作数分发同步,否则会错位。• scale_a整体广播:与 A 侧广播模式一致。A 侧缩放对每个 PE 相同。• 命名暗示: vector与vectors的单复数差异。A 侧单个向量,B 侧向量组。• 纯连线:不参与算术,延迟可控。这一层只做位宽重排与复制,不含乘法或加法。
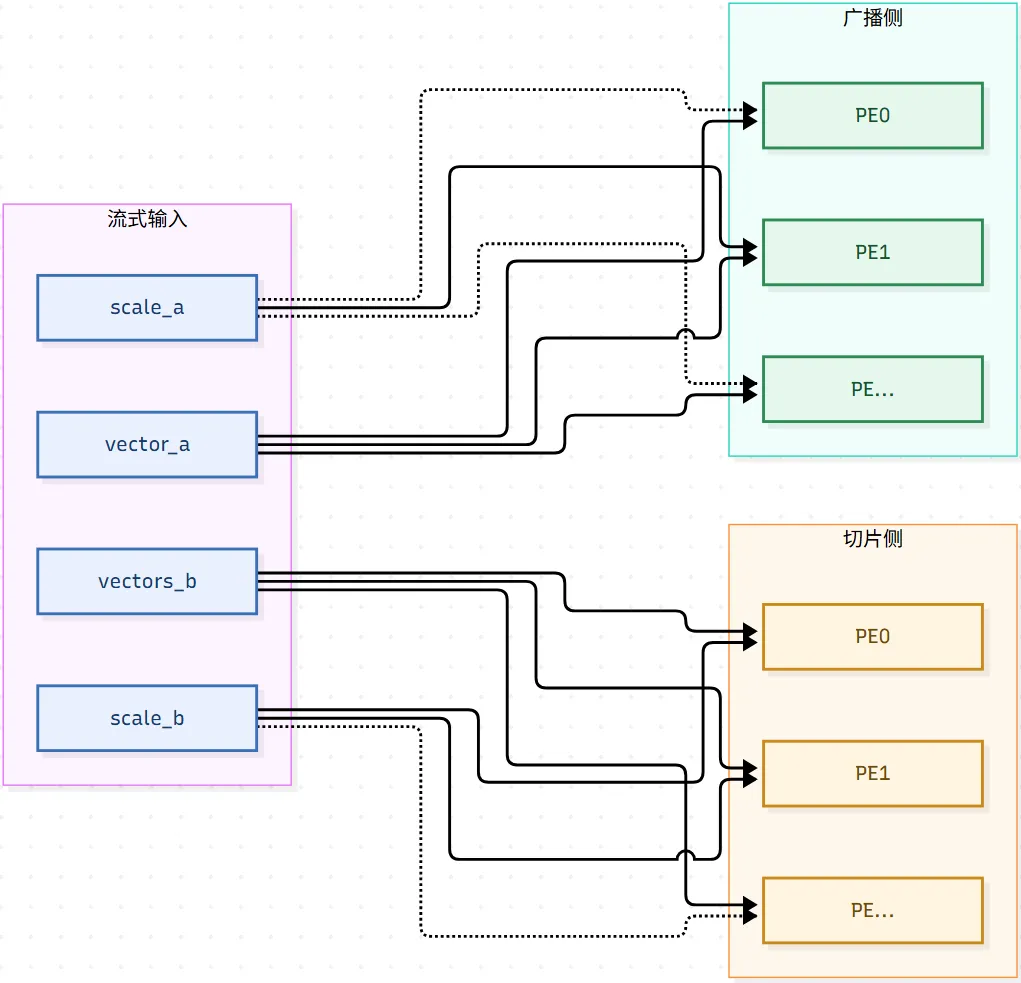
• 广播侧: vector_a与scale_a同步广播。两者必须同时到达各 PE,否则缩放与操作数会错拍。• 切片侧: vectors_b与scale_b按通道切分。切分粒度必须与 MX 的 32 元素分组一致。• 模式一致:数据与缩放因子分发必须匹配。这是这一层最容易出错的地方。 • 连接成本:广播是连线,切片是截取,都无算术。因此这一层的延迟主要是布线延迟。
从系统视角看,这一层是“协议世界”与“算术世界”的翻译器。
它完成两件事:
• 把窄数据宽度聚合成宽并行格式。AXI-Stream 的窄数据在这里被拼成计算核心需要的宽向量。 • 把块缩放因子对齐到对应通道。缩放因子必须跟着操作数走,不能独立流动。
MX 规范要求每 32 个元素共享一个缩放因子。
切片逻辑必须与VectorSize保持一致,否则缩放会错位。
错位的后果不是精度下降,而是数值完全错误。
所以这一层的验证重点是“对齐”,而不是“计算”。🎯
八、在线量化与量化公式 🎯
hwpe/fp32_to_mxfp8_quantizer.sv 把 FP32 累加结果转回 MXFP8。
README 称它为“在线量化器”。在线意味着它挂在流水线末级,与累加同步工作;加速器因此可直接输出块缩放格式,不需要软件后处理。它闭合了“MX 输入 → FP32 累加 → MX 输出”的完整链条。
parameter bit Encoding = 0;  // 0 - E5M2, 1 - E4M3
parameter bit Saturate = 1;
• Encoding:选择目标编码。E5M2 范围宽,E4M3 精度高,对应不同的下游需求。• Saturate:控制溢出行为。饱和模式钳位,非饱和模式产生 Inf/NaN,便于上层检测异常。• 内部流程:提取 → 调指数 → 舍入 → 溢出处理。四个步骤对应量化公式的各个部分。 • 特殊值:零、NaN、Inf 需分别处理。它们在两种编码下的位模式不同,不能走常规路径。 • 流水末级:与累加链形成流水。量化不阻塞累加,只要下游能接收。
核心公式 5:量化与舍入
FP32 结果到 MXFP8 的量化,可以写成:
• 是 FP32 累加结果。它是长 K 维累加后的高精度值。 • 是该 32 元素块共享的缩放因子。它把 FP32 值平移到目标格式的可表示区间。 • 是块的 E8M0 指数。它只有指数,没有尾数。 • round采用 guard/round/sticky 舍入。三位信息保证舍入误差可控。• 结果 被压入 E5M2 或 E4M3 位宽。位宽越窄,舍入误差越大。 • 反量化时乘以 即可恢复近似值。整个流程可逆,但精度有损。
核心公式 M6:矩阵级再量化
把公式 5 提升到矩阵层面,最终结果 被重新分块量化:
每个 是 的子矩阵,共享一组缩放因子 。量化后:
• 表示逐元素除以对应缩放。 • 是量化后的 MXFP8 子矩阵。 • 量化后整个矩阵仍保持嵌套结构。 • 下游可以按同样的分块方式读取与反量化。
公式 5 与公式 M6 构成闭环:
块缩放 → 点积 → FP32 累加 → 矩阵再量化。
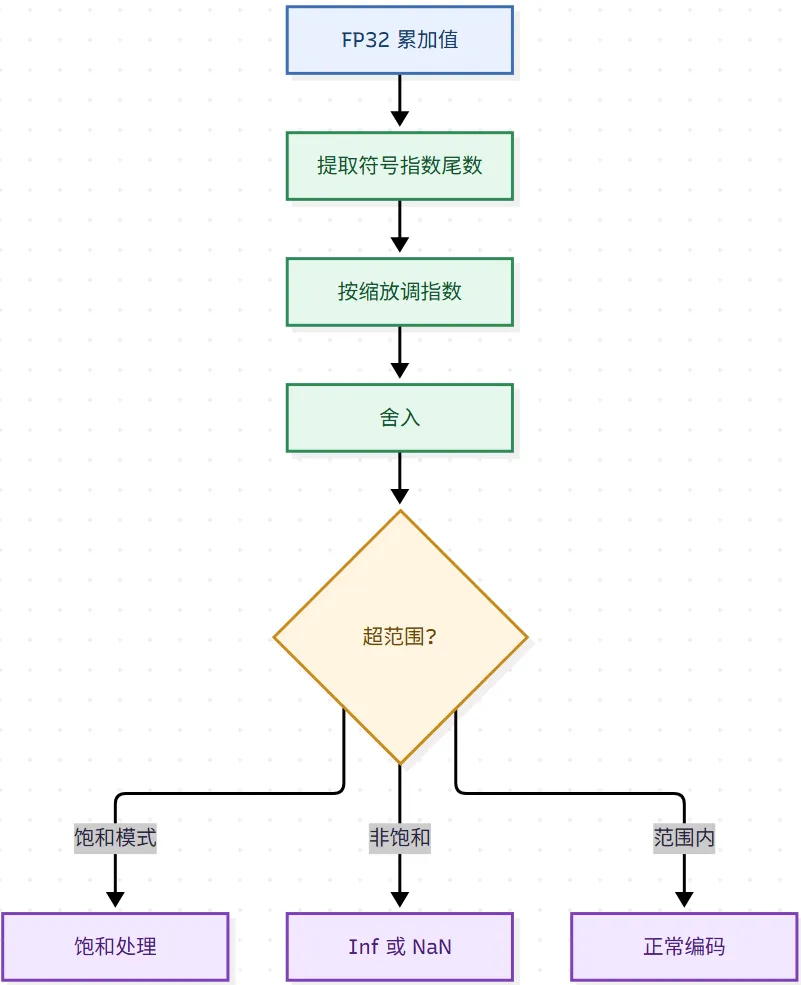
• 提取与调整:指数先按共享缩放平移。这一步把 FP32 的量级搬到目标格式能表示的范围。 • 舍入:guard/round/sticky 保证误差可控。只保留目标位宽所需的信息,其余按规则舍入。 • 溢出分支:饱和钳位,或产生 Inf/NaN。两种行为对应不同的下游处理策略。 • 特殊值:零、NaN、Inf 单独编码。它们不参与常规舍入路径。 • 编码选择: Encoding决定最终位模式。同一份逻辑可输出 E5M2 或 E4M3。
在线量化的意义在于 闭合数据通路。
完整链条是:MX 输入 → FP32 累加 → MX 输出。
• 相比“FP32 输出 + 软件量化”:省去一次完整搬运。结果不必先写回内存再由软件处理。 • 代价:硬件中多一组舍入与特殊值逻辑。面积增加有限,但换来了端到端的格式闭合。
对调用者来说,加速器对外表现就是“MX 进、MX 出”。
中间的高精度累加对软件透明。🧱
九、数据流全景 🗺️
开头那张架构图是模块落点,开头那张数据流图是通路关系,这里只补一次完整 tile 的时间轴展开。
• 填充阶段:只写不读,建立第一个部分和。此时缓冲区在填充,流水线尚未进入稳态。 • 稳态累加:读写交替,流水线吞吐最高。这是整个 tile 计算中耗时最长的阶段。 • 收尾阶段:写入被标记为最终结果。此时该槽位不再参与累加。 • 输出阶段:端口 2 接管。结果被送往量化器,然后写回。 • 吞吐关键:稳态越长,填充与收尾开销占比越小。K 维较长时,这个占比会显著下降。
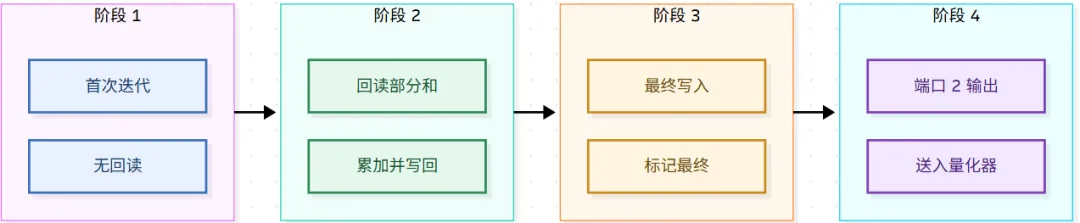
填充与收尾是固定开销,稳态是可变开销。
Reuse越大,固定开销的占比越小。📊
回到开头两张图:数据从左侧流入,经过阵列的外积计算,部分和在缓冲区里反复累加,最终化后经端口 2 送入量化器。整条链路的节奏,由计数器给出的 first_iter/last_iter 控制。
十、设计取舍与当前边界 ⚖️
综合来看,MXCore 的 RTL 在几个关键点上做了明确取舍。
并行度组织
• 选择“内积长度 × 外积并行度”的二维参数化 • 而不是固定一种形态
(32,32)、(16,64)、(8,128)三组配置说明:
同样吞吐下,深加法树配少 PE 与 浅加法树配多 PE 各有取舍。
前者省面积,后者省延迟。
• 深加法树:加法链长,PE 数量少。适合面积受限、频率要求不高的场景。 • 浅加法树:延迟短,PE 数量多。适合频率要求高、面积相对宽松的场景。 • 共同点:总 MAC 吞吐相同。验证环境可以复用,只需重新生成参数。
缓冲策略
• 选择双读端口的全局输出缓冲区 • 用额外读口换取累加链连续性
这是典型的“用存储带宽换流水效率”决策。
在Reuse较大时收益明显。
• Reuse = 32:缓冲浅,面积小。适合小规模、短 K 维的场景。• Reuse = 64:折中,适合多数场景。稳态与开销之间比较平衡。• Reuse = 128:缓冲深,适合长 K 维。稳态阶段长,固定开销被摊薄。
格式支持
• 源格式:MXFP8、MXFP8ALT、MXFP4 • 累加格式:FP32 • 量化输出:MXFP8 • 通过参数使能允许裁剪
覆盖了 MX 生态中最常用的组合。
• E5M2:指数范围优先。适合数值跨度大的场景。 • E4M3:尾数精度优先。适合数值集中、要求误差小的场景。 • MXFP4:存储宽度最小。适合带宽受限、精度要求不高的场景。
验证边界与仿真实证
当前主分支仅支持规则 tile:
• mdim必须是Reuse的整数倍• kdim必须是VectorSize的整数倍• ndim必须是NPE的整数倍
边界处理、部分 tile 的掩码与填充逻辑尚未完全合入。
构造激励时需保证维度对齐。
在规则 tile 配置下,设计已经通过 Verilator 仿真验证。下图是仿真终端的输出:
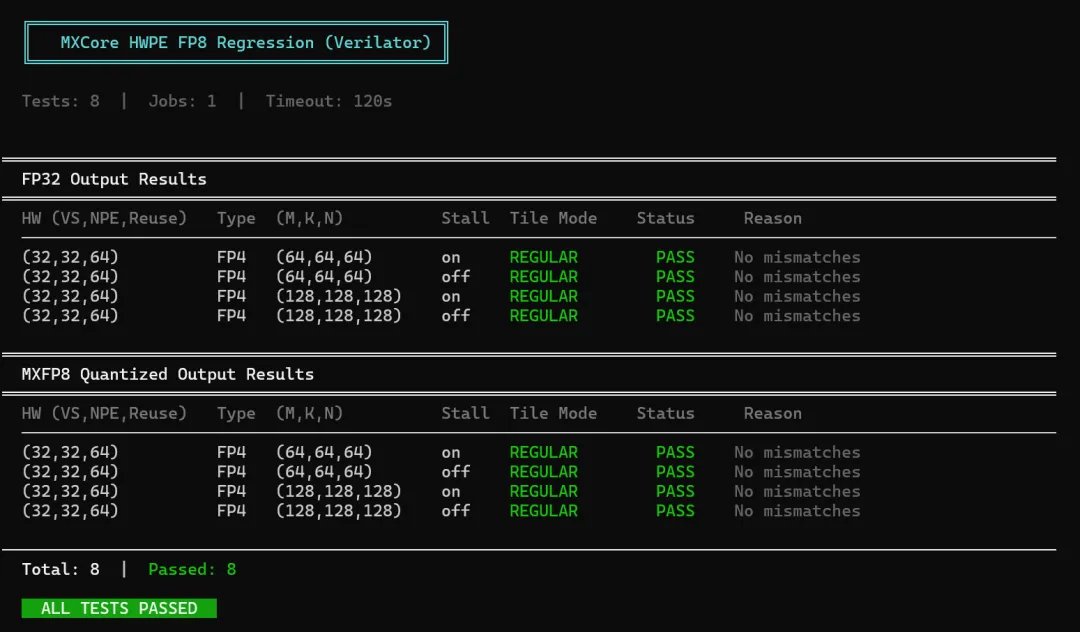
• 仿真器:Verilator,开源、速度快,适合回归。它把 SystemVerilog 编译成 C++,仿真速度比事件驱动仿真器快很多。 • 结果:终端输出显示所有测试用例 PASS。没有 FAIL,也没有超时。 • 覆盖范围:对应规则 tile 配置下的功能验证。覆盖了点积、回读、最终化、输出这条完整链路。 • 与本文对应:验证的正是前文的点积、缓冲、边界信号链条。公式 2 到公式 M6 的行为都在其中。 • 意义:说明这套参数化结构在规则维度下功能正确。结构不是纸面设计,而是可跑通的实现。
这张图是“设计可跑通”的直接证据。
也说明分层验证策略是有效的:计算核心可独立仿真。
此外,控制状态机与缩放因子生成细节,需直接查看仓库对应文件。本文描述集中在计算核心与已展开的外围模块。
MXCore 采用开源许可:硬件源码为 Solderpad 0.51,软件源码为 Apache 2.0。如果用于学术工作,README 给出了引用格式,对应论文标题是 MXCore: Rethinking Matrix Multiplication Accelerators for Microscaling (MX) Arithmetic。
源码之外,README 还列出了 MX 规范、MX 数据格式与 MXDOTP 三篇参考文献。
它们分别对应格式定义、精度评估与点积单元来源。
结语 🌟
MXCore 的价值不在于某一个模块的巧妙。
而在于它把三件事组织成了一套可复用的结构:
• MX 格式的数值特性。窄位宽元素 + 共享块缩放,撑起动态范围。 • HWPE 的集成范式。Engine、Controller、Streamer 三层分离,便于独立验证。 • 参数化的硬件粒度。三个参数正交可调,覆盖多个设计点。
各模块各司其职:
• 参数包回答“做多大”。它把设计空间压缩成少数几个数字。 • 引擎回答“怎么连”。它只做集成,不做算术。 • 阵列回答“怎么算”。它执行公式 2 到 3,以及矩阵形式 2b。 • 缓冲区回答“怎么攒”。它用双端口消除结构性冒险,执行公式 M4。 • 量化器回答“怎么出”。它执行公式 5 与 M6,闭合数据通路。
数学上只有六条核心公式:
吞吐、点积、矩阵乘法、缩放融合、迭代次数、量化。
其余都是围绕这六条公式的数据搬运与控制。
沿这条线索阅读源码,比逐个文件死抠实现细节,更容易建立整体直觉。
从设计方法上看,MXCore 还提供了一个可借鉴的模板:
• 参数先行:先把设计空间抽象成少数几个数字。参数正交,实验才可解释。 • 分层验证:计算核心与外围层分开。回归范围可预期,问题定位更快。 • 边界外置:把“什么时候算完”从数据通路中剥离。控制逻辑小,时序更稳。 • 通道分离:用双读端口消除累加与输出的结构冒险。吞吐提升来自结构,而不是频率。 • 矩阵嵌套:把 MX 的“元素 + 缩放”写成嵌套矩阵,硬件就自然分成块级与元素级两层。
这些做法不依赖具体格式,也不依赖具体工艺。
它们对其它窄位宽加速器同样适用。🚀