ARTICLE · 1240234
6 种 KV Cache 量化方法,图解说明
2027 年真正的护城河,跟智能体本身其实没多大关系,而在于捕获全栈轨迹(full-stack trajectories)。
想象一下:两个团队在同一天、基于同一个模型发布了同一个智能体。竞品发布完就翻篇了;而你发布的智能体,会从每一次会话中学习——用户在哪些地方介入过、哪些操作是手动完成的、哪些需求被反复提起。
每过一周,它就多掌握几项新技能,多积累一批评测集和数据集。
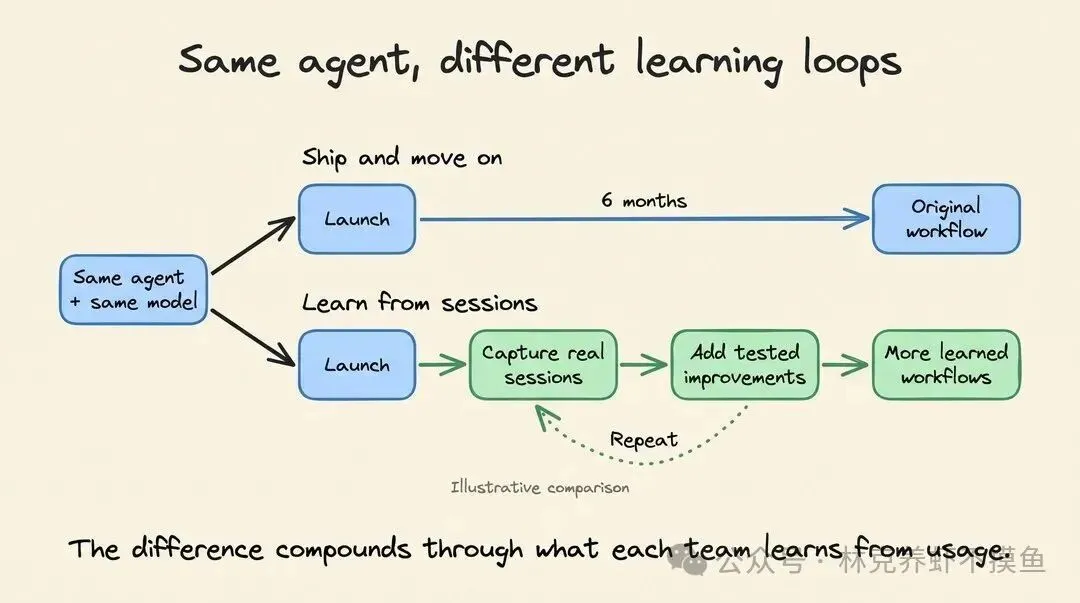
六个月后,你们其实已经不在同一个产品维度上竞争了。因为优势不在模型,而在你用户的数据。
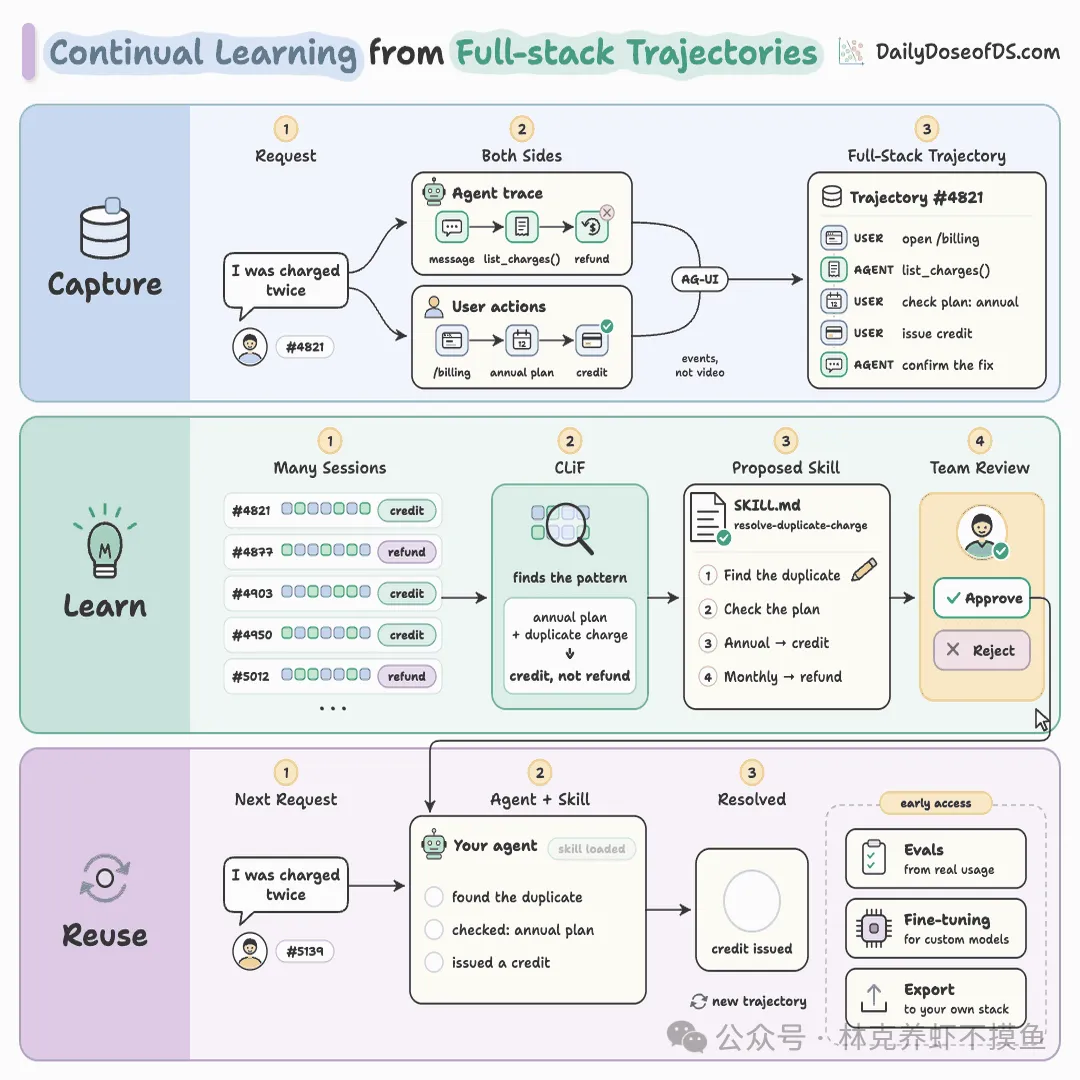
CLiF(https://go.copilotkit.ai/get-clif) 是内置在 CopilotKit 里的一套全新学习平台,它能看到每一条轨迹:
The trace(轨迹):智能体走过的每一步 The product(产品侧行为):用户在产品里做过的每一件事
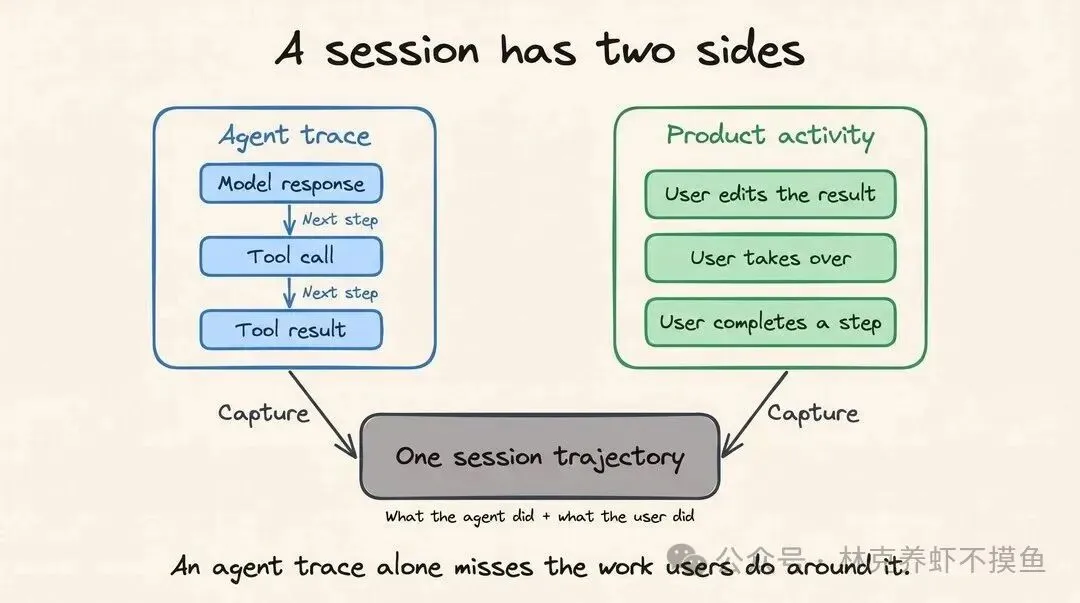
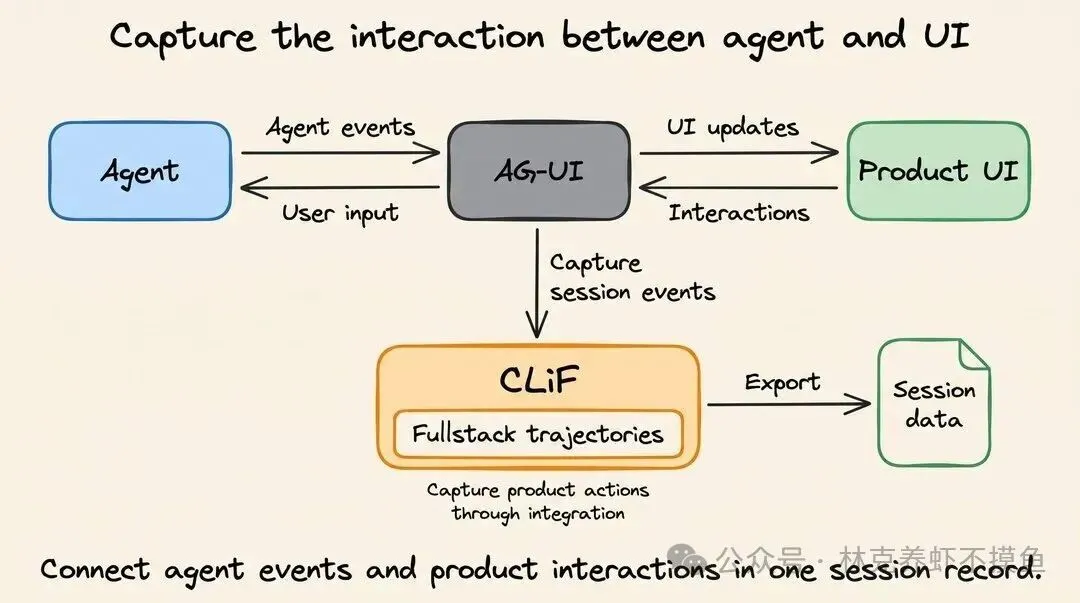
AG-UI 协议本来就处在智能体与 UI 之间,因此它能同时看到两侧,并把真实会话转换成可导出的全栈轨迹、评测集、技能和微调模型。
你可以自托管,入口在这里:https://go.copilotkit.ai/get-clif
如果你正在做面向用户的智能体,我们的建议是:现在就开始收集这些数据。
CLiF 已经实现好了达成这一点所需的整套持续学习基础设施。我们正在做一个实操 demo,很快会分享出来,敬请期待!
量化模型权重,并不会自动缩小 KV cache。
权重存储的是模型学到的参数;KV cache 存储的是处理请求时计算出来的 key 和 value。降低其中一者的精度,并不会自动改变另一者。
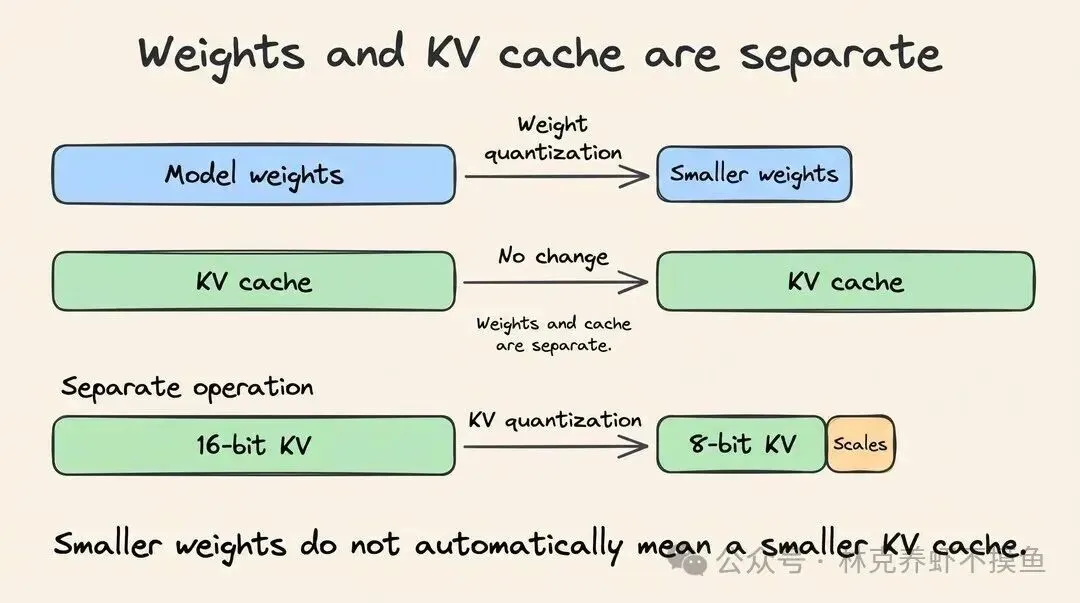
随着请求保留的 token 越来越多,cache 会不断膨胀;而并发请求还需要各自的空间来存放自己的条目。KV 量化减少的,正是存储这些条目所用的字节数。
举例来说,从 16-bit 降到 8-bit,原始的 KV 数据量直接减半。但把 scale、其他元数据以及任何高精度 buffer 都算进去之后,整体节省就没那么可观了。
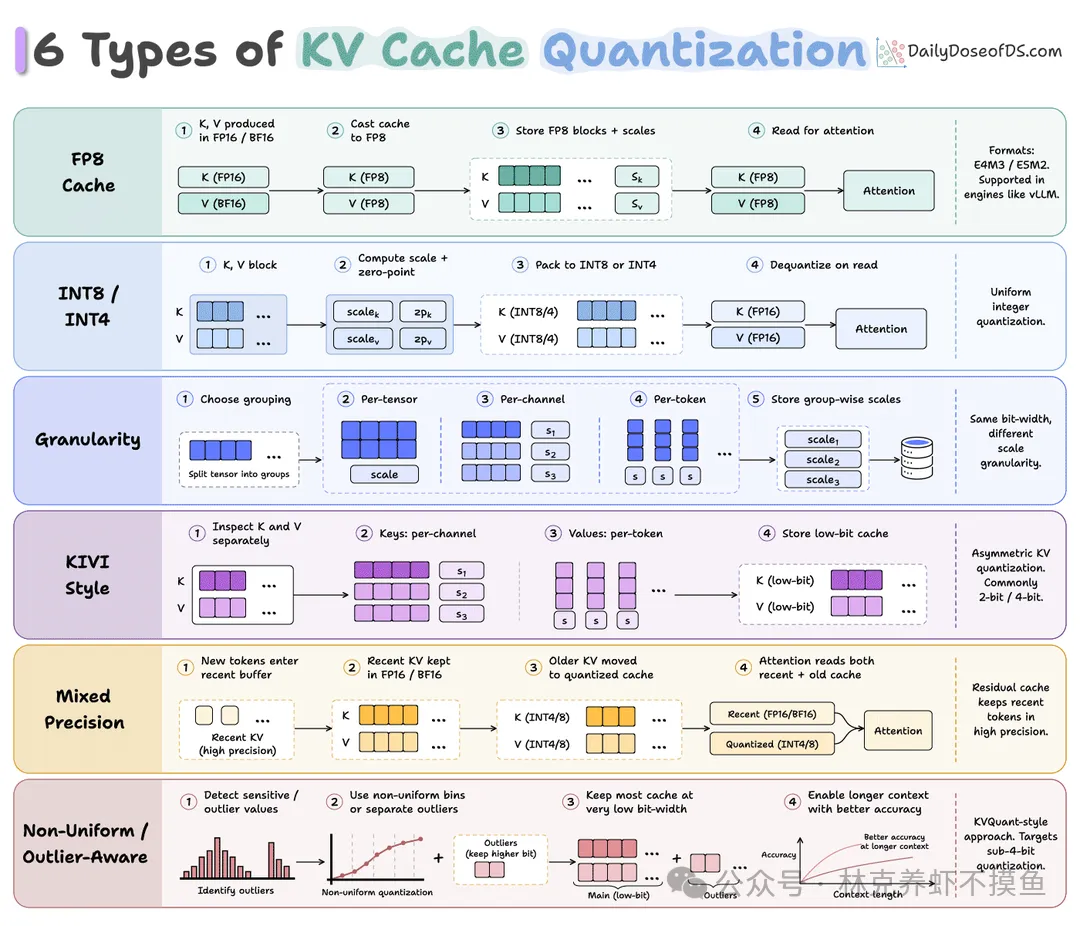
下面这六种方法,描述的是 KV 量化内部的不同取舍。其中几种可以叠加使用,比如 4-bit 整数、小量化分组,再配一个存放近期 token 的高精度 buffer。
1. FP8 cache
使用 FP16 或 BF16 的 cache,每个数字占 16 bit。FP8 只占 8 bit,因此同样数量的条目,占用的原始空间减半。
一个 scaling factor 会把数值调整到适配 FP8 的取值范围。实现上会保留这个 scale,让 attention kernel 能正确解读存下来的数字。
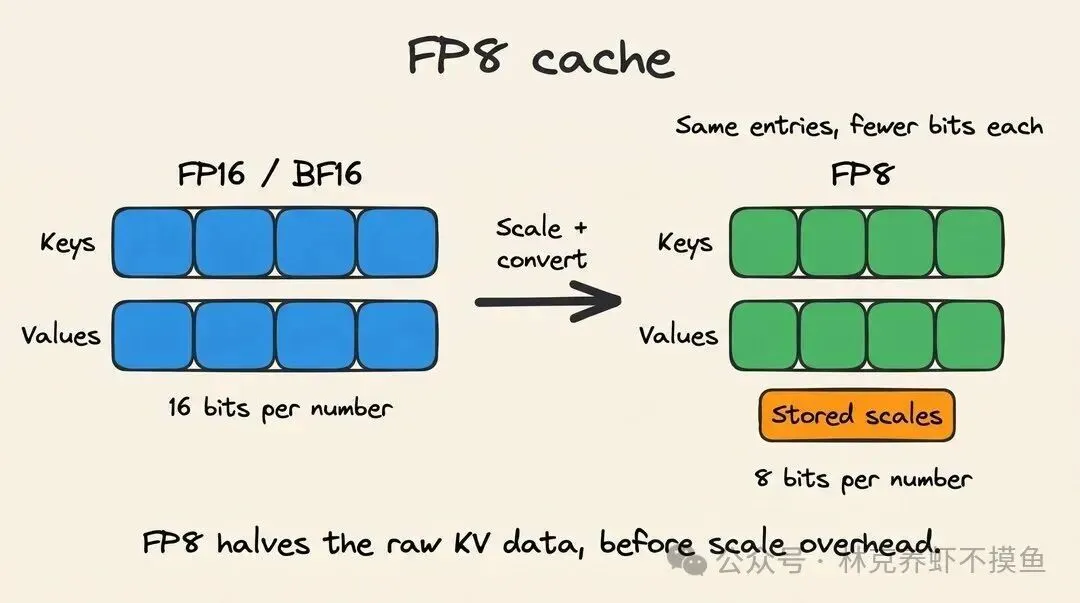
例如,1 GiB 的 16-bit KV 数据会变成 512 MiB 的 FP8 数据——这还没算 scale 和其他开销。
模型权重占用的空间不变,除非你另外单独对它做量化。serving engine 和 GPU 需要一个兼容的 attention kernel。单靠 FP8 存储,并不能决定这个 kernel 能跑多快。
2. INT8 / INT4 cache
这类方法用 8-bit 或 4-bit 整数来表示缓存里的数字。一个 scale(有时再加一个 zero-point)告诉 kernel 这些整数该如何映射回近似值。
INT8 有 256 个可选整数级别;INT4 只有 16 个,因此占用存储更少,但取整时能做的选择也更少。
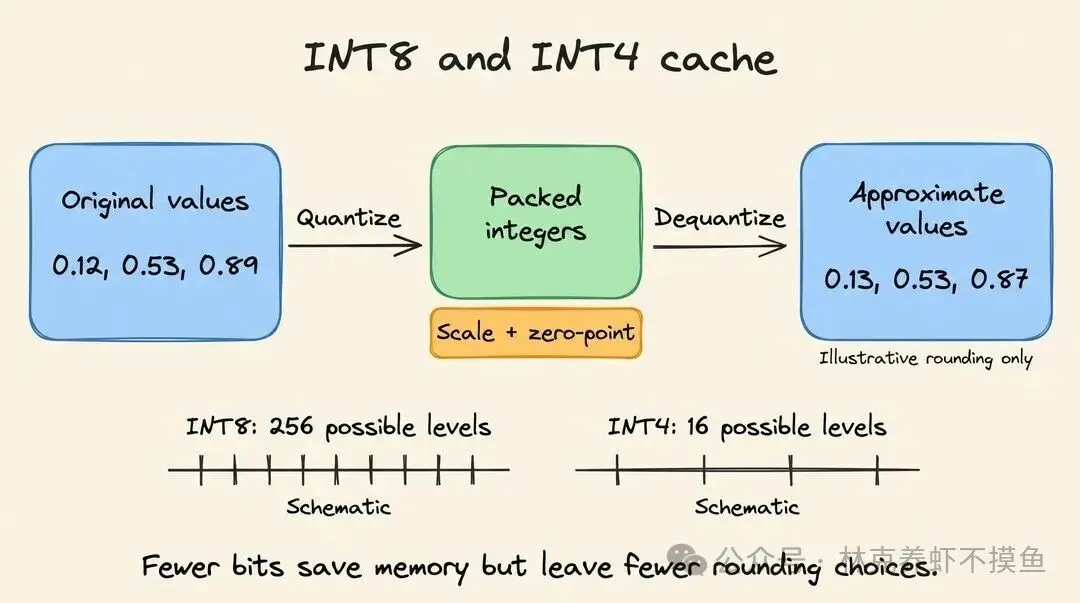
例如,两个很接近的值在 INT4 下可能被取整到同一个级别。反量化回来之后,attention 就无法再精确区分它们了。
kernel 会对存储的条目做 unpack 和 dequantize,而且往往就在 attention 计算过程内部完成。这部分额外工作,会抵消掉一部分“读更少字节”带来的收益。
3. 量化粒度(Quantization granularity)
粒度决定的是多少个数字共用一个 scale。
你可以让一个 scale 覆盖整个 tensor,也可以让不同的 scale 分别覆盖 channel、token 或更小的分组。
假设一组里大多数数字都落在 0 到 1 之间,但有一个是 20。包含 20 的那个共享 scale,会让可用于区分小数字的取整级别变少。
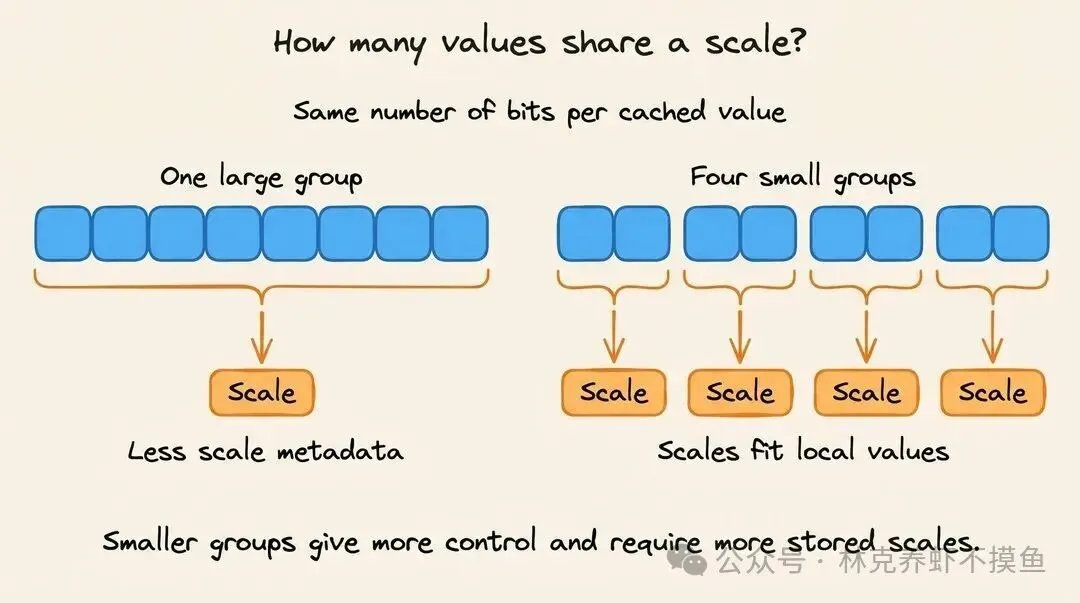
更小的分组,能限制这个离群值所能影响到的其他数字的数量。但每个分组都要有自己的 scale,而 scale 本身也占内存。
两个实现都用 4-bit 数值,实际的总内存占用和精度仍可能不同——差别就在于它们共享 scale 的方式不一样。
4. KIVI 式量化
KIVI 对 key 和 value 采用不同的分组规则。它的分析发现:异常大的 key 值往往集中在某些特定 channel 上,而 value 呈现的是另一种模式。
channel 指的是 key 或 value 向量中的某一个坐标。KIVI 会把一个 token 块内、同一 channel 的 key 分为一组,让该 channel 在这个块内拥有自己的 scale。
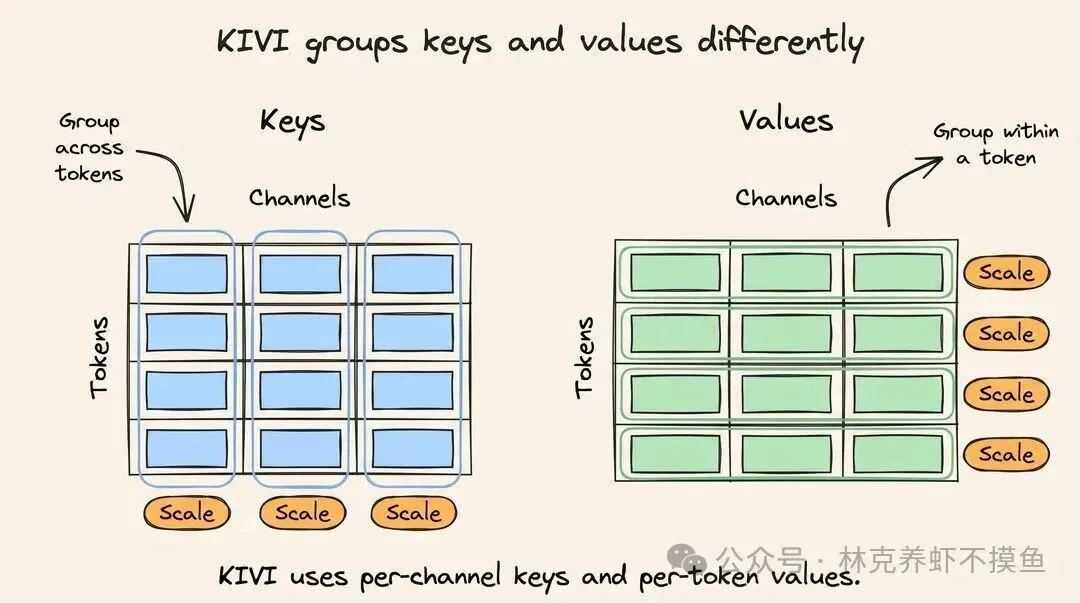
而对于 value,它则在每个 token 内部进行分组。这样一来,某个 token 的 value 范围就不会决定其他所有 token 的 scale。
原始方法瞄准的是在不微调模型的前提下实现 2-bit KV 存储。它的分组规则有助于控制取整误差,但精度仍然需要在你实际服务的模型和工作负载上验证。
5. 混合精度(Mixed precision)
一种混合精度做法是:把近期(recent)的 key 和 value 放在高精度 buffer 里,而把较早的条目存进量化后的 cache。
新条目先进入 buffer;buffer 填满时,实现会把一整块条目量化,然后移入压缩区。
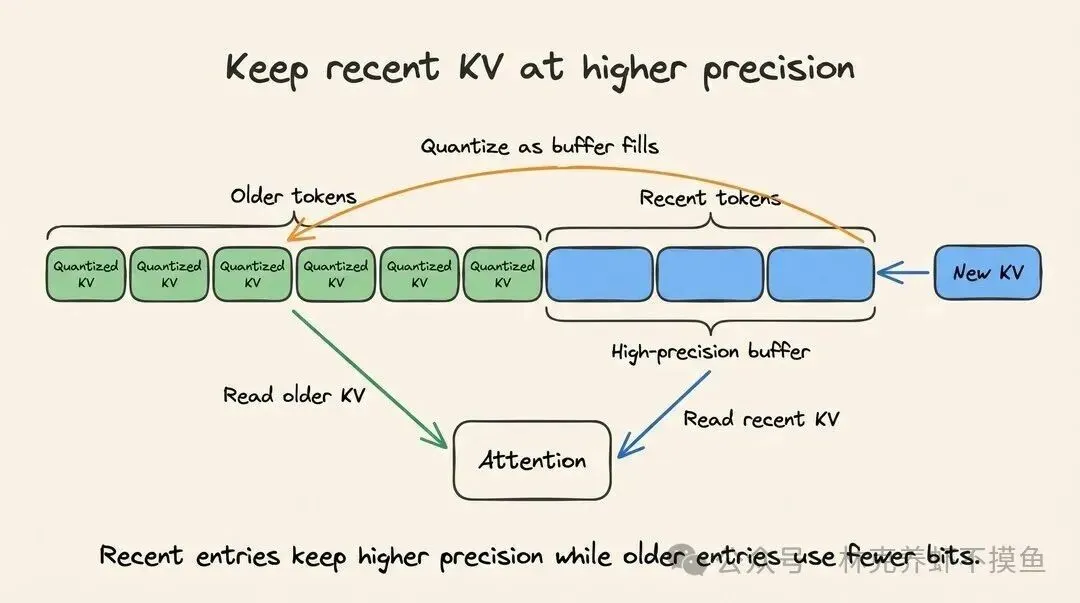
解码时,attention 会同时读取两部分。近期条目只要还留在 buffer 里,就不受量化误差影响。
buffer 越大,越多条目保持高精度,但内存节省就越少。这种做法还能帮你攒够 token 以便按块量化 key——正如 KIVI 所做的那样。
6. 非均匀 / 离群值感知量化
均匀量化把数字取整到等距的级别上。非均匀量化则改变这个间距,分配级别以更好地表示数值分布,或保护敏感值。
例如,如果大量数字聚集在 0 附近,就可以在那里放更多级别,而不是把级别均匀铺在很宽的区间上。
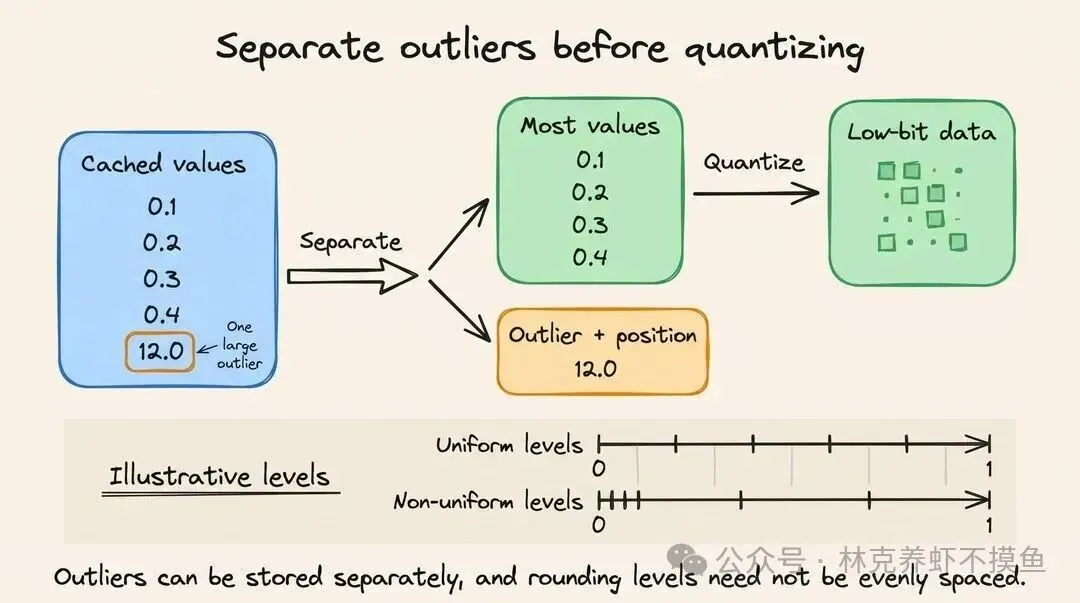
离群值处理解决的是一个相关问题。KVQuant 把异常大的值拆到稀疏存储里,同时保留它们的位置,让 kernel 在算 attention 时能加以考虑。
剩下的值就可以使用更窄的取值范围。被单独拿出来的离群值及其位置都会带来开销,因此内存成本不只是低位数据本身。
用成本来检验收益
更小的 cache 可以在同一张 GPU 上容纳更长的上下文或更多请求。
解码是否更快,取决于减少的内存访问量能否超过额外量化计算带来的开销。
请与未量化的 cache 做对比:使用同一个模型、同样的 prompt、相同的输出长度和并发度。检查总内存占用、解码延迟,以及在你应用真正关心的长上下文任务上的回答质量。
我们在 LLMOps 课程里把所有这些都覆盖到了,从基础一路讲到生产实践:
阅读第 1 部分:LLMOps 基础 →(https://www.dailydoseofds.com/llmops-crash-course-part-1/) 阅读第 2 部分:理解 LLM 的核心构件 →(https://www.dailydoseofds.com/llmops-crash-course-part-2) 阅读第 3 部分:LLM 的关键组件,聚焦注意力机制、transformer 与混合专家(MoE)架构,以及预训练与微调的基础 →(https://www.dailydoseofds.com/llmops-crash-course-part-3) 阅读第 4 部分:解码策略、生成参数、最佳实践,以及 LLM 应用的完整生命周期 →(https://www.dailydoseofds.com/llmops-crash-course-part-4) 阅读第 5 部分:系统视角下的上下文与提示工程、上下文学习、提示类型与各类提示技巧 →(https://www.dailydoseofds.com/llmops-crash-course-part-5) 阅读第 6 部分:提示版本管理、防御式提示,以及 verbalized sampling、角色提示等技巧 →(https://www.dailydoseofds.com/llmops-crash-course-part-6) 阅读第 7 部分:上下文工程,涵盖上下文类型、上下文构建原则,以及构建高信噪比输入的检索-centric 技巧 →(https://www.dailydoseofds.com/llmops-crash-course-part-7) 阅读第 8 部分:LLM 系统中的记忆、动态与时序上下文,涵盖短期/长期记忆、动态上下文注入,以及智能体应用中的常见失效模式 →(https://www.dailydoseofds.com/llmops-crash-course-part-8) 阅读第 9 部分:LLM 应用的评估方法与路径,重点建立对基础概念的扎实理解 →(https://www.dailydoseofds.com/llmops-crash-course-part-9) 阅读第 10 部分:LLM 应用中的评估基准、任务特定方法论,以及评估 LLM 应用的核心工具链 →(https://www.dailydoseofds.com/llmops-crash-course-part-10) 阅读第 11 部分:多轮系统的评估、工具使用评估、追踪(tracing)与红队测试 →(https://www.dailydoseofds.com/llmops-crash-course-part-11) 阅读第 12 部分:LLM 微调、LoRA 与 QLoRA 等参数高效方法,以及 RLHF、DPO、GRPO 等对齐技术 →(https://www.dailydoseofds.com/llmops-crash-course-part-12/) 阅读第 13 部分:LLM 推理优化、KV caching、PagedAttention、FlashAttention、投机解码与模型并行 →(https://www.dailydoseofds.com/llmops-crash-course-part-13/) 阅读第 14 部分:LLM serving 基础,包括 API 接入、用 vLLM 做推理,以及实践中的取舍决策。(https://www.dailydoseofds.com/llmops-crash-course-part-14)
我们还写了一篇开放获取的 KV Cache 工程文章(https://www.dailydoseofds.com/p/kv-cache-engineering-for-llm-serving/),覆盖量化以及其他降低 cache 内存的方法,并附代码示例和各自的取舍。在这里阅读 →
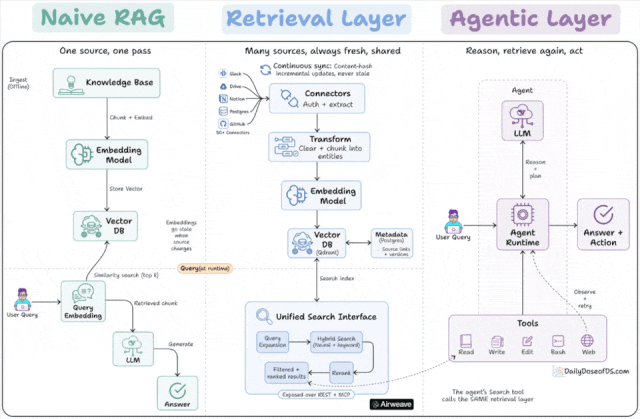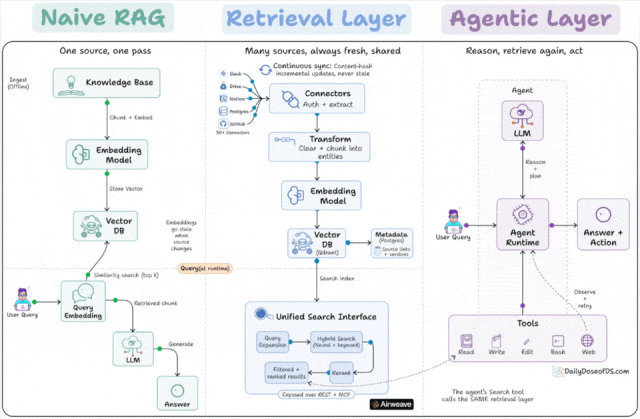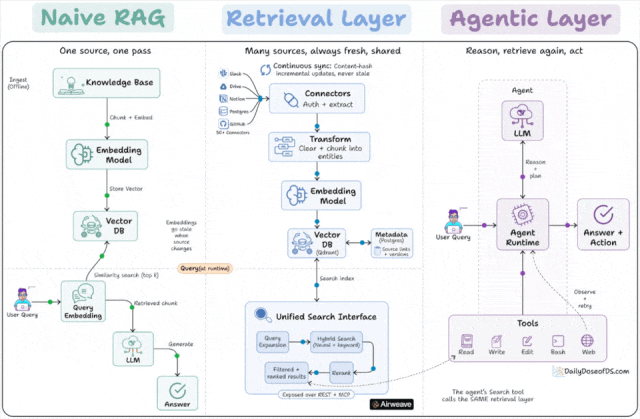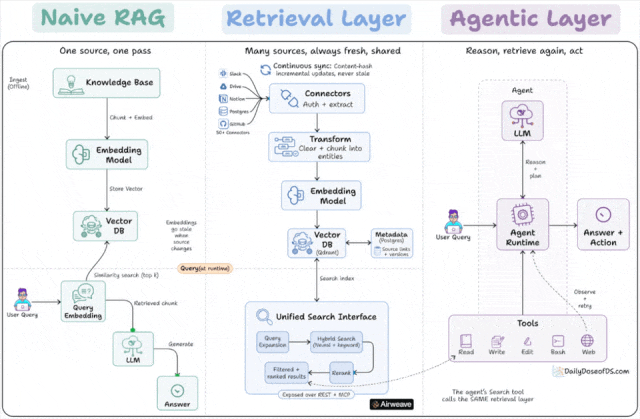
Google 和 Anthropic 在 RAG 上有一点是共识:检索不再是一条你一次性搭好的流水线,而是一个被别的东西调用的工具。
Anthropic 的 MCP 把检索暴露成智能体可以调用的一个 tool。 Google 现在也以同样的方式提供检索,其 RAG Engine 就位于 Gemini 智能体平台之下,与 MCP server 并列。
这个转变听起来很小,但它改变了底下的整个架构。今天我们就来拆解三件事:为什么经典 RAG 在生产环境并不理想、一个常驻检索层长什么样,以及智能体如何消费它。
古典 / 朴素 RAG
朴素 RAG 是单个应用内部的一条一次性流水线:知识库被切块、embedding、写入向量数据库;查询时,用户 query 打到向量库做相似度检索,召回的 chunk 再送给 LLM。
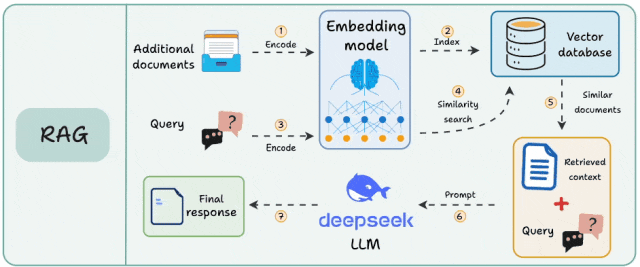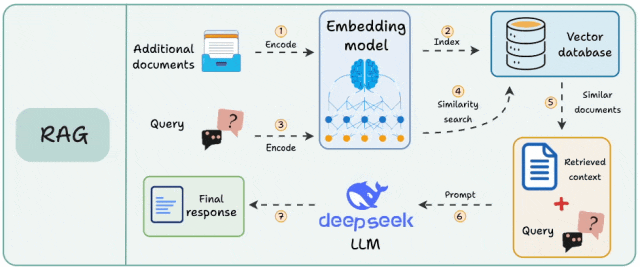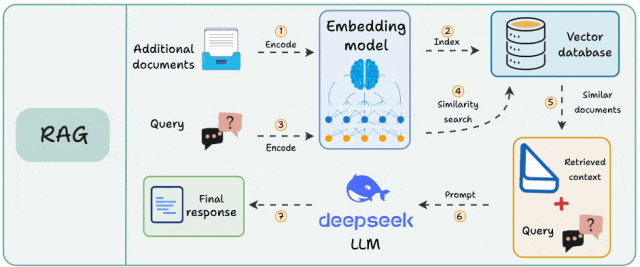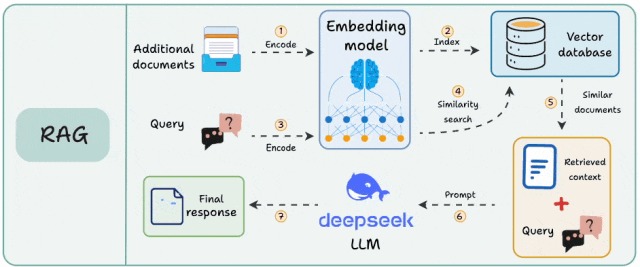
当答案只存在于一个很少变化的语料库里时,这套东西能跑通。但在规模化时,它会立刻在两个方面崩掉。
第一个是陈旧(staleness)。embedding 反映的是建索引那一刻的源内容。当 Notion 里一个文档改了、或 Postgres 里一行更新了,向量仍指向旧内容,直到有人重跑整条流水线。
第二个是重复(duplication)。检索逻辑被焊死在单个应用上。第二个应用或智能体如果需要同样的数据,就得从零重建同样的连接器、切块和 embedding 流程。
检索作为常驻层
修法是:别再把检索当成应用内部的一个步骤,而要把它当作应用之下一层常驻的基础设施。
检索层把写入(ingestion)与查询分离,并让 ingestion 持续运行,而不是只跑一次。
在写入侧,连接器从多个数据源拉取内容、处理鉴权与抽取、按实体切块、做 embedding,再写入向量库——同时配一个元数据存储,用来保存来源链接和版本信息。
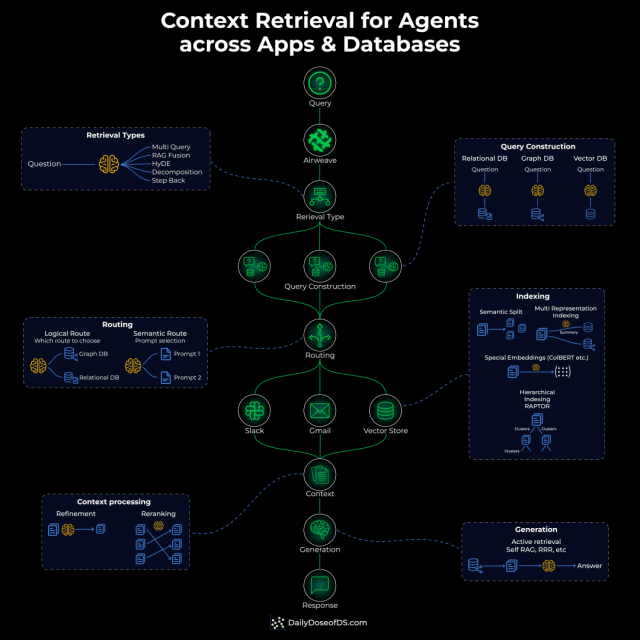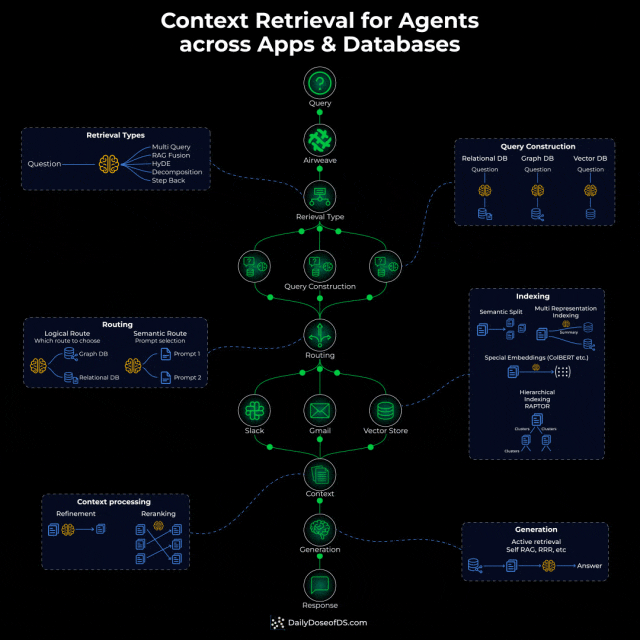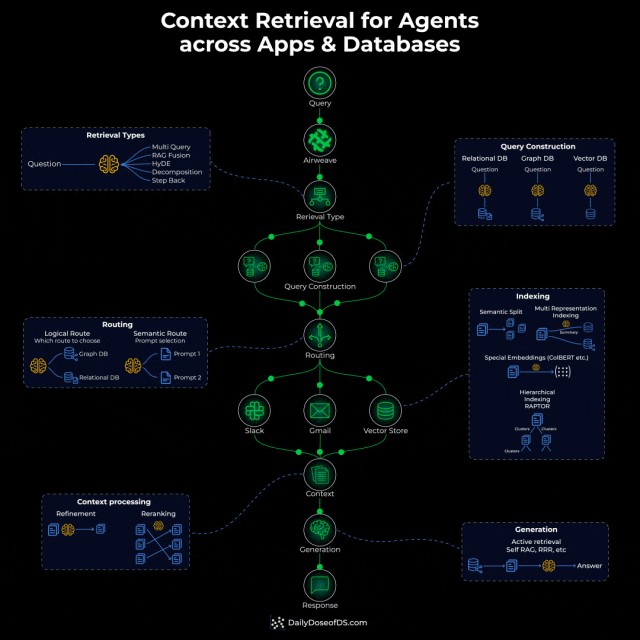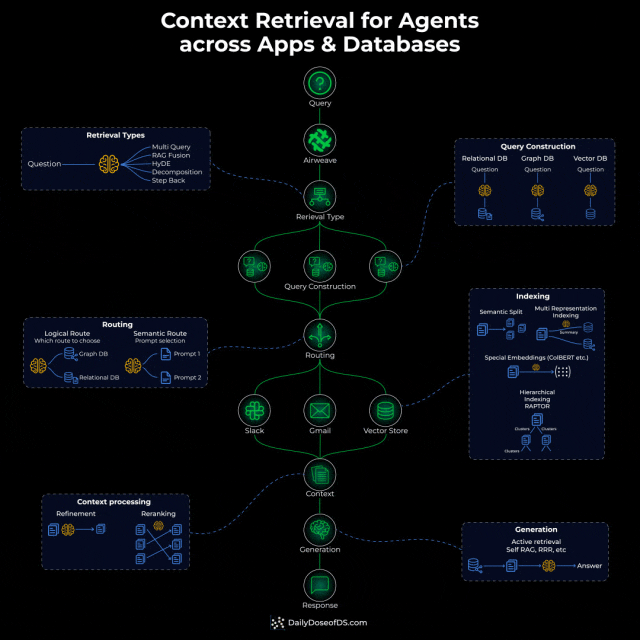
同步进程监听变更,只更新变化了的部分,并通过内容哈希避免对未变更的数据重新做 embedding。
在查询侧,请求先被扩展,再走结合神经检索与关键词检索的混合搜索(hybrid search),然后重排,最后带着来源归属(source attribution)返回结果。
关键特性是:这一层不属于任何单个应用。它通过 API 暴露出去,因此一个 RAG 聊天机器人和一个自主智能体可以查询同一个索引。
智能体如何改变这个局面
智能体不会在一开始只做一次检索。它会推理,判断自己需要上下文,调用搜索,读取结果,再决定是否用更精细的 query 再搜一次。检索变成了循环里的一个工具,而不是固定的第一步。
而智能体调用的这个工具,正是检索层。
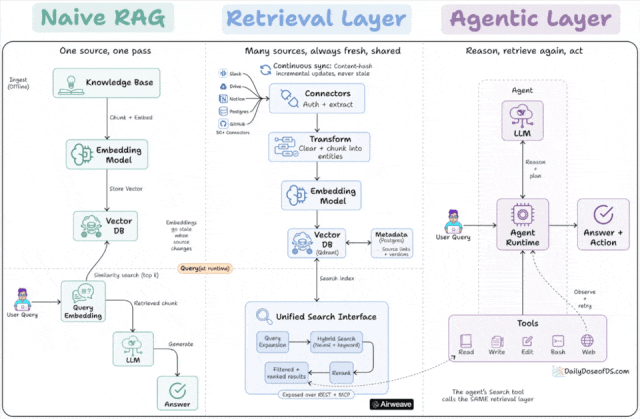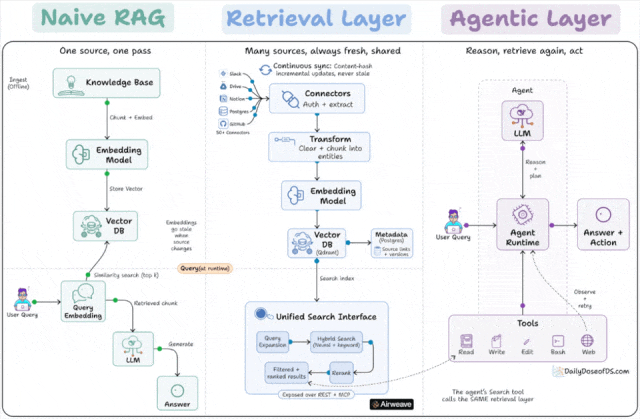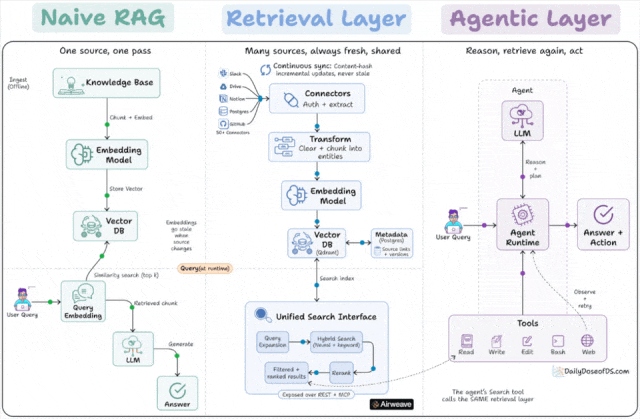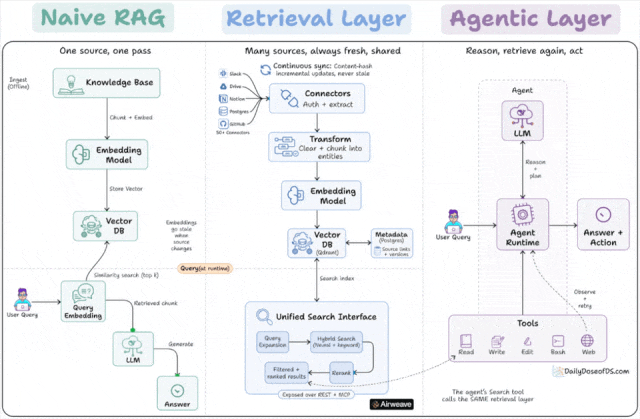
智能体的搜索函数与 RAG 应用的检索,其实是进入同一个已同步存储的同一条查询路径。它们从来就不是两套系统——只不过一个被画在了应用内部,另一个被抽出来共享了。
👉 交给你:把检索从应用里挪出来、放进一个共享层,对你的技术栈来说是对的选择吗?