ARTICLE · 1242236
我删掉 2998 篇文档,「重复」从 828 组掉到 35 组
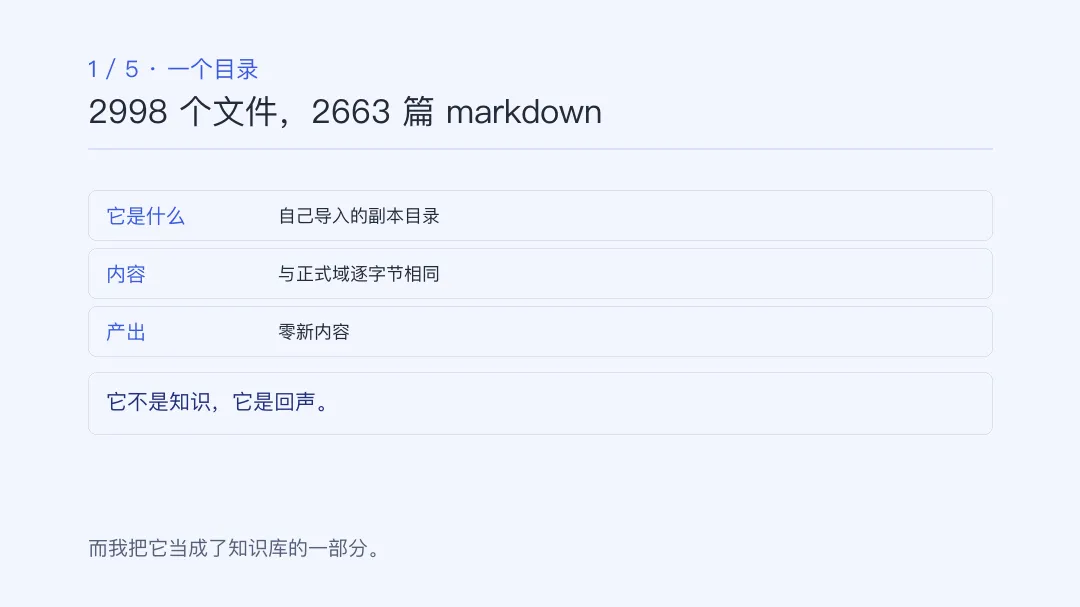
10 月 12 日,我把一个叫「95-WorkBuddy导入」的目录整个搬走了:2998 个文件,2663 篇 markdown。
搬完之后我第一次跑重复检测,结果从 828 组掉到了几十组。
我删掉的不是垃圾。是我自己半年前亲手导进去的"备份"。
1
它是什么
半年多以前,我从另一个工具把知识库导进这套系统。导完,原目录我没删。
它长得和正式知识库一模一样:同样的八个域,同样的文件名,同样的目录层级。
唯一的差别是:它不产生内容,它是副本。
2
它干了三件我一直没看见的事
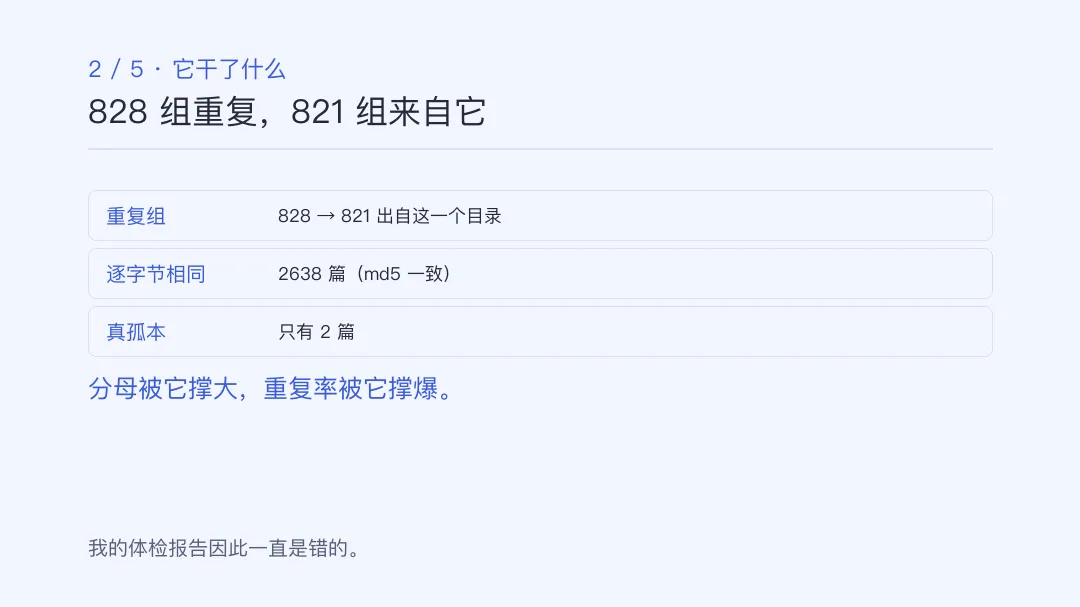
第一件,制造重复。当时测出的 828 组重复里,821 组来自它——其中 2638 篇和正式域逐字节相同,md5 一模一样。
第二件,污染分母。它不在检索索引里(索引只收正式域),但被算进了"总库存"。于是我的覆盖率永远差着两千多篇,看起来像"我有一大堆东西没进索引",其实那堆东西根本不该存在。
第三件最贵:浪费判断。我每次改完一份文档,都要额外确认一遍"我改的是哪一份"。这种确认不产出任何东西,但它每天都要花掉几分钟。
3
我为什么一直不敢删
怕删掉孤本。
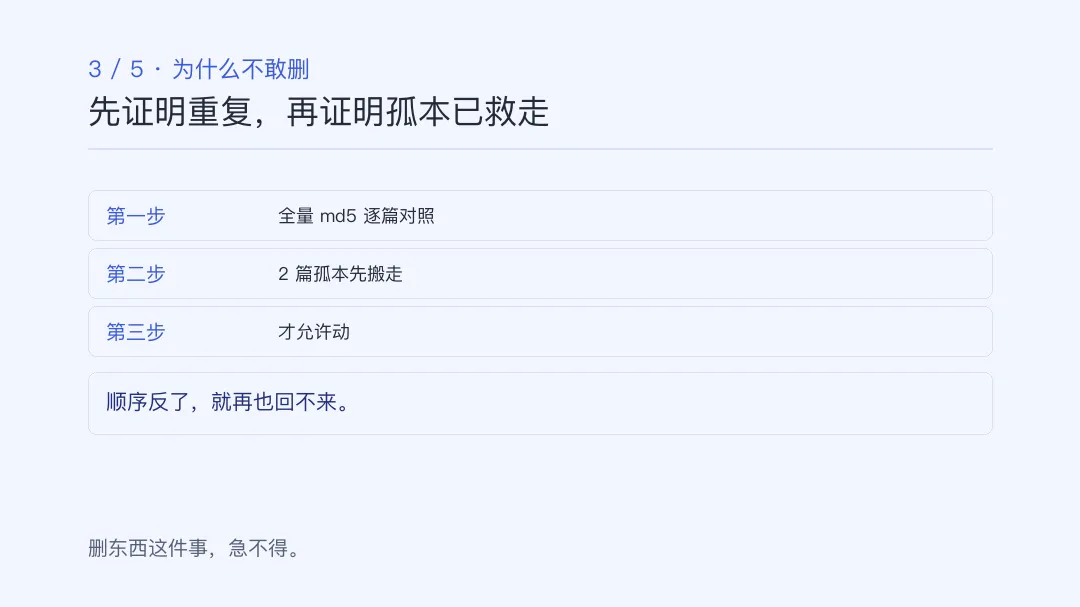
所以搬之前我先做了一件事:全量 md5 对照,一篇一篇比。结果很清楚——2638 篇逐字节相同,真·孤本只有 2 篇。
那 2 篇我先单独抢救到正式域,然后才动整个目录。
搬的时候留了完整的清单(每一篇的 md5),放在备份目录里。真有一天要还原,照着清单能一比一还原。
删东西这件事,我现在的做法是:先证明它真的重复,再证明孤本已经救走,最后才允许动。
4
一个知识库,五个副本
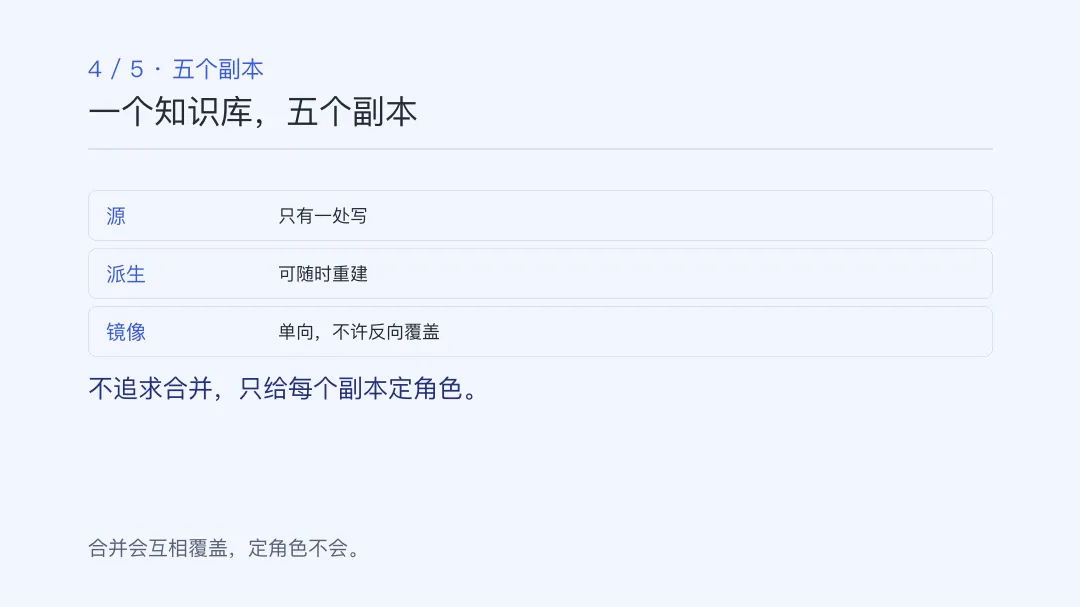
那次体检还顺带查出另一件事:同一个知识库,在我这台机器上有五个版本——知识库本体、向量库、Obsidian 主库、Obsidian 工作库、还有这个导入副本。
我一开始想的是"把它们合并成一个"。试过之后才发现这条路是错的:合并会互相覆盖,而且你永远不知道最后留下的是谁的内容。
后来改成一个更笨但更稳的办法:给每个副本定角色,不追求合并。
· 源只有一个,人写的,不能自动重建
· 派生层只在本机重建,不参与同步
· 镜像只许往一个方向流,永不回灌
5
更贵的一课:镜像会偷偷回灌
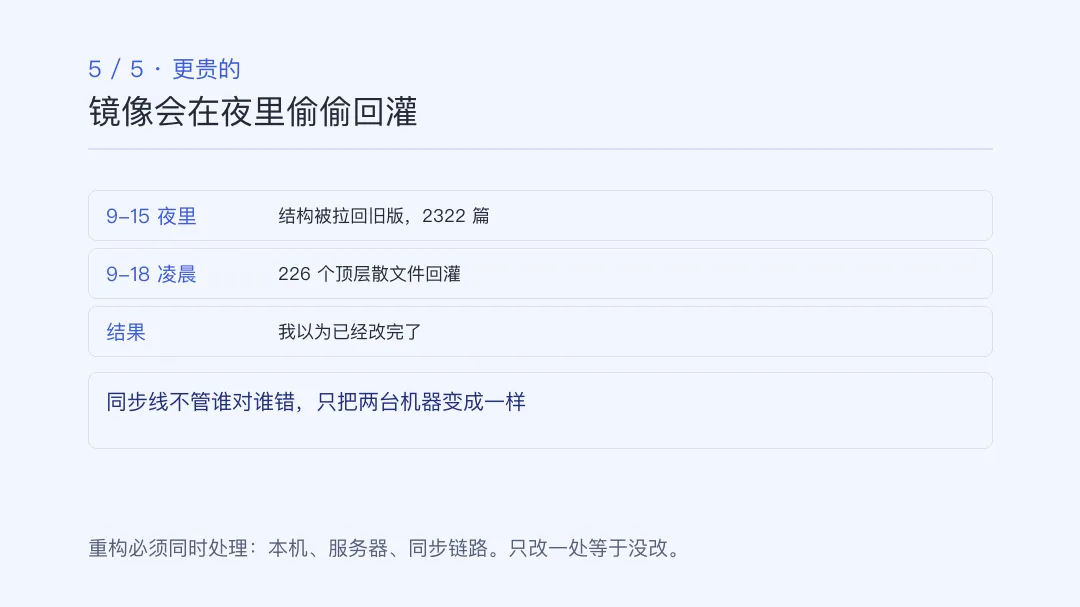
9 月 15 日夜里,我把知识库重构成八个域。第二天早上打开,结构变回了旧的——夜间同步把云端的老结构拉了回来,一次加回 2322 篇。
9 月 18 日又来一次:226 个顶层散文件被同步拉回本地。
最难受的不是回弹,是我的哨兵全程没响。后来查清楚:那个哨兵只查目录结构,不查文件——结构看着是干净的,所以它认为一切正常。
修了两处:同步只同步源(派生层排除在外);哨兵从"目录级"改成"文件级",顶层散文件超过 5 个就告警。
只改本机等于没改。 重构这件事,本机、云端、同步链路,三个地方必须同时处理。
6
今天的数据
同一个口径源,今天早上刚跑:
· 重复:35 组 / 多出 37 份(那次是 828 组)
· 库存 md:3438 篇
· 治理记分:17/21 = 81%
搬走的 2998 个文件里,没有一篇是我真正需要的内容。
所以这一次治理,我没让自己多存任何东西。它只是让我少存了 2998 份"看起来像知识"的东西。
数据治理里最反直觉的一件事:有时候指标变好,不是因为你加了什么,是因为你终于承认有些东西本来就不该在那儿。
关于这个号
一个用 AI 干活的人,每天记一笔。写踩过的坑、核过的数、改过的地方。不写趋势,不写预测,只写我手里这台机器真发生了什么。