ARTICLE · 1286090
2026 年 CSP-J 第二轮(复赛)试题解析与考情深度复盘
字数 14570,阅读大约需 73 分钟
2026 年 CSP-J 第二轮(复赛)试题解析与考情深度复盘
新东方优编程教练组 · 2026 年 10 月
本文为优编程教练组针对 2026 年 CCF CSP-J/S 第二轮认证入门组(CSP-J)真题的完整解析。四道题——旅游(travel)、回文串(string)、按位与(and)、纸牌游戏(card)——我们已逐题完成题意拆解、部分分梯度、正解推导与代码验证,并对照我们赛前发布的《2026 年 CSP-J 第二轮备考分析及考点预测》,对考情作一次系统复盘。
卷首语:这一届,拿一等靠稳,冲高分靠观察
同学们考完了,先别急着对答案。让我们教练组说句实在话:这一届 CSP-J,拿一等靠的是稳,冲高分靠的是观察。
四道题摆下来,T1、T2 是我们反复强调的"送分题 + 基础题",T3 是一道连续第二年把位运算放在区分位的按位贪心题,T4 是一道"观察规律 + 递推"的思维型压轴题。整套卷子没有一道超出 NOI 大纲的偏题怪题,每一道题都能用我们课堂上讲过的知识拆解。一等线附近比的,是"你能不能把题意读准、把边界想清、把部分分拿满";再往上拉开档次的,是 T3、T4 能不能看出关键性质。
这正是我们赛前预测里最想传递的那句话:2025 年偏易,2026 年大概率会"适度回调"——题目不会突然变难变怪,但区分度会重新立起来。 从结果看,"区分度重新立起来"完全兑现:T4 比去年高出一档。整体难度则没有回调,与去年相当、比 2024 年更友好——T1 比去年更容易,T3 与去年持平。
下面,我们先把整套卷子的"大盘"看清楚,再一题一题地给同学们讲透。
一、总体分析:难度、分数线与命题方向
1. 四题总览
先说结论:我们在赛前预测中反复强调的"难度梯度"——T1/T2 基础、T3/T4 拉开区分度——与今年的真实命题结构完全一致。 这是本次预测最值得肯定的一点,也是同学们在备考中最该信任的一点。
2. 难度梯度:结构拉开,与我们赛前判断高度吻合
我们赛前给出的原话是:
"2025 年 J 组偏易,2026 年大概率适度回调,T3、T4 难度比 2025 略有上升,T1、T2 仍是基础题。"
把这套卷子放进近两年里看,整体的难度坐标是:与 2025 年相当、比 2024 年易,但难度结构明显拉开了。 逐题对照如下:
1. T1 旅游:回到入门档,比 2025 年《拼数》更易,与 2024 年《扑克牌》同档。✅ 赛前"T1 是基础送分题"完全兑现,甚至比预期还友好。 2. T2 回文串:与近两年 T2 同档,但多了一道复杂度门槛——展开后最长 200 万亿个字符,必须按段处理。✅ 赛前"T2 是基础档"兑现。 3. T3 按位与:与近两年 T3 难度持平,同样是"一个关键转化 + 贪心"。赛前我们预计 T3 会略有回升,实际持平。 4. T4 纸牌游戏:比 2025 年《多边形》高出一档(普及+/提高),比 2024 年《接龙》低一档。✅ 赛前"T4 难度比 2025 年上升"兑现。
一句话总结:赛前我们说"T1、T2 基础保底"完全准确;"后两题难度比 2025 回升"兑现了一半——T4 上浮,T3 持平。 所以今年是"结构拉开"而不是"整体变难":最难的题更难了,中低档的题更友好了,区分度由此重新立了起来。
3. 分数线走势:中段更扎实、选手更强,小幅走高 5~10 分
看分数线,不能只看题目难度,还要看"选手水平"这股被很多人忽视的力量。先把两组官方数据摆出来:
CSP-J 全国一等基准线(入门级)
| 260~265 |
北京一等线(强省代表)
| 270~275 |
2024、2025 两年分数线的跳涨,根源在于题目变易、高分扎堆。今年整体难度与去年相当,影响分数线的是两股力量,而且它们作用在不同的分数段:
力量一:题目结构拉开——顶端更难,中段更好拿。 T4 上浮一档,看不出关键性质的同学会停在 60 分左右,满分段人数会比去年收缩;但 T1 比去年《拼数》更易,四题的部分分又设计得特别足——T1 按规则判断就是满分,T2、T3、T4 不写正解也能分别拿到 68 / 75 / 72 分。一等线落在中段,主要由前两题和各题的部分分决定,T4 的满分门槛只影响高分段。也就是说,"会一部分、不会全部"的同学,今年能稳稳拿到中段的扎实分数。
力量二:选手水平整体上了一个台阶。 这是近几年最明显、也最容易被忽视的变化——GESP 考级在小学阶段普及,大量孩子在满 12 周岁、能够报名 CSP-J 之前,就已经完成了系统的算法训练,进入 CSP-J 时起点明显更高(本文第 6 节有详细对照)。学生整体变强,意味着同样的题,高分段人数更多、分数更"实"。
两股力量叠加的结果是:T4 的难度只压低了满分段;一等线所在的中段,因为 T1 更易、部分分充足、选手整体变强而更加密实,分数线大概率小幅走高 5~10 分。
我们教练组给出的推演是:
全国一等基准线大概率从 255 分小幅上行到 260~265 分;北京一等线大概率从 265 分上行到 270~275 分。强省(重庆、浙江、广东等)一等线继续走高,头部省份或再度逼近、甚至创出新高。
这个判断,与我们赛前预测文章里的两个趋势判断完全同向:一是命题会越来越重视"把暴力分和部分分给足",二是 GESP 训练前置化、选手端的水位持续上涨——今年这两点同时兑现了。
同学们需要注意的是:分数线上涨,不意味着整套题变简单,也不等于拿一等更容易。 今年整体难度与去年相当,T4 还难了一档;分数线上涨,一是因为 T1 更易、部分分更足,中段分数更扎实,二是因为选手整体变强。分数线附近同分选手扎堆,丢一个细节分就可能掉一个档次——只有把该拿的分一分不丢地拿满,才能稳稳站在线上。
4. 命题方向:三个新信号,两个深层趋势
抛开"预测准不准"不谈,今年的命题里藏了三个趋势信号,我们教练组把它们点出来,供明年、后年备考的同学参考:
信号一:位运算连续两年坐镇 T3,而且越考越深。 早年的位运算多以进制拆分的形式出现在 T1 送分位(如 2020 年《优秀的拆分》),考的是"你会不会写 %2、/2"。2025 年 T3《异或和》把位运算放进了区分位,考的是前缀异或的性质;今年 T3 继续考位运算,升级为"按位与 + 按位贪心",位运算从"基础语法"变成了"思维核心"。这提醒我们:任何基础知识点,都要往"它能怎么变形、怎么上移"的方向去理解,不能因为它过去送分就轻视它。
信号二:字符串题开始考"压缩表示"。 T2 回文串表面考回文,实质考的是行程编码(Run-Length Encoding)——输入不是逐个字符,而是"连续一段 + 重复次数",且段长能到 。这种"给你一个压缩过的数据,逼你按段处理而不是展开"的考法,考的是复杂度意识,而不是字符串技巧,值得单独练一批。
信号三:压轴题从 DP 转向"观察规律"。 2024 年 T4《接龙》、2025 年 T4《多边形》都是动态规划(后者是背包计数);今年 T4《纸牌游戏》的满分不需要任何 DP 模板,靠的是观察出"首牌点数始终在最左端",再用递推合并计数,栈只出现在部分分里。这恰恰印证了我们赛前反复叮嘱的那句话:压轴题不能只练 DP 和图论,思维模拟题、数据结构题同样要储备。 连续两年 DP 之后换了类型,说明压轴题不会固定在某一类上,两条腿走路才稳。
除了这三个"考点信号",这套卷子在更深的层面还透出两个趋势,值得所有教练和家长重视:
趋势一:命题从"单纯模拟"走向"观察与优化"。 近两年的 T2《地图探险》《座位》以按规则模拟为主,照做就行;今年的 T2 字符串长到无法展开、T4 逐局模拟只能拿到一半左右分数,满分必须找出"局与局之间的关系"。照规则执行的能力,换个背景就要重学;先观察、再计算的习惯,却能带到任何一道新题上。
趋势二:数学性质成为解题关键。 2022 年《解密》、2023 年《一元二次方程》考代数,2025 年《异或和》以前缀异或为核心;今年的 T3 靠二进制位权逐位确定答案,T2 靠对称位置配对计数。数学不再是"额外加分项",而是"把题目转化成算法的工具"。
5. 透过试题看能力:出题组真正在考什么
把这四道题拆开看,它考的不是"学没学过某个算法",而是五种能力:
1. 阅读理解能力。 T1 的四问层层叠加,后三问都以"同一节车厢"为前提;T3 题面加粗了"恰好" m 个;T4 收走旧牌之后,新打出的牌还要放回最右端。读题的准确度,只能在按正式赛制进行的全真模拟里反复练出来。 2. 由数据范围推做法的能力。 T2 测试点 13~16 段数不超过 2000、段长却到 10 亿,提示按段计算;T3 测试点 18~19 数值小于 1024,提示枚举答案;T4 测试点 18~19 点数不超过 3000,提示按点数分组。我们国庆专项赛的五场题解,都是"从暴力逐档讲到正解",练的正是这条台阶。 3. 观察性质的能力。 T4 要发现"首牌始终在最左端"这条贯穿整局的性质;T3 要把"选哪 m 个数"转成"答案能否包含这些位"的判断。这类专项思维,需要在专题集训里集中打磨。 4. 成批计算的能力。 T2 把一段相同的字符一次处理完,T4 把首牌点数相同的局合成一组,都是把"逐个算"换成"成批算"。这类手法来自系统课程中成体系的模型积累,并通过 GESP 考级阶段性检验。 5. 细节严谨与按档拿分。 T2 样例 3 的答案 30 亿已超出 int;T3 的搜索不加剪枝,m = n 一档就会超时;T4 弹栈时不同步清除位置记录,被收走的牌会被当成还在桌上。
普及组拉开差距的,已经从"会不会写"变成了"能不能看出性质"。 这五种能力,恰恰是我们在备考中反复强调、在 GESP 考级和日常训练中持续打磨的方向。
6. 对照 NOI 大纲与 GESP:知识门槛不高,分差在观察
不少家长会问:今年题目这么"绕",是不是要提前学很多高级算法?我们的答案很明确——不需要,这套题的知识门槛并不高。
对照 NOI 大纲(2025 年修订版),全卷涉及模拟法、枚举法、字符数组与 string、位运算、贪心法、递推法和栈,部分分的搜索用到深度优先搜索,全部在入门级之内;四题满分用到的知识点,难度系数都不超过【3】。 换句话说,T4 只用入门级的递推,就考出了普及+/提高的思维深度——入门级的知识,已经足以考出有区分度的压轴题。
再对照 GESP C++ 认证标准,更是如此:
1. T1:三级(字符串与模拟法)即可满分; 2. T2:三级(一维数组与模拟法)可拿 68 分,满分另需四级的复杂度估算和一级就有的 long long; 3. T3:三级(位运算与枚举)可拿 70 分,满分的逐位确定属于五级的贪心; 4. T4:三级(数组模拟)加特殊性质可拿 48 分,六级(栈)到 72 分,满分只用一维数组和四级的递推。
按知识点计,只用三级的内容,四题合计就能拿到 286 分,越过一等线;从五级到满分,差的是观察,不是新算法。 这正是 GESP 标准设计的严谨之处——考级的分级与比赛的分档是对齐的。
考级分级与比赛分档对齐,意味着在 GESP 上扎实走到五级的孩子,满 12 周岁进入 CSP-J 时,已经具备冲一等的知识储备。按 2026 年衔接办法,GESP C++ 七级 80 分及以上、或八级 60 分及以上,可申请免 CSP-J 第一轮认证;八级 80 分及以上,还可申请免 CSP-J 或 CSP-S 第一轮(二选一)。CSP-J/S 要求报名者在当年 9 月 1 日前年满 12 周岁,对还不能报名的小学生来说,GESP 就是现阶段检验与积累的主要途径——大量孩子在小学阶段反复接受 GESP 训练,正是选手整体水平上升的底层原因,也是我们判断"分数线小幅走高"的重要依据。
二、逐题精讲
T1 旅游(travel)—— 一道"读题题",送分题就要一遍写对
难度:★ 考点:字符串解析 + 条件判断模拟 类型:模拟题
1. 原题面
题目描述
小 R 和小 X 准备坐高铁出门旅游。他们买了两张二等座车票,车票上写着各自的车厢号和座位号。两人希望座位相邻,这样旅途中可以坐在一起。
他们乘坐的列车由 节车厢组成,车厢编号是 01 到 17。其中,01 和 16 号车厢是一等座车厢,其余车厢是二等座车厢。两人买的都是二等座车票,座位都在二等座车厢中。每节二等座车厢共有 排,每排有 个座位。座位号由两位排号和一位大写字母组成,例如 03C 表示第 排 C 座。每一排的座位按照从左到右的顺序排列,座位字母依次是 A、B、C、D、F,其中 C 座与 D 座之间是过道,即每排过道左侧的座位序列是 A、B、C,右侧是 D、F。以下是一节二等座车厢的座位示意图:
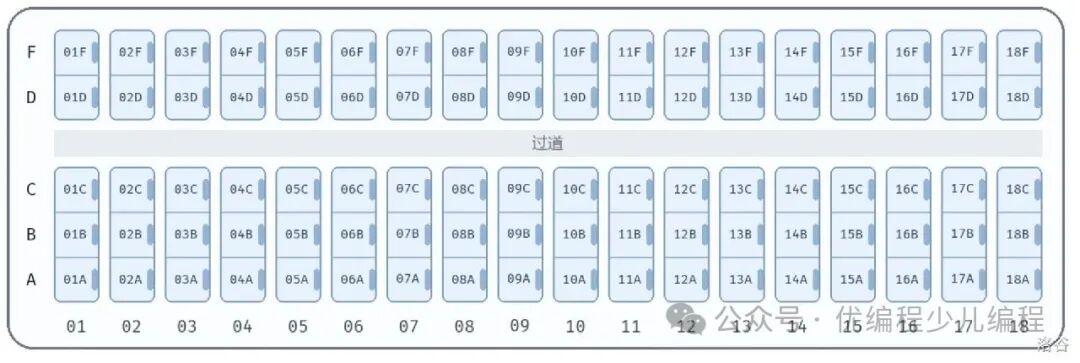
每排的文字布局为:A B C|过道|D F。
两个座位相邻,当且仅当在同一节车厢的同一排,位于过道的同一侧,且在该侧的座位序列中相邻。
你需要帮助小 R 依次判断:
1. 两张车票对应的座位是否在同一节车厢; 2. 两张车票对应的座位是否在同一节车厢的同一排; 3. 两张车票对应的座位是否在同一节车厢的同一排,且位于过道的同一侧; 4. 两张车票对应的座位是否相邻。
输入格式
从文件 travel.in 中读入数据。
输入的第一行包含四个字符串 ,分别表示小 R 的车票上的车厢号、座位号,以及小 X 的车票上的车厢号、座位号。
输出格式
输出到文件 travel.out 中。
输出一行一个长度为 的 01 字符串,分别表示四个问题的答案,其中 1 代表是,0 代表否。
输入输出样例 #1
输入 #1
02 01A 02 01B输出 #1
1111输入输出样例 #2
输入 #2
02 01C 02 01A输出 #2
1110输入输出样例 #3
输入 #3
02 01C 02 01D输出 #3
1100输入输出样例 #4
输入 #4
02 02B 02 01A输出 #4
1000输入输出样例 #5
输入 #5
02 01A 03 01A输出 #5
0000说明/提示
样例 1 解释
02 号车厢是二等座车厢。01A 和 01B 在同一节车厢、同一排、过道的同一侧,并且相邻,因此输出 1111。
样例 2 解释
两个座位在同一节车厢、同一排、过道的同一侧,但 01C 与 01A 中间隔着 01B,不相邻,因此输出 1110。
数据范围
对于所有测试数据,均有:
1. 是 01到17之间除01和16外的两位车厢号;2. 是对应车厢中的合法座位号,即前两位是 01到18之间的排号,末位是A、B、C、D、F中的一个字母;3. 两张车票对应的不是同一个座位,即 或 。
特殊性质 A:两个座位在同一节车厢,即 。
特殊性质 B:两个座位在同一排,即 的前两位与 的前两位相同。
特殊性质 C:两个座位在过道的同一侧。
特殊性质 D:小 R 的座位是 D 座,小 X 的座位是 F 座,即 的末位字符是 D, 的末位字符是 F。
2. 题眼在哪里
这道题我们赛前预判得最准的一点是:T1 大概率是一道"贴近生活的长题面 + 字符串/模拟"题。 今年这道"高铁座位"就是典型——题面讲了一整段车厢、排号、座位字母,但真正要你做的,就是把"座位相邻"这四个字变成几行判断。
拿到这道题,第一反应不应该是"赶紧写代码",而是先把题目里那个反直觉的坑找出来。这道题的坑在哪?在座位字母上:
一排座位从左到右是
A B C|过道|D F。
看清楚没有——座位字母里没有 E,而且 C 和 D 之间隔着过道。这就埋了两个陷阱:
1. 字母上 C和D是相邻的,但座位不相邻(中间隔着过道);2. 字母上 D和F中间跳过了E,看似不相邻,但座位是紧挨着的。
谁要是用"字母的 ASCII 码差值"来判断相邻,D、F 这一对一定会判错——而样例里恰好没有 D、F 相邻的情况,测不出来,性质 D 的测试点就会失分。 这道题考的就是这个。
3. 题意拆解:四个问题一层套一层
题目要我们依次回答四个"是/否",输出一个长度为 4 的 01 串:
1. 是否同一节车厢?(比较车厢号 c1 == c2)2. 是否同一节车厢的同一排?(在 1 的基础上,排号相同) 3. 是否同一节车厢的同一排、且过道同侧?(在 2 的基础上,都在过道左或都在右) 4. 是否相邻?(在 3 的基础上,两个座位紧挨着)
注意这四个问题不是独立的,每一问都以前一问成立为前提。我们赛前反复强调的"读题要读条件之间的包含关系",这道题就是最好的例子——样例 5 里两个座位排号、字母都相同,但车厢不同,四问就全是 0。谁要是把第 2 问写成"只比较排号",就会在这里翻车。
4. 核心技巧:把座位"放到数轴上"
破解相邻判断的钥匙,是我们赛前在"找规律"专题里反复练过的一招:把对象放到数轴上,让空位也占一格。
我们把一排座位映射成位置编号,让过道也占一个编号:
| 4 |
映射之后,两个判断都变成了纯粹的数值比较:
1. 同侧:编号小于 4 在过道左边,大于 4 在右边,两边同左或同右就是同侧; 2. 相邻:编号相差 1。过道占了编号 4,于是 C(3) 与D(5) 相差 2 → 判为不相邻;D(5) 与F(6) 相差 1 → 判为相邻。
两个反直觉陷阱,被"过道占一个编号"这一个动作同时化解。这就是我们常说的:想清楚建模,代码自然就短。
5. 满分程序
#include <bits/stdc++.h>using namespace std;string c1, s1, c2, s2;bool ans[5]; // ans[i]:第 i 问的答案,下标从 1 开始// 座位字母在一排中的位置编号:A、B、C 为 1、2、3,过道占 4,D、F 为 5、6int pos(char ch){ if (ch == 'A') { return 1; } if (ch == 'B') { return 2; } if (ch == 'C') { return 3; } if (ch == 'D') { return 5; } return 6; // 剩下的只有 F}int main(){ freopen("travel.in", "r", stdin); freopen("travel.out", "w", stdout); cin >> c1 >> s1 >> c2 >> s2; int p1 = pos(s1[2]); // 小 R 座位的位置编号 int p2 = pos(s2[2]); // 小 X 座位的位置编号 bool l1 = (p1 < 4); // 小 R 是否在过道左边 bool l2 = (p2 < 4); // 小 X 是否在过道左边 // 第 1 问:车厢号相同 ans[1] = (c1 == c2); // 第 2 问:第 1 问成立,且排号(座位号的前两个字符)相同 ans[2] = ans[1] && s1[0] == s2[0] && s1[1] == s2[1]; // 第 3 问:第 2 问成立,且两人都在过道左边或都在右边 ans[3] = ans[2] && l1 == l2; // 第 4 问:第 3 问成立,且位置编号相差 1 ans[4] = ans[3] && abs(p1 - p2) == 1; for (int i = 1; i <= 4; i++) { if (ans[i]) { cout << '1'; } else { cout << '0'; } } cout << '\n'; return 0;}时间、空间复杂度都是 。
6. 易错点清单
1. 用 s1 == s2判断同排——把座位字母也一起比了,01A和01B会被误判成不同排。2. 只比较 s1[1] == s2[1]——把第01排和第11排当成同一排。3. 后一问没带上前一问的结果——样例 5 的 02 01A 03 01A就会答错。4. 用字母编码差判断相邻—— D/F差 2 却紧挨着,会被判成不相邻;如果同侧判断也没写对,C/D差 1 却隔着过道,又会被判成相邻。5. 文件名写错。这里再敲一遍黑板: freopen("travel.in", ...)和freopen("travel.out", ...)必须和题面一字不差,少写一个字母就是 0 分。
7. 教练点评
这道题是本次预测的"代表作":我们赛前说"T1 大概率是贴近生活的长题面 + 字符串/模拟",今年就来了道"高铁座位"。但同学们要记住,T1 送分题的价值不在于"你会不会做",而在于"你能不能 15 分钟内一遍写对、不留隐患"。 送分题是全场性价比最高的一道题,谁在这里因为文件名、边界、读题大意丢分,谁就是全场最亏的人。
T2 回文串(string)—— 展开不了,就要会"按段"处理
难度:★★ 考点:字符串 + 对称配对计数 + 双指针 类型:计数题(行程编码)
1. 原题面
题目描述
小 R 有一个长度为 的字符串 ,其中只包含小写英文字母。小 R 发现,虽然 可能很长,但它可以分成 个连续的段,其中第 段由 个小写英文字母 构成。把这 段依次拼接起来便得到 ,因此 。相邻两段中的字符可以相同。
小 X 喜欢回文串。若一个字符串反转后与原字符串相同,就称它是回文串,例如 aba、abba 都是回文串,而 aabbc 不是。也就是说,字符串 是回文串,当且仅当对于所有 ,均有 。
小 X 想让小 R 把 改成回文串。小 R 可以将 中任意一个位置的字符修改成任意小写英文字母。他想用尽量少的修改满足小 X 的要求。
你需要帮助小 R 求出,他最少需要修改多少个位置的字符,才能将 改成回文串。
输入格式
从文件 string.in 中读入数据。
输入的第一行包含一个正整数 。
输入的第 行包含一个正整数 和一个小写英文字母 。
输出格式
输出到文件 string.out 中。
输出一行一个整数,表示小 R 最少需要修改多少个位置的字符,才能将 改成回文串。
输入输出样例 #1
输入 #1
32 a2 b1 c输出 #1
2输入输出样例 #2
输入 #2
22 a3 a输出 #2
0输入输出样例 #3
输入 #3
61000000000 a1000000000 a1000000000 a1000000000 b1000000000 b1000000000 b输出 #3
3000000000说明/提示
样例 1 解释
小 R 的字符串 由 段构成:第 段由 个 a 组成,第 段由 个 b 组成,第 段由 个 c 组成,依次拼接得到 。
小 R 可以将最后一个字符 c 和倒数第二个字符 b 都改为 a,得到回文串 aabaa,共修改 个位置的字符。可以证明,小 R 最少需要修改 个位置的字符,才能将 改成回文串。
样例 2 解释
小 R 的字符串 由 段构成:第 段由 个 a 组成,第 段由 个 a 组成,依次拼接得到 ,则 已经是回文串,不需要修改。
数据范围
对于所有测试数据,均有:
1. ; 2. 对于所有 ,均有 ,且 为小写英文字母。
2. 题眼在哪里
这道题的题眼,藏在一句话里:输入不是给你一个字符串,而是给你"连续一段 + 出现次数"。 第 段由 个字母 构成, 能到 。
这意味着什么?意味着在完整数据下,这个字符串你根本展开不了——总长度 最大能到 ,别说存不下,就是一个字符一个字符地比较也比不完。
所以这道题的实质考法就清楚了:这是一个"压缩表示"的字符串题,你必须按段处理,而不是展开后逐字符处理。 这考的是成批计算的能力——先想清楚"逐字符该怎么做",再找到"一批处理方式完全相同的字符",一次处理一批。
3. 题意拆解:最少改几处,变成回文
把 改成回文,就是让每一对对称位置( 和 )的字符相同。每一对:
1. 字符相同 → 不用改; 2. 字符不同 → 把其中一个改成另一个,改一次就够。
每个位置只属于一对,各对互不影响,所以答案 = 字符不同的对称位置对数。 为奇数时正中间那个字符和自己对称,不用管。
这一步不需要任何算法,只需要想清楚"对称位置一一配对、各对互不影响"。真正的难点在后面:怎样在不展开字符串的情况下数出这些对。
4. 思考过程:从暴力到满分,三档递进
第一档(56 分):展开字符串,逐对比较。 当 时,直接把字符串展开,枚举左半边 ,若 就答案加一。这是最朴素的做法,也是务必先拿到手的暴力分——我们赛前反复说"暴力一定比 0 分强",这道题前 12 个测试点 + 17、18 测试点都能这样拿。如果内存允许开约 100 MB 的字符数组,把展开数组开到 ,测试点 19~21 也能展开处理,这就是前文所说的 68 分。
第二档(72 分):枚举段对,用区间交集计数。 段长能到 时展开不了,但段数 时,可以枚举"左端所在段 、右端所在段 ",算出这两段之间有多少对对称位置(就是两个区间的交集长度), 时把交集长度加进答案。思路的核心是:同一段内的字母都相同,没必要一个一个比。
第三档(100 分):双指针,按剩余段长批量处理。 段数和段长都大时,枚举段对是 ,会超时。关键观察是:从两端同时向中间走,每一时刻真正"相遇"的只有左端所在段和右端所在段,交集非空的段对不超过 个。 于是用两个指针 l、r,每轮处理 对:
1. 若 c[l] != c[r],这 对都不同,答案加 ;2. 两边都扣除 (不管字母是否相同都要扣,这 对已经处理完了); 3. 左段用完就 l++,右段用完就r--。
循环条件是 l < r。当 l == r 时,剩下的字符都在同一段内,彼此相同,不用改。
5. 满分程序
#include <bits/stdc++.h>using namespace std;const int N = 200005;int n;int a[N]; // a[i]:第 i 段还没有处理的字符个数,读入时是原始段长char c[N];long long ans;int main(){ freopen("string.in", "r", stdin); freopen("string.out", "w", stdout); ios::sync_with_stdio(false); cin.tie(0); cin >> n; for (int i = 1; i <= n; i++) { cin >> a[i] >> c[i]; } int l = 1; // 左端当前所在的段 int r = n; // 右端当前所在的段 while (l < r) { int t = min(a[l], a[r]); // 本轮一次处理 t 对对称位置 if (c[l] != c[r]) { ans += t; // t 对字符都不同,每对修改一次 } // 不论字母是否相同,两端都处理掉 t 个字符 a[l] -= t; a[r] -= t; if (a[l] == 0) { l++; // 左段用完,进入下一段 } if (a[r] == 0) { r--; // 右段用完,进入上一段 } } // l == r 时,剩下的字符都在同一段内,彼此相同,不用修改 cout << ans << '\n'; return 0;}每轮至少用完一段,最多 轮,时间复杂度 ,与展开后的长度 无关。答案最大到 ,必须用 long long。
6. 易错点清单
1. 逐对比较时 i枚举到len而不是len/2——每对不同字符会被算两次。2. 答案或前缀长度用 int——样例 3 的答案 就溢出了。3. 字母不同时写成 ans++——一批 对只算了一次。4. 先减后取 min 的坑:若写成先 a[l] -= min(a[l], a[r]),再a[r] -= min(a[l], a[r]),第二个min用的是已经减小的a[l],两边扣除长度就不同了。5. 只在字母不同时扣除长度——字母相同时 l、r都不动,程序死循环。
7. 教练点评
这道题我们赛前判断"T2 是基础档",命中了。但更重要的是,这道题给所有同学提了个醒:"字符串题"不等于"把字符串展开来暴力做"。 这道题用"压缩表示"来包装字符串,逼你把时间复杂度从"和长度相关"优化到"和段数相关"。这种"行程编码"思路,同学们务必单独练一批。
T3 按位与(and)—— 位运算连续两年坐镇 T3,一道标准的按位贪心
难度:★★~★★★ 考点:位运算 + 按位贪心 类型:贪心题(区分题)
1. 原题面
题目描述
小 R 有 个非负整数 。
小 X 给了小 R 一个正整数 ,并要求小 R 从这 个非负整数中选出恰好 个,使得选出的 个数的二进制按位与的值最大。
你需要帮助小 R 求出,他能选出的 个数的按位与的最大值。
输入格式
从文件 and.in 中读入数据。
输入的第一行包含两个正整数 。
输入的第二行包含 个非负整数 ,依次表示小 R 的 个非负整数。
输出格式
输出到文件 and.out 中。
输出一行一个非负整数,表示小 R 能选出的 个数的按位与的最大值。
输入输出样例 #1
输入 #1
4 23 15 12 12输出 #1
12输入输出样例 #2
输入 #2
5 331 3 1 15 7输出 #2
7说明/提示
样例 1 解释
小 R 有 个非负整数:。
1. 若小 R 选择 ,则按位与的值为 ; 2. 若小 R 选择 ,则按位与的值为 ; 3. 若小 R 选择 ,则按位与的值为 ; 4. 若小 R 选择 ,则按位与的值为 。
因此,小 R 能选出的 个数的按位与的最大值为 。
样例 2 解释
若小 R 选择 ,则按位与的值为 。可以证明,小 R 能选出的 个数的按位与的最大值为 。
数据范围
对于所有测试数据,均有:
1. ; 2. 对于所有 (),均有 。
特殊性质 A:对于所有 (),均存在非负整数 满足 。
特殊性质 B:存在非负整数 满足 ,且对所有 (),均有 。
2. 题眼在哪里
这道题最有意思的地方,在于它印证了我们赛前的一个判断,同时也给出了一个"升级信号"。
我们在赛前预测 T1 考点时,明确把"位运算"写进了考点池,当时的定位偏基础。实际上,2025 年 T3《异或和》已经把位运算放进了区分位;今年命题组连续第二年在 T3 考位运算,并且从前缀异或的性质升级到了"按位与 + 按位贪心"——位运算从"语法题"变成了"思维题"。这正是本文总体分析里点出的第一个信号:任何基础知识点,都可能"上移"成为区分度核心。
那么这道题的题眼在哪?在一句话上:
求"选恰好 个数,使它们的按位与最大"。
看到"按位与最大",脑子里要立刻蹦出我们课堂上反复讲的一个模型:按位贪心。 因为比较两个数的大小,先看最高位、再看次高位——所以"最大化按位与",天然就应该从高位到低位,一位一位地贪。
3. 题意拆解:把"最大化"转成"可行性判断"
先想清楚按位与的两条性质:
1. 某一位是 1,当且仅当所选的每个数这一位都是 1。 只要有一个数这一位是 0,结果这一位就是 0。 2. 多选一个数,结果中的 1 只会减少、不会增加。
于是问题转化为一个"判断":给定一个数 ,能否选出 个数,使它们的按位与"包含 的所有 1"?
要让按位与包含 的所有 1,每个被选的数都必须包含 的所有 1,代码写出来就是:
(a[i] & x) == x // 注意:括号不能省!统计满足这个条件的数有几个,够不够 个,这个判断记为 check(x)。
答案就是"最大的、满足 check(x) 的 x"。 这句话是整道题的枢纽——把"最大化"转成了"可行性判断",剩下的就是高效地找这个最大 x。
4. 思考过程:六档递进,每一档都是一层思维
这道题的部分分设计堪称教科书,我们赛前反复强调"先拿暴力分再考虑优化",这道题就是最好的练习场。我们把每一档的思路都点出来:
1. 50 分:搜索。 DFS 枚举选哪些数,加上"剩下的数不够选就不再搜"的剪枝,,以及 且 、、 的测试点都能很快搜完。这是暴力,但也是必须稳稳拿到的第一桶金。 2. 60 分: 用前缀后缀按位与。 只需决定"不选哪个数",用 pre[i](第 个到第 个的与)和suf[i](第 个到第 个的与)拼出答案。注意空前缀、空后缀要设成全 1 的(1<<30)-1,不能设 0。3. 65 分:特殊性质 A(每个数都是 )。 这种数按位与等于最小值,选最大的 个即可。 4. 75 分:特殊性质 B(数是 )。 答案可以直接用公式 算出,其中 是不小于 的最小 2 的幂。 5. 95 分:值域小()时从大到小枚举答案。 候选答案只有 这不超过 个,配合计数数组逐个 check。6. 100 分:按位贪心。 见下文。
这几档我们都写了代码并逐档验证,考场上可以在主函数里"判断数据满足哪档就调哪档",把分数合起来。 其中第 5 档"从大到小枚举答案、判断能否做到",正是满分做法的前身——这也是我们赛前反复教的考场策略:部分分不是"次优解",而是"满分的垫脚石"。
5. 满分做法:从高位到低位逐位确定
值域到 时,候选答案有约 个,不能枚举。但"找最大的可行 x"可以一位一位地确定:
1. 从第 29 位到第 0 位,依次试探第 位能不能取 1; 2. 令 x = ans | (1 << k)(保留已确定的 1,再要求第 位也是 1);3. 若 check(x)为真,第 位就定为 1(ans = x);否则第 位为 0,ans不变。
为什么高位能为 1 就一定要取 1? 因为高位的一个 1,比所有更低位的 1 加起来还大。这正是"按位贪心"的正确性来源。
这里有一个最容易错的思想误区:不能把每一位分开统计"有几个数这一位是 1",再把个数够 的位拼起来。反例: 选两个,每一位都恰好有两个数是 1,但没有两个数同时拥有这三个 1。所以试探新的一位时,必须和已经确定的位一起检查——x = ans | (1 << k) 里的 ans,就是把已经确定的位一起带上。
6. 满分程序
#include <bits/stdc++.h>using namespace std;const int N = 200005;int n, m, ans;int a[N];// 能否选出 m 个数,使它们的按位与包含 x 的所有 1bool check(int x){ int cnt = 0; for (int i = 1; i <= n; i++) { if ((a[i] & x) == x) { // 括号不能省:== 的优先级高于 & cnt++; } } return cnt >= m;}int main(){ freopen("and.in", "r", stdin); freopen("and.out", "w", stdout); ios::sync_with_stdio(false); cin.tie(0); cin >> n >> m; for (int i = 1; i <= n; i++) { cin >> a[i]; } // 从第 29 位到第 0 位依次试探 for (int k = 29; k >= 0; k--) { int x = ans | (1 << k); if (check(x)) { ans = x; } } cout << ans << '\n'; return 0;}时间复杂度 , 时约 次,非常轻松。
7. 易错点清单
1. 搜索时 val初值设为 0——0 与任何数相与都是 0,答案永远 0。2. 前缀/后缀的 pre[0]、suf[n+1]设为 0——不选第一个/最后一个数时结果被错误清零。3. (a[i] & x) == x写成a[i] & x == x——==优先级高于&,实际只检查了最低位。4. 试探时写成 x = 1 << k——丢掉了已经确定的高位。5. 从低位到高位确定——先定的低位会限制后面的选择,可能失去更高的位。 6. 先去重再计数——相同的值是不同的数,可以同时选。
8. 教练点评
这道题,我们赛前的判断是"位运算在考点池内、但定位偏基础",而命题组连续第二年把位运算放在 T3,并且从前缀异或升级到了按位贪心。这既是命题的新意,也是给我们的提醒:位运算绝不是"会写 %2 就行"的送分语法,它的上界可以很高。 "按位贪心"这个模型——从高位到低位、带着已确定的位一起试探、用可行性判断决定每一位——是位运算题最常用的进阶模型,同学们务必把它练成肌肉记忆。我们课堂上讲的"最大化按位与 / 最小化按位或"通用套路,今年在 T3 原汁原味地考出来了。
T4 纸牌游戏(card)—— 思维模拟压轴题,规律藏在"最后出现"
难度:★★★~★★★★ 考点:模拟 + 栈(部分分)+ 观察规律 + 递推 类型:思维题
1. 原题面
题目描述
小 Z 正在玩一种单人纸牌游戏。
他有一叠特制的纸牌,共有 张,从上到下的点数依次为 。每张牌的点数都是 到 之间的整数,且每种点数都出现至少一次。
小 Z 将进行 局相互独立的游戏。每局开始前,他会将所有牌按原顺序放回牌堆,并清空桌面。在第 ()局中,他跳过前 张牌,依次打出第 张到第 张牌,这些牌的点数依次为 。
桌面上的牌始终从左到右排成一行。打出一张点数为 的牌时:
1. 若桌面上没有点数为 的牌,就将这张牌放在最右端; 2. 否则,收走桌面上点数为 的牌及其右侧的所有牌,再把这张牌放在最右端。被收走的牌在本局中不再使用。
由上述规则可知,任意时刻桌面上同一种点数的牌至多只有一张。
最后一张牌打出后,本局游戏结束。
例如,若桌面上从左到右的牌的点数依次为 ,则打出一张点数为 的牌后,桌面上从左到右的牌的点数依次为 。接着打出一张点数为 的牌时,桌面上原来点数为 的牌及其右侧的所有牌(点数依次为 )被收走,再把新打出的 放在最右端,此时桌面上从左到右的牌的点数依次为 。
你需要帮助小 Z 依次求出,对于每个 ,在所有 局游戏中,有多少局结束时桌面上留有点数为 的牌。
输入格式
从文件 card.in 中读入数据。
输入的第一行包含两个正整数 ,分别表示牌的数量和点数种类数。
输入的第二行包含 个正整数 ,依次表示小 Z 的牌从上到下的点数。
输出格式
输出到文件 card.out 中。
输出一行 个非负整数,其中第 ()个整数表示在所有 局游戏中,有多少局结束时桌面上留有点数为 的牌。
输入输出样例 #1
输入 #1
4 31 2 1 3输出 #1
3 1 4输入输出样例 #2
输入 #2
10 33 1 2 1 3 2 3 1 2 1输出 #2
10 3 3说明/提示
样例 1 解释
对于第 局游戏,小 Z 依次打出点数为 的牌:
1. 打出第 张牌(点数为 )后,桌面上只有一张点数为 的牌; 2. 打出第 张牌(点数为 )后,桌面上从左到右的牌的点数依次为 ; 3. 打出第 张牌(点数为 )后,先收走桌面上点数为 的两张牌,再放上新打出的 ,桌面上只有一张点数为 的牌; 4. 打出第 张牌(点数为 )后,桌面上从左到右的牌的点数依次为 。
因此第 局游戏结束时,桌面上从左到右的牌的点数依次为 。
对于第 局游戏,小 Z 依次打出点数为 的牌,结束时桌面上从左到右的牌的点数依次为 。
对于第 局游戏,小 Z 依次打出点数为 的牌,结束时桌面上从左到右的牌的点数依次为 。
对于第 局游戏,小 Z 仅打出一张点数为 的牌,结束时桌面上只有一张点数为 的牌。
因此,在全部 局游戏中:
1. 有 局游戏结束时,桌面上留有点数为 的牌,即第 局; 2. 有 局游戏结束时,桌面上留有点数为 的牌,即第 局; 3. 有 局游戏结束时,桌面上留有点数为 的牌,即全部 局。
数据范围
对于所有测试数据,均有:
1. ,; 2. 对于所有 (),均有 ; 3. 每种点数都出现至少一次,即对于所有 (),均存在 ()满足 。
特殊性质 A:。
特殊性质 B:至多存在 个 ()满足 。
2. 题眼在哪里
压轴题来了。这道题兑现了我们赛前"T4 难度比 2025 年上升"的判断——它比去年的《多边形》高出一档。它的难点不在算法模板,而在你能不能从模拟中发现规律。
先把题意翻译成人话:有 张牌,第 局从第 张开始往右打(跳过前 张)。桌面上牌从左到右排一行,打出一张点数 的牌时——桌面上没有 就放最右端;有 就收走"原来的 及其右侧所有牌",再把新牌放最右端。对每种点数,问 局中有多少局结束时它留在桌上。
题眼在哪?在两个看似不起眼的事实上:
事实一:最后一张牌每局都会留下。 它是每局最后打出的牌,放到最右端后,再没有牌能把它收走。
事实二:一局的首牌点数,始终待在桌面最左端。 要收走它,只能再打出同样的点数,而这时新牌又放回桌面,桌面上只剩这一张——所以最左端永远是首牌点数,只是换成了新牌。
这道题的全部玄机,都从"事实二"里长出来。
3. 关键规律:首牌相同,结局相同
由事实二,每次打出首牌点数 后,桌面上都只剩这一张 。设点数 最后一次出现在位置 last[x]。打完这张牌后,桌面上只有 ;之后再也不会出现 ,它会一直留在最左端,不影响其他牌。
于是得到全题的关键结论:
也就是说,一局的最终桌面只取决于首牌点数 ,而"从位置 开始的那一局"的首牌是 ,记为 nxt[x]( 的"后继")。
首牌为 的局共有 cnt[x] 个,它们的最终桌面完全相同,可以合成一组。沿着 一路走到 0,经过的点数就是这些局最终桌面上从左到右的点数。
以样例 1 为例(a = 1 2 1 3):nxt[1]=3、nxt[2]=1、nxt[3]=0。于是首牌为 1 的两局最终是 ,首牌为 2 的一局是 ,首牌为 3 的一局是 。点数 1、2、3 分别被 3、1、4 局经过,答案正是 3 1 4。
4. 思考过程:从逐局模拟到线性
1. 24 分:逐局模拟。 时,每局用数组模拟桌面,从左到右找重复点数。这是暴力分。 2. 48 分:栈 + 位置数组。 桌面本质是个栈(放牌在右端、收牌收右端一段),用 pos[x]记录点数位置,找位置就是 了。 时每局模拟变线性。3. 60 分: 与性质 A。 只有两种点数时,最后一张牌的点数每局都留下,答案为 ;另一种点数 只在首牌是它的局里留下,答案为 cnt[x]。序列不降时, 的答案就是last[x]。4. 72 分:性质 B(压缩连续相同牌)。 连续相同的牌只需打一张,压成块后块数 ;从同一块开始的局结果相同,逐块模拟后按块长一次统计。 5. 80 分:按首牌分组,沿后继链走。 时,对每个首牌点数沿链走到底,每经过一个点数就 ans[y] += cnt[x]。6. 100 分:合并到达同一点数的局数。 能到 ,各条链可能很长,逐条走是 。但不同的链一旦走到同一个点数,后面的路径完全相同,重复走是浪费。
5. 满分做法:先汇总,再往后传
满分的点睛之笔,是把"逐条走链"改成"合并后一起传":
1. 初始 ans[x] = cnt[x],表示首牌为 的局从 出发;2. 处理点数 时, ans[x]已经汇总了所有经过 的局,执行ans[nxt[x]] += ans[x],把它们一起传给后继;3. 传递后 ans[x]不清零——因为它本身就是 的答案(这些局的最终桌面既有 ,也有它后面的点数)。
把每个点数向其后继连一条边,所有点数构成一个森林,链尾是根。 的答案就是它子树里所有点数的 cnt 之和——上面这个过程,就是自下而上累加子树和。
处理顺序也很讲究:按"最后出现位置"从小到大处理。因为后继的最后出现位置总在后面,所以从左到右扫原序列,在位置 遇到 last[a[i]] == i(即这是点数的最后一次出现)时,就把 ans[a[i]] 传给 ans[a[i+1]]。
6. 满分程序
#include <bits/stdc++.h>using namespace std;const int N = 500005;const int M = 300005;int n, m;int a[N];int cnt[M]; // cnt[x]:点数 x 出现的次数,即首牌为 x 的局数int last[M]; // last[x]:点数 x 最后一次出现的位置int ans[M]; // ans[x]:经过点数 x 的局数,也就是答案int main(){ freopen("card.in", "r", stdin); freopen("card.out", "w", stdout); ios::sync_with_stdio(false); cin.tie(0); cin >> n >> m; for (int i = 1; i <= n; i++) { cin >> a[i]; cnt[a[i]]++; last[a[i]] = i; } for (int x = 1; x <= m; x++) { ans[x] = cnt[x]; // 首牌为 x 的局从 x 出发 } // 按最后出现位置从小到大处理:从左到右扫,遇到某个点数的最后一次出现就处理它 for (int i = 1; i < n; i++) { int x = a[i]; if (last[x] == i) { ans[a[i + 1]] += ans[x]; // 经过 x 的局,接着都经过 x 的后继 a[i+1] } } for (int x = 1; x <= m; x++) { if (x > 1) { cout << ' '; } cout << ans[x]; } cout << '\n'; return 0;}时间复杂度 ,满分程序的核心只有十来行。这就是思维题的特点:想通规律,代码很短;想不通,就只能停在模拟的分数上。
7. 易错点清单
1. 每局还没结束就统计桌面上的牌——牌可能在后面被收走。 2. 弹栈循环写成 while (top >= pos[x])——弹出旧x时pos[x]被清零,循环停不下来,整个栈被弹空。3. 性质 B 中给留下的牌加上"它所在块的长度"——应该加起点块的长度 w[i]。4. 在点数的每一次出现处都往后传——只有最后一次出现处的下一张牌才是后继。 5. 按点数 的顺序传递——可能先传走 ,之后才有局数传给 。 6. 传递时用 cnt[x]而不是ans[x]——会漏掉从其他点数传到 的局。7. 传递后把 ans[x]清零——会丢掉点数 自己的答案。
8. 教练点评
这道压轴题兑现了我们赛前"T4 难度上升"的判断。它的部分分靠模拟和栈,满分靠观察规律后递推——这恰恰印证了我们赛前反复叮嘱的那句话:压轴题不能只练 DP 和图论,思维模拟题、数据结构题同样要储备。 2024 年《接龙》、2025 年《多边形》连续两年是 DP,今年换成了观察型思维题,压轴题不会固定在某一类上。同学们平时除了刷 DP/图论,务必保留一条"思维题"的练习线:模拟找规律、观察不变量、合并相同状态,这类题练的正是信奥最核心的"思维肌肉"。
这道题还有个非常漂亮的命题细节:它把"很多局在某一刻之后完全相同"这个规律藏得很深,一旦发现,就变成一道线性题。这类"合并相同状态"的思想在各类竞赛题中都很常用,值得同学们单独归纳一个专题。
三、结语:把该拿的分拿满,就是胜利
把四道题串起来看,我们想对同学们说三句话:
第一句:拿一等的胜负手,是"基础题拿满 + 部分分不丢";冲高分的分水岭,是 T3、T4 的关键观察。 T1、T2 合计 200 分是送分题和基础题,加上 T3 的搜索、T4 的模拟,稳扎稳打的选手拿到 270~320 分是完全可预期的——这恰恰是今年分数最集中的主力区间,一等线也落在这个区间里。在这个分数段里,能不能把该拿的分一分不丢,直接决定你在一等线附近的位置;再往上,就要看能不能想到 T3 的逐位确定、T4 的首牌规律。
第二句:趋势在变,但方法不变。 位运算坐镇 T3、字符串压缩表示、压轴题思维化——这些是今年命题的新信号。但应对它们的办法,还是我们赛前反复强调的那套:考点覆盖要宽、暴力分要拿、边界要想清、文件名要写对、别死磕一题。 方法论是长期有效的,题目怎么变都逃不出这个框架。
第三句:赛后的复盘,比分数本身更重要。 考完不是结束。每道题——你做对了,问问自己是不是"侥幸";你做错了,定位一下错在"知识点没学透""思路打不开""读题理解错"还是"边界细节出错"。把错题复盘成经验,这一届的成绩才有长远的价值。
最后,用我们赛前预测文章里反复强调的一句话收尾,它今年再次被验证:
难度梯度会变,但"把会做的题一遍做对、把不会的题暴力拿分"的考场方法论,永远成立。
优编程教练组,在今晚的直播解析中,继续和大家相见,扫码预约即可。
本文由新东方优编程教练组撰写。真题信息以 CCF 官方与考场真题为准;文中分数线趋势为教练组基于历年官方数据的分析判断,仅供备考参考。四道题的正解代码均已通过官方样例、与暴力程序对拍及极限规模数据测试。