ARTICLE · 1298162
7000字回看文档OCR多模态大模型狂潮史:129个模型、6个发展时期下的3点观察
今天是2026年11月2日,星期一,北京,天气晴。
我们来看文档智能方向。最近多模态OCR模型又掀起了一个高潮,Indra、OXR1.0、OvisOCR3、文心UnlimitedOCR2、MiniCPM-OCR、Surya2.5、Xiaomi-OCR-0在18天内密集发布/因此,可以在这个方向做个总结。回顾下,可以做下,文档多模态OCR大模型发布史与高峰期分析。
从技术角度上看,技术主线经历了四次范式迁移:OCR-free文档理解(Donut/Nougat/Smoldocling)→格式化统一输出(GOT-OCR定义OCR-2.0)→视觉token压缩与小模型化(DeepSeek-OCR2025-10,分水岭)→2026年的"压缩+RL+多任务"配方固化(PaddleOCR-VL、Xiaomi-OCR-0、PolyOCR)。
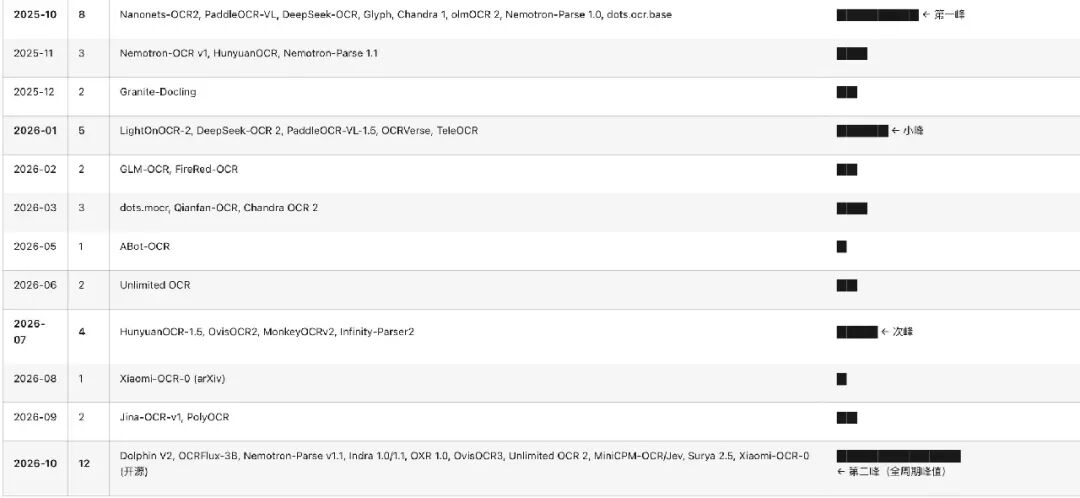
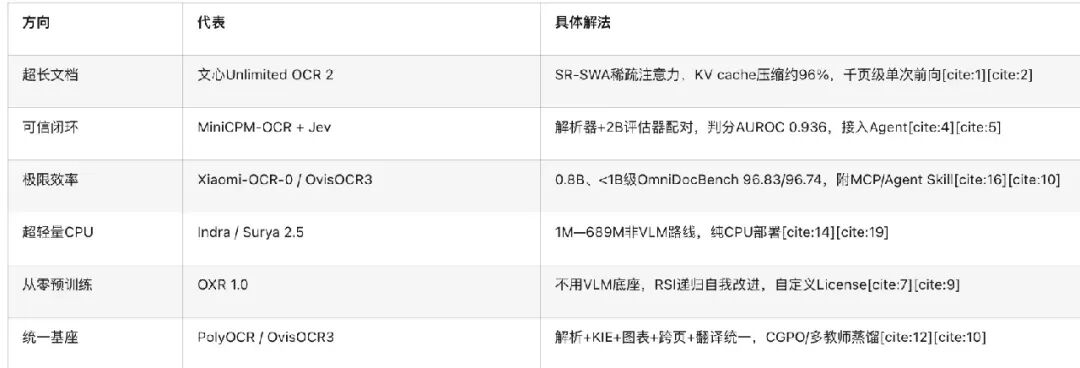
然后从2025年10月之后,酒开始引起高峰。并且,几个高峰都有一些热点伴随,如DeepSeek-OCR重定义问题引爆(跟进者一周内连发6款;精度饱和后(OmniDocBench头部差距<1个百分点),各队分头突围,长文档、校验闭环、CPU轻量、从零预训练。
当然,从中也可以看出一些趣趋势:
趋势一:Agent工具化(证据最强)。Gartner将agentic document processing列为IDP行业2026头号趋势;AgenticOCR做查询驱动"按需解析";小米随模型开源MCP/AgentSkill、面壁提供pipSDK/SKILL.md。下游从"人看"变"Agent消费",接口形态、输出schema(Markdown/JSON双格式、带坐标与阅读顺序)要为工具调用重设计。
趋势二:"解析+校验"可信闭环成标配。结构幻觉(Markdown表格乱行、虚构公式;表格生成不存在的单元格)是当前最被低估的风险。MiniCPM-OCR的Jev、olmOCR2的可验证奖励、Jina-OCR的密集奖励同属"把输出正确性变成显式建模对象"这一思路。生产环境还需要证据链接schema与评测门禁,demo与生产的差距是商业化真正门槛。
趋势三:统一基座与专用模型之争未定。PolyOCR-Venus、OvisOCR3走向统一基座;但Indra/OXR证明纯专用轻量在成本上仍有杀伤力。两者可能长期共存于不同部署档位而非一方消灭另一方。
趋势四:长文档与多页是一年内最热工程方向。百度UnlimitedOCR2千页级单次前向、XL-DocBench/MPDocBench-Parse多页评测、HunyuanOCR 跨页多图QA,真实业务文档是几十上百页的,逐页切图会破坏跨页表格与阅读顺序。
趋势五:小模型效率战将继续但边际收益递减。0.8B—1.3B档位的OmniDocBench分数已逼近标注噪声水平(头部差距<1个百分点≤基准约12%标注错误率隐含的噪声)。接下来比拼会从榜单分数转向真实场景鲁棒性与TCO(吞吐、显存、量化生态)。
做个细致总结,总会有帮助。
一、文档多模态大模型的发布梳理
通过社区记录,可以对当前文档多模态OCR模型做个统计分析,如下:
1、计量分析结果
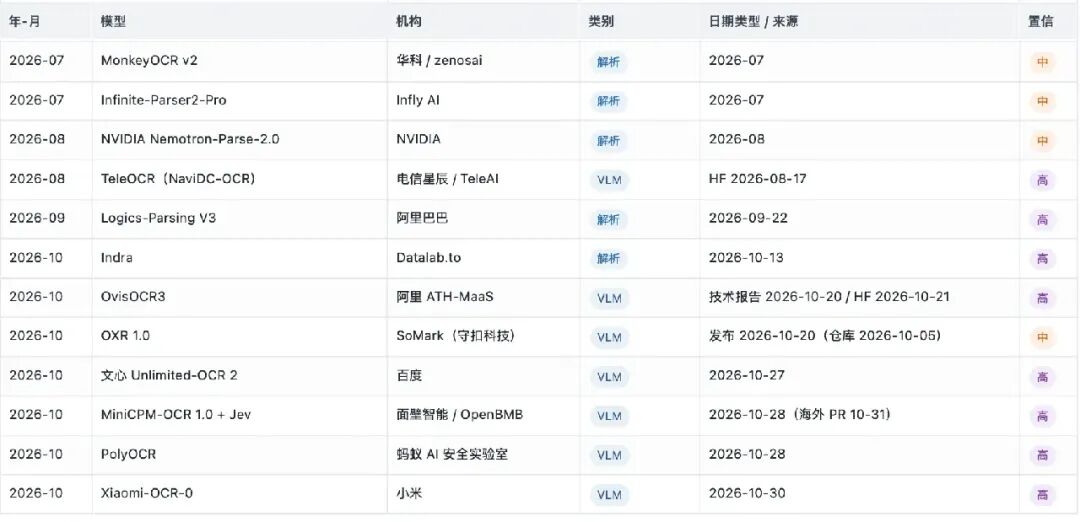
通过收录,可以得到全量发布时间清单共129条。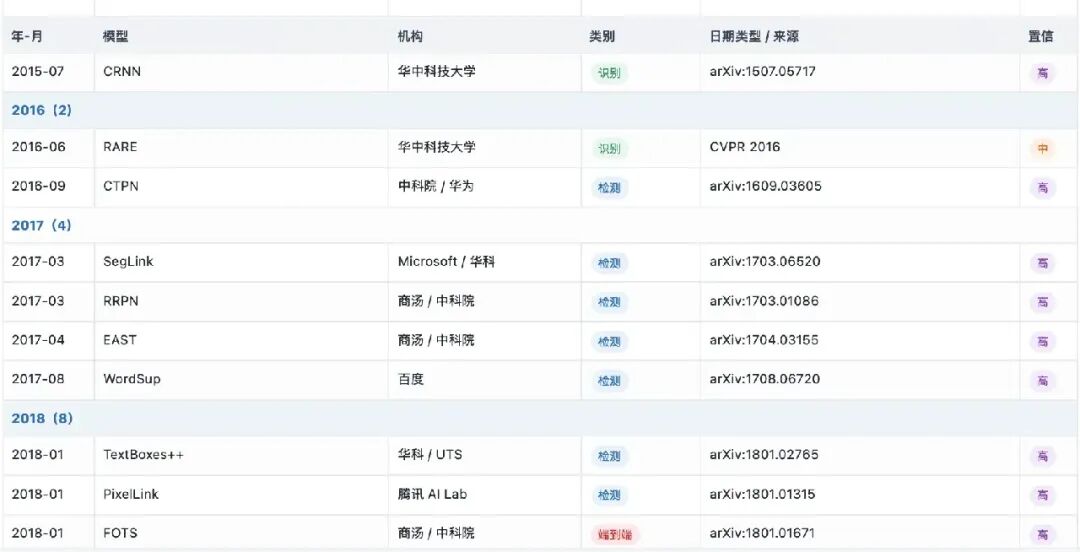
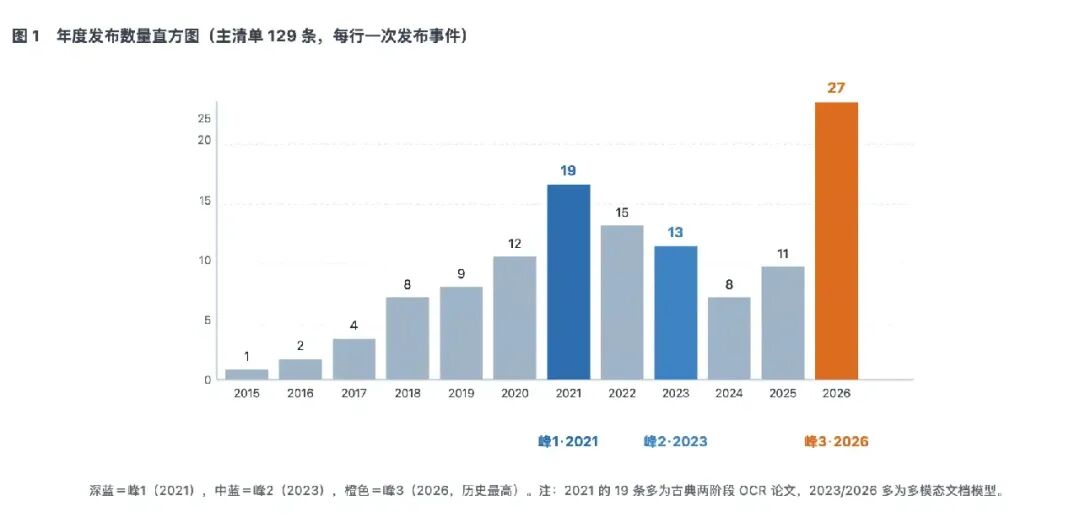
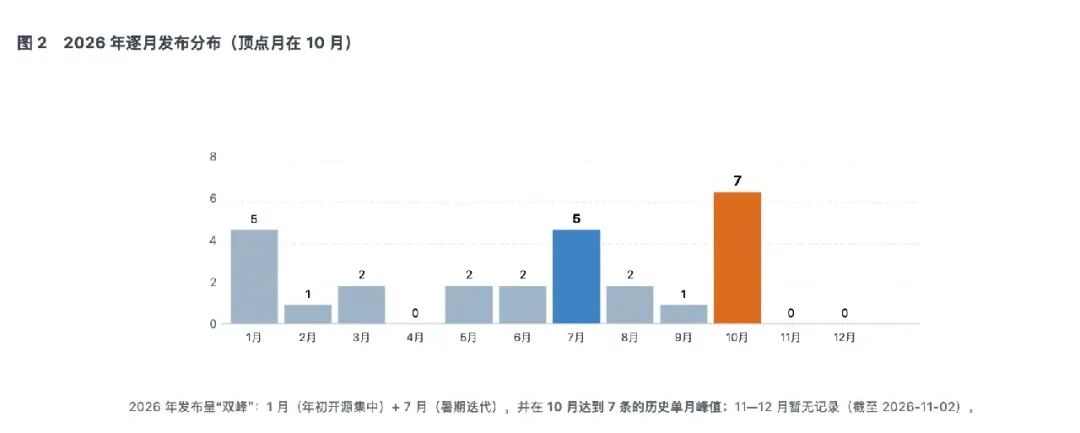
年度发布数量直方图如下,可以看到尖峰:
2026年逐月发布分布(顶点月在10月)
如果把时间线放长,其实可以得到一些趋势点:
2、可以呈现出哪些发展时期?
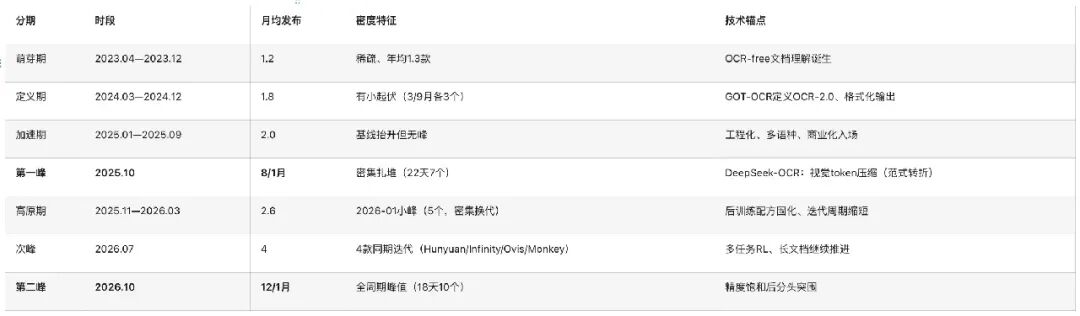
可以细分为6个时期:
1)萌芽期(2023):OCR-free范式播种
这个时期的问题是传统OCR只产出纯文本,丢失版面、表格结构与阅读顺序;学术PDF的公式与多栏混排在检测+识别分离的pipeline下损失严重。
所以思想是两条谱系同时萌芽,纯OCR-free(DocParser/UReader从图像到结构化输出)与VLM-based(mPLUG-DocOwl首次把VLM引入文档理解)。Nougat(Meta)是标志性事件:证明学术PDF可以端到端转Markdown/LaTeX,无需任何外部OCR模块。DocMamba把SSM引入文档预训练,但当时还没找到大规模端到端的落地形态。
代表模型:DocParser、DUBLIN、mPLUG-DocOwl、UniDoc、Nougat、UReader、DocPedia、UPOCR,这个时期的特点是:模型规模小(数百M级)、任务窄(学术PDF/票据表单)、发布主体全是研究机构(Meta、阿里达摩院、Adobe、中科大、华工),商业公司未入场,需求和数据配方都未成熟。
2)定义期(2024):格式化输出统一范式
这个时期想解决的问题是从"识别文字"到"还原文档结构":公式、表格、图表等视觉符号需要统一的格式化输出。
所以,核心方法是GOT-OCR2.0提出"OCR-2.0"概念:700M统一encoder-decoder输出plain/formatted双格式(含Markdown/LaTeX/HTML),覆盖公式、表格、图表、乐谱,这是第一个真正意义上的端到端格式化输出OCR模型。阿里mPLUG-DocOwl系列把文档理解VLM从单页扩展到多页(2用视觉压缩);CREPE引入坐标感知训练避免结构丢失;DocVLM(AWS)把VLM变成"文档阅读器"插件。
代表:GOT-OCR2.0(复旦大学/商汤)、mPLUG-DocOwl1.5/2、CREPE(NAVER)、DocMamba(中科大/讯飞)、TextMonkey(华中科大)、DocVLM(AWS)。这些模型规模两极化,GOT-OCR是700M小模型路线,mPLUG-DocOwl是多B级VLM路线(9个月后0.8B小模型的胜利证明GOT的直觉更接近本质)。2024年9月GOT-OCR发布后,"formattedOCR"成为行业默认标准,后续所有模型都以Markdown输出为基准。
3)加速期(2025H1):工程化、多语种与商业化入场
这个时期解决的问题是规模化使用,高吞吐批量解析PDF、多语种覆盖、小模型低成本部署、商业API可行性验证。方法为:olmOCR7B+合成数据管线做到10倍吞吐并配套单元测试式评测;SmolDocling把解析压到256M级;Dolphin(字节)提出"分析-解析"两阶段;Infinity-Parser引入RL优化文档扫描策略;MonkeyOCR用"结构-识别-关系"三元组;dots.ocr用单VLM统一版面检测与内容识别、100+语言;MinerU2.5标志工具链团队转向端到端模型(之前是规则+OCR的pipeline);MistralOCR以纯API形式验证付费需求(闭源API,商业价值已被证明)。
代表:olmOCR(AllenAI)、SmolDocling(IBM)、Dolphin(字节)、Infinity-Parser(RL扫描)、MonkeyOCR(华中科大/金山)、dots.ocr(小红书)、MinerU2.5(OpenDataLab)。从中可以看到,发布主体从研究机构扩散到创业公司(Nanonets、Datalab)、大厂产品线(字节、阿里、IBM)、甚至手机厂商准备入场。"小模型+多语种+吞吐"三个后来决胜的维度都在此期铺开。
4)第一峰(2025年10月):DeepSeek-OCR与视觉token压缩范式转折
这个时期想解决的问题是:长上下文成本。此前7B+模型解析一页需要数千token,限制了实时应用。
这个时期的模型有Nanonets-OCR2、PaddleOCR-VL、DeepSeek-OCR、Glyph、Chandra1、olmOCR2、Nemotron-Parse1.0、dots.ocr.base。
回顾下当时背景,DeepSeek-OCR(2025-10-20)提出"ContextsOpticalCompression",DeepEncoder(SAM窗口注意力+CLIP全局注意力)实现16倍视觉token压缩,10倍压缩比下解码精度约97%,把OCR重新定义为"视觉信息压缩"问题,这是整个行业的分水岭。后续跟进全部围绕压缩率—精度前沿展开:PaddleOCR-VL 0.9B验证"小模型+高质量合成数据+NaViT动态分辨率encoder"的配方可复现;olmOCR2用"单元测试可验证奖励+RL"处理结构化错误;Glyph探索视觉token与渲染的统一;Chandra1/Nemotron-Parse补多语与API生态。
这个时期也有一个特点,模型小型化在此定局(此后0.8B—1.3B成主流档位);该节点立即引来反驳研究("性能部分依赖语言先验、8k—10.5ktoken即失效";"视觉压缩不优于简单基线")
5)高原期+小峰(2025.11—2026.03):配方固化与换代
这个时期解决的问题:把第一峰验证的路线做成稳定配方:后训练体系、真实场景鲁棒性、长文档、任务统一。
这个时期是2026-01小峰的形态与两个大峰不同,是"旗舰二代集中换代"(DeepSeek-OCR2、PaddleOCR-VL-1.5是上一代的直接续作),而非"新玩家集中入场"。迭代周期已缩短到季度级。
这个阶段的后训练配方固化为"继续预训练→SFT→GRPO/可验证奖励RL"(PaddleOCR-VL-1.5明确用GRPO;FireRed-OCR公开渲染合成管线;GLM-OCR 0.9B以MIT协议开源);DeepSeek-OCR2的DeepEncoderV2继续压缩路线;TeleOCR 1.2B以"形变感知"切入物理拍摄文档;OCRVerse(港中文)尝试整体化OCR;Qianfan-OCR(百度千帆)提出Layout-as-Thought提示。
6)次峰(2026.07)与第二峰(2026.10):精度饱和后的分头突围
这个时期的背景是精度已近饱和,如OmniDocBenchv1.6头部模型均超过94%、彼此差距不到1个百分点。各队分头突围:2026-07的4个(HunyuanOCR-1.5、OvisOCR2、MonkeyOCRv2、Infinity-Parser2)是各厂旗舰的年度升级,形态上类似"高原期换代";2026-10的12个是全周期峰值,发布方横跨大厂(百度/阿里/腾讯/DeepSeek/小米/智谱)、创业公司(SoMark)、安全实验室(蚂蚁)、海外工具商(Datalab/NVIDIA)。
二、这些的背后可以做如何思考?3个角度
同样的,可以做多个思考:
1、为什么2026年10月又刮起这阵风了?
当然,2026年10月的热潮不是技术突变,而是“基准见顶+信任痛点+RAG入口+端侧隐私+开源加速”五股力量在同一窗口叠加的结果。这块可以拆开从多个不同的角度来看,看几个点:
其一,基准趋同,被迫迁移竞争维度。到2025末,主流模型在OmniDocBenchv1.6上已挤在96—97分,单点“准确率”内卷见顶。继续卷分已无差异化,厂商只能把竞争维度迁到长文档、端侧、可信、吞吐,这恰是2026这批模型的共同叙事(文心讲“页数自由”、MiniCPM讲“可信”、Indra讲“CPU端侧”)。
其二,信任税显性化。在财务、法务、医疗场景,1%字段出错就足以让自动化流水线停摆,企业被迫对99%已正确数据全量人工复核。MiniCPM提出的“信任税”精确刻画了这一成本黑洞,并催生“质检决策模型”这一全新角色(Jev)。这说明产业焦点从“认得出”转向“敢入库”。
其三,RAG/Agent入口刚需。企业知识库、Agent的“读文档”环节高度依赖解析质量,解析错了下游全错。2025起RAG落地爆发,直接把文档解析推到基础设施位置,需求侧拉动明显。
其四,端侧与隐私刚需。合同、票据、病历等敏感文档不愿上公有云,本地小模型(0.8B—3B)在消费级GPU/CPU可跑,使“私有化文档智能”成为刚需,驱动OvisOCR、Xiaomi-OCR、Indra等端侧路线。
其五,开源正反馈+数据飞轮。OlmOCR的开放数据管线、PaddleOCR生态、ModelScope/GitHub上的快速复现,使新模型从立项到开源周期缩短到数月,2026出现“10月七连发”的集群效应。
但是,需要注意的是:当前峰值由厂商密集官宣驱动,后续是否持续取决于真实落地ROI与通用大模型的反扑。
2、热潮背后需要警醒什么?
这个其实可以进一步细分为另外几个不确定的痛点:
其一,评测失真(结构性)。不止口径不一,更根本是"整体分数掩盖关键字段错误"。只要评测以整体编辑距离为主,厂商就能用长尾牺牲换高分。需要以"关键字段准确率+难例子集分数"为核心的独立第三方评测;不信厂商自报分数,怎么自己评估。实际上,我们有基本事实:所有榜单分数(OXR97.18、OvisOCR396.74等)都是厂商自报、口径不一、不可横向相减。拿不同基准的分数比高低,是选型最常见的错误。建议用真实文档测,不要用benchmark:拿自己的真实文档抽样测试,重点测关键字段准确率而非整体编辑距离。整体96分可能掩盖"金额字段错3%",而后者才是让自动化停摆的。更直接的,可以专门测长尾:留一批难例(手写、退化扫描、复杂表格)单独测,这是厂商分数最失真的地方。一个模型在benchmark上97分、在你的难例上可能掉到70分。
其二,长尾鲁棒性(结构性)。手写、退化扫描、稀有语种、极端版式不是"还没做好",是"单一证据源结构性做不到"(Indra自承手写25.2%)。突破只能靠多源证据融合,不能靠更大的单一模型;
其三,幻觉与关键字段错误。端到端模型仍可能错金额/日期,在严肃场景后果严重。质检模型降低但未消除风险,且有自己的相关性陷阱;
其四,通用大模型反扑:当GPT/Gemini把多源证据融合做进通用Agent且成本下降,专用OCR-VLM可能被吸收。这是专用厂商最大的长期风险;
3、技术上可以作为范式总结?
其一,范式迁移四次重定义,一直在变。例如:
1.OCR-free萌芽(2023):从纯文本输出转向结构化序列(Donut→Nougat→mPLUG-DocOwl),把"检测+识别+版面"多模块合为单一生成目标;
2.格式化输出统一(2024):GOT-OCR定义"OCR-2.0",plain/formatted双格式成为行业默认;
3.视觉token压缩(2025-10,分水岭):DeepSeek-OCR把OCR重定义为"视觉信息压缩"问题,此后模型设计围绕压缩率—精度前沿展开。2026年出现的非VLM反路线(Indra1M识别模型、OXR从零预训练)则提示:当VLM通用能力对文档任务不再必要时,专用轻量架构重新有了竞争力;
4.多任务统一(2026):PolyOCR-Venus/OvisOCR3走向"解析+KIE+图表+跨页+翻译"统一基座。
其二,数据方法:三件套成标配。
一路渲染合成:FireRed-OCR公开Render-basedSynthesisPipeline(HTML/CSS模板程序化生成,渲染图→完美MarkdownGT);DocAtlas用DOCX差分渲染+LaTeX合成覆盖82语言;dots.ocr用教学生蒸馏启动多语种合成;小米用"多专家共识交叉投票+预测-重渲染-像素比对回环"造1.7亿样本;FormatDecoupledRL用HTML模板渲染从教育题库造数据。
二路难样本挖掘:PaddleOCR-VL-1.5做高熵难样本筛选,1.6版形成"继续预训练→SFT→RL"三阶段+专家不一致样本回流飞轮。
三路可验证奖励RL:olmOCR2的单元测试式奖励、Xiaomi-OCR-0的Mix-RL(结构编辑距离+表格匹配分)、PolyOCR的CGPO(样本级路由教师指导,较GRPO+固定蒸馏组合OCRBenchv2.1英文75.42→80.42)、Jina-OCR的密集验证奖励。
归纳:2026年公开配方就是是渲染合成+难样本挖掘+可验证奖励RL。
其三,评测演进:从干净PDF到真实性分解。
OCRBenchv2(8能力23任务、1万人工校验样本)、OmniDocBench(9类文档源、模块级诊断)、olmOCR-Bench(7000+单元测试式二值判分)、LongDocURL(跨元素定位与数值推理)构成2025年的底座。2026年新基准转向真实退化:Real5-OmniDocBench(物理重拍、3D形变)、PureDocBench(干净/退化/真实三域)、MPDocBench-Parse(多页实用解析)、XL-DocBench(超长文档)、WildHandBench/OmniHandwritingOCR(手写,最佳仅~72%,"手写鸿沟")。
评测自身的质疑与新基准同步:PureDocBench审计出OmniDocBench约12.08%标注错误并有数据污染风险,OmniDocBench被指已饱和。"登顶"宣传的含金量系统性下降。
其四,效率与部署:0.8B—1.3B成主战场。PaddleOCR-VL0.9B单卡1.43页/秒;MiniCPM-OCR1.3B经DSpark解码加速提效55%、吞吐约1.49×;PaddleOCR-VL-1.6、3.62×;MinerU2.5Pro,首日支持vLLM/SGLang/llama.cpp/Ollama全生态;Xiaomi-OCR-00.8B<1B级榜首;Indra纯CPU约15×Tesseract;RTPrune等免训练剪枝进一步压DeepSeek-OCR推理成本。"页/秒"已是一等指标。端侧路线分化:面壁走"1-2B多模态+专用OCR子模型+判分模型"组合;小米走"0.8B单模型覆盖解析+KIE+OCR-VQA"并落地。
关于我们
老刘说NLP技术社区,自2022年建立以来,以公正、客观的角度,围绕知识图谱本体论+RAG知识库+Agent智能体三个方向做深入跟进,加入方式在:https://mp.weixin.qq.com/s/_sEWHeV20sN1JcwGJU9tJw