ARTICLE · 1306525
主题模型:不读一句,机器就懂几百篇文档在聊啥
500 条外卖评价、一学期 80 篇文献、论坛 1000 条帖子——全堆在你面前,你打算怎么一眼看明白大家在聊什么?
逐条读完?不可能。这时候就得请出文本主题模型:它像个不知疲倦的图书管理员,把一堆杂乱文档自动拢成几个主题篮——每个篮子里,装着意思相近的一堆词。它不关心句子长短,只在乎「谁和谁常在一起出现」。
上一期我们聊了词云:把一篇、一批文字,摊成一张「谁出现多谁字就大」的海报。词云是给眼睛的速写;主题模型则是给脑子的分组——它要回答的是:这几百篇文档,到底在聊哪几件事?
举个生活例子:你收到 100 条用户反馈,主题模型可能一下子告诉你——哦,三成在吐槽「配送慢」,四成在夸「味道好」,两成在问「优惠券」。你不用读一句,就抓住了全局。
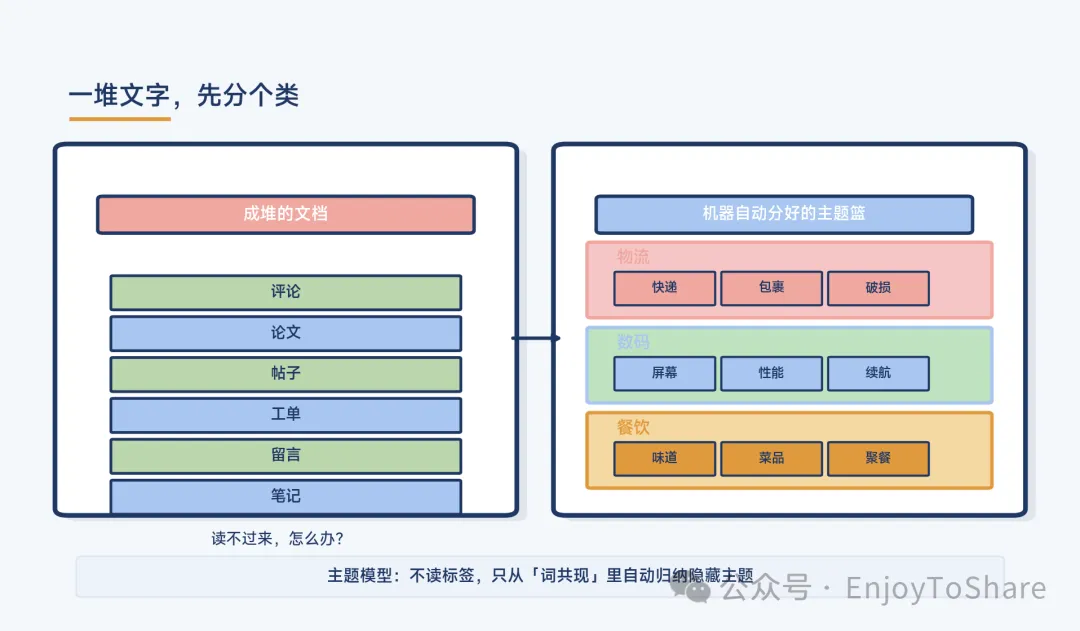
— 为什么需要:一堆杂乱文档,机器自动拢成几个主题篮
01
一堆文字先分个类
我们天生擅长「分堆」:水果分生鲜和零食,歌曲分摇滚和民谣,衣服分上衣和裤子。文字也一样。给机器一堆文档,它不会「读」,但它会数:哪些词老是在同一篇里扎堆出现,就归到一个主题。
主题模型干的事,本质上是无监督分类:没有人事先打标签,机器自己从词与词的共现里,挖出隐藏的主题结构。这叫「无监督」,因为答案不是你喂的,是它自己长出来的。
主题模型在找什么
主题 = 一组常一起出现的词 (机器从「词共现」里自动归纳)
它和词云是表兄弟:词云看「一篇里谁字最大」,主题模型看「一堆文档里谁和谁总结伴」。一个管局部,一个管全局;一个给图,一个给结构。
02
核心直觉:文档是主题的混合物
LDA(隐狄利克雷分配)是主题模型里最出名的一位。它有一个特别漂亮的核心直觉,记住这句话就够了:
文档是主题的混合物,主题是词的混合物。
翻译成人话:每篇文章,像一杯按配方调出来的「主题鸡尾酒」——比如 60% 餐饮 + 30% 物流 + 10% 数码;而每个主题,又像一组「常一起出场的词」——比如「餐饮」主题里,总是飘着味道、菜品、聚餐这几个气泡。
所以一篇文档,最后能用「几个主题各自的占比」来代表。这比逐字读,轻了不知多少倍——你一眼就能说清,这篇到底在讲啥、偏向哪边。
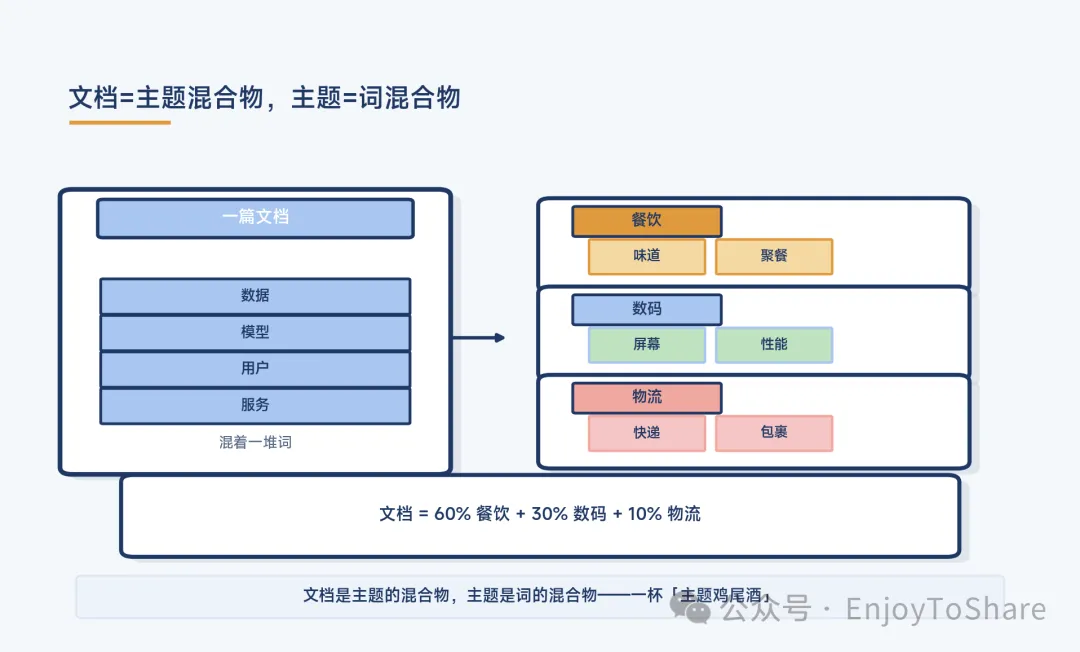
— 核心直觉:文档=主题混合物(一杯鸡尾酒),主题=词混合物(一组气泡)
03
原理:机器怎么学会的
机器怎么知道哪几个词是一伙的?它靠一个「生成故事」反向推理:
假设每写一篇文档,作者都先偷偷掷一把「主题骰子」,决定这篇用哪几个主题、各占多少;然后每写一个词,再掷一把「词骰子」,从对应主题里挑一个词写出来。词袋假设下,词的顺序不重要,重要的只是「这个词被选了几次」。
机器拿到写好的文档后,反过来猜:要是我刚才那样掷骰子,最容易生成出这篇文档的「主题骰子配方」和「词骰子配方」是啥?猜出来,主题就出来了。数学上这叫「推断」,常用 Gibbs 采样或变分法。
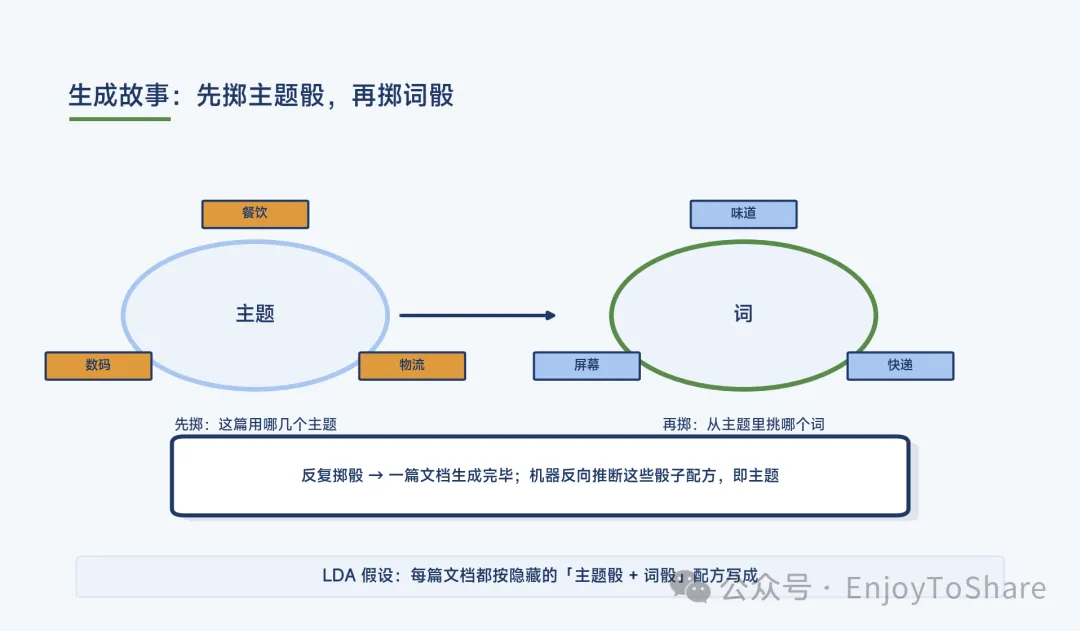
— 生成故事:先掷主题骰选主题,再掷词骰选词,反复成篇
两个小机关你得知道:一是「狄利克雷先验」,它给主题分布一个「别太极端」的倾向(别让一篇文档 100% 只属于一个主题,留点混合才自然);二是「词袋假设」,它丢掉语序,所以主题模型抓得到「聊什么」,抓不准「怎么聊」。
LDA 的核心分解
p(词 | 文档) = Σ_主题 p(主题 | 文档) · p(词 | 主题)
04
一个最小可跑示例
光说不练假把式。下面用 sklearn 跑一个中文主题模型:12 条评论,挖 3 个主题。中文照样先 jieba 切词,再交给模型——套路和词云如出一辙。
import jieba
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation
raw = [
"餐厅 味道 赞 菜品 新鲜 环境 优雅 聚餐 推荐",
"火锅 食材 新鲜 口味 好 聚餐 朋友 开心 推荐",
"咖啡馆 咖啡 香 甜点 精致 安静 聚会 推荐",
"小吃 街 美食 多 价格 实惠 分量 足 打卡 推荐",
"手机 屏幕 清晰 性能 强 续航 长 系统 流畅 值得 买",
"笔记本 轻薄 性能 强 散热 好 办公 流畅 推荐",
"平板 屏幕 好 续航 强 便携 看剧 学生 推荐",
"电脑 芯片 强 屏幕 细腻 游戏 流畅 办公 给力 推荐",
"快递 配送 慢 包装 破损 时效 差 售后 敷衍 不 推荐",
"物流 信息 更新 慢 包裹 丢件 客服 推诿 退换 麻烦 差评",
"配送 时效 差 包装 简陋 客服 态度 差 退货 繁琐 不 推荐",
"快递员 送货 慢 包裹 破损 售后 推诿 不 推荐",
]
docs = [" ".join(jieba.lcut(d)) for d in raw] # 中文先切词
vec = CountVectorizer(stop_words=["这家","适合","值得","还","但","的","会",
"强烈","非常","不","来","推荐","高","好",
"服务","体验"],
token_pattern=r"(?u)\b\w+\b")
X = vec.fit_transform(docs)
lda = LatentDirichletAllocation(n_components=3, random_state=1, max_iter=100)
lda.fit(X)
terms = vec.get_feature_names_out()
for i, comp in enumerate(lda.components_):
top = [terms[j] for j in comp.argsort()[:-6:-1]]
print(f"主题{i+1}:", " ".join(top))
OUTPUT
主题1: 慢 推诿 包裹 破损 快递
主题2: 聚餐 新鲜 打卡 足 街
主题3: 强 流畅 屏幕 差 性能
看,机器自己从 12 条评论里挖出了 3 个主题:主题1 满屏「慢 / 包裹 / 破损 / 快递」——这是物流吐槽;主题2「聚餐 / 新鲜 / 打卡」——这是餐饮种草;主题3「屏幕 / 性能 / 流畅」——这是数码体验。我们没给任何标签,它自己就分好了堆。
再看每篇文档的「主题配方」:餐饮评论大多 90% 以上落在主题2,数码评论落在主题3,物流评论落在主题1。少数几篇因为「差」「配送」等词跨类出现,被分到了相邻主题——这恰恰是真实数据里要调参的信号。
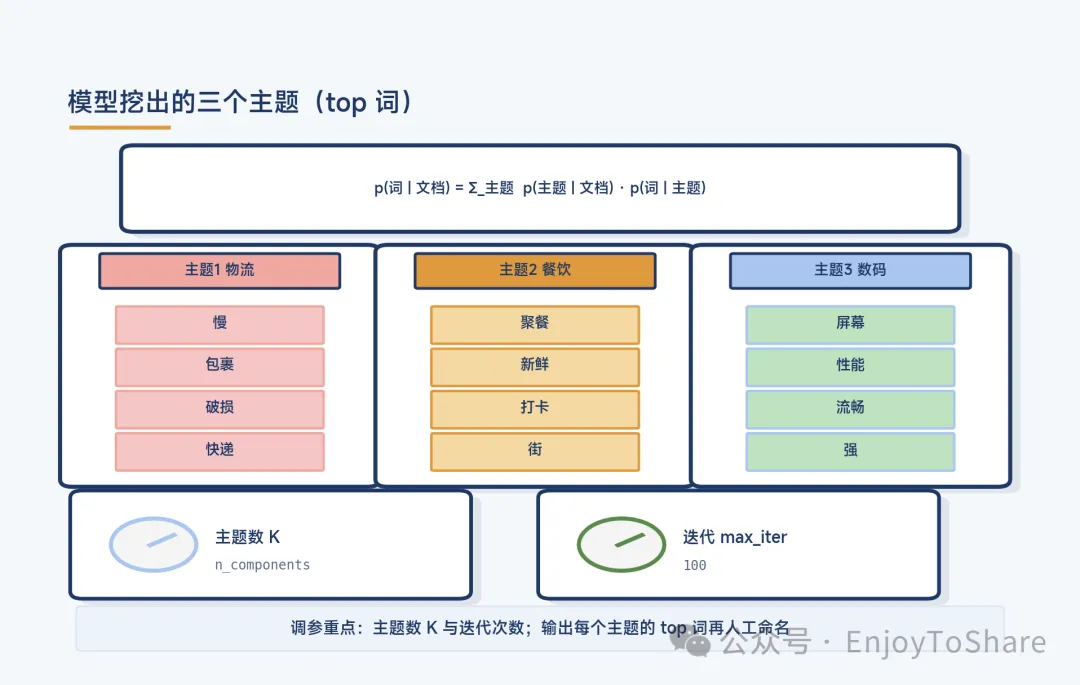
— 推理结果:三个主题 top 词各自成团,文档按占比归入对应主题
05
怎么读结果 + 调参坑
主题模型出结果,不等于结束。怎么把它用起来,有几道坎要过:
主题数 K
先定要挖几个主题:K 太小主题糊成一团,太大又碎成噪声,常用「肘部法」或人工试几轮
中文分词
和词云一样,中文必须先用 jieba 切词,否则每个字单飞,主题全碎
停用词
「的 / 了 / 我们 / 服务 / 体验」这类高频虚词会霸屏,按业务加进停用词
主题命名
模型只给词不给名,得你看着 top 词人工起名(如「物流吐槽」)
可解释性
主题词偶尔混入跨类词属正常,可加停用词或调 K 改善,别强求完美
还有人常问:LDA 之外有没有更省事的?有——NMF(非负矩阵分解)。它不走「掷骰子」那套概率框架,直接把「文档-词」矩阵拆成「文档-主题」和「主题-词」两块,对短文本往往更稳、更快。入门可以先从 NMF 上手,再回头理解 LDA。
from sklearn.decomposition import NMF
nmf = NMF(n_components=3, random_state=1)
nmf.fit(X) # X 同样来自 CountVectorizer
for i, comp in enumerate(nmf.components_):
top = [terms[j] for j in comp.argsort()[:-6:-1]]
print(f"主题{i+1}:", " ".join(top))
一句口诀:中文先 jieba 切词 → 向量化 → LDA/NMF 分解 → 看每主题 top 词 → 人工命名。
06
应用场景
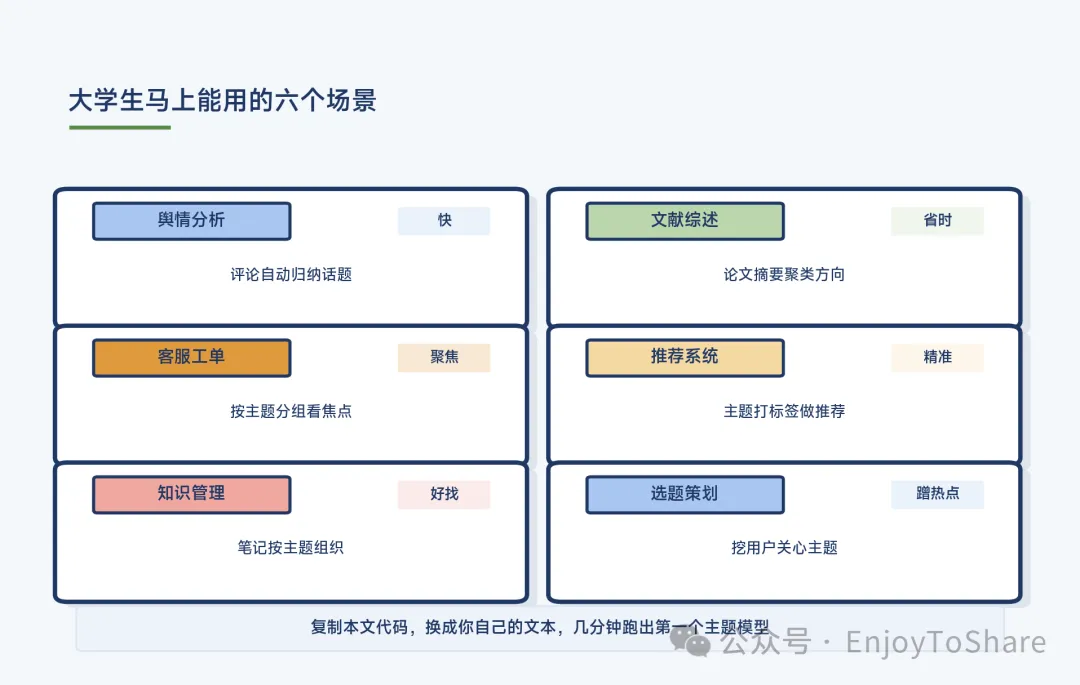
— 应用场景:舆情 / 文献 / 工单 / 推荐 / 知识库 / 选题
舆情分析:把几百条微博或商品评论丢进去,自动归纳出大家在吵哪几个话题(如「价格」「质量」「售后」);
文献综述:读过的几十篇论文摘要,自动聚类成几个研究方向,开题不再大海捞针;
客服工单:海量工单按主题分组,一眼看出这周问题集中在「物流」还是「质量」;
推荐系统:用主题给文章、商品打标签,相似主题的内容互相推荐,冷启动也能跑;
知识管理:把笔记、会议纪要按主题组织,复习时按主题检索,不再翻聊天记录;
选题策划:公众号后台留言、问卷开放题,挖出用户最关心的几个主题来定下期选题。
结语
主题模型全部智慧就一句——把「一堆文档」,压缩成「几个主题 × 每个主题哪些词」。它不读句子,只读「谁和谁常在一起」;不给你标准答案,只给你一组待命名的概率分布。配上好中文分词、合适的 K、干净的停用词,你就能让机器替你,从文字的汪洋里,捞出几根最清晰的线。
它当然有边界:词袋假设让它看不懂语序和讽刺,主题数要你拍板,结果要你命名。但作为「让机器先替你分好类、你再来精读」的第一道滤网,几乎没有更省力的起点。下一篇,我们可以聊聊它的进阶——把词变成向量、直接算「语义距离」的词嵌入 Word2Vec。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。