ARTICLE · 1313918
AI 8 小时就能搓一套实验室管理软件,药企为什么还在掏钱买?
上个月,一个叫 Brandon Thomas 的程序员,带着 3 个队友和 8 个 Agent,用几周时间做出了 Adobe 的开源替代,留下一句话:"Software is over。"
刘润老师为此写了一篇《以后软件都能自己搓了,这门生意还能怎么做?》。他的判断是:软件会越来越不值钱,未来的软件生意大概率是三样东西的叠加——开源(软件本身)+ 付费墙(让企业省心)+ 现场服务(最后一公里有人到场)。
这篇文章在生物医药圈传得格外快。有位药企的 IT 负责人的朋友反馈:
"我们 IT 团队,花了 8 个小时用 AI 搓了一套样品管理模块,用起来还挺顺手。"
一个实验室管理软件的骨架——样品登记、库存台账、领用审批、设备预约、实验记录模板,剥开来看,就是一堆表单、流程和权限。把需求讲清楚,AI 用 8 小时交付一个能跑的版本,完全在情理之中。
于是问题变得非常实在:
既然自己能搓,生物医药实验室管理软件,还需不需要采购?
我们把结论先放在前面:
该买的,还得买。但在生物医药,采购的理由比通用的三条还要多一条——而且恰恰是最贵的那一条。
通用的三条是:开源、省心、有人到场。第四条是生物医药独有的:数据飞轮。
下面一本一本算账。
01 开源:代码更容易获得了,但实验室软件的成本不止代码
先承认一个变化:AI 正在降低实验室软件的开发门槛。在生物医药,"软件本身正在变得不值钱"这句话,比在任何一个行业都成立。
因为实验室软件的门槛,天然就比其他企业软件低半档。它不需要处理千万级并发,不需要复杂的分布式事务,业务逻辑翻来覆去就是"人、机、料、法、环"那几张表。这类东西,正是 AI 最擅长的部分。
所以如果你今天去问一个药企 IT 负责人:"样品管理模块能不能自己做?"答案多半是能。
但问题从来不在"能不能做出来",而在"做出来的是什么"。
Adobe 的替代做出来,你说它是"PhotoCraft";实验室管理软件做出来,你说它是"实验记录系统",名字差不多,可它们承担的责任完全不是一回事。
Photoshop 崩了,你重启一次,损失的是半小时。
实验记录系统崩了——三年前那批临床前数据谁改过、改成了什么、为什么改,说不清了。
这不是夸张。业内有过真实的教训:有生物药企为了省下采购费,在本地部署了一套开源 LIMS,几个月后系统在小规模数据库迁移中崩溃,由于缺乏专业运维,多年的临床前实验数据在修复过程中被乱码覆盖。省下的钱,一次事故就连本带利还了回去。
代码可以重写,实验数据不能重做。
这就是生物医药实验室软件和通用软件的第一道分野:通用软件交付的是功能,实验室软件交付的是证据。
功能是可以用几周搓出来的。证据不行。
也就是说,自建并不是不可行。真正容易被低估的,是自建之后的长期责任。
尤其对药企来说,某个功能暂时不能用,和关键实验记录无法追溯,后果完全不同。
界面可以重做,代码可以重写,但已经完成的实验,未必能按原来的条件再做一次。
功能只是决定系统能不能开始用,数据和流程的可靠性,决定它能不能一直用。这也是实验室软件不能只按“写了多少代码”来定价的原因。
02 第一堵墙:你搓出的只是"实验记录",不是能追溯的"证据链"
一提合规,很多人容易觉得抽象。所以我们不讲法规条文,不妨先看几个具体问题:
①审计追踪:一张 log 表,不等于审计追踪
给系统加一张操作日志表,并不难。难的是,21 CFR Part 11 和 EU GMP Annex 11 要求的审计追踪,是系统级、防篡改、且管理员也无法修改的。
稽查员来看的时候,他问的不是"你有没有日志",而是:
谁在什么时间改了什么?修改前后分别是什么?为什么修改?相关记录是否受到保护?具有高权限的人操作系统时,又如何受到约束?
企业需要考察的,是整套控制机制,而不仅是页面上有没有“操作日志”四个字。
日志记录、权限分离、异常监控和管理制度,要能够相互配合。否则,系统看起来留了痕,关键时刻却未必能还原过程。
②电子签名:电子签名:一个确认按钮,承载不了全部责任
“我完成了实验”“我复核了结果”“我批准了记录”,是不同的动作,也对应不同的责任。
因此,电子签名不仅要关联签署人,还要明确签名的含义,并与对应记录保持关联。
签署之后能否修改?谁能解锁?修改后是否需要重新复核?这些问题,都需要在系统和流程中明确。
把按钮命名为“电子签名”,仅仅只是开始。这三个动作在 GxP 世界里是三种责任。AI 搓出来的系统,很大概率只有一个"提交"按钮。
③数据完整性:ALCOA+ 九个字,一个都躲不掉
样品编号填了,实验结果上传了,不代表记录就完整了。
可归属(Attributable)、清晰(Legible)、同步(Contemporaneous)、原始(Original)、准确(Accurate),外加完整、一致、持久、可及。
数据完整性的要求,最终要落到这些日常动作上。软件可以帮助团队及时记录、减少遗漏、保留修改过程,但无法替代真实、规范的实验执行。
其中"同步"这一条最容易被自建系统击穿:实验做完三天后才补录记录,时间戳是补录那天。在稽查员眼里,这不是"补记",这是"数据完整性缺陷"。
④验证:系统上线之后,责任还在继续
在受监管环境里部署一套复杂系统,初始的 IQ/OQ/PQ 验证,行业经验数字是15 万到 35 万美元。
更麻烦的是:这不是一次性支出。系统每次升级、每次功能变更,都要走变更控制和再验证。
自建系统如此,采购系统也是如此。
区别在于,成熟厂商能否提供清晰的产品文档、测试资料、版本说明和变更支持,帮助企业减少重复建设。
系统升级、接口调整、关键配置变化,也需要评估影响,并据此决定需要开展哪些测试和验证工作。
因此,不能简单理解为“买了软件就合规”,也不能把验证当成上线前一次性完成的手续。
⑤五年 TCO:授权费只是零头
这一点可能是最反直觉的。行业里的经验法则是:采购价通常不到五年总拥有成本的 25%。
剩下的 75% 在哪?数据迁移、持续验证、人员培训、接口维护、以及那个永远在排队的"能不能加个字段"。
<25%采购授权费占五年 TCO 的比例
$15–35 万复杂系统初始验证(IQ/OQ/PQ)经验区间
每次升级受监管系统需变更控制与再验证
10–25 年GxP 数据需保留的时间跨度
所以真正的问题不是"买要花多少钱",而是:
自建的第一个月,你会觉得省了一大笔。自建的第三年,你会发现自己养了一支队伍。
而这支队伍的队长一旦离职——他带走的不只是代码,还有"为什么当年要这么设计"的全部记忆。可你的数据要保留十年、二十五年。
系统活三年,数据活二十五年。这就是自建和采购之间最不对称的地方。
03 第二堵墙:付费买的不只是功能,还有持续运行的支持
刘润原文里那句话我们很认同:付费墙卖的是"从我能做,到你能放心用"之间的距离。
放到生物医药,这段距离主要体现在三件事上:
第一,关键控制能否贯穿不同模块。
实验记录、样品、库存和审批,如果各自使用不同的账号规则、权限逻辑和日志机制,企业就要花更多精力维持一致性。
衍因科技的公开产品体系提供了一个具体例子:其 AI MEGASphere 合规平台介绍了审批引擎、账号与权限控制、合规策略和审计日志;上层产品则覆盖实验记录 yanNote、实验室管理 yanLIMS 和文献管理 yanLibrary 等场景。
这种平台化设计值得关注的地方,是能否让不同业务共享基础能力,减少每增加一个模块就重新搭建一套规则的工作。
但平台能力最终如何落地,仍要结合版本、配置和企业实际流程确认。
第二,升级和故障能否得到持续支持。
关键系统的升级,需要提前评估影响,安排必要测试,并准备恢复方案。
采购时要问清楚的,不只是“多久更新一次”,还包括:更新了什么,谁评估影响,谁负责测试,出了问题多久响应,能否恢复到可用状态。
当系统需要支持研发资料整理、质量审核或申报准备时,企业需要的已经超出了通用记录工具的范围。
衍因官网介绍的灵研合规助手 yanReviewer,包含 AI 审核和注册申报智能体等方向。
对企业来说,这类能力值得进一步验证:能识别哪些问题,依据是什么,建议如何复核,处理过程是否能够追溯。
AI 可以辅助检查和整理,专业人员仍需对最终内容作出判断。
采购的价值,要体现在企业少做了多少重复工作,以及关键问题发生时,能够获得什么支持。
04 第三堵墙:最后一公里,在实验室里是一台台具体的仪器
通用软件的"现场服务",是有人来帮你配流程、做培训。
生物医药的"现场服务",要难一个数量级。因为实验室里的最后一公里,不是流程,是硬件。
同一个检测项目,A 公司用的是 A 品牌的酶标仪,B 公司用的是三年前买的另一台;同样的审批,有的实验室要先找课题组长再找 QA,有的按金额走不同分支。每家实验室的仪器、SOP、审批习惯都不一样。
这就是为什么"通用能力"在生物医药最容易被打回原形。
有意思的是,AI 也在改写这一段的成本结构。
衍因科技目前使用"视—动联合"的非侵入式技术接入存量设备——不改造硬件、不换仪器,靠机器视觉定位 + 具身机器人操作,让主流品牌的存量设备直接接入智能协同,部署周期压到小时级。
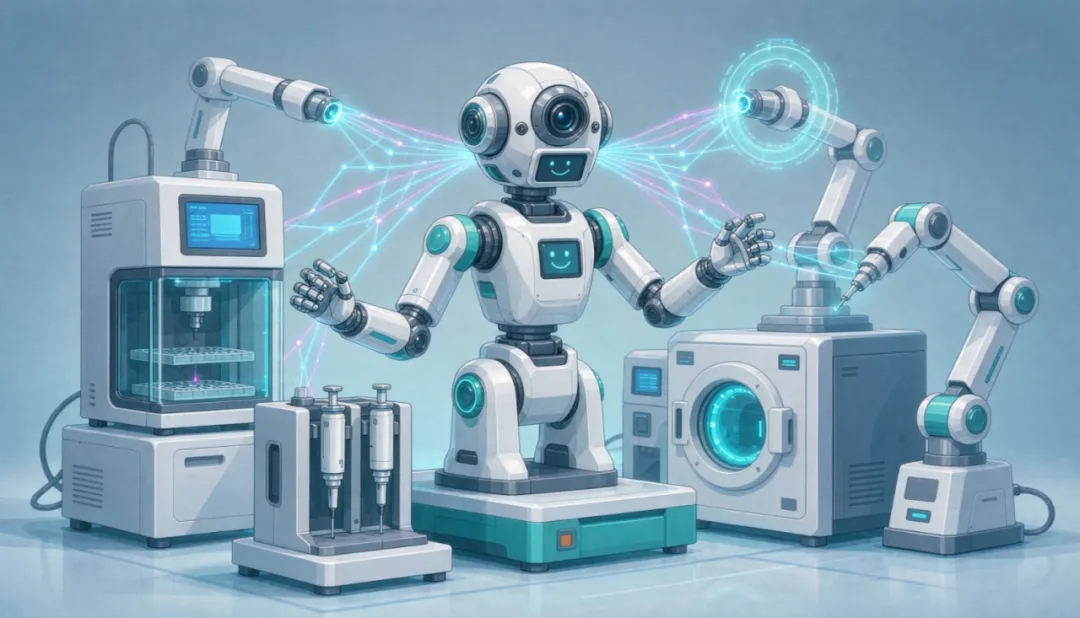
这件事的意义不只是"省事":
它把"最后一公里"从一场需要停工改造的工程,变成了一次配置。
而在一个稳转株筛选的真实项目里,把 AI 规划、机器视觉定位、机器人执行、数据回收分析串成一条线之后,结果是成本降低 50%、效率提升 80%。
成本 −50%细胞疗法企业稳转株筛选项目
效率 +80%AI 规划 → 机器人执行 → 数据回流
小时级存量设备非侵入式接入部署周期
~30%因人为误差无法复现的实验占比
这两个数字不是来自"写了个软件",而是来自"软件 + 设备 + 人"真正跑通了。
这也是为什么厂商越来越倾向于和生态伙伴分工:产品方做可复用的平台和模型,实施伙伴上门交付。就像刘润说的开奶茶店——品牌方挣供应链的钱,加盟商一杯一杯地挣。卖产品,和卖"用产品",是两笔钱。
05 第四堵墙(生物医药独有):你搓不出一条"干湿闭环"的数据飞轮
前面三条,是把刘润的框架翻译成生物医药的语言。
但如果只讲到这里,这篇文章就只是一篇翻译稿。生物医药实验室软件真正的付费墙,还有第四条——而且它和前三条性质完全不同。
前三条买的是成本规避(少踩坑、少担责、少停产)。第四条买的是能力获取(你买不到的东西)。
这一条叫:数据飞轮。
你自己搓的系统,数据是死水。
想象一下:你自研了一套 ELN,用了三年,积累了上万条实验记录。然后呢?
然后它就躺在那里。它是档案,不是资产。它不会被用来训练任何模型,也不会让下一个项目的设计变得更快。
因为要让数据变成资产,需要三样东西,而你没有:
· 统一的数据模型(本体)——让"这管样品"和"那条序列"能真正关联起来,而不是躺在两张表里靠人工拼接;
· 领域模型——通用的大模型不懂 CRISPR、不懂稳转株筛选,它需要被生物数据喂过;
· 闭环回路——干实验(设计)指导湿实验(验证),湿实验的数据回流,反过来改进下一轮设计。
第三点最关键,也最贵。
AI 搓得出代码,搓不出五年湿实验。
AI 可以在几周内写出一个漂亮的实验记录系统。它写不出下面这些东西:
近 20 万条标注数据积累
400 万+ / 800 万+基因序列 / 蛋白序列
1.5 万+实验室 Protocol
300+ 次 / 50+实战建模经验 / 集成生物模型
这是衍因科技 MEGASphere 大模型底座背后的一组数字。请注意:这些不是"数据量",是用湿实验的失败和成功一轮一轮喂出来的。
一个周末能搓出代码。五年的湿实验,搓不出来。
这就是第四条墙的本质:
前三条,AI 让自建变得越来越可行。第四条,AI 让采购变得越来越值。
因为 AI 真正稀缺的不是生成代码的能力,而是高质量、可追溯、可被模型消费的领域数据。而这一类数据,恰恰只有"实验被执行了多少次"才能产生。
所以未来真正值钱的实验室软件,不是那个帮你记录实验的系统,而是那个能让你的实验数据持续产生复利的回路。
06 所以,到底什么时候自己搓,什么时候掏钱买?
判断的关键点,不是“AI 能不能写出来”,而是“这套系统要承担什么责任”。
给你一张可以直接拿去开会的判断清单:
【自己搓满足这些特征】
· 一次性需求,用完即弃
· 不进 GxP 体系,不用于申报
· 一个人或小范围使用,不涉及跨部门协作
· 结果对错你能一眼看出来
· 数据丢了不心疼
【掏钱买满足任意一条就够】
· 要用于注册申报、要接受稽查
· 需要电子签名和防篡改审计追踪
· 多人跨部门协作,有审批流
· 数据要保留十年以上
· 需要对接仪器设备和自动化产线
· 你希望三年后这些数据还能喂出一个更好的模型
一句话版本的判断标准:
如果是"记录"需求,自己搓;如果是"证据"需求或"资产"需求,掏钱买。
最后的话
回到开头那个问题:软件都能自己搓了,生物医药实验室管理软件还需不需要采购?
我们的答案是:
采购的理由变了,但采购不会消失。
过去,软件厂商可以凭借开发能力获得订单。今天,客户越来越有能力自己完成一些功能,厂商就必须证明更多价值。
对衍因科技这样的科研软件企业来说,这种价值应当落在实际工作里:
· 买合规——让数据成为可被监管采信的证据;
· 买确定性——出错时有人接电话,升级时不停摆;
· 买飞轮——让每一次实验都沉淀成下一次设计的起点。
而且顺序是反过来的:越是自己能搓的年代,后两样越值钱。
实验数据是否更容易找到和追溯,跨团队流程是否更顺畅,重复整理是否减少,关键系统是否得到持续支持,以及过去的实验能否为下一轮研发提供依据。
这些都需要通过产品、交付和使用结果来证明。
AI 会让软件更容易开发,也会让客户的选择更多。
但当一套系统开始承载真实的实验、长期的数据和跨团队的责任,企业仍然需要认真决定:由谁建设,由谁维护,由谁持续把它做好。
八小时能做出一个很好的起点。
药企愿意长期付费的理由,在起点之后。